
In this Article
Bu rehber, herkese açık verileri büyük ölçekte toplamak isteyen mühendislerin çoğunlukla tercih ettiği çalışma zamanı olan Node.js ile JavaScript kullanarak nasıl web scraping yapılacağını açıklar. JavaScript ile web scraping yapmayı öğrenmek, sayfa için doğru aracı seçmek demektir: statik HTML için hafif bir HTTP istemcisi veya betikler aracılığıyla yüklenen içerik için headless bir tarayıcı.
Aşağıda her iki durum için de çalışan, doğrudan çalıştırılabilir Node.js kodunun yanı sıra proje kurulumu, JSON ve CSV’ye yapılandırılmış dışa aktarma, sayfalama, geri çekilmeli yeniden denemeler, hız sınırlama, proxy kimlik doğrulaması, XHR yakalama ve bir scraper’ın zaman içinde çalışmaya devam edip etmemesini belirleyen etik ve engelleme konularını bulacaksınız.
DataImpulse, 195 ülkede 90 milyondan fazla residential, mobile ve datacenter IP adresi sunan etik bir proxy sağlayıcısıdır. GB başına 1 dolardan başlayan, süresi dolmayan trafiğe sahip kullandıkça öde modeli kullanır; web scraping, reklam doğrulama, fiyat izleme, pazar araştırması ve çoklu hesap yönetiminde kullanılır.
Temel bilgiler
- İki araç zinciri: Statik sayfalar yalnızca bir HTTP istemcisi ile fetch ve cheerio gibi bir ayrıştırıcıya ihtiyaç duyarken, içeriği tarayıcıda oluşturan dinamik sayfalar Puppeteer veya Playwright gibi headless bir motora ihtiyaç duyar.
- En iyi proxy türü: bot tespitini aşan gerçek tüketici IP’lerini kullanan dönen residential proxy’ler.
- Fiyat: GB başına 1 dolardan başlayan, süresi dolmayan trafik ve abonelik gerektirmeyen kullandıkça öde modeli.
- Kapsam: 195 ülkede etik biçimde tedarik edilen 90 milyondan fazla IP.
- Güvenilirlik: %99,51 başarı oranı, G2’de 5 üzerinden 4,8 puan.
- Protokoller ve hedefleme: Ülke hedefleme dahil HTTP, HTTPS ve SOCKS5.
JavaScript ile web scraping nedir?
JavaScript ile web scraping, genellikle bir tarayıcı sekmesi yerine Node.js çalışma zamanında çalışan JavaScript kullanılarak web sayfalarının programatik olarak istenmesi ve bunlardan yapılandırılmış verilerin çıkarılması sürecidir.
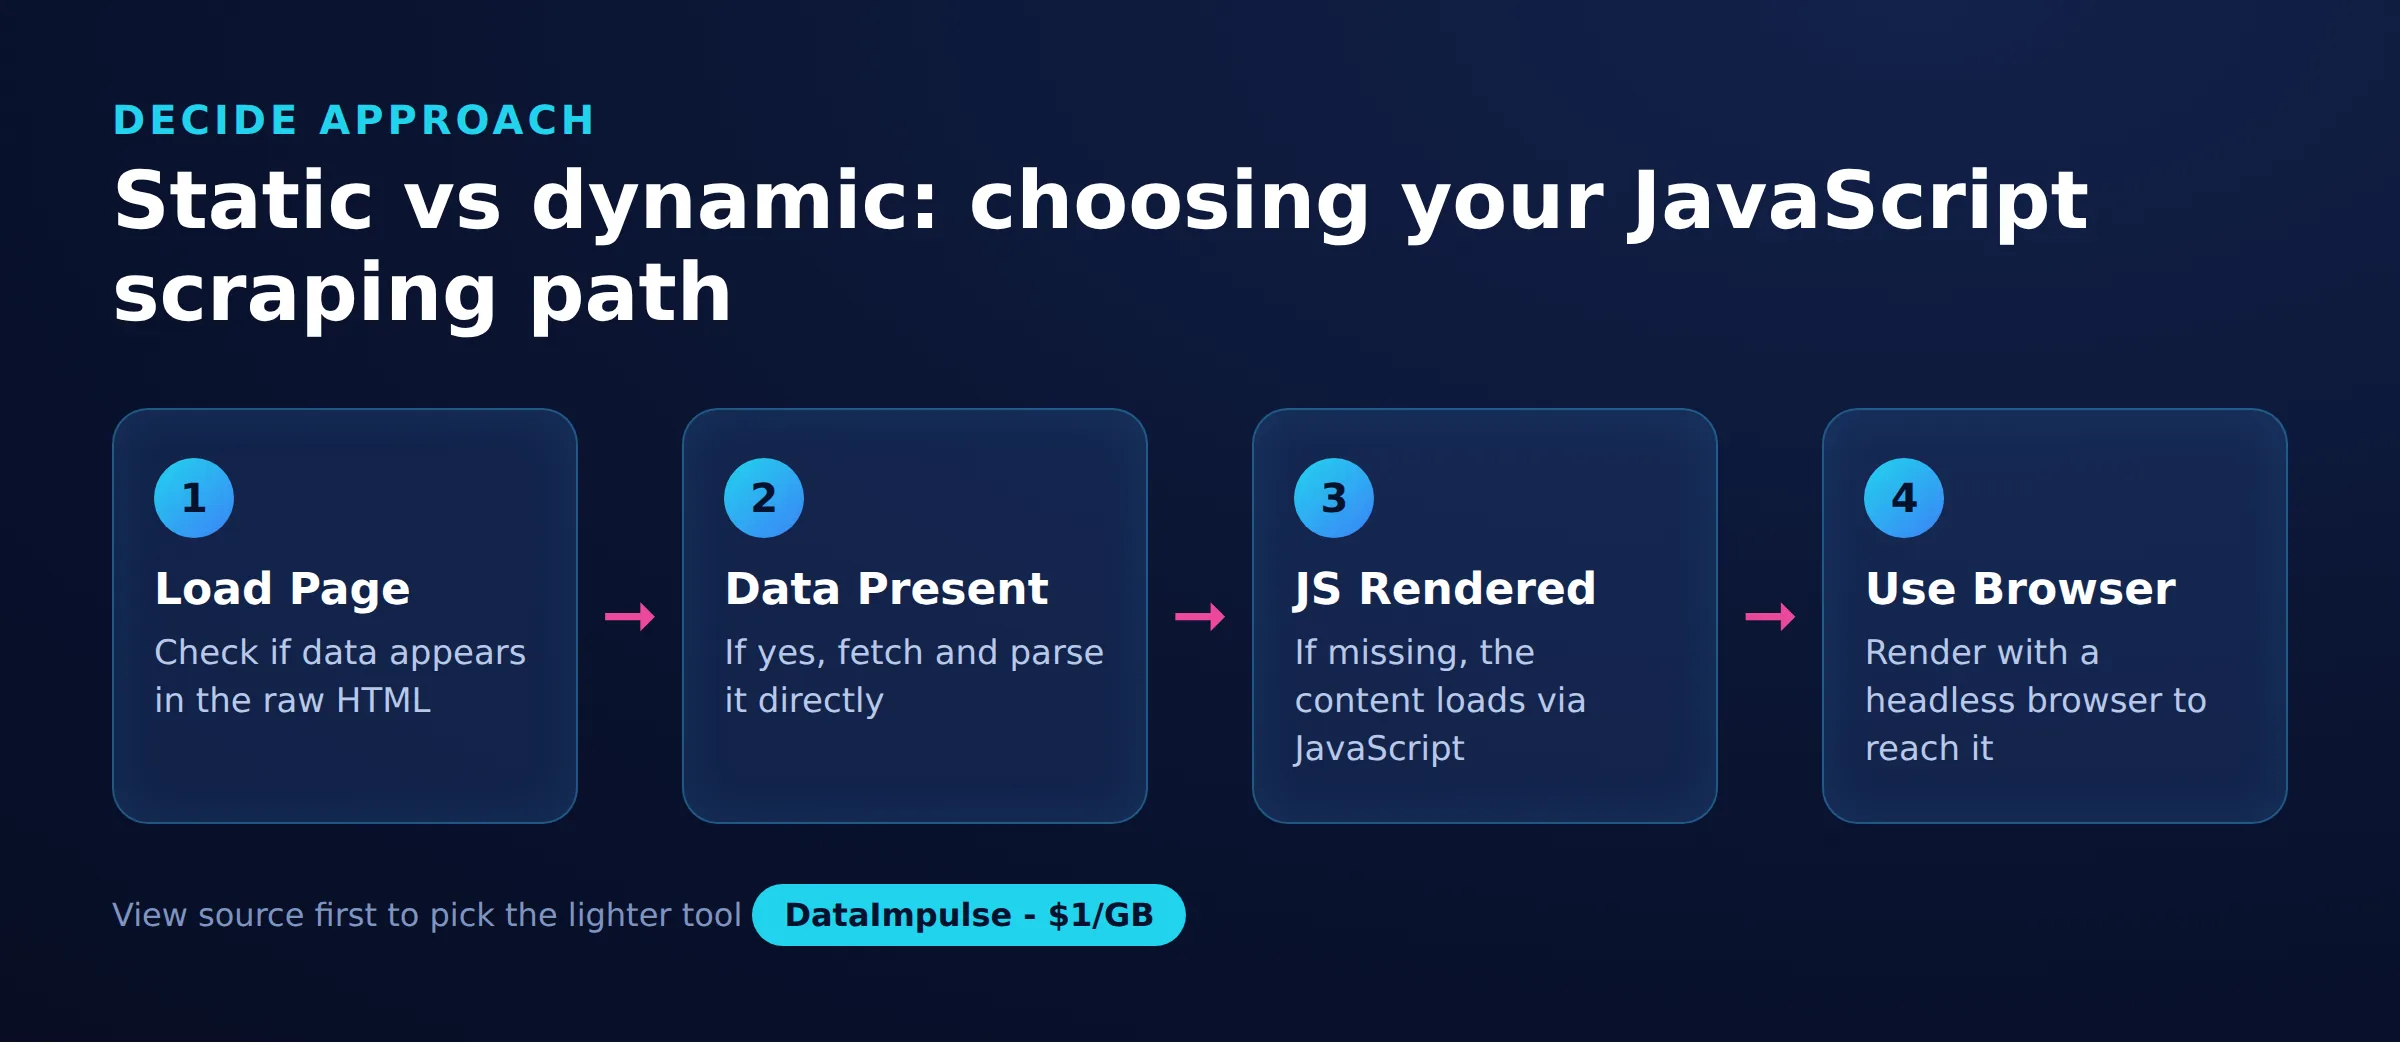
JavaScript doğal bir seçimdir çünkü dil zaten Document Object Model’i modeller; bu nedenle öğe seçimi front-end geliştiricilere tanıdık gelir. Uygulamada bir scraper üç iş yapar: bir sayfayı HTTP üzerinden getirir, dönen işaretlemeyi sorgulanabilir bir ağaca ayrıştırır ve başlıklar, fiyatlar ya da bağlantılar gibi önem verdiğiniz alanları çıkarır. Karmaşıklık, hedef sayfanın verisini nasıl sunduğundan kaynaklanır; bu yüzden doğru aracı seçmek ayrıştırmanın kendisinden daha önemlidir. Statik sayfalar verilerini ilk HTML yanıtında sunar, dinamik sayfalar ise yüklemeden sonra bunu tarayıcıda oluşturur; iki durum farklı araç zincirleri gerektirir.
Node.js scraping projesi nasıl kurulur?
Bir proje klasörü oluşturun, npm ile başlatın ve herhangi bir scraping kodu yazmadan önce ihtiyacınız olan kütüphaneleri kurun.
Node.js 18 ve sonrası yerleşik genel fetch ile gelir; bu nedenle basit GET istekleri için HTTP kütüphanesine ihtiyacınız yoktur, ancak birçok ekip interceptor’ları ve proxy yönetimi nedeniyle hâlâ axios’u tercih eder. Aşağıdaki komutlar bir proje iskeleti oluşturur; ayrıştırma için cheerio’yu, alternatif istemci olarak axios’u, eşzamanlılık denetimi için p-limit’i, dinamik sayfalar için de Puppeteer ve Playwright’ı kurar:
mkdir js-scraper && cd js-scraper
npm init -y
npm install cheerio axios p-limit
npm install puppeteer playwright

# enable modern import syntax
npm pkg set type=module
type=module ayarı, import ifadelerini kullanmanızı sağlar. CommonJS tercih ediyorsanız varsayılan ayarı koruyun ve bunun yerine require kullanın. Bu rehberdeki örnekler import söz dizimini kullanır, ancak her biri doğrudan bir require çağrısına karşılık gelir. Kurulum tamamlandığında, tek projede hem statik hem dinamik scraping için gereken her şeye sahip olursunuz.
fetch ve cheerio ile statik bir sayfa nasıl scrape edilir?
Statik sayfalarda HTML’yi yerleşik fetch işleviyle indirin ve sunucuda size jQuery tarzı bir API sağlayan cheerio ile ayrıştırın.
Statik sayfalar içeriklerini doğrudan ilk HTML yanıtında döndürür; dolayısıyla tarayıcıda oluşturma gerekmez. Bu yaklaşım hızlı ve ekonomiktir çünkü görselleri, yazı tiplerini veya betikleri değil yalnızca işaretlemeyi indirirsiniz. Aşağıdaki örnek bir sayfayı getirir, cheerio’ya yükler ve her ürün kartını okur:
import * as cheerio from 'cheerio';

async function scrape(url) {
  const res = await fetch(url, {
    headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
  });
  if (!res.ok) throw new Error(`Request failed: ${res.status}`);
  const html = await res.text();
  const $ = cheerio.load(html);

  const items = [];
  $('.product').each((i, el) => {
    items.push({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim(),
      link: $(el).find('a').attr('href')
    });
  });
  return items;
}

console.log(await scrape('https://example.com/catalog'));
axios tercih ediyorsanız ayrıştırma kısmı aynıdır ve yalnızca istek değişir. Axios, 2xx olmayan durum kodlarında otomatik olarak hata fırlatır ve proxy yapılandırmasını kolaylaştırır; bu yüzden birçok üretim scraper’ı onu kullanır:
import axios from 'axios';
import * as cheerio from 'cheerio';

const { data: html } = await axios.get('https://example.com/catalog', {
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' },
  timeout: 15000
});
const $ = cheerio.load(html);
const titles = $('.product h2').map((i, el) => $(el).text().trim()).get();
console.log(titles);
Bir scraper’ı herhangi bir siteye yöneltmeden önce hedefin buna izin verdiğini doğrulamak önemlidir. Bir web sitesinin scraping’e izin verip vermediğini kontrol etme rehberimiz robots.txt’yi ve hizmet şartlarını ele alır.
Yapılandırılmış veriler JSON ve CSV’ye nasıl çıkarılır?
Her kaydı düz nesnelerden oluşan bir dizide toplayın, ardından bu diziyi bir JSON dosyasına yazın veya CSV dosyası için virgülle ayrılmış satırlara dönüştürün.
Ham olarak scrape edilen metin, ancak öngörülebilir bir yapıda saklandığında yararlıdır. JavaScript dizisi doğrudan serileştirildiği için JSON en basit hedeftir. Aşağıdaki kod parçası, scrape edilen öğeleri yerleşik dosya sistemi modülüyle diske yazar:
import { writeFile } from 'node:fs/promises';

const items = await scrape('https://example.com/catalog');
await writeFile('products.json', JSON.stringify(items, null, 2), 'utf-8');
console.log(`Saved ${items.length} records to products.json`);
Veriler bir elektronik tabloya veya veri ambarına aktarılacaksa CSV daha uygundur. Tırnak işaretlerini kaçırarak ve alanları birleştirerek bunu kütüphane olmadan oluşturabilirsiniz; ancak fiyatlar ve başlıklar virgül içerebileceğinden kaçırma işlemi önemlidir:
import { writeFile } from 'node:fs/promises';

function toCsv(rows) {
  const headers = Object.keys(rows[0]);
  const escape = (v) => `"${String(v ?? '').replace(/"/g, '""')}"`;
  const lines = [headers.join(',')];
  for (const row of rows) {
    lines.push(headers.map((h) => escape(row[h])).join(','));
  }
  return lines.join('\n');
}

const items = await scrape('https://example.com/catalog');
await writeFile('products.csv', toCsv(items), 'utf-8');
Sayfa düzeni biraz değiştiğinde sonraki araçların bozulmaması için alan adlarınızı çalıştırmalar arasında sabit tutun. İkili dosya varlıklarını da çekmeniz gerekiyorsa bir web sitesinden görselleri scrape etme.
Sayfalama ile birden çok sayfa nasıl scrape edilir?
Sitenin sayfa URL’leri üzerinde döngü kurun veya her sayfadaki sonraki sayfa bağlantısını izleyin; her birini scrape edin ve sonuç kalmadığında durun.
Çoğu katalog, sonuçları ?page=2 gibi bir sorgu parametresi kullanarak numaralı sayfalara böler veya sonraki bağlantısını sunar. En güvenli düzen her sayfayı okur, kayıtlarını toplar, ardından sonraki sayfayı arar ve bulunmadığında durur. Aşağıdaki örnek, bir sayfa hiç öğe döndürmeyene kadar numaralı sayfaları dolaşır:
import * as cheerio from 'cheerio';

async function scrapeAll(base) {
  const all = [];
  for (let page = 1; page <= 50; page++) {
    const res = await fetch(`${base}?page=${page}`, {
      headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
    });
    if (!res.ok) break;
    const $ = cheerio.load(await res.text());
    const items = $('.product').map((i, el) => ({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim()
    })).get();

    if (items.length === 0) break;
    all.push(...items);
    await new Promise((r) => setTimeout(r, 1000));
  }
  return all;
}

console.log((await scrapeAll('https://example.com/catalog')).length);
Sayfalar arasındaki bir saniyelik beklemeye ve sitenin hiç boş sayfa döndürmemesi durumunda kontrolden çıkan döngüyü önleyen 50 yinelemelik kesin sınıra dikkat edin. İçerik numaralı sayfalar yerine kaydırarak yükleniyorsa, aşağıdaki Puppeteer bölümünde ele alınan bir headless tarayıcıya ihtiyacınız vardır.
Yeniden denemeler, geri çekilme ve hız sınırlama nasıl yönetilir?
Her isteği, her hatadan sonra daha uzun bekleyen bir yeniden deneme yardımcısıyla sarın ve sitenin toleransı içinde kalmak için aynı anda çalışacak istek sayısını sınırlayın.
Ağlar güvenilir değildir ve sunucular geçici hatalar döndürür; bu nedenle ilk hatada vazgeçen bir scraper gereksiz yere veri kaybeder. Üstel geri çekilmeye sahip bir yeniden deneme yardımcısı, denemeler arasında aşamalı olarak daha uzun bekler; bu aynı zamanda hızı sınırlanmış bir sunucunun toparlanmasına zaman tanır:
async function fetchWithRetry(fn, retries = 4, delay = 1000) {
  for (let attempt = 1; attempt <= retries; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt === retries) throw err;
      const wait = delay * 2 ** (attempt - 1);
      console.warn(`Attempt ${attempt} failed, retrying in ${wait}ms`);
      await new Promise((r) => setTimeout(r, wait));
    }
  }
}

const html = await fetchWithRetry(async () => {
  const res = await fetch('https://example.com/catalog');
  if (res.status === 429) throw new Error('Rate limited');
  if (!res.ok) throw new Error(`HTTP ${res.status}`);
  return res.text();
});
Geri çekilme tekil istekleri yönetir, ancak paralel çalışanların sayısını da denetlemeniz gerekir. Yüzlerce eşzamanlı istek göndermek hedef sunucuyu zorlar ve trafiğinizin işaretlenmesine neden olur. p-limit kütüphanesi eşzamanlılığı sınırlar; böylece sabit sayıda worker URL kuyruğunu işler:
import pLimit from 'p-limit';

const limit = pLimit(5); // at most 5 requests in flight
const urls = Array.from({ length: 100 }, (_, i) =>
  `https://example.com/item/${i + 1}`
);

const results = await Promise.all(
  urls.map((url) =>
    limit(() => fetchWithRetry(async () => {
      const res = await fetch(url);
      if (!res.ok) throw new Error(`HTTP ${res.status}`);
      return res.text();
    }))
  )
);

console.log(`Fetched ${results.length} pages with a cap of 5 in parallel`);
Geri çekilme ve eşzamanlılık sınırı birlikte, etkinizi makul ve başarı oranınızı yüksek tutar. Daha kapsamlı bir kontrol listesi için web scraping en iyi uygulamaları rehberimize bakın.
Puppeteer ile dinamik sayfalar nasıl scrape edilir?
Yüklemeden sonra JavaScript ile içerik oluşturan dinamik sayfalarda Puppeteer ile headless Chrome’u yönetin, hedef seçiciyi bekleyin ve tamamen oluşturulmuş DOM’u okuyun.
Birçok modern site neredeyse boş bir HTML kabuğu döndürür, ardından arka plan istekleriyle veri getirir. HTTP istemcisi yararlı bir şey göremez; bu nedenle sayfanın kendi JavaScript’ini çalıştıran bir motora ihtiyacınız vardır. Puppeteer headless Chrome’u denetler; öğeleri bekleyebilir, tıklayabilir ve kaydırabilir. Aşağıdaki örnek bir seçiciyi bekler, sonra tarayıcı bağlamındaki verileri çıkarmadan önce sonsuz kaydırma yüklemesini tetiklemek için tekrar tekrar kaydırır:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();
await page.setUserAgent('Mozilla/5.0 (compatible; MyScraper/1.0)');
await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });

// wait until the first batch of cards is present
await page.waitForSelector('.product');

// infinite scroll: scroll to the bottom until height stops growing
let previousHeight = 0;
for (let i = 0; i < 20; i++) {
  const height = await page.evaluate('document.body.scrollHeight');
  if (height === previousHeight) break;
  previousHeight = height;
  await page.evaluate('window.scrollTo(0, document.body.scrollHeight)');
  await new Promise((r) => setTimeout(r, 1500));
}

const items = await page.evaluate(() =>
  Array.from(document.querySelectorAll('.product')).map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
Döngü, yeni içerik yüklenmediğini gösteren sayfa yüksekliği artmayı bırakır bırakmaz durur; 20 kaydırmalık kesin sınır da sonsuz döngüyü önler. Bu hedef sınıfı hakkında daha fazla bilgi için dinamik web sayfalarını scrape etme.
Puppeteer’a alternatif olarak Playwright nasıl kullanılır?
Playwright, Puppeteer ile neredeyse aynı şekilde çalışır ancak Chromium, Firefox ve WebKit için birinci sınıf destek ile kararsız seçicileri azaltan otomatik beklemeli konumlandırıcılar ekler.
Playwright, özgün Puppeteer mühendislerinden bazıları tarafından geliştirildi ve API’sinin çoğunu paylaşır; bu nedenle geçiş genellikle birkaç çağrıyı yeniden adlandırma meselesidir. Konumlandırıcıları öğelerin işlem yapılabilir hâle gelmesini otomatik olarak bekler; böylece birçok manuel waitForSelector çağrısı ortadan kalkar. Eşdeğer scraper şöyledir:
import { chromium } from 'playwright';

const browser = await chromium.launch({ headless: true });
const context = await browser.newContext({
  userAgent: 'Mozilla/5.0 (compatible; MyScraper/1.0)'
});
const page = await context.newPage();
await page.goto('https://example.com/feed', { waitUntil: 'networkidle' });

await page.locator('.product').first().waitFor();

const items = await page.locator('.product').evaluateAll((els) =>
  els.map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
Aynı scraper’ı birden çok tarayıcı motorunda test etmeniz veya yerleşik ağ taklit özelliğini istemeniz durumunda Playwright’ı seçin. Yalnızca Chrome’u hedefliyorsanız ve daha küçük bağımlılık istiyorsanız Puppeteer’ı seçin. Her ikisi de fetch ve cheerio’dan çok daha fazla bellek tüketir; bu nedenle onları gerçekten oluşturma gerektiren sayfalara ayırın.
Hangi JavaScript scraping aracını seçmelisiniz?
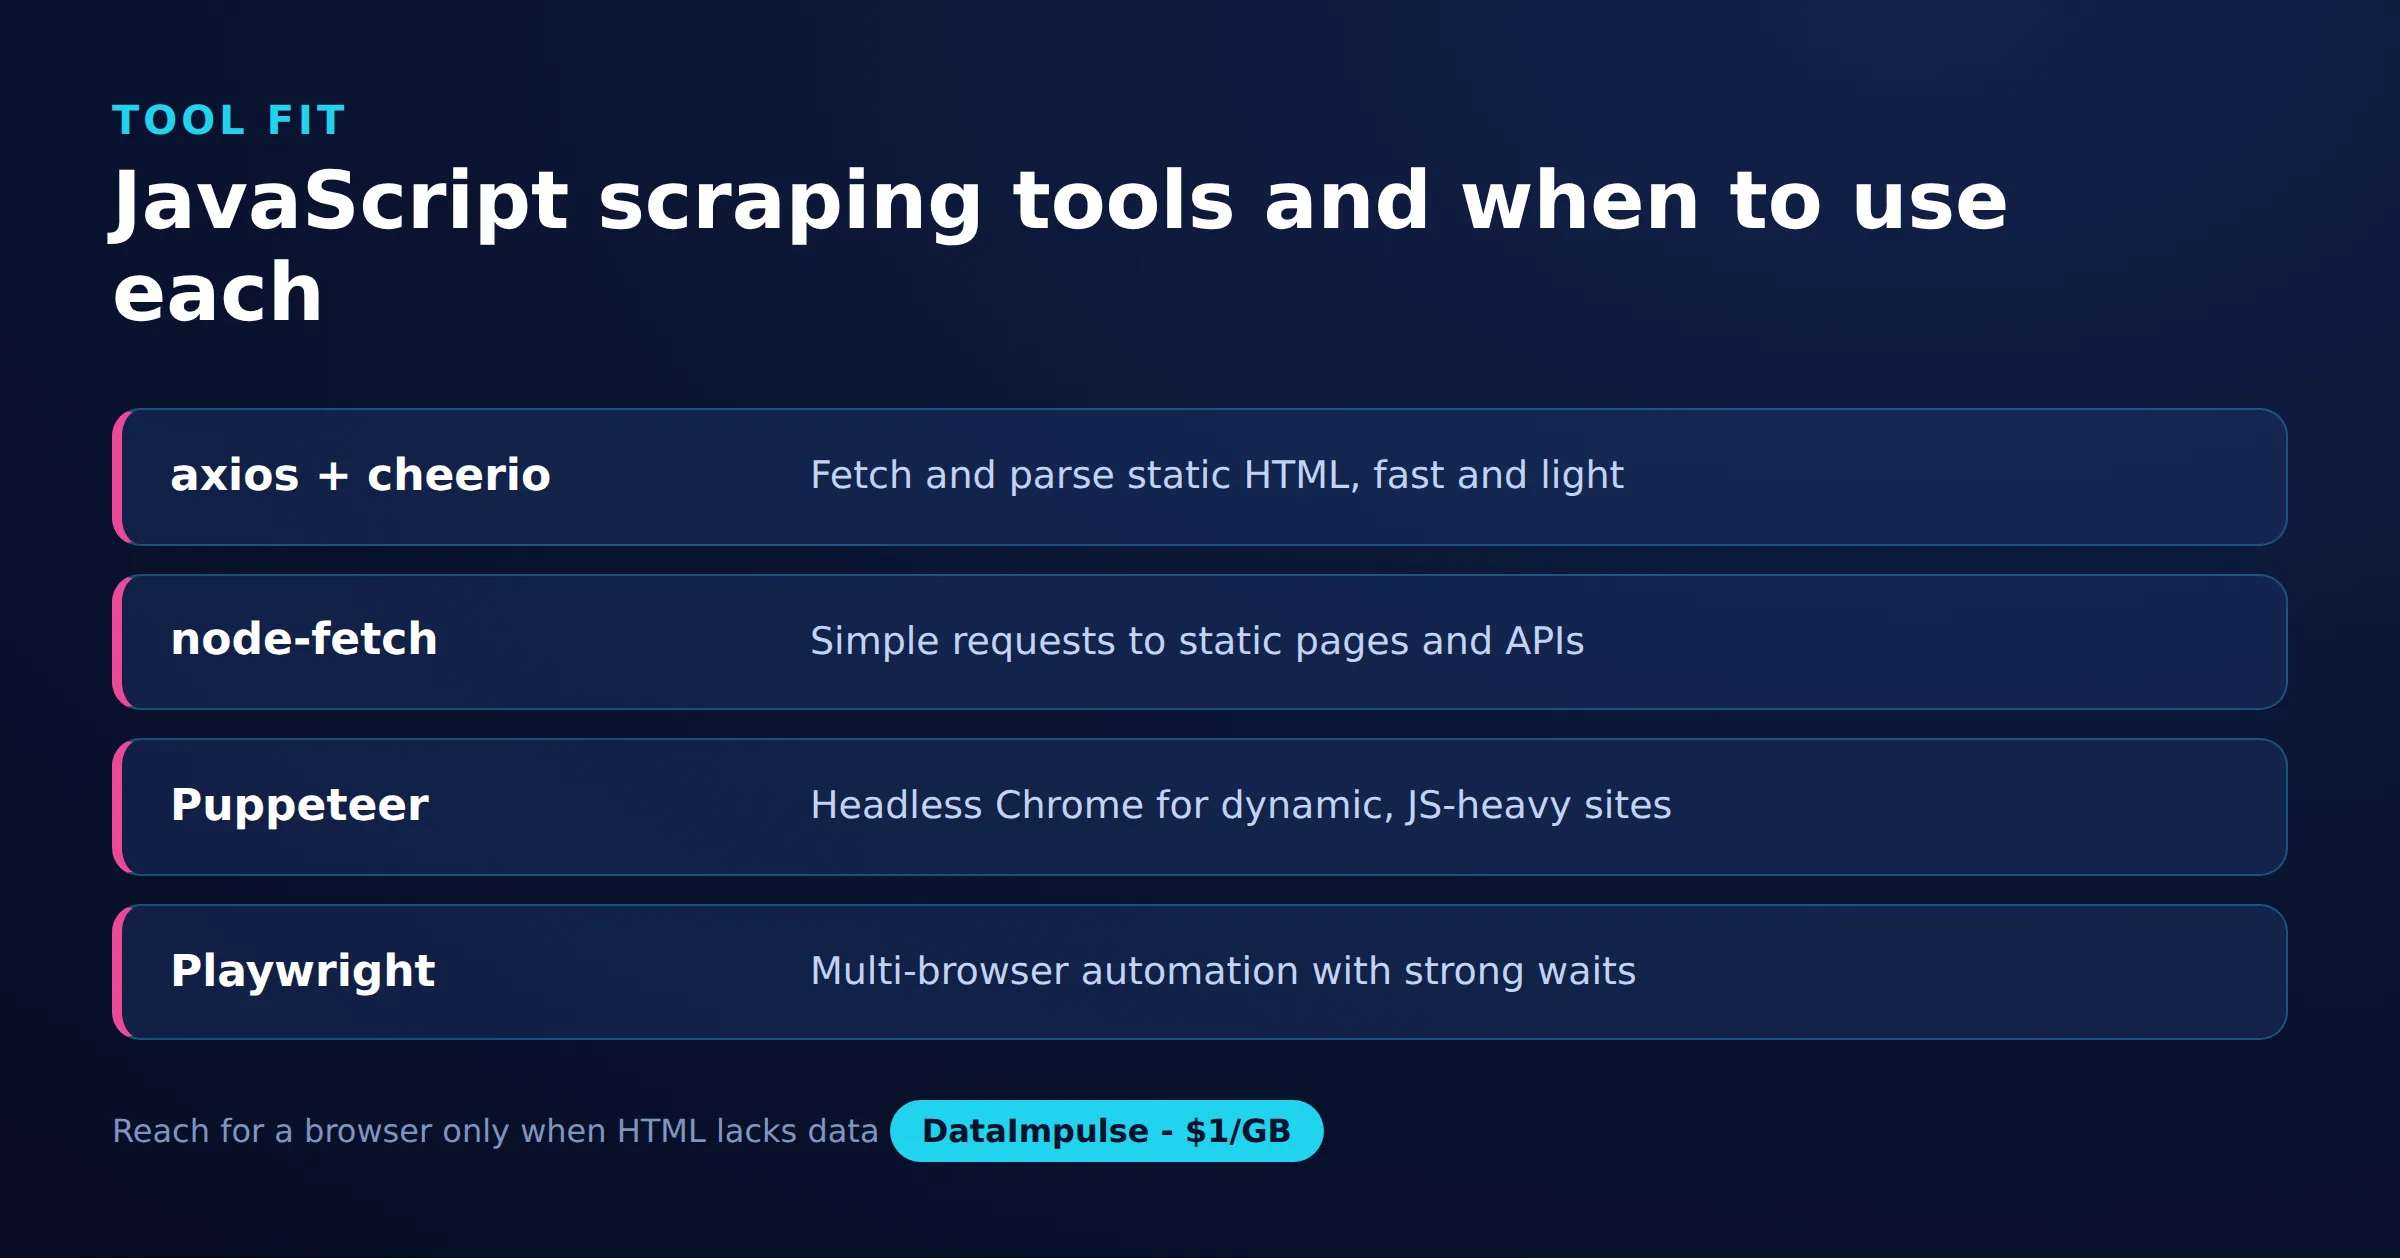
Statik HTML için cheerio ile fetch veya axios kullanın; Puppeteer ya da Playwright’ı yalnızca bir sayfa verisini tarayıcıda oluşturduğunda tercih edin.
Doğru araç, sayfanın veriyi nasıl sunduğuna ve hızı oluşturma doğruluğuna ne kadar tercih ettiğinize bağlıdır. HTTP istemcileri hızlı ve hafiftir ancak JavaScript çalıştıramaz; headless tarayıcılar gerçek kullanıcının gördüğü her şeyi çalıştırır fakat daha fazla bellek ve zaman gerektirir. Aşağıdaki tablo denge noktalarını özetler:
| Araç | JS çalıştırır | Hız | En uygun kullanım |
|---|---|---|---|
| fetch + cheerio | Hayır | En hızlı | Statik HTML, yüksek hacim |
| axios + cheerio | Hayır | Hızlı | Statik HTML, kolay proxy yapılandırması |
| Puppeteer | Evet | Yavaş | Dinamik, yalnızca Chrome sayfaları |
| Playwright | Evet | Yavaş | Dinamik, tarayıcılar arası test |
Yaygın bir üretim düzeni ikisini birleştirir: headless tarayıcıyı yalnızca oluşturma gerektiren sayfalara veya endpoint’lere ulaşmak için kullanın, ardından isteklerin büyük bölümü için düz bir HTTP istemcisine dönün. JavaScript bu iş için kullanılabilir birkaç stack’ten biridir; ekosistemleri karşılaştırıyorsanız Rust ile web scraping rehberimiz derlenmiş bir alternatifi ele alır.
JavaScript scraper’ları proxy üzerinden nasıl yönlendirirsiniz?
İsteklerin farklı bir IP adresinden çıkması için proxy ayarlarını HTTP istemcinize veya tarayıcı başlatma seçeneklerinize iletin; bu, yükü dağıtır ve tek bir adresin hızının sınırlanma olasılığını azaltır.
Tek bir IP’den çok sayfa scrape etmek, engellenmenin en hızlı yoludur. İstekleri bir adres havuzunda sırayla dolaştırmak, trafiği birçok ayrı ziyaretçi gibi gösterir. axios ile proxy host’unu, portunu ve kimlik bilgilerini istek yapılandırmasında sağlarsınız. Aşağıdaki örnek bir DataImpulse ağ geçidi üzerinden yönlendirir:
import axios from 'axios';

const { data } = await axios.get('https://example.com', {
  proxy: {
    protocol: 'http',
    host: 'gw.dataimpulse.com',
    port: 823,
    auth: { username: 'YOUR_USERNAME', password: 'YOUR_PASSWORD' }
  },
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
});
console.log(data.length, 'bytes received through the proxy');
Chrome proxy URL’si içinde kimlik bilgilerini kabul etmediği için Puppeteer proxy’yi başlatma argümanı olarak alır ve ardından sayfada kimlik doğrulaması yapar. Kullanıcı adı ve parolaya sahip proxy nesnesini doğrudan kabul eden Playwright’ta da düzen aynıdır:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({
  headless: 'new',
  args: ['--proxy-server=gw.dataimpulse.com:823']
});
const page = await browser.newPage();
await page.authenticate({
  username: 'YOUR_USERNAME',
  password: 'YOUR_PASSWORD'
});
await page.goto('https://example.com', { waitUntil: 'networkidle2' });
console.log(await page.title());
await browser.close();
DataImpulse, residential proxy’ler, datacenter proxy’ler ve mobile proxy’ler ile HTTP, HTTPS ve SOCKS5 üzerinden dönen ve sticky session’lar sunar. Ülke hedefleme dahildir; eyalet, şehir, ZIP ve ASN hedefleme ise ücretli eklentilerdir. Bir proxy isteği kimlik doğrulama hatası döndürürse HTTP hata 407 en yaygın nedeni açıklar; proxy kimlik doğrulaması rehberimiz kimlik bilgisi biçimlerini daha ayrıntılı ele alır.
XHR ve JSON endpoint’leri nasıl yakalarsınız?
Oluşturulmuş HTML’yi scrape etmek yerine headless tarayıcıdaki ağ trafiğini izleyin ve sayfanın arka planda getirdiği JSON yanıtlarını okuyun; bu genellikle daha temiz ve hızlıdır.
Dinamik sayfalar verilerini genellikle JSON döndüren gizli bir API’den alır. Bu yanıtı doğrudan okumak DOM ayrıştırmasını tamamen atlar ve size iyi yapılandırılmış kayıtlar verir. Hem Puppeteer hem Playwright yanıtları dinlemenize ve istediklerinizi yakalamanıza olanak tanır. Aşağıdaki Puppeteer örneği, bir API yolundaki tüm JSON yanıtlarını yakalar:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();

const captured = [];
page.on('response', async (response) => {
  const url = response.url();
  if (url.includes('/api/') && response.headers()['content-type']?.includes('application/json')) {
    try {
      captured.push(await response.json());
    } catch (err) {
      // non-JSON body, ignore
    }
  }
});

await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });
console.log(`Captured ${captured.length} JSON payloads`);
await browser.close();
Endpoint URL’sini ve parametrelerini öğrendiğinizde, çoğu zaman tarayıcıyı tamamen bırakabilir ve sayfanın gönderdiği aynı HTTP istek başlıklarını ileterek JSON API’yi düz fetch ile çağırabilirsiniz. Bu, size statik scraper’ın hızını ve oluşturulmuş olanın eksiksizliğini verir; dinamik sitelerdeki en büyük tek performans kazanımı budur.
Scraping’in etik ve yasal sınırları nelerdir?
Yalnızca herkese açık verileri scrape edin, sitenin robots.txt’sine ve hizmet şartlarına saygı gösterin, kişisel verilerden kaçının ve bir sunucuyu asla aşırı yüklemeyin. Bu uygulamalar projenizi hem savunulabilir hem sürdürülebilir kılar.
Bir sitenin tarayıcılardan kaçınmasını istediği yolları görmek için alan adının kökündeki robots.txt dosyasını kontrol edin ve bu isteklere ciddi yaklaşın. Scraper’ınızı dürüst bir User-Agent ile tanımlayın, isteklerinizi yavaşlatın ve aynı sayfayı gereksiz yere yeniden getirmemek için yanıtları önbelleğe alın. Altyapı tarafında IP adreslerinizin kaynağı önemlidir. DataImpulse, etik proxy’ler işleten bir sağlayıcıdır; bunlar GDPR ile uyumlu olarak onay veren ve ücretlendirilen kullanıcılardan tedarik edilir, ayrıca bir veri işleme sözleşmesi sunulur. Etik yalnızca bir uyumluluk meselesi değildir; nazik ve şeffaf scraper’lar aynı zamanda çalışmaya devam edenlerdir. Sürdürülebilir veri toplamanın ilkeleri için etik web scraping rehberimize bakın.
Sık sorulan sorular
JavaScript ile scrape etmek için Node.js gerekir mi?
Hızlı, tek sayfalık bir testin ötesindeki her şey için evet. Node.js, scraper’ları bir sunucuda çalıştırmanıza, birçok URL üzerinde döngü kurmanıza, yeniden denemeleri yönetmenize, veri dışa aktarmanıza ve proxy kullanmanıza olanak tanır; tarayıcı konsolu bunların hiçbirini iyi yapamaz.
fetch ve cheerio yerine Puppeteer’ı ne zaman kullanmalıyım?
Veri ilk HTML yanıtında mevcutsa cheerio ile fetch veya axios kullanın. Headless tarayıcı çok daha ağır olduğundan, yalnızca içerik sayfa yüklendikten sonra JavaScript ile oluşturuluyorsa Puppeteer veya Playwright’a geçin.
Node.js’de scrape edilen verileri CSV’ye nasıl aktarırım?
Kayıtları nesne dizisi olarak toplayın, ardından her nesnenin değerlerini birleştirip tırnak işaretleriyle virgülleri kaçırarak virgülle ayrılmış satırlar oluşturun. Sonucu yerleşik fs modülüyle bir dosyaya yazın veya csv-stringify gibi bir kütüphane kullanın.
JavaScript ile scrape ederken neden engelleniyorum?
Yaygın nedenler tek IP’den çok fazla istek, eksik ya da şüpheli bir User-Agent ve istekler arasında gecikme olmamasıdır. Dönen proxy’ler, gerçekçi HTTP istek başlıkları, geri çekilmeli yeniden denemeler ve hız sınırlama engellemeleri azaltır.
JavaScript scraping için en iyi proxy türü hangisidir?
Datacenter proxy’ler toleranslı hedefler için hızlı ve ekonomiktir; residential ve mobile proxy’ler ise katı sitelerde gerçek kullanıcılara daha çok benzer. Dönen oturumlar, isteklerin birçok adrese dağıtılmasına yardımcı olur.
DataImpulse ne zaman doğru tercih değildir?
Statik ISP proxy’lerine, tamamen yönetilen bir scraping API’ye veya bankacılık ve devlet sitelerine erişime ihtiyacınız varsa DataImpulse doğru araç değildir. Herkese açık veri toplamak ve içeriğe erişmek için dönen residential, mobile ve datacenter proxy’lere odaklanır.
Güvenilir proxy’lerle scraping’e başlayın
JavaScript scraper’larınızı sürekli engellemeler olmadan çalışır durumda tutmaya hazır mısınız? DataImpulse, GB başına 1 dolardan başlayan, süresi dolmayan trafik ve abonelik gerektirmeyen, etik biçimde tedarik edilmiş residential, mobile ve datacenter IP’ler sunar. Hesap oluşturun ve ilk scraper’ınızı bugün bir proxy üzerinden yönlendirin.