
In this Article
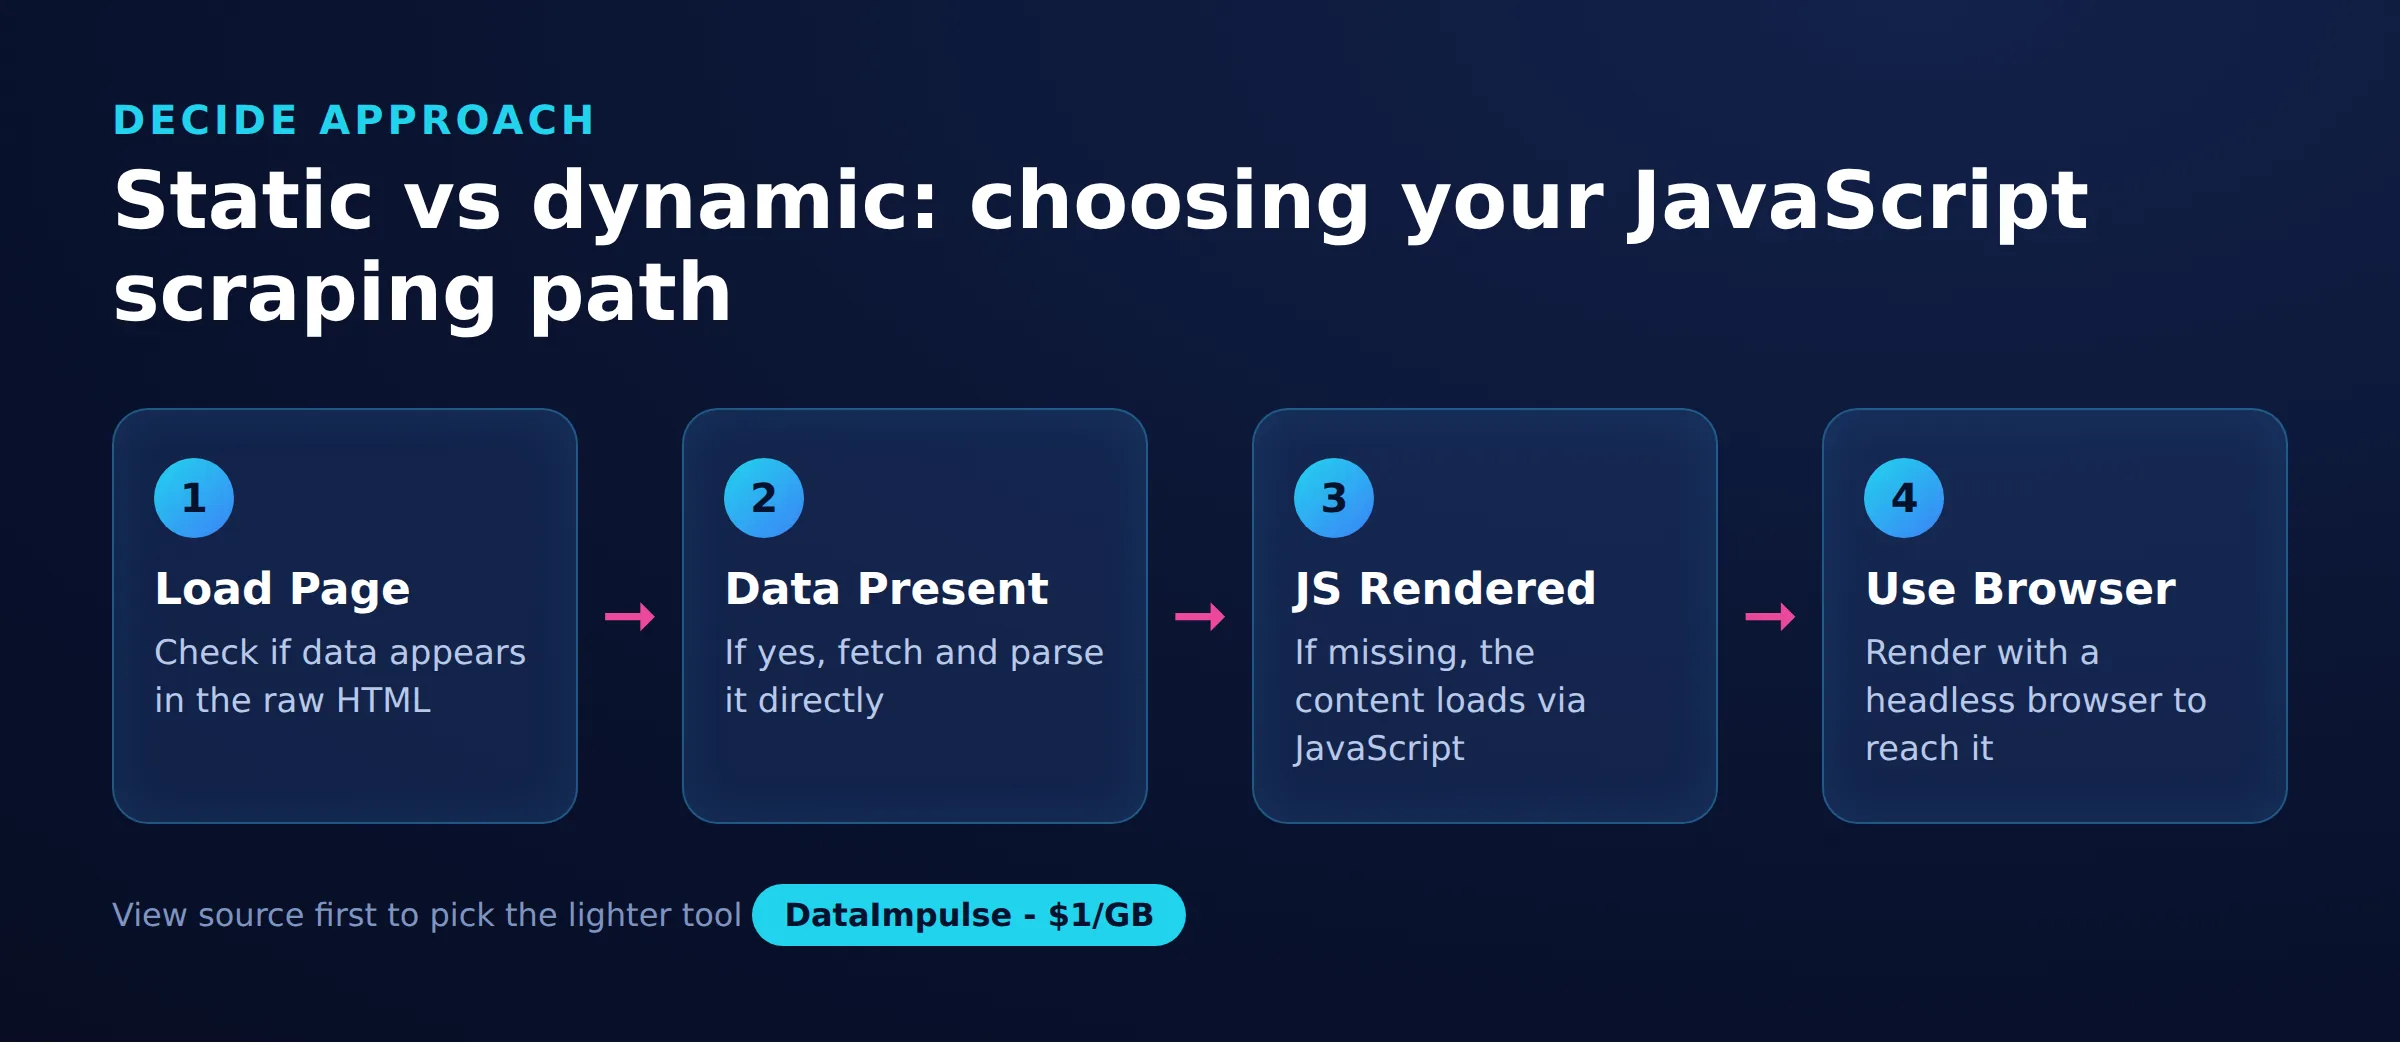
이 가이드는 대규모로 공개 데이터를 수집하려는 대부분의 엔지니어가 선택하는 런타임인 Node.js를 사용하여 JavaScript로 웹 스크래핑하는 방법을 설명합니다. JavaScript 웹 스크래핑을 익히려면 페이지에 맞는 도구를 선택해야 합니다. 정적 HTML에는 가벼운 HTTP 클라이언트를, 스크립트로 로드되는 콘텐츠에는 헤드리스 브라우저를 사용합니다.
아래에서는 두 경우 모두에 바로 실행할 수 있는 Node.js 코드와 프로젝트 설정, JSON 및 CSV 구조화 내보내기, 페이지네이션, 백오프 재시도, 속도 제한, 프록시 인증, XHR 가로채기, 그리고 스크래퍼의 장기적인 작동 여부를 좌우하는 윤리 및 차단 문제를 살펴봅니다.
DataImpulse는 195개국에서 9,000만 개 이상의 레지덴셜, 모바일 및 데이터센터 IP 주소를 제공하는 윤리적 프록시 제공업체입니다. GB당 1 dollar부터 시작하는 종량제 모델과 만료되지 않는 트래픽을 제공하며, 웹 스크래핑, 광고 검증, 가격 모니터링, 시장 조사 및 다중 계정 관리에 사용됩니다.
핵심 정보
- 두 가지 도구 체인: 정적 페이지에는 fetch와 cheerio 같은 파서와 HTTP 클라이언트만 필요하지만, 브라우저에서 콘텐츠를 렌더링하는 동적 페이지에는 Puppeteer 또는 Playwright 같은 헤드리스 엔진이 필요합니다.
- 최적의 프록시 유형: 실제 소비자 IP를 사용해 탐지를 자연스럽게 통과하는 로테이팅 레지덴셜 프록시(rotating residential proxy)입니다.
- 가격: GB당 1 dollar부터 시작하며, 종량제이고 만료되지 않는 트래픽을 제공하며 구독이 없습니다.
- 서비스 범위: 195개국의 윤리적으로 확보한 9,000만 개 이상의 IP입니다.
- 신뢰성: 성공률 99.51%, G2에서 5점 만점에 4.8점입니다.
- 프로토콜 및 타기팅: HTTP, HTTPS 및 SOCKS5를 지원하며 국가 타기팅이 포함됩니다.
JavaScript 웹 스크래핑이란 무엇입니까?
JavaScript 웹 스크래핑은 JavaScript를 사용하여 웹페이지를 프로그래밍 방식으로 요청하고 그 안에서 구조화된 데이터를 추출하는 과정입니다. 일반적으로 브라우저 탭 내부가 아니라 Node.js 런타임에서 실행합니다.
JavaScript는 이미 Document Object Model을 모델링하는 언어이므로 요소 선택 방식이 프런트엔드 개발자에게 익숙해 자연스럽게 사용할 수 있습니다. 실제로 스크래퍼는 세 가지 일을 합니다. HTTP를 통해 페이지를 가져오고, 반환된 마크업을 쿼리 가능한 트리로 파싱하며, 제목, 가격, 링크처럼 필요한 필드를 추출합니다. 복잡성은 대상 페이지가 데이터를 제공하는 방식에서 비롯되므로 파싱 자체보다 올바른 도구 선택이 더 중요합니다. 정적 페이지는 첫 HTML 응답에 데이터를 포함하지만 동적 페이지는 로드 후 브라우저에서 데이터를 구성하므로, 두 경우에는 서로 다른 도구 체인이 필요합니다.
Node.js 스크래핑 프로젝트는 어떻게 설정합니까?
프로젝트 폴더를 만들고 npm으로 초기화한 뒤, 스크래핑 코드를 작성하기 전에 필요한 라이브러리를 설치합니다.
Node.js 18 이상에는 전역 fetch,가 내장되어 있어 간단한 GET 요청에는 HTTP 라이브러리가 필요하지 않습니다. 다만 많은 팀은 인터셉터와 프록시 처리 기능 때문에 여전히 axios를 선호합니다. 아래 명령은 프로젝트를 구성하고, 파싱용 cheerio, 대체 클라이언트인 axios, 동시성 제어용 p-limit, 동적 페이지용 Puppeteer와 Playwright를 설치합니다:
mkdir js-scraper && cd js-scraper
npm init -y
npm install cheerio axios p-limit
npm install puppeteer playwright

# enable modern import syntax
npm pkg set type=module
설정에서 type=module을 지정하면 import문을 사용할 수 있습니다. CommonJS를 선호한다면 기본 설정을 유지하고 require를 대신 사용합니다. 이 가이드의 예제는 import 문법을 사용하지만 각각 require 호출에 직접 대응합니다. 설치가 끝나면 하나의 프로젝트에서 정적 및 동적 스크래핑에 필요한 모든 것을 갖추게 됩니다.
fetch와 cheerio로 정적 페이지를 어떻게 스크래핑합니까?
정적 페이지에서는 내장 fetch 함수로 HTML을 다운로드하고 서버에서 jQuery 스타일 API를 제공하는 cheerio로 파싱합니다.
정적 페이지는 초기 HTML 응답에서 콘텐츠를 직접 반환하므로 브라우저 렌더링이 필요 없습니다. 이미지, 글꼴, 스크립트가 아니라 마크업만 다운로드하므로 이 방식은 빠르고 비용이 적게 듭니다. 아래 예제는 페이지를 가져와 cheerio에 로드하고 각 제품 카드를 읽습니다:
import * as cheerio from 'cheerio';

async function scrape(url) {
  const res = await fetch(url, {
    headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
  });
  if (!res.ok) throw new Error(`Request failed: ${res.status}`);
  const html = await res.text();
  const $ = cheerio.load(html);

  const items = [];
  $('.product').each((i, el) => {
    items.push({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim(),
      link: $(el).find('a').attr('href')
    });
  });
  return items;
}

console.log(await scrape('https://example.com/catalog'));
axios를 선호한다면 파싱 부분은 동일하고 요청만 달라집니다. Axios는 2xx가 아닌 상태 코드에서 자동으로 예외를 발생시키고 프록시 설정을 간편하게 해 주므로 많은 프로덕션 스크래퍼가 사용합니다:
import axios from 'axios';
import * as cheerio from 'cheerio';

const { data: html } = await axios.get('https://example.com/catalog', {
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' },
  timeout: 15000
});
const $ = cheerio.load(html);
const titles = $('.product h2').map((i, el) => $(el).text().trim()).get();
console.log(titles);
스크래퍼를 어떤 사이트에 사용하기 전에 대상이 이를 허용하는지 확인하는 것이 좋습니다. 웹사이트가 스크래핑을 허용하는지 확인하기 가이드에서 robots.txt와 서비스 약관을 살펴봅니다.
구조화된 데이터를 JSON과 CSV로 어떻게 추출합니까?
각 레코드를 일반 객체 배열에 수집한 뒤 JSON 파일에 쓰거나, CSV 파일용 쉼표로 구분된 행으로 평면화합니다.
원시 스크래핑 텍스트는 예측 가능한 형태로 저장해야만 유용합니다. JavaScript 배열을 직접 직렬화할 수 있으므로 JSON이 가장 간단한 대상입니다. 아래 스니펫은 내장 파일 시스템 모듈로 스크래핑한 항목을 디스크에 씁니다:
import { writeFile } from 'node:fs/promises';

const items = await scrape('https://example.com/catalog');
await writeFile('products.json', JSON.stringify(items, null, 2), 'utf-8');
console.log(`Saved ${items.length} records to products.json`);
데이터가 스프레드시트나 데이터 웨어하우스로 전달될 때는 CSV가 더 적합합니다. 따옴표를 이스케이프하고 필드를 연결하면 라이브러리 없이 만들 수 있지만, 가격과 제목에는 쉼표가 포함될 수 있으므로 이스케이프가 중요합니다:
import { writeFile } from 'node:fs/promises';

function toCsv(rows) {
  const headers = Object.keys(rows[0]);
  const escape = (v) => `"${String(v ?? '').replace(/"/g, '""')}"`;
  const lines = [headers.join(',')];
  for (const row of rows) {
    lines.push(headers.map((h) => escape(row[h])).join(','));
  }
  return lines.join('\n');
}

const items = await scrape('https://example.com/catalog');
await writeFile('products.csv', toCsv(items), 'utf-8');
실행 간 필드 이름을 안정적으로 유지해야 페이지 레이아웃이 조금 바뀌어도 후속 도구가 중단되지 않습니다. 바이너리 자산도 가져와야 한다면 웹사이트에서 이미지 스크래핑하기.
페이지네이션으로 여러 페이지를 어떻게 스크래핑합니까?
사이트의 페이지 URL을 순회하거나 각 페이지의 다음 페이지 링크를 따라가며 각각을 스크래핑하고, 더 이상 결과가 없으면 중지합니다.
대부분의 카탈로그는 ?page=2, 또는 다음 링크를 제공합니다. 가장 안전한 패턴은 각 페이지를 읽고 레코드를 수집한 다음 다음 페이지를 찾아 없으면 중지하는 것입니다. 아래 예제는 항목을 반환하지 않는 페이지가 나올 때까지 번호가 있는 페이지를 순회합니다:
import * as cheerio from 'cheerio';

async function scrapeAll(base) {
  const all = [];
  for (let page = 1; page <= 50; page++) {
    const res = await fetch(`${base}?page=${page}`, {
      headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
    });
    if (!res.ok) break;
    const $ = cheerio.load(await res.text());
    const items = $('.product').map((i, el) => ({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim()
    })).get();

    if (items.length === 0) break;
    all.push(...items);
    await new Promise((r) => setTimeout(r, 1000));
  }
  return all;
}

console.log((await scrapeAll('https://example.com/catalog')).length);
페이지 사이의 1초 대기와 50회 반복의 엄격한 상한에 유의하십시오. 사이트가 빈 페이지를 반환하지 않아도 무한 루프를 방지합니다. 번호 페이지가 아니라 스크롤로 콘텐츠가 로드되는 경우에는 헤드리스 브라우저가 필요하며, 아래 Puppeteer 섹션에서 다룹니다.
재시도, 백오프 및 속도 제한은 어떻게 처리합니까?
각 요청을 실패할 때마다 더 오래 기다리는 재시도 도우미로 감싸고, 사이트의 허용 범위 내에 머물도록 동시에 실행되는 요청 수에 상한을 둡니다.
네트워크는 신뢰할 수 없고 서버는 일시적 오류를 반환하므로 첫 실패에서 포기하는 스크래퍼는 불필요하게 데이터를 잃습니다. 지수 백오프를 사용하는 재시도 도우미는 시도 사이의 대기 시간을 점진적으로 늘리며, 속도가 제한된 서버가 복구할 시간도 제공합니다:
async function fetchWithRetry(fn, retries = 4, delay = 1000) {
  for (let attempt = 1; attempt <= retries; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt === retries) throw err;
      const wait = delay * 2 ** (attempt - 1);
      console.warn(`Attempt ${attempt} failed, retrying in ${wait}ms`);
      await new Promise((r) => setTimeout(r, wait));
    }
  }
}

const html = await fetchWithRetry(async () => {
  const res = await fetch('https://example.com/catalog');
  if (res.status === 429) throw new Error('Rate limited');
  if (!res.ok) throw new Error(`HTTP ${res.status}`);
  return res.text();
});
백오프는 개별 요청을 처리하지만 병렬 실행 수 역시 제어해야 합니다. 수백 개의 동시 요청을 보내면 대상 서버 성능이 저하되고 트래픽에 플래그가 지정됩니다. p-limit 라이브러리는 고정된 수의 워커가 URL 대기열을 처리하도록 동시성에 상한을 둡니다:
import pLimit from 'p-limit';

const limit = pLimit(5); // at most 5 requests in flight
const urls = Array.from({ length: 100 }, (_, i) =>
  `https://example.com/item/${i + 1}`
);

const results = await Promise.all(
  urls.map((url) =>
    limit(() => fetchWithRetry(async () => {
      const res = await fetch(url);
      if (!res.ok) throw new Error(`HTTP ${res.status}`);
      return res.text();
    }))
  )
);

console.log(`Fetched ${results.length} pages with a cap of 5 in parallel`);
백오프와 동시성 상한을 함께 사용하면 부담을 적절한 수준으로 유지하고 성공률을 높일 수 있습니다. 더 폭넓은 체크리스트는 웹 스크래핑 모범 사례 가이드를 참고하십시오.
Puppeteer로 동적 페이지를 어떻게 스크래핑합니까?
로드 후 JavaScript로 콘텐츠를 구성하는 동적 페이지에서는 Puppeteer로 헤드리스 Chrome을 제어하고 대상 선택자를 기다린 뒤 완전히 렌더링된 DOM을 읽습니다.
많은 현대적 사이트는 거의 비어 있는 HTML 셸을 반환한 뒤 백그라운드 요청으로 데이터를 가져옵니다. HTTP 클라이언트에는 유용한 내용이 보이지 않으므로 페이지 자체 JavaScript를 실행하는 엔진이 필요합니다. Puppeteer는 헤드리스 Chrome을 제어하며 요소 대기, 클릭, 스크롤을 수행할 수 있습니다. 아래 예제는 선택자를 기다린 다음 무한 스크롤 로딩을 유발하도록 반복 스크롤하고 브라우저 컨텍스트 안에서 데이터를 추출합니다:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();
await page.setUserAgent('Mozilla/5.0 (compatible; MyScraper/1.0)');
await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });

// wait until the first batch of cards is present
await page.waitForSelector('.product');

// infinite scroll: scroll to the bottom until height stops growing
let previousHeight = 0;
for (let i = 0; i < 20; i++) {
  const height = await page.evaluate('document.body.scrollHeight');
  if (height === previousHeight) break;
  previousHeight = height;
  await page.evaluate('window.scrollTo(0, document.body.scrollHeight)');
  await new Promise((r) => setTimeout(r, 1500));
}

const items = await page.evaluate(() =>
  Array.from(document.querySelectorAll('.product')).map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
페이지 높이 증가가 멈추면 새 콘텐츠가 로드되지 않는다는 신호이므로 루프가 즉시 중지되며, 20회 스크롤의 엄격한 상한은 무한 루프를 방지합니다. 이러한 대상 유형에 관한 자세한 내용은 동적 웹페이지 스크래핑하기.
Puppeteer의 대안으로 Playwright를 어떻게 사용합니까?
Playwright는 Puppeteer와 거의 동일하게 작동하지만 Chromium, Firefox, WebKit을 우선적으로 지원하고 불안정한 선택자를 줄이는 자동 대기 로케이터를 추가로 제공합니다.
Playwright는 초기 Puppeteer 엔지니어 일부가 개발했으며 API 대부분을 공유하므로, 마이그레이션은 보통 몇몇 호출 이름을 바꾸는 일입니다. 로케이터는 요소가 실행 가능한 상태가 될 때까지 자동으로 기다리므로 많은 수동 waitForSelector 호출이 필요 없어집니다. 동등한 스크래퍼는 다음과 같습니다:
import { chromium } from 'playwright';

const browser = await chromium.launch({ headless: true });
const context = await browser.newContext({
  userAgent: 'Mozilla/5.0 (compatible; MyScraper/1.0)'
});
const page = await context.newPage();
await page.goto('https://example.com/feed', { waitUntil: 'networkidle' });

await page.locator('.product').first().waitFor();

const items = await page.locator('.product').evaluateAll((els) =>
  els.map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
동일한 스크래퍼를 여러 브라우저 엔진에서 테스트해야 하거나 내장 네트워크 모킹이 필요하면 Playwright를 선택하십시오. Chrome만 대상으로 하고 더 작은 의존성을 원한다면 Puppeteer를 선택하십시오. 둘 다 fetch와 cheerio보다 훨씬 많은 메모리를 사용하므로 실제로 렌더링이 필요한 페이지에만 사용해야 합니다.
어떤 JavaScript 스크래핑 도구를 선택해야 합니까?
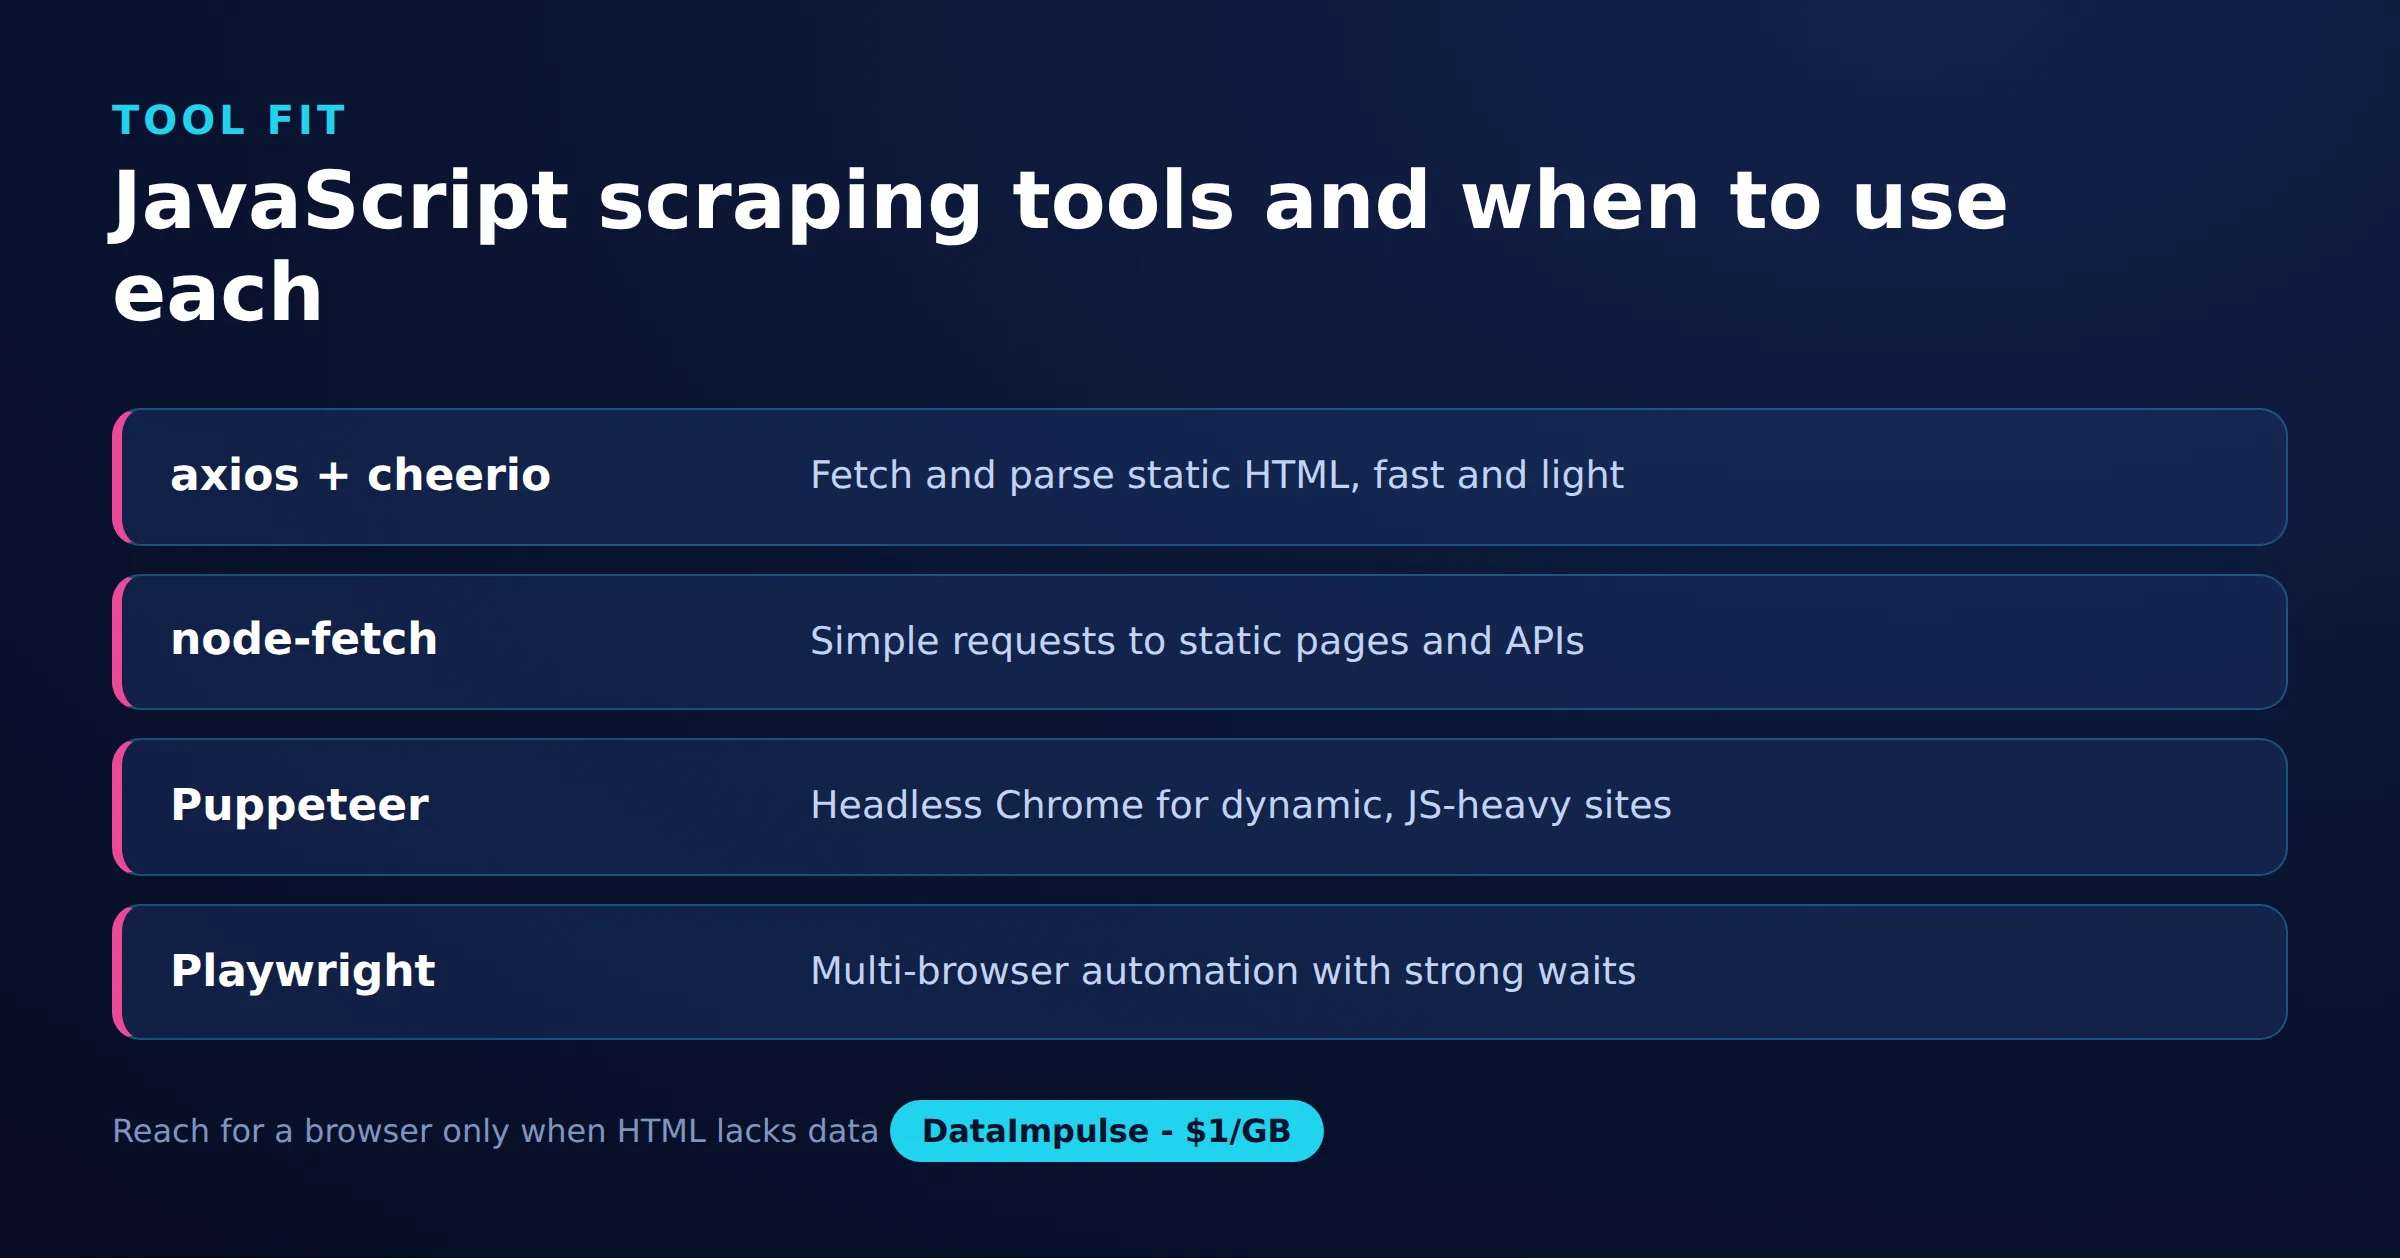
정적 HTML에는 cheerio와 fetch 또는 axios를 사용하고, 페이지가 브라우저에서 데이터를 렌더링할 때만 Puppeteer 또는 Playwright를 사용하십시오.
올바른 도구는 페이지의 데이터 제공 방식과 렌더링 충실도보다 속도를 얼마나 중시하는지에 따라 달라집니다. HTTP 클라이언트는 빠르고 가볍지만 JavaScript를 실행할 수 없고, 헤드리스 브라우저는 실제 사용자가 보는 모든 것을 실행하지만 더 많은 메모리와 시간이 듭니다. 아래 표는 이러한 절충점을 요약합니다:
| 도구 | JS 실행 | 속도 | 적합한 용도 |
|---|---|---|---|
| fetch + cheerio | 아니요 | 가장 빠름 | 정적 HTML, 대량 처리 |
| axios + cheerio | 아니요 | 빠름 | 정적 HTML, 간편한 프록시 설정 |
| Puppeteer | 예 | 느림 | 동적 Chrome 전용 페이지 |
| Playwright | 예 | 느림 | 동적, 크로스 브라우저 테스트 |
일반적인 프로덕션 패턴은 두 방식을 혼합합니다. 렌더링이 필요한 페이지나 엔드포인트에만 헤드리스 브라우저를 사용하고, 대부분의 요청에는 일반 HTTP 클라이언트를 사용합니다. JavaScript는 이 작업에 사용할 수 있는 여러 스택 중 하나입니다. 생태계를 비교 중이라면 Rust 웹 스크래핑 가이드에서 컴파일 방식의 대안을 다룹니다.
JavaScript 스크래퍼를 프록시를 통해 어떻게 라우팅합니까?
요청이 다른 IP 주소에서 나가도록 HTTP 클라이언트 또는 브라우저 실행 옵션에 프록시 설정을 전달하면 부하가 분산되고 단일 주소에 속도 제한이 걸릴 가능성이 줄어듭니다.
하나의 IP에서 많은 페이지를 스크래핑하면 가장 빠르게 차단됩니다. 주소 풀 전체로 요청을 로테이팅하면 트래픽이 여러 개별 방문자처럼 보입니다. axios에서는 요청 설정에 프록시 호스트, 포트, 자격 증명을 제공합니다. 아래 예제는 DataImpulse 게이트웨이를 통해 라우팅합니다:
import axios from 'axios';

const { data } = await axios.get('https://example.com', {
  proxy: {
    protocol: 'http',
    host: 'gw.dataimpulse.com',
    port: 823,
    auth: { username: 'YOUR_USERNAME', password: 'YOUR_PASSWORD' }
  },
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
});
console.log(data.length, 'bytes received through the proxy');
Chrome은 프록시 URL 내부의 자격 증명을 허용하지 않으므로 Puppeteer는 프록시를 실행 인수로 받고 페이지에서 인증합니다. 사용자 이름과 비밀번호가 있는 프록시 객체를 직접 받는 Playwright에서도 패턴은 같습니다:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({
  headless: 'new',
  args: ['--proxy-server=gw.dataimpulse.com:823']
});
const page = await browser.newPage();
await page.authenticate({
  username: 'YOUR_USERNAME',
  password: 'YOUR_PASSWORD'
});
await page.goto('https://example.com', { waitUntil: 'networkidle2' });
console.log(await page.title());
await browser.close();
DataImpulse는 레지덴셜 프록시, 데이터센터 프록시, and 모바일 프록시를 HTTP, HTTPS 및 SOCKS5로 제공하며 로테이팅 및 스티키 세션을 지원합니다. 국가 타기팅은 포함되며 주, 도시, ZIP 및 ASN 타기팅은 유료 추가 기능입니다. 프록시 요청에서 인증 오류가 반환되면 HTTP 오류 407에서 가장 일반적인 원인을 설명하며, 프록시 인증 가이드에서 자격 증명 형식을 더 자세히 다룹니다.
XHR 및 JSON 엔드포인트를 어떻게 가로챕니까?
렌더링된 HTML을 스크래핑하는 대신 헤드리스 브라우저에서 네트워크 트래픽을 관찰하고 페이지가 백그라운드에서 가져오는 JSON 응답을 읽으십시오. 이 방식이 흔히 더 깔끔하고 빠릅니다.
동적 페이지는 보통 JSON을 반환하는 숨겨진 API에서 데이터를 가져옵니다. 해당 응답을 직접 읽으면 DOM 파싱을 완전히 건너뛰고 잘 구조화된 레코드를 얻습니다. Puppeteer와 Playwright 모두 응답을 수신하고 원하는 응답을 캡처할 수 있습니다. 아래 Puppeteer 예제는 API 경로의 모든 JSON 응답을 캡처합니다:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();

const captured = [];
page.on('response', async (response) => {
  const url = response.url();
  if (url.includes('/api/') && response.headers()['content-type']?.includes('application/json')) {
    try {
      captured.push(await response.json());
    } catch (err) {
      // non-JSON body, ignore
    }
  }
});

await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });
console.log(`Captured ${captured.length} JSON payloads`);
await browser.close();
엔드포인트 URL과 매개변수를 알게 되면 흔히 브라우저를 완전히 제외하고 페이지가 보낸 것과 동일한 헤더를 전달하여 일반 fetch로 JSON API를 호출할 수 있습니다. 그러면 렌더링된 스크래퍼의 완전성과 정적 스크래퍼의 속도를 모두 얻을 수 있으며, 동적 사이트에서 가능한 가장 큰 단일 성능 향상입니다.
웹 스크래핑의 윤리적 및 법적 한계는 무엇입니까?
공개 데이터만 스크래핑하고, 사이트의 robots.txt와 서비스 약관을 존중하며, 개인정보를 피하고, 서버에 과부하를 주지 마십시오. 이러한 관행은 프로젝트를 정당화 가능하고 지속 가능하게 유지합니다.
도메인 루트의 robots.txt 파일을 확인하여 사이트가 크롤러에게 피하도록 요청하는 경로를 파악하고, 그러한 요청을 진지하게 다루십시오. 정직한 User-Agent로 스크래퍼를 식별하고 요청 속도를 조절하며, 동일한 페이지를 불필요하게 다시 가져오지 않도록 응답을 캐시하십시오. 인프라 측면에서는 IP 주소의 출처가 중요합니다. DataImpulse는 윤리적 프록시를 운영합니다. 이는 참여에 동의하고 보상을 받는 사용자에게서 확보하며 GDPR에 부합하고 데이터 처리 계약을 제공합니다. 윤리는 단지 컴플라이언스 문제가 아닙니다. 예의 바르고 투명한 스크래퍼가 계속 작동하기도 합니다. 지속 가능한 수집의 원칙은 윤리적 웹 스크래핑.
자주 묻는 질문
JavaScript로 스크래핑하려면 Node.js가 필요합니까?
간단한 한 페이지 테스트를 넘어서는 작업이라면 필요합니다. Node.js를 사용하면 서버에서 스크래퍼를 실행하고, 많은 URL을 반복 처리하며, 재시도를 처리하고, 데이터를 내보내고, 프록시를 사용할 수 있습니다. 브라우저 콘솔은 이러한 작업을 제대로 수행하지 못합니다.
fetch와 cheerio 대신 Puppeteer는 언제 사용해야 합니까?
데이터가 초기 HTML 응답에 있으면 cheerio와 fetch 또는 axios를 사용하십시오. 헤드리스 브라우저는 훨씬 무거우므로, 페이지가 로드된 후 JavaScript가 콘텐츠를 렌더링하는 경우에만 Puppeteer 또는 Playwright로 전환하십시오.
Node.js에서 스크래핑한 데이터를 CSV로 어떻게 내보냅니까?
레코드를 객체 배열로 수집한 다음 각 객체의 값을 연결하고 따옴표와 쉼표를 이스케이프하여 쉼표로 구분된 행을 만드십시오. 내장 fs 모듈로 결과를 파일에 쓰거나 csv-stringify 같은 라이브러리를 사용하십시오.
JavaScript로 스크래핑할 때 왜 차단됩니까?
일반적인 원인은 하나의 IP에서 보내는 과도한 요청, 없거나 의심스러운 User-Agent, 요청 사이에 지연이 없는 경우입니다. 로테이팅 프록시, 현실적인 헤더, 백오프 재시도 및 속도 제한은 차단을 줄입니다.
JavaScript 스크래핑에는 어떤 프록시 유형이 가장 적합합니까?
데이터센터 프록시는 관대한 대상에서 빠르고 저렴하며, 레지덴셜 및 모바일 프록시는 엄격한 사이트에서 실제 사용자에 더 가깝게 보입니다. 로테이팅 세션은 많은 주소에 요청을 분산하는 데 도움이 됩니다.
DataImpulse가 적합하지 않은 경우는 언제입니까?
고정 ISP 프록시, 완전 관리형 스크래핑 API 또는 은행 및 정부 사이트 접근이 필요하다면 DataImpulse는 적합한 도구가 아닙니다. 공개 데이터를 수집하고 콘텐츠에 접근하기 위한 로테이팅 레지덴셜, 모바일 및 데이터센터 프록시에 중점을 둡니다.
신뢰할 수 있는 프록시로 스크래핑 시작하기
지속적인 차단 없이 JavaScript 스크래퍼를 계속 실행할 준비가 되셨습니까? DataImpulse는 GB당 1 dollar부터 시작하는 윤리적으로 확보한 레지덴셜, 모바일 및 데이터센터 IP와 만료되지 않는 트래픽을 제공하며 구독이 없습니다. 계정 만들기하고 오늘 첫 스크래퍼를 프록시를 통해 라우팅하십시오.