
In this Article
Nauka web scraping dynamicznych stron oznacza pracę z treścią, której nie ma w HTML pobranym przez pierwsze żądanie. Nowoczesne serwisy tworzą w przeglądarce siatki produktów, ceny, komentarze i kanały za pomocą JavaScript, dlatego zwykłe pobranie przez HTTP zwraca pusty szkielet zamiast danych.
Ten przewodnik omawia pełny proces w Python. Zaczyna od wykrywania dynamicznej treści przez porównanie surowej odpowiedzi z wyrenderowanym DOM, a następnie porządkuje opcje ekstrakcji od najtańszej do najbardziej zasobożernej: znalezienie ukrytego JSON API, użycie Playwright lub Selenium, obsługę infinite scroll i przycisków ładowania większej liczby elementów, ograniczanie transferu proxy, dodawanie ponownych prób, równoległy web scraping oraz eksport czystych JSON i CSV.
DataImpulse to etyczny dostawca proxy, oferujący ponad 90 milionów adresów IP residential, mobile i datacenter w 195 krajach. Stosuje model pay-as-you-go od 1 dolar za GB z transferem bez daty wygaśnięcia i jest używany do web scraping, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
- Dynamiczny web scraping: Treść tworzona przez JavaScript nie występuje w surowym HTML, dlatego musisz wywołać bazowe JSON API pobierane przez stronę albo wyrenderować stronę w przeglądarce headless.
- Najlepszy typ proxy: rotujące residential proxy, które używają prawdziwych konsumenckich IP i omijają wykrywanie.
- Cena: od 1 dolar za GB, pay-as-you-go, z transferem bez daty wygaśnięcia i bez subskrypcji.
- Zasięg: Ponad 90 mln etycznie pozyskanych IP w 195 krajach.
- Niezawodność: wskaźnik powodzenia 99,51%, ocena 4,8 na 5 w G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem na kraje w pakiecie.
Co sprawia, że strona internetowa jest dynamiczna?
Strona jest dynamiczna, gdy istotna treść jest tworzona przez JavaScript w przeglądarce, zamiast być dostarczana w początkowej odpowiedzi HTML. Serwer wysyła lekki szkielet, a kod po stronie klienta następnie pobiera dane i wstawia je do DOM po otwarciu strony.
Najszybsza ręczna kontrola polega na porównaniu dwóch widoków tej samej strony. Kliknij prawym przyciskiem i wybierz Wyświetl źródło strony, aby zobaczyć surowy HTML zwrócony przez serwer, potem otwórz narzędzia deweloperskie i sprawdź panel Elements, który pokazuje aktualny DOM po uruchomieniu skryptów. Jeśli interesująca Cię cena lub pozycja widnieje w panelu Elements, ale nie ma jej w źródle strony, treść jest dynamiczna i pojedyncze żądanie jej nie przechwyci.
- Treść statyczna występuje w źródle strony i można ją analizować bezpośrednio z odpowiedzi HTTP.
- Treść dynamiczna pojawia się wyłącznie w wyrenderowanym DOM i jest ładowana za pomocą żądań w tle.
Możesz zautomatyzować tę diagnozę w kodzie. Najpierw policz docelowe elementy w surowym HTML pobieranym przez zwykłego klienta HTTP:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/products"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=30)
soup = BeautifulSoup(resp.text, "html.parser")

raw_cards = soup.select("div.product-card")
print("Cards in raw HTML:", len(raw_cards))

# If this prints 0 but the page clearly shows products in a browser,
# the content is injected by JavaScript and the page is dynamic.
Następnie wyrenderuj ten sam URL w przeglądarce headless i policz je ponownie. Różnica między tymi dwiema liczbami jest dowodem:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()
    page.goto("https://example.com/products", wait_until="networkidle")
    rendered_cards = page.query_selector_all("div.product-card")
    print("Cards after JavaScript runs:", len(rendered_cards))
    browser.close()

# Raw HTML 0, rendered DOM 48 means the page builds its content dynamically.
Przed napisaniem pełnego scrapera warto też potwierdzić, że cel zezwala na zautomatyzowany dostęp. Nasz przewodnik, jak sprawdzić, czy strona zezwala na scraping omawia odczytywanie reguł robots i warunków świadczenia usług.
Jakiej metody użyć do web scraping dynamicznych stron?
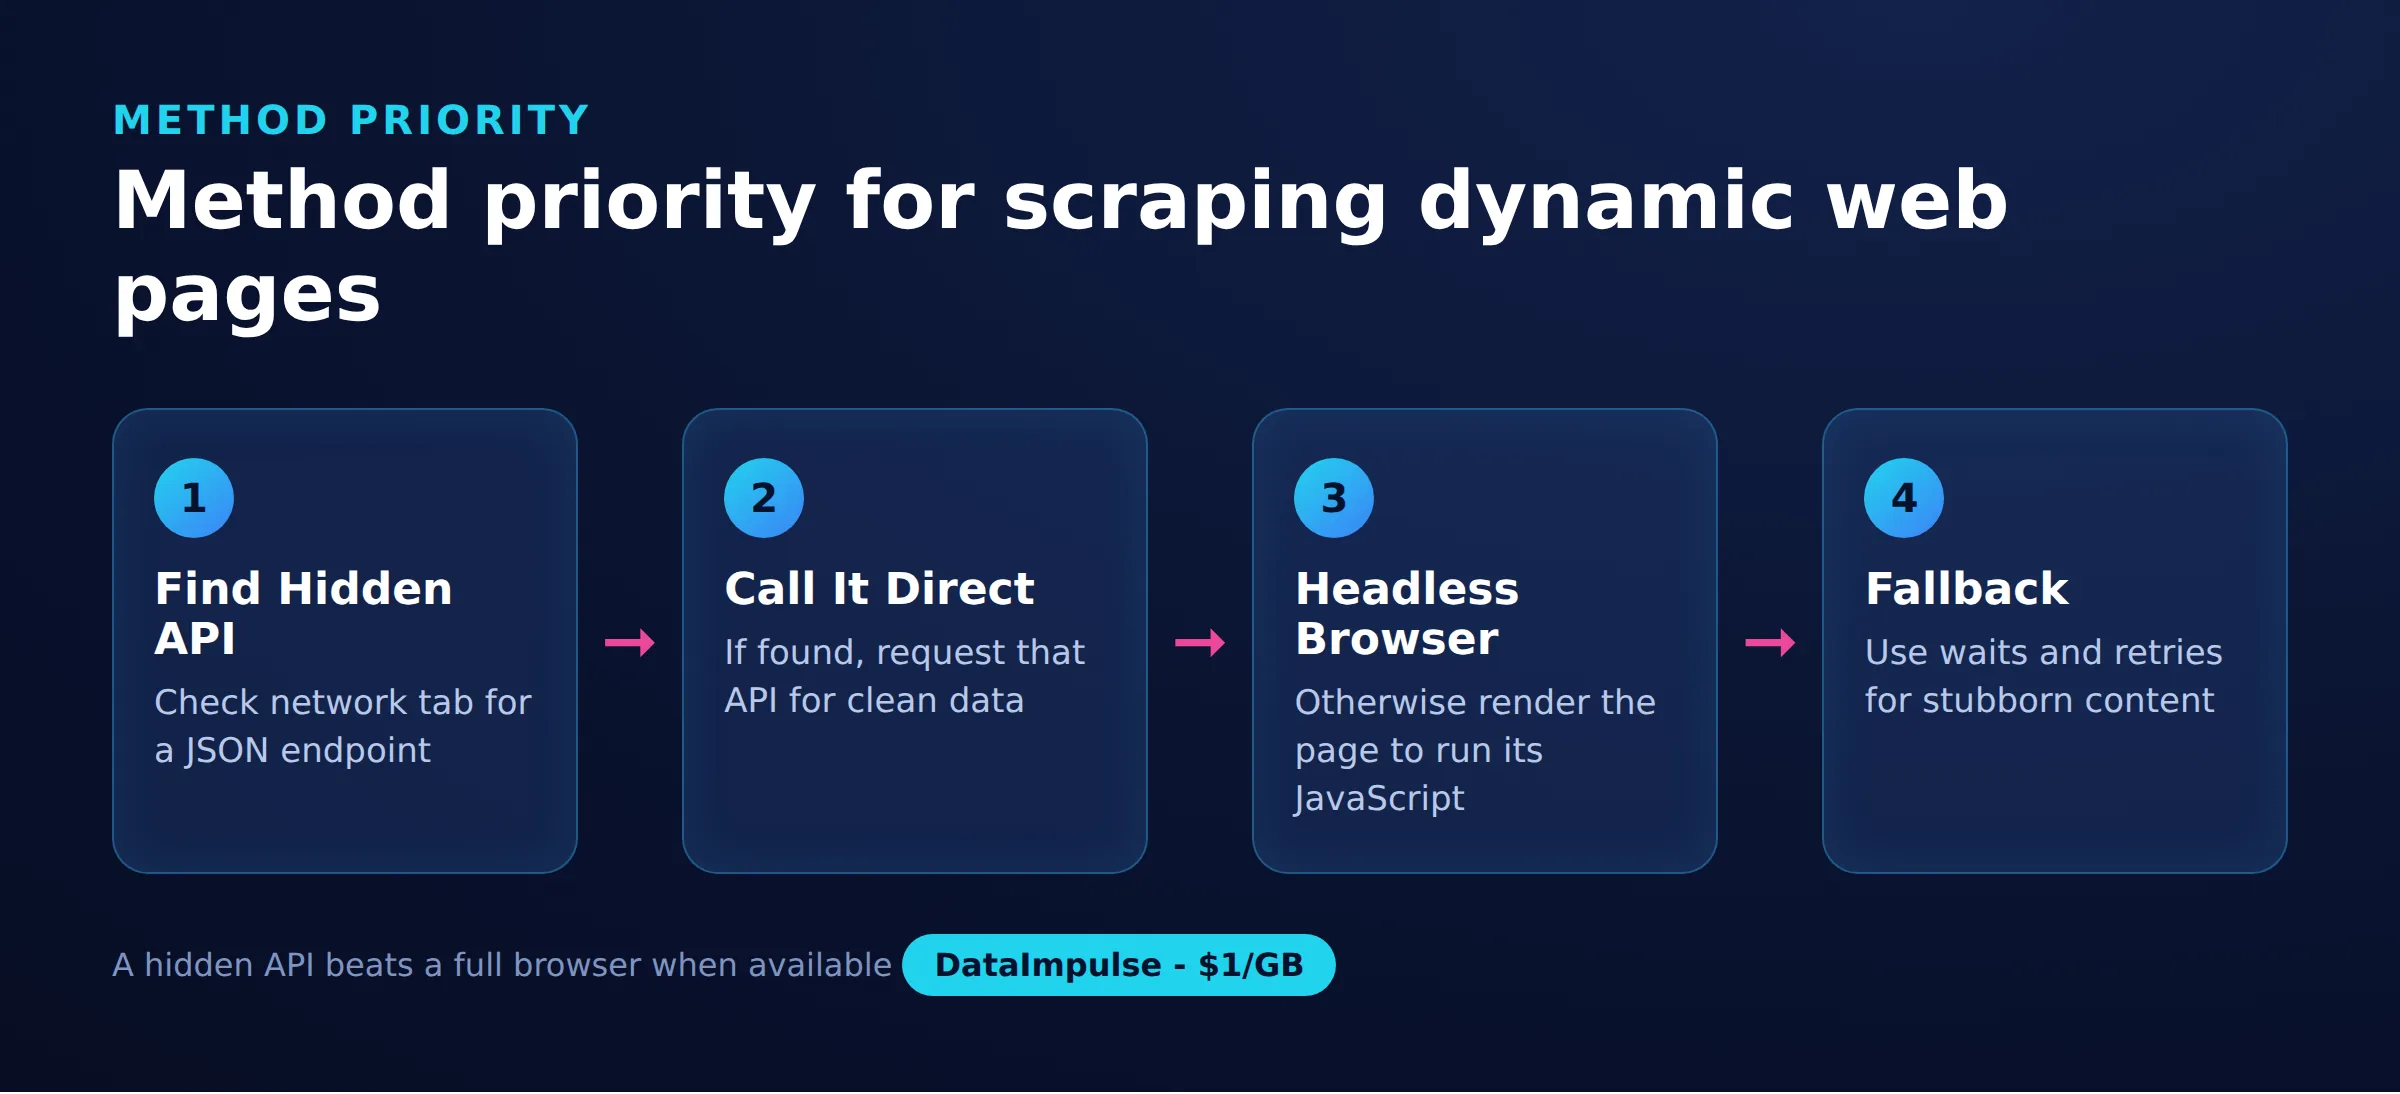
Wybierz najlżejszą metodę, która niezawodnie zwraca dane: wywołaj ukryte JSON API, gdy istnieje, a po przeglądarkę headless sięgaj tylko wtedy, gdy go nie ma. Każda opcja równoważy szybkość i koszt z zakresem odtworzenia strony.
Poniższa tabela porównuje cztery popularne podejścia, abyś mógł wybrać przed napisaniem kodu. W praktyce większość projektów łączy dwa z nich, używając ukrytego API do masowego pobierania i przeglądarki dla stron, które mu się opierają.
| Metoda | Szybkość | Koszt | Najlepsze zastosowanie | Główne ograniczenie |
|---|---|---|---|---|
| Ukryte JSON API | Najszybsza | Najniższy | Dane za przejrzystym wywołaniem XHR | Endpoint może się zmienić lub wymagać tokenów |
| Playwright | Umiarkowana | Wyższy | Pełne renderowanie, nowoczesna kontrola async | Zużywa CPU, pamięć i transfer |
| Selenium | Umiarkowana | Wyższy | Starsze stosy, szeroka obsługa języków | Wolniejsza konfiguracja, bardziej rozbudowane oczekiwania |
| requests-html | Wolna | Niski | Lekki JavaScript na prostych stronach | W dużej mierze nieutrzymywane, kruche renderowanie |
Koszt ma znaczenie, ponieważ przeglądarka headless kierowana przez rozliczane według transferu proxy pobiera znacznie więcej bajtów niż pojedyncze wywołanie API. Jeśli prowadzisz web scraping na dużą skalę, wybrana metoda wpływa na rachunek równie mocno jak kod. Więcej o tempie żądań i nagłówkach znajdziesz w naszym przewodniku najlepsze praktyki web scraping.
Jak znaleźć ukryte API stojące za dynamiczną stroną?
Poszukaj żądania w tle, które strona wykonuje, by pobrać dane, ponieważ ten endpoint zwykle zwraca czysty JSON, który możesz wywołać bezpośrednio. To najszybsze i najbardziej niezawodne podejście, które całkowicie eliminuje uruchamianie przeglądarki.
Otwórz narzędzia deweloperskie, przejdź do karty Network, filtruj według Fetch/XHR i odśwież stronę. Gdy pojawia się treść, obserwuj żądania zwracające JSON zawierający potrzebne wartości. Sprawdź URL żądania, metodę, parametry zapytania oraz wysyłane nagłówki i tokeny, a następnie kliknij prawym przyciskiem i skopiuj jako cURL, by zobaczyć pełną postać. Gdy potrafisz odtworzyć to wywołanie klientem HTTP, całkowicie pomijasz renderowanie i pobierasz ustrukturyzowane dane za ułamek kosztu.
Oto minimalny przykład wywołujący endpoint JSON przez proxy i odczytujący pola bezpośrednio:
import requests

proxy = "http://USERNAME:[email protected]:823"
proxies = {"http": proxy, "https": proxy}

headers = {
    "User-Agent": "Mozilla/5.0",
    "Accept": "application/json",
    "Referer": "https://example.com/products",
}
params = {"category": "laptops", "page": 1}

r = requests.get(
    "https://example.com/api/v2/products",
    headers=headers,
    params=params,
    proxies=proxies,
    timeout=30,
)
r.raise_for_status()
data = r.json()

for item in data["items"]:
    print(item["name"], item["price"])
Jeśli endpoint jest stronicowany, zwiększaj parametr page albo podążaj za następnym kursorem zwracanym przez odpowiedź. Gdy żądanie potrzebuje tokenu, ustal, gdzie strona wydaje go po raz pierwszy, i odtwórz je w tej samej sesji. Kierowanie wywołania przez DataImpulse oznacza, że endpoint widzi residential IP zamiast adresu Twojego serwera, co ma znaczenie, gdy API ogranicza liczbę żądań według źródła. Jeśli napotkasz barierę uwierzytelniania na samym proxy, nasza notatka o uwierzytelnianiu proxy wyjaśnia format poświadczeń.
Jak prowadzić web scraping dynamicznych stron za pomocą Playwright?
Gdy nie ma przejrzystego API do wywołania, użyj przeglądarki headless, takiej jak Playwright, aby JavaScript wykonał się dokładnie tak jak u użytkownika, a potem odczytaj gotowy DOM. Playwright jest nowoczesnym wyborem domyślnym, ponieważ oferuje niezawodne automatyczne oczekiwanie, pełną obsługę async i prostą opcję proxy.
Najpierw zainstaluj go i pobierz plik binarny przeglądarki:
pip install playwright
playwright install chromium
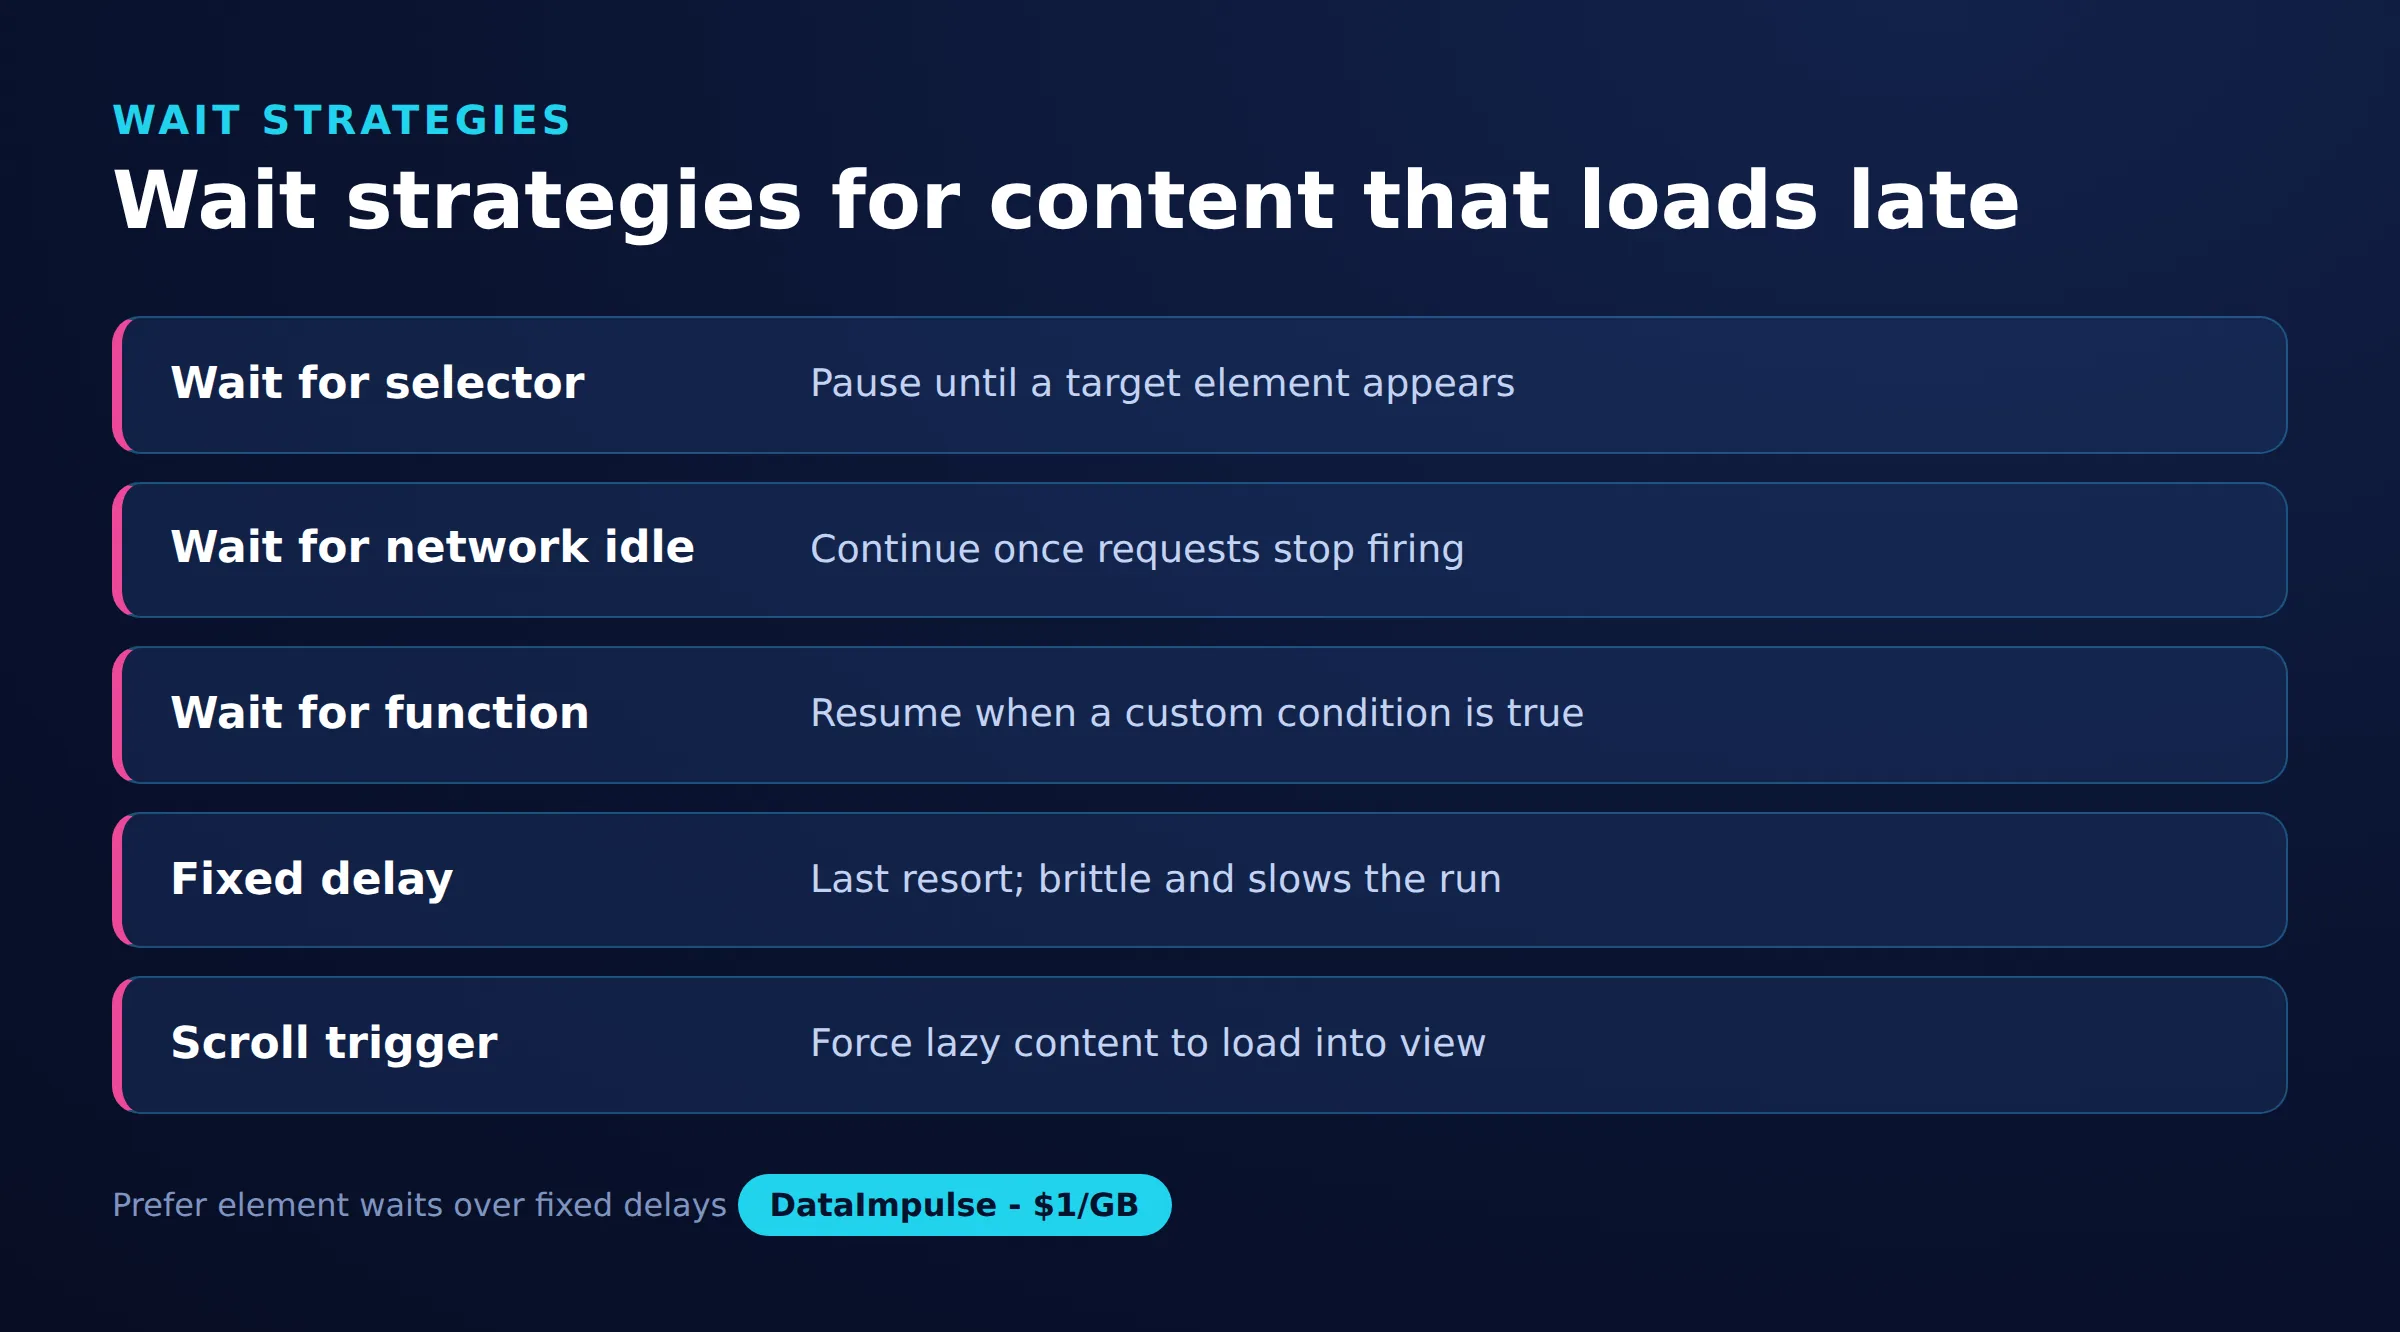
Kluczową zasadą jest oczekiwanie na konkretny potrzebny element zamiast zgadywania przy użyciu stałych opóźnień. Poniższy przykład uruchamia Chromium, kieruje je przez proxy w formie słownika, czeka na siatkę produktów i wyodrębnia wyrenderowane wartości:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True, proxy=PROXY)
    context = browser.new_context(user_agent="Mozilla/5.0")
    page = context.new_page()
    page.goto("https://example.com/products", wait_until="domcontentloaded")

    page.wait_for_selector("div.product-card", timeout=15000)

    cards = page.query_selector_all("div.product-card")
    for card in cards:
        name = card.query_selector(".title").inner_text()
        price = card.query_selector(".price").inner_text()
        print(name, price)

    browser.close()
Oczekiwanie to obszar, w którym większość dynamicznych scraperów odnosi sukces lub ponosi porażkę, dlatego warto znać cztery strategie i wiedzieć, kiedy każda z nich pasuje. Wybieraj oczekiwanie na konkretny selektor lub warunek zamiast networkidle, które może zawieszać się na stronach utrzymujących długotrwałe połączenia:
# Wait for a specific element (most reliable)
page.wait_for_selector("div.product-card", timeout=15000)

# Wait for the initial DOM to be built, before every script finishes
page.goto(url, wait_until="domcontentloaded")

# Wait until there are no network connections for 500 ms
page.goto(url, wait_until="networkidle")

# Wait for a custom condition, such as a minimum item count
page.wait_for_function(
    "document.querySelectorAll('div.product-card').length > 20"
)
Jeśli Twój cel mocno opiera się na skryptach uruchamianych w przeglądarce, nasz uzupełniający artykuł o web scraping z JavaScript dokładniej omawia renderowanie po stronie klienta, które czyni te strony trudnymi.
Jak obsługiwać infinite scroll i przyciski ładowania większej liczby elementów?
Wywołuj te same zdarzenia, których strona używa do ładowania kolejnej treści, a potem czekaj na wyrenderowanie każdej nowej partii przed jej odczytem. Infinite scroll i przyciski ładowania większej liczby elementów pobierają dane tylko podczas działania użytkownika, więc pojedyncze załadowanie strony przechwytuje jedynie pierwszy ekran.
Zanim użyjesz przeglądarki, ponownie sprawdź kartę Network, ponieważ infinite scroll jest prawie zawsze zasilany stronicowanym wywołaniem XHR, a iterowanie po tym endpoincie z użyciem opisanego wyżej podejścia requests jest znacznie tańsze niż przewijanie. Jeśli musisz przewijać, rób to w kontrolowanej pętli, która zatrzymuje się, gdy nie pojawiają się nowe elementy:
def scroll_until_stable(page, item_selector, max_rounds=30):
    seen = 0
    for _ in range(max_rounds):
        page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
        page.wait_for_timeout(1500)
        count = len(page.query_selector_all(item_selector))
        if count == seen:
            break            # no new items loaded, stop
        seen = count
    return seen
Strony używające jawnego przycisku zamiast przewijania potrzebują pętli kliknięć. Odczytaj liczbę elementów przed każdym kliknięciem, kliknij przycisk i poczekaj, aż liczba wzrośnie, aby nigdy nie wyprzedzić renderowania:
def click_load_more(page, button_selector, item_selector, max_clicks=50):
    for _ in range(max_clicks):
        button = page.query_selector(button_selector)
        if button is None or not button.is_visible():
            break
        before = len(page.query_selector_all(item_selector))
        button.click()
        page.wait_for_function(
            "([sel, n]) => document.querySelectorAll(sel).length > n",
            arg=[item_selector, before],
        )
    return len(page.query_selector_all(item_selector))
Usuwaj duplikaty podczas zbierania, ponieważ ponowne odczytywanie tych samych węzłów przy każdym przebiegu jest częste. Zachowuj zbiór unikalnych ID lub URL i dodawaj tylko rekordy, których jeszcze nie widziałeś.
Czy możesz użyć Selenium zamiast Playwright?
Tak, Selenium steruje prawdziwą przeglądarką w ten sam sposób i jest dobrym wyborem, gdy Twój zespół już go używa albo potrzebuje szerokiej obsługi języków. Wzorzec odzwierciedla Playwright: załaduj stronę, poczekaj na warunek za pomocą WebDriverWait, a następnie odczytaj elementy z wyrenderowanego DOM.
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

options = Options()
options.add_argument("--headless=new")
options.add_argument("--proxy-server=http://gw.dataimpulse.com:823")

driver = webdriver.Chrome(options=options)
driver.get("https://example.com/products")

WebDriverWait(driver, 15).until(
    EC.presence_of_element_located((By.CSS_SELECTOR, "div.product-card"))
)

for card in driver.find_elements(By.CSS_SELECTOR, "div.product-card"):
    name = card.find_element(By.CSS_SELECTOR, ".title").text
    price = card.find_element(By.CSS_SELECTOR, ".price").text
    print(name, price)

driver.quit()
Jedno zastrzeżenie: zwykła flaga –proxy-server nie przyjmuje nazwy użytkownika ani hasła, dlatego uwierzytelniane proxy potrzebuje pomocnika. Biblioteka Selenium Wire czysto wstawia poświadczenia, a nasz przewodnik po konfiguracji proxy Selenium Wire pokazuje dokładną konfigurację. Selenium jest bardziej wymagający w konfiguracji niż Playwright, a jego oczekiwania są bardziej rozbudowane, dlatego nowe projekty często zaczynają od Playwright, chyba że istnieje powód, by pozostać przy Selenium.
Jak ograniczyć transfer proxy podczas renderowania stron?
Blokuj zasoby, których nie potrzebujesz, aby przeglądarka przestała pobierać obrazy, czcionki i media, których nigdy nie analizujesz. Przeglądarka headless domyślnie pobiera każdy zasób, a każdy z tych bajtów kosztuje, gdy ruch jest kierowany przez proxy rozliczane za gigabajt.
Playwright pozwala przechwytywać żądania i przerywać te nieistotne dla ekstrakcji. Blokowanie obrazów, mediów i czcionek może znacznie ograniczyć transfer proxy, pozostawiając nietknięte JSON i HTML, które faktycznie odczytujesz:
BLOCK = {"image", "media", "font"}

def block_heavy(route):
    if route.request.resource_type in BLOCK:
        route.abort()
    else:
        route.continue_()

context = browser.new_context()
context.route("**/*", block_heavy)
page = context.new_page()
page.goto("https://example.com/products", wait_until="domcontentloaded")
Możesz rozszerzyć ten sam handler, aby pomijać domeny analityczne i reklamowe, które zwiększają obciążenie bez dodawania danych. Przy transferze DataImpulse rozliczanym pay-as-you-go od 1 dolar za GB i bez daty wygaśnięcia, ograniczenie marnowanych bajtów bezpośrednio obniża koszt każdego scrapingu. Ponowne użycie jednego kontekstu przeglądarki na powiązanych stronach także eliminuje powtarzający się koszt uruchomienia, a najtańsze pozostaje żądanie, którego unikasz dzięki ukrytemu API.
Jak dodać obsługę błędów i ponowne próby?
Otocz każdą nawigację pętlą ponownych prób z wykładniczym zwiększaniem przerw, aby pojedyncze wolne ładowanie lub przejściowa blokada nie kończyły całego uruchomienia. Dynamiczne strony zawodzą sporadycznie, a scraper, który poddaje się przy pierwszym limicie czasu, straci dużą część rekordów na dużą skalę.
Przechwytuj limit czasu zgłaszany przez Playwright, odczekaj rosnący czas i ponów próbę ograniczoną liczbę razy, zanim zapiszesz niepowodzenie i przejdziesz dalej:
import time
from playwright.sync_api import TimeoutError as PlaywrightTimeout

def fetch_with_retries(page, url, selector, retries=3, backoff=2):
    for attempt in range(1, retries + 1):
        try:
            page.goto(url, wait_until="domcontentloaded", timeout=30000)
            page.wait_for_selector(selector, timeout=15000)
            return page.query_selector_all(selector)
        except PlaywrightTimeout:
            wait = backoff ** attempt
            print(f"Attempt {attempt} timed out, retrying in {wait}s")
            time.sleep(wait)
    raise RuntimeError(f"Failed to load {url} after {retries} attempts")
Łącz ponowne próby z rotacją proxy, aby każda próba wychodziła przez świeże IP. Jeśli jedno wyjście jest ograniczone limitem, następne żądanie trafia na inny adres i często się udaje. Rotująca pula residential proxy lub mobile proxy automatycznie przypisuje nowe IP do każdego żądania, co zmienia wiele twardych blokad w prostą ponowną próbę. Szczegółowe informacje o obsłudze błędów na poziomie proxy znajdziesz w naszej notatce o błędzie HTTP 407 omawiającej najczęstszą odpowiedź uwierzytelniającą.
Jak prowadzić web scraping wielu dynamicznych stron równolegle?
Użyj async API Playwright z semaforem asyncio, aby kilka stron renderowało się jednocześnie bez przeciążania Twojego komputera ani celu. Równoległość przywraca przepustowość dynamicznemu web scraping, ponieważ każda strona przeglądarki spędza większość czasu na czekaniu na sieć.
Semafor ogranicza liczbę stron działających równolegle. Współdziel jedną przeglądarkę i kontekst między zadaniami, otwieraj stronę dla każdego URL i zbieraj wyniki:
import asyncio
from playwright.async_api import async_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

async def scrape_one(context, url, sem):
    async with sem:
        page = await context.new_page()
        try:
            await page.goto(url, wait_until="domcontentloaded")
            await page.wait_for_selector("div.product-card", timeout=15000)
            cards = await page.query_selector_all("div.product-card")
            return [await c.inner_text() for c in cards]
        finally:
            await page.close()

async def main(urls):
    sem = asyncio.Semaphore(5)   # at most 5 pages at once
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, proxy=PROXY)
        context = await browser.new_context()
        tasks = [scrape_one(context, u, sem) for u in urls]
        results = await asyncio.gather(*tasks)
        await browser.close()
    return results

urls = ["https://example.com/products?page=%d" % i for i in range(1, 21)]
data = asyncio.run(main(urls))
Utrzymuj umiarkowany limit równoległości. Zbyt wiele równoległych stron wyczerpuje pamięć i uruchamia limity liczby żądań, co kosztuje Cię więcej ponownych prób, niż oszczędza równoległość. Zacznij od około pięciu i zwiększaj go tylko, dopóki wskaźniki powodzenia pozostają wysokie.
Jak eksportować zebrane dane do JSON i CSV?
Zbieraj wyniki każdej strony do listy słowników, a następnie zapisz tę listę do JSON dla danych zagnieżdżonych albo CSV dla płaskich tabel wygodnych dla arkuszy kalkulacyjnych. Rozdzielenie ekstrakcji i eksportu ułatwia testowanie i ponowne uruchamianie scrapera.
import json
import csv

records = [
    {"name": "Laptop A", "price": "999"},
    {"name": "Laptop B", "price": "1299"},
]

# Export to JSON
with open("products.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)

# Export to CSV
with open("products.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price"])
    writer.writeheader()
    writer.writerows(records)
Wybierz JSON, gdy rekordy zawierają zagnieżdżone listy lub obiekty, a CSV, gdy każdy rekord ma te same płaskie pola i analitycy otworzą go w arkuszu kalkulacyjnym. Normalizuj pola przed zapisem, aby każdy rekord miał te same klucze, a etap eksportu pozostał prosty niezależnie od sposobu wyrenderowania dynamicznej strony. Następnie ten sam JSON może zasilić ładowanie bazy danych lub zadanie analityczne bez dalszego parsowania.
Często zadawane pytania
Jak rozpoznać, czy strona jest dynamiczna, zanim napiszesz scraper?
Porównaj źródło strony z panelem Elements w narzędziach deweloperskich albo policz docelowy element w surowym HTML i w wyrenderowanym DOM. Jeśli dane pojawiają się dopiero po uruchomieniu JavaScript, strona jest dynamiczna i potrzebuje wywołania API lub przeglądarki headless.
Czy lepiej wywołać ukryte API, czy użyć przeglądarki headless?
Wywołaj ukryte API, gdy potrafisz je znaleźć, ponieważ zwraca czysty JSON za ułamek kosztu renderowania i znacznie szybciej. Używaj przeglądarki headless tylko wtedy, gdy nie istnieje odtwarzalne API lub dane zależą od złożonych skryptów po stronie klienta.
Czy do dynamicznego web scraping użyć Playwright czy Selenium?
Playwright jest nowoczesnym wyborem domyślnym dzięki niezawodnemu automatycznemu oczekiwaniu i wbudowanej obsłudze async, dlatego nowe projekty zwykle od niego zaczynają. Selenium dobrze pasuje, gdy Twój stos już go używa albo potrzebujesz szerszej obsługi języków.
Jak ograniczyć transfer proxy podczas używania przeglądarki headless?
Przechwytuj żądania i przerywaj obrazy, czcionki, media oraz analitykę, których nie analizujesz. Może to znacznie ograniczyć transfer, ponieważ koszt proxy jest mierzony za gigabajt, a także przyspiesza ładowanie każdej strony.
Jak prowadzić web scraping treści ładowanej przez infinite scroll?
Najpierw sprawdź w karcie Network stronicowane wywołanie XHR stojące za przewijaniem i iteruj bezpośrednio po tym endpoincie. Jeśli musisz przewijać, rób to w kontrolowanej pętli i czekaj na wyrenderowanie każdej nowej partii przed jej odczytem.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego API do scrapingu lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotujących proxy residential, mobile i datacenter do zbierania danych publicznych oraz uzyskiwania dostępu do treści.
Powiązane przewodniki
Prowadź web scraping dynamicznych stron z niezawodnymi proxy
Jeśli Twój scraper potrzebuje IP residential, mobile lub datacenter zachowujących się jak prawdziwi odwiedzający, możesz zacząć od transferu pay-as-you-go od 1 dolar za GB. Utwórz konto DataImpulse i kieruj dynamiczny web scraping przez rotujące proxy lub sticky session.