
In this Article
คู่มือนี้อธิบายวิธีทำ web scraping ด้วย JavaScript โดยใช้ Node.js ซึ่งเป็น runtime ที่วิศวกรส่วนใหญ่มักเลือกใช้เมื่อต้องการเก็บข้อมูลสาธารณะในปริมาณมาก การเรียนรู้วิธีทำ web scraping ด้วย JavaScript หมายถึงการเลือกเครื่องมือให้เหมาะกับหน้าเว็บ: HTTP client ขนาดเบาสำหรับ HTML แบบคงที่ หรือ headless browser สำหรับเนื้อหาที่โหลดผ่านสคริปต์
ด้านล่างมีโค้ด Node.js ที่ใช้งานได้จริงและรันได้สำหรับทั้งสองกรณี รวมถึงการตั้งค่าโปรเจกต์ การส่งออกแบบมีโครงสร้างเป็น JSON และ CSV การแบ่งหน้า การลองใหม่พร้อม backoff การจำกัดอัตราคำขอ การยืนยันตัวตน proxy การดักจับ XHR ตลอดจนประเด็นด้านจริยธรรมและการบล็อกซึ่งเป็นตัวกำหนดว่า scraper จะทำงานต่อไปได้หรือไม่เมื่อเวลาผ่านไป
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรม โดยมีที่อยู่ IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการใน 195 ประเทศ ใช้โมเดลจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกไม่หมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- เครื่องมือ 2 ชุด: หน้าแบบคงที่ต้องมีเพียง HTTP client พร้อม parser เช่น fetch และ cheerio ส่วนหน้าแบบไดนามิกที่แสดงเนื้อหาในเบราว์เซอร์ต้องใช้ engine แบบ headless เช่น Puppeteer หรือ Playwright
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxies ซึ่งใช้ IP ของผู้บริโภคจริงที่หลบเลี่ยงการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน ทราฟฟิกไม่หมดอายุ และไม่มีค่าสมัครสมาชิก
- ความครอบคลุม: IP ที่ได้มาอย่างมีจริยธรรมมากกว่า 90M ใน 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
web scraping ด้วย JavaScript คืออะไร?
web scraping ด้วย JavaScript คือกระบวนการส่งคำขอไปยังหน้าเว็บและดึงข้อมูลแบบมีโครงสร้างจากหน้าเหล่านั้นด้วยโปรแกรม JavaScript โดยทั่วไปจะรันบน runtime Node.js แทนที่จะรันในแท็บเบราว์เซอร์
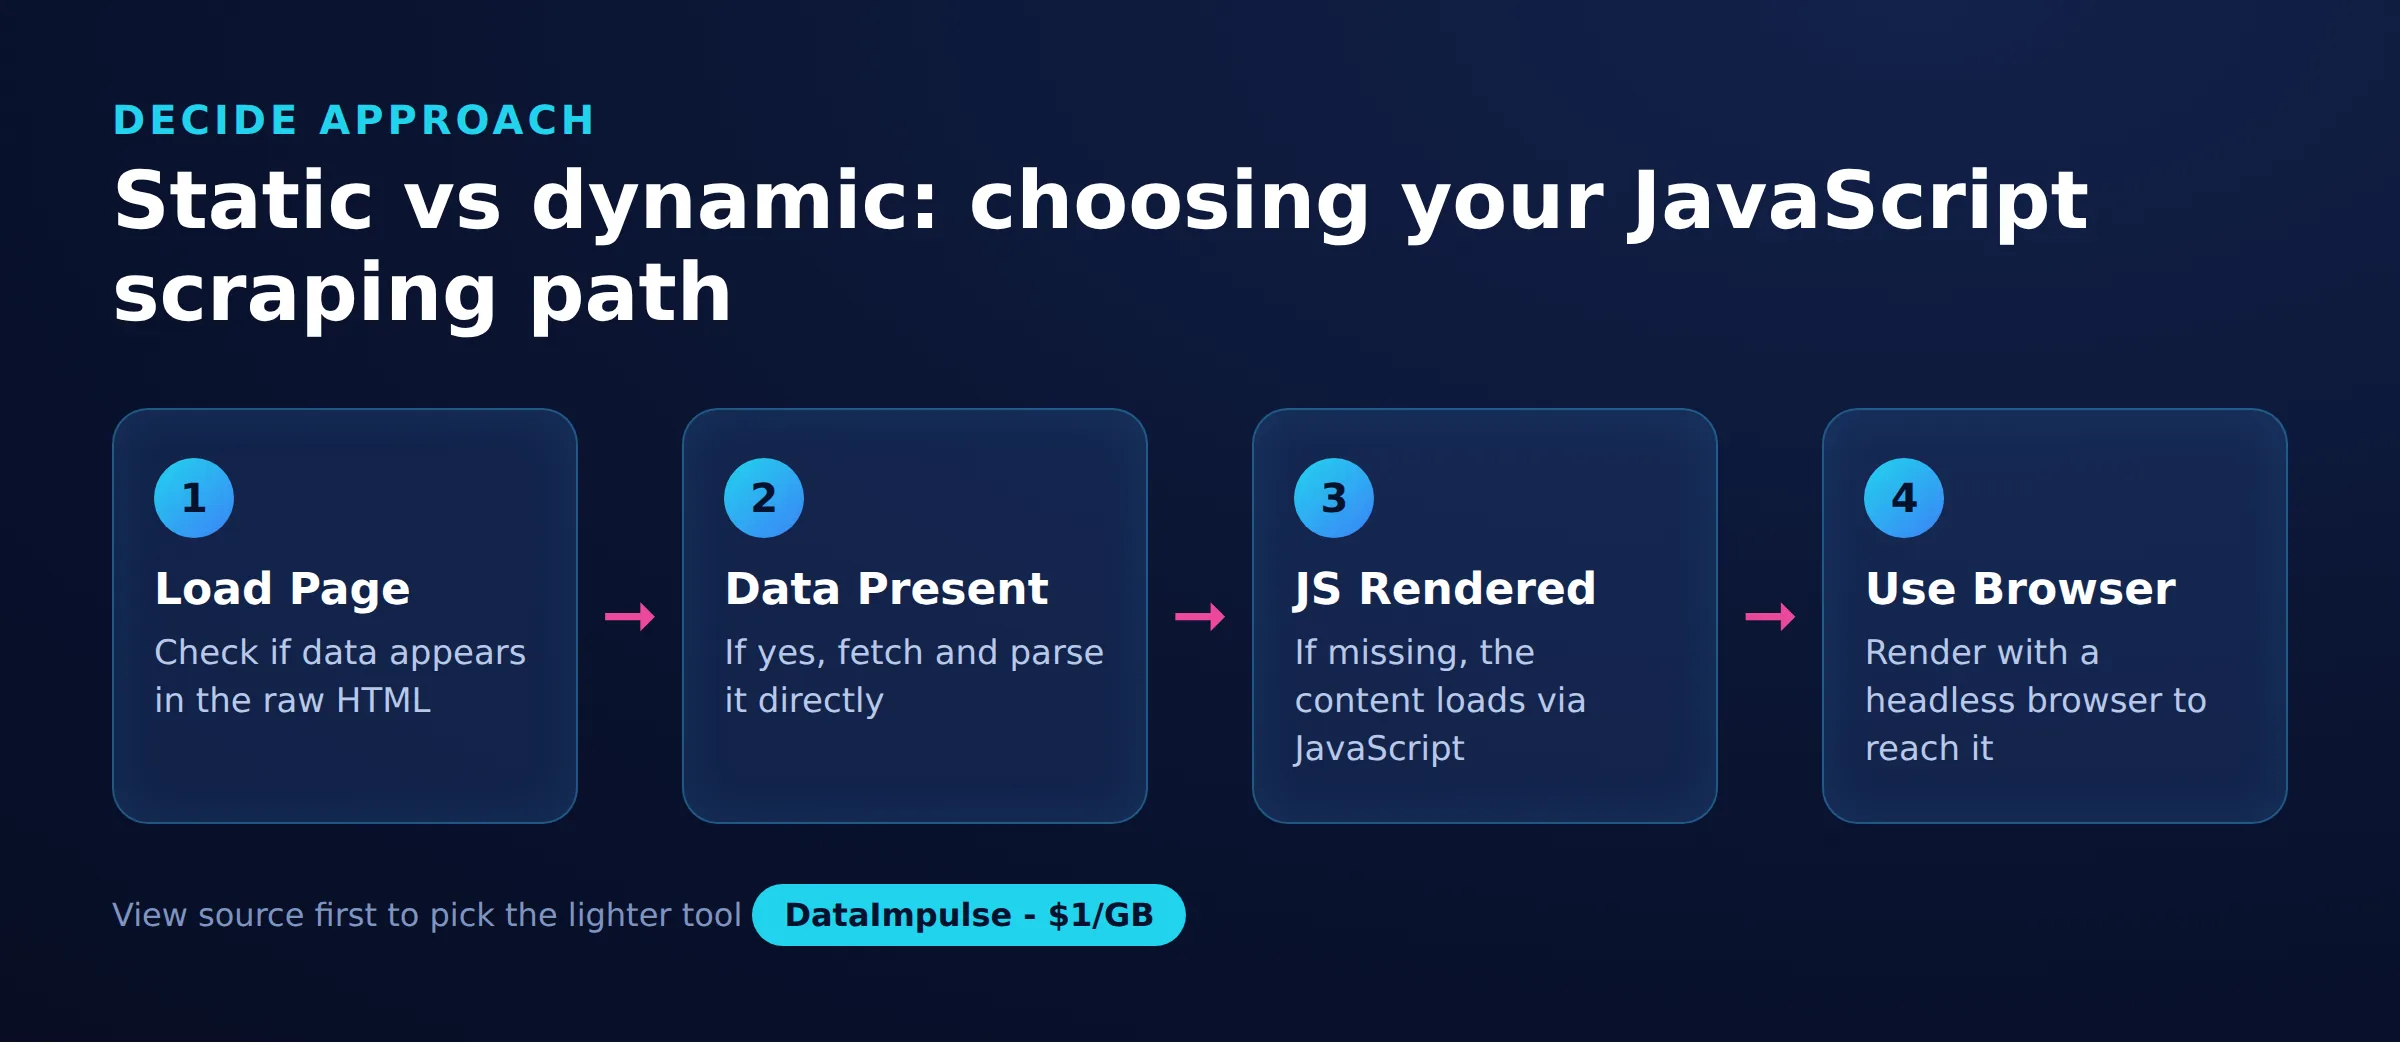
JavaScript เหมาะกับงานนี้โดยธรรมชาติ เพราะภาษานี้มีโมเดล Document Object Model อยู่แล้ว การเลือกองค์ประกอบจึงคุ้นเคยสำหรับนักพัฒนา front-end ในทางปฏิบัติ scraper ทำ 3 อย่าง: ดึงหน้าเว็บผ่าน HTTP แยกวิเคราะห์ markup ที่ตอบกลับมาเป็น tree ที่ค้นหาได้ และดึงฟิลด์ที่ต้องการ เช่น ชื่อ ราคา หรือลิงก์ ความซับซ้อนอยู่ที่วิธีที่หน้าเป้าหมายส่งข้อมูลมา จึงทำให้การเลือกเครื่องมือที่ถูกต้องสำคัญกว่าการแยกวิเคราะห์เอง หน้าแบบคงที่ส่งข้อมูลมากับการตอบกลับ HTML ครั้งแรก ขณะที่หน้าแบบไดนามิกประกอบข้อมูลในเบราว์เซอร์หลังโหลด และทั้งสองกรณีต้องใช้เครื่องมือคนละชุด
ตั้งค่าโปรเจกต์ scraping ด้วย Node.js อย่างไร?
สร้างโฟลเดอร์โปรเจกต์ เริ่มต้นด้วย npm และติดตั้งไลบรารีที่ต้องใช้ก่อนเขียนโค้ด scraping
Node.js 18 และเวอร์ชันใหม่กว่ามี fetch แบบ global มาให้ จึงไม่ต้องใช้ไลบรารี HTTP สำหรับคำขอ GET ง่าย ๆ แม้หลายทีมยังเลือก axios เพราะมี interceptors และจัดการ proxy ได้ดี คำสั่งด้านล่างสร้างโครงโปรเจกต์และติดตั้ง cheerio สำหรับแยกวิเคราะห์ axios เป็น client ทางเลือก p-limit สำหรับควบคุม concurrency และ Puppeteer กับ Playwright สำหรับหน้าแบบไดนามิก:
mkdir js-scraper && cd js-scraper
npm init -y
npm install cheerio axios p-limit
npm install puppeteer playwright

# enable modern import syntax
npm pkg set type=module
การตั้งค่า type=module ทำให้ใช้คำสั่ง import ได้ หากต้องการ CommonJS ให้คงค่าเริ่มต้นไว้และใช้ require แทน ตัวอย่างในคู่มือนี้ใช้ไวยากรณ์ import แต่ทุกตัวอย่างสอดคล้องกับการเรียก require โดยตรง เมื่อติดตั้งเสร็จ คุณจะมีทุกอย่างที่จำเป็นสำหรับ scraping ทั้งแบบคงที่และไดนามิกในโปรเจกต์เดียว
scrape หน้าแบบคงที่ด้วย fetch และ cheerio อย่างไร?
สำหรับหน้าแบบคงที่ ให้ดาวน์โหลด HTML ด้วยฟังก์ชัน fetch ที่มีมาให้ แล้วแยกวิเคราะห์ด้วย cheerio ซึ่งให้ API สไตล์ jQuery บนเซิร์ฟเวอร์
หน้าแบบคงที่ส่งเนื้อหาโดยตรงใน HTML response แรก จึงไม่ต้อง render ในเบราว์เซอร์ วิธีนี้รวดเร็วและประหยัด เพราะดาวน์โหลดเฉพาะ markup ไม่ใช่รูปภาพ ฟอนต์ หรือสคริปต์ ตัวอย่างด้านล่างดึงหน้าเว็บ โหลดเข้า cheerio และอ่าน product card แต่ละรายการ:
import * as cheerio from 'cheerio';

async function scrape(url) {
  const res = await fetch(url, {
    headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
  });
  if (!res.ok) throw new Error(`Request failed: ${res.status}`);
  const html = await res.text();
  const $ = cheerio.load(html);

  const items = [];
  $('.product').each((i, el) => {
    items.push({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim(),
      link: $(el).find('a').attr('href')
    });
  });
  return items;
}

console.log(await scrape('https://example.com/catalog'));
หากต้องการใช้ axios ส่วนของการแยกวิเคราะห์เหมือนเดิมทุกประการ และเปลี่ยนเฉพาะคำขอ Axios จะโยนข้อผิดพลาดสำหรับ status code ที่ไม่ใช่ 2xx โดยอัตโนมัติ และกำหนดค่า proxy ได้ตรงไปตรงมา จึงเป็นเหตุผลที่ scraper สำหรับงานจริงจำนวนมากใช้มัน:
import axios from 'axios';
import * as cheerio from 'cheerio';

const { data: html } = await axios.get('https://example.com/catalog', {
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' },
  timeout: 15000
});
const $ = cheerio.load(html);
const titles = $('.product h2').map((i, el) => $(el).text().trim()).get();
console.log(titles);
ก่อนให้ scraper ทำงานกับเว็บไซต์ใด ควรยืนยันก่อนว่าเป้าหมายอนุญาตหรือไม่ คู่มือของเราเรื่องวิธี ตรวจสอบว่าเว็บไซต์อนุญาตให้ scraping หรือไม่ อธิบาย robots.txt และเงื่อนไขการให้บริการ
ดึงข้อมูลแบบมีโครงสร้างเป็น JSON และ CSV อย่างไร?
รวบรวมแต่ละระเบียนไว้ใน array ของ plain object แล้วเขียน array นั้นลงไฟล์ JSON หรือแปลงเป็นแถวคั่นด้วยจุลภาคสำหรับไฟล์ CSV
ข้อความที่ scrape มาแบบดิบจะมีประโยชน์ก็ต่อเมื่อเก็บไว้ในรูปแบบที่คาดเดาได้ JSON เป็นเป้าหมายที่ง่ายที่สุด เพราะ JavaScript array แปลงเป็น serial ได้โดยตรง snippet ด้านล่างเขียนรายการที่ scrape ลงดิสก์ด้วยโมดูล file system ที่มีมาให้:
import { writeFile } from 'node:fs/promises';

const items = await scrape('https://example.com/catalog');
await writeFile('products.json', JSON.stringify(items, null, 2), 'utf-8');
console.log(`Saved ${items.length} records to products.json`);
CSV เหมาะกว่าเมื่อข้อมูลถูกนำไปใช้กับ spreadsheet หรือ data warehouse คุณสร้างได้โดยไม่ต้องใช้ไลบรารีด้วยการ escape เครื่องหมายอัญประกาศและเชื่อมฟิลด์เข้าด้วยกัน แต่การ escape สำคัญเพราะราคาและชื่ออาจมีจุลภาค:
import { writeFile } from 'node:fs/promises';

function toCsv(rows) {
  const headers = Object.keys(rows[0]);
  const escape = (v) => `"${String(v ?? '').replace(/"/g, '""')}"`;
  const lines = [headers.join(',')];
  for (const row of rows) {
    lines.push(headers.map((h) => escape(row[h])).join(','));
  }
  return lines.join('\n');
}

const items = await scrape('https://example.com/catalog');
await writeFile('products.csv', toCsv(items), 'utf-8');
รักษาชื่อฟิลด์ให้คงที่ระหว่างการรัน เพื่อไม่ให้เครื่องมือปลายทางหยุดทำงานเมื่อ layout ของหน้าเปลี่ยนเล็กน้อย หากต้องดึง binary asset ด้วย โปรดดูคู่มือเรื่องวิธี scrape รูปภาพจากเว็บไซต์
scrape หลายหน้าด้วยการแบ่งหน้าอย่างไร?
วนผ่าน URL ของหน้าเว็บไซต์ หรือตามลิงก์หน้าถัดไปในแต่ละหน้า scrape ทุกหน้า และหยุดเมื่อไม่มีผลลัพธ์เพิ่ม
แค็ตตาล็อกส่วนใหญ่แบ่งผลลัพธ์เป็นหน้าที่มีหมายเลขโดยใช้ query parameter เช่น ?page=2 หรือแสดงลิงก์ถัดไป รูปแบบที่ปลอดภัยที่สุดคืออ่านแต่ละหน้า รวบรวมระเบียน แล้วหาหน้าถัดไปและหยุดเมื่อไม่พบ ตัวอย่างด้านล่างวนผ่านหน้าที่มีหมายเลขจนหน้าหนึ่งไม่ส่งรายการกลับมา:
import * as cheerio from 'cheerio';

async function scrapeAll(base) {
  const all = [];
  for (let page = 1; page <= 50; page++) {
    const res = await fetch(`${base}?page=${page}`, {
      headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
    });
    if (!res.ok) break;
    const $ = cheerio.load(await res.text());
    const items = $('.product').map((i, el) => ({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim()
    })).get();

    if (items.length === 0) break;
    all.push(...items);
    await new Promise((r) => setTimeout(r, 1000));
  }
  return all;
}

console.log((await scrapeAll('https://example.com/catalog')).length);
สังเกตการหยุด 1 วินาทีระหว่างหน้า และเพดานตายตัว 50 รอบ ซึ่งป้องกัน loop ที่ควบคุมไม่ได้หากเว็บไซต์ไม่เคยส่งหน้าว่างกลับมา เมื่อเนื้อหาโหลดด้วยการเลื่อนแทนหน้าที่มีหมายเลข คุณต้องใช้ headless browser ซึ่งครอบคลุมในส่วน Puppeteer ด้านล่าง
จัดการการลองใหม่ backoff และการจำกัดอัตราอย่างไร?
ครอบทุกคำขอด้วยตัวช่วยลองใหม่ที่รอนานขึ้นหลังล้มเหลวแต่ละครั้ง และจำกัดจำนวนคำขอที่ทำงานพร้อมกันเพื่อให้อยู่ภายในระดับที่เว็บไซต์รับได้
เครือข่ายไม่น่าเชื่อถือและเซิร์ฟเวอร์อาจส่งข้อผิดพลาดชั่วคราว ดังนั้น scraper ที่ยอมแพ้เมื่อผิดพลาดครั้งแรกย่อมสูญเสียข้อมูลโดยไม่จำเป็น ตัวช่วยลองใหม่ที่มี exponential backoff จะรอนานขึ้นเป็นลำดับระหว่างความพยายาม ซึ่งยังให้เวลาสำหรับเซิร์ฟเวอร์ที่ถูกจำกัดอัตราในการฟื้นตัว:
async function fetchWithRetry(fn, retries = 4, delay = 1000) {
  for (let attempt = 1; attempt <= retries; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt === retries) throw err;
      const wait = delay * 2 ** (attempt - 1);
      console.warn(`Attempt ${attempt} failed, retrying in ${wait}ms`);
      await new Promise((r) => setTimeout(r, wait));
    }
  }
}

const html = await fetchWithRetry(async () => {
  const res = await fetch('https://example.com/catalog');
  if (res.status === 429) throw new Error('Rate limited');
  if (!res.ok) throw new Error(`HTTP ${res.status}`);
  return res.text();
});
Backoff จัดการคำขอเดี่ยว แต่ยังต้องควบคุมจำนวนคำขอที่ทำงานขนานกันด้วย การส่งคำขอพร้อมกันหลายร้อยรายการทำให้เซิร์ฟเวอร์เป้าหมายเสื่อมประสิทธิภาพและทำให้ทราฟฟิกถูกระบุ p-limit จำกัด concurrency เพื่อให้ worker ตามจำนวนที่กำหนดประมวลผลคิวของ URL:
import pLimit from 'p-limit';

const limit = pLimit(5); // at most 5 requests in flight
const urls = Array.from({ length: 100 }, (_, i) =>
  `https://example.com/item/${i + 1}`
);

const results = await Promise.all(
  urls.map((url) =>
    limit(() => fetchWithRetry(async () => {
      const res = await fetch(url);
      if (!res.ok) throw new Error(`HTTP ${res.status}`);
      return res.text();
    }))
  )
);

console.log(`Fetched ${results.length} pages with a cap of 5 in parallel`);
เมื่อใช้ร่วมกัน backoff และเพดาน concurrency จะช่วยให้ร่องรอยการใช้งานอยู่ในระดับสมเหตุสมผลและอัตราความสำเร็จสูง สำหรับ checklist ที่กว้างขึ้น โปรดดูคู่มือ แนวทางปฏิบัติที่ดีสำหรับ web scraping ของเรา
scrape หน้าแบบไดนามิกด้วย Puppeteer อย่างไร?
สำหรับหน้าแบบไดนามิกที่สร้างเนื้อหาด้วย JavaScript หลังโหลด ให้ควบคุม Chrome แบบ headless ด้วย Puppeteer รอ selector เป้าหมาย แล้วอ่าน DOM ที่ render สมบูรณ์
เว็บไซต์สมัยใหม่จำนวนมากส่ง HTML shell ที่เกือบว่าง แล้วจึงดึงข้อมูลผ่าน background request HTTP client จะไม่เห็นสิ่งที่ใช้ประโยชน์ได้ จึงต้องมี engine ที่รัน JavaScript ของหน้าเว็บเอง Puppeteer ควบคุม Chrome แบบ headless และรอองค์ประกอบ คลิก และเลื่อนได้ ตัวอย่างด้านล่างรอ selector จากนั้นเลื่อนซ้ำเพื่อกระตุ้นการโหลดแบบเลื่อนไม่สิ้นสุด ก่อนดึงข้อมูลใน browser context:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();
await page.setUserAgent('Mozilla/5.0 (compatible; MyScraper/1.0)');
await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });

// wait until the first batch of cards is present
await page.waitForSelector('.product');

// infinite scroll: scroll to the bottom until height stops growing
let previousHeight = 0;
for (let i = 0; i < 20; i++) {
  const height = await page.evaluate('document.body.scrollHeight');
  if (height === previousHeight) break;
  previousHeight = height;
  await page.evaluate('window.scrollTo(0, document.body.scrollHeight)');
  await new Promise((r) => setTimeout(r, 1500));
}

const items = await page.evaluate(() =>
  Array.from(document.querySelectorAll('.product')).map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
loop จะหยุดทันทีที่ความสูงหน้าเว็บไม่เพิ่มขึ้น ซึ่งบ่งชี้ว่าไม่มีเนื้อหาใหม่กำลังโหลด และเพดานตายตัว 20 ครั้งของการเลื่อนช่วยป้องกัน loop ที่ไม่สิ้นสุด หากต้องการข้อมูลเพิ่มเติมเกี่ยวกับเป้าหมายประเภทนี้ โปรดดูคู่มือเรื่องวิธี scrape หน้าเว็บแบบไดนามิก
ใช้ Playwright เป็นทางเลือกแทน Puppeteer อย่างไร?
Playwright ทำงานเกือบเหมือน Puppeteer แต่เพิ่มการรองรับ Chromium, Firefox และ WebKit แบบ first-party รวมถึง locator ที่รออัตโนมัติซึ่งช่วยลด selector ที่ไม่เสถียร
Playwright สร้างโดยวิศวกรบางคนจากทีม Puppeteer ดั้งเดิม และมี API ส่วนใหญ่เหมือนกัน การย้ายจึงมักเป็นเพียงการเปลี่ยนชื่อการเรียกไม่กี่จุด locator ของมันรอให้องค์ประกอบพร้อมดำเนินการโดยอัตโนมัติ จึงตัดการเรียก waitForSelector ด้วยตนเองไปได้มาก scraper ที่เทียบเท่ากันมีลักษณะดังนี้:
import { chromium } from 'playwright';

const browser = await chromium.launch({ headless: true });
const context = await browser.newContext({
  userAgent: 'Mozilla/5.0 (compatible; MyScraper/1.0)'
});
const page = await context.newPage();
await page.goto('https://example.com/feed', { waitUntil: 'networkidle' });

await page.locator('.product').first().waitFor();

const items = await page.locator('.product').evaluateAll((els) =>
  els.map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
เลือก Playwright เมื่อต้องทดสอบ scraper เดียวกันบน browser engine หลายตัว หรือต้องการ network mocking ที่มีมาให้ เลือก Puppeteer เมื่อเป้าหมายมีเพียง Chrome และต้องการ dependency ที่เล็กกว่า ทั้งคู่ใช้หน่วยความจำมากกว่า fetch และ cheerio อย่างมาก จึงควรสงวนไว้สำหรับหน้าที่ต้อง render จริง ๆ
ควรเลือกเครื่องมือ JavaScript scraping ใด?
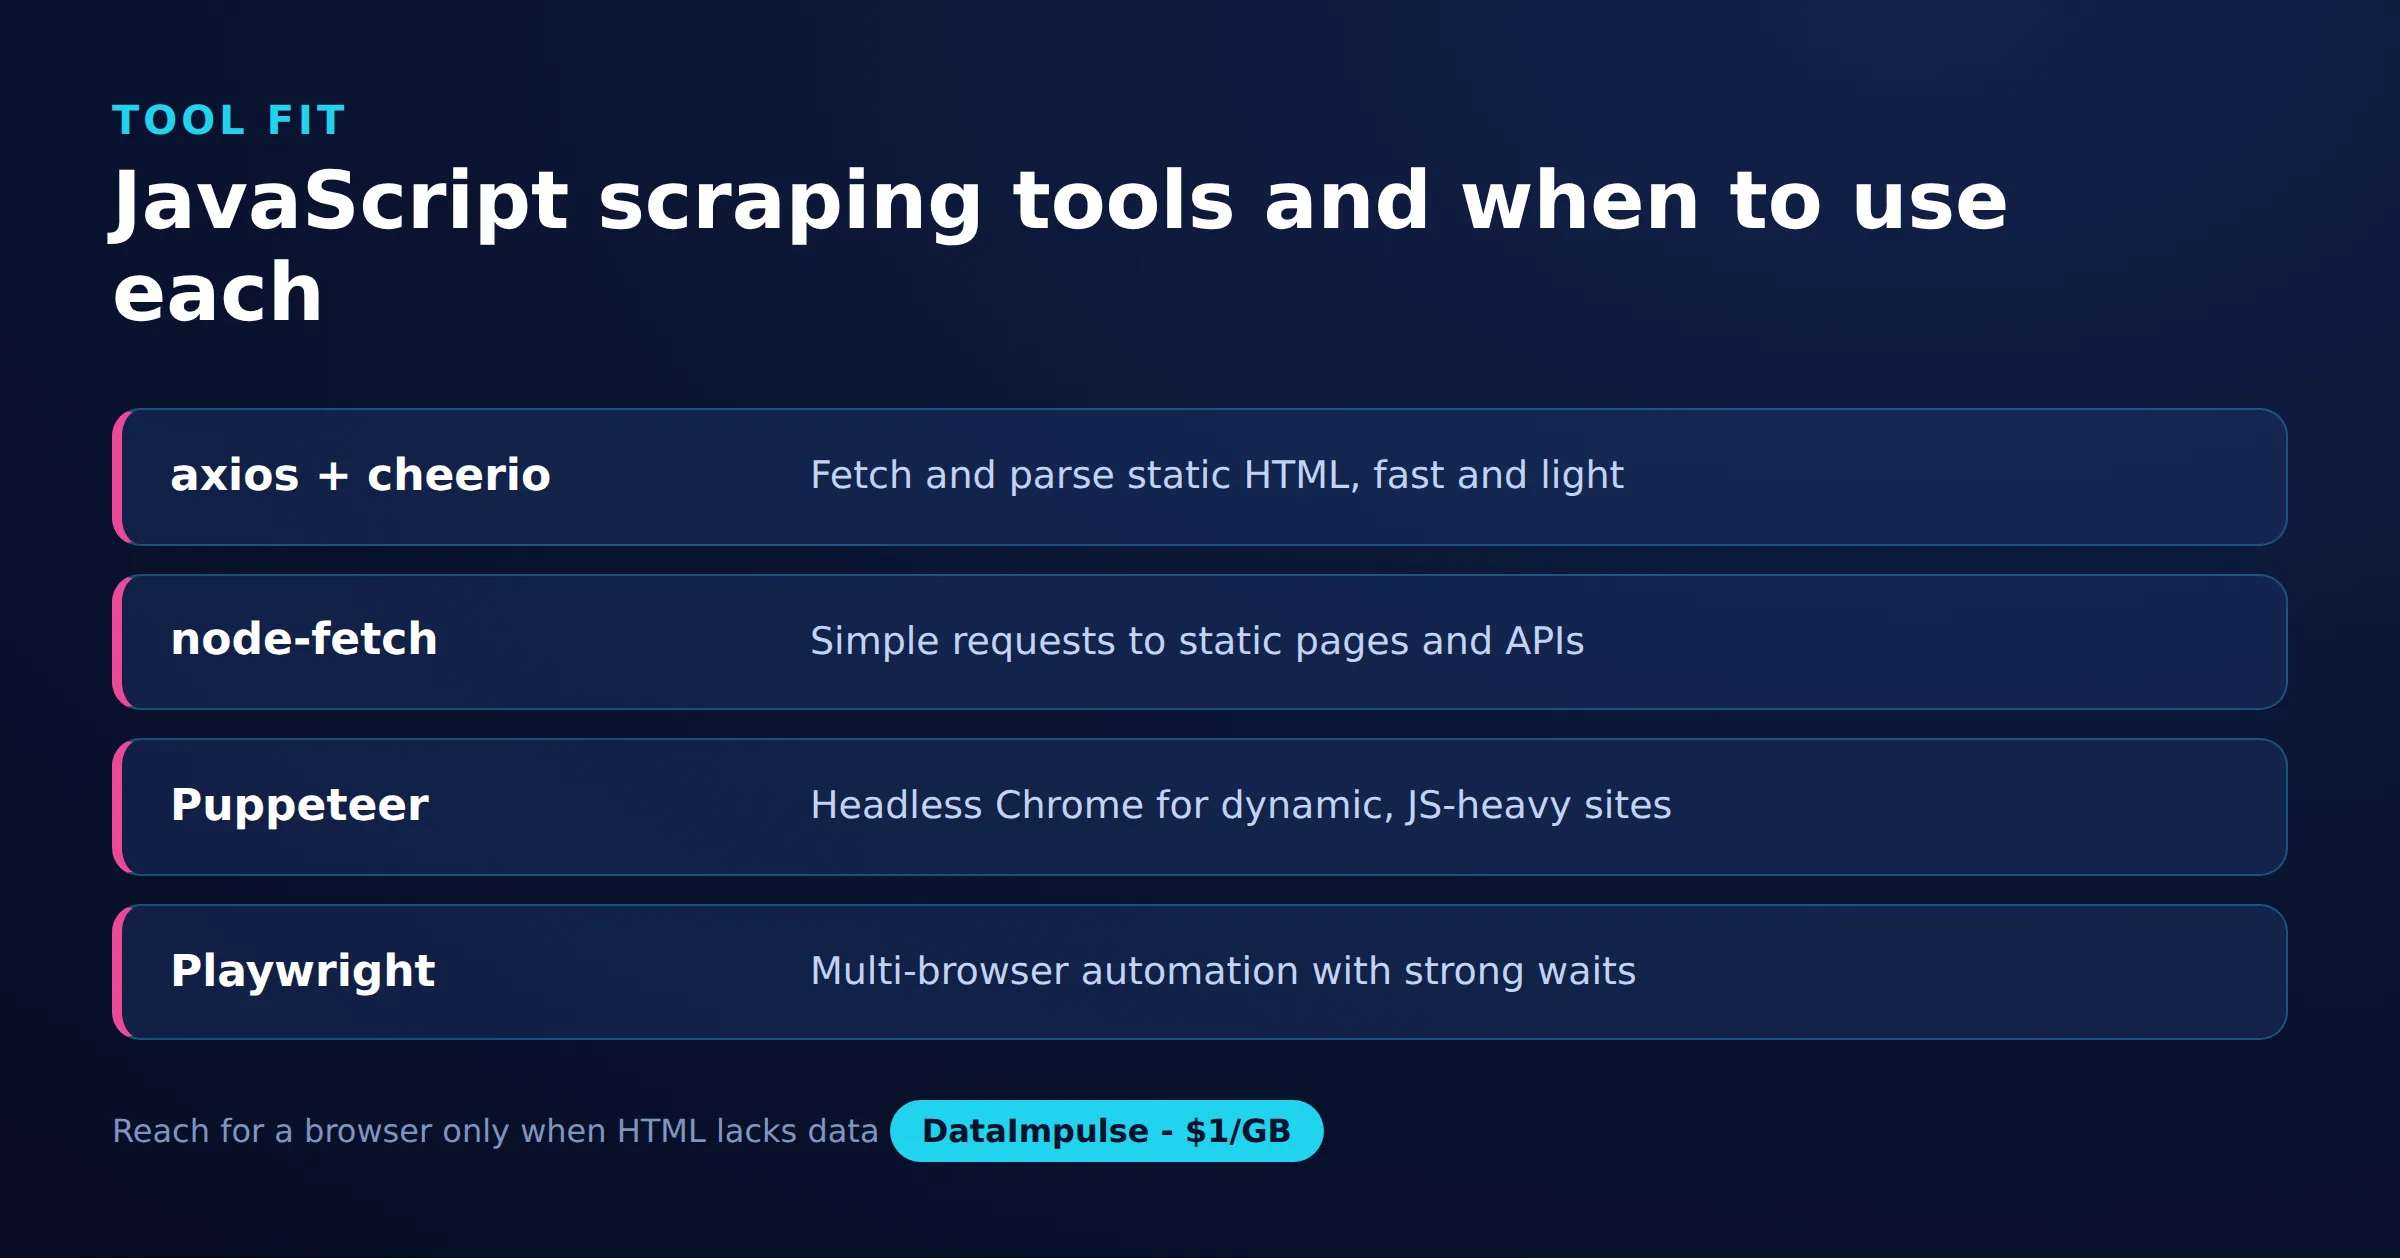
ใช้ fetch หรือ axios กับ cheerio สำหรับ HTML แบบคงที่ และเลือก Puppeteer หรือ Playwright เฉพาะเมื่อหน้าเว็บ render ข้อมูลในเบราว์เซอร์
เครื่องมือที่ถูกต้องขึ้นกับวิธีที่หน้าเว็บส่งข้อมูลและระดับที่ให้ความสำคัญกับความเร็วมากกว่าความเที่ยงตรงของการ render HTTP client รวดเร็วและเบา แต่ไม่สามารถรัน JavaScript ได้ ส่วน headless browser รันทุกอย่างที่ผู้ใช้จริงเห็นได้ แต่ใช้หน่วยความจำและเวลามากกว่า ตารางด้านล่างสรุปข้อแลกเปลี่ยน:
| เครื่องมือ | รัน JS | ความเร็ว | เหมาะสำหรับ |
|---|---|---|---|
| fetch + cheerio | ไม่ | เร็วที่สุด | HTML แบบคงที่ ปริมาณสูง |
| axios + cheerio | ไม่ | เร็ว | HTML แบบคงที่ ตั้งค่า proxy ง่าย |
| Puppeteer | ใช่ | ช้า | หน้าแบบไดนามิกสำหรับ Chrome เท่านั้น |
| Playwright | ใช่ | ช้า | แบบไดนามิก การทดสอบข้ามเบราว์เซอร์ |
รูปแบบการใช้งานจริงที่พบบ่อยคือผสมทั้งสองแบบ: ใช้ headless browser เฉพาะเพื่อเข้าถึงหน้าหรือ endpoint ที่ต้อง render แล้วกลับไปใช้ HTTP client ธรรมดาสำหรับคำขอส่วนใหญ่ JavaScript เป็นหนึ่งในหลาย stack ที่ใช้ทำงานนี้ได้ หากกำลังเปรียบเทียบ ecosystem คู่มือ web scraping ด้วย Rust ของเราครอบคลุมทางเลือกแบบ compiled
ส่ง JavaScript scraper ผ่าน proxy อย่างไร?
ส่งการตั้งค่า proxy ไปยัง HTTP client หรือตัวเลือกเปิด browser เพื่อให้คำขอออกจากที่อยู่ IP อื่น ซึ่งช่วยกระจายโหลดและลดโอกาสที่ที่อยู่เดียวจะถูกจำกัดอัตรา
การ scrape หลายหน้าจาก IP เดียวเป็นวิธีที่เร็วที่สุดในการถูกบล็อก การหมุนเวียนคำขอผ่าน pool ของที่อยู่ทำให้ทราฟฟิกดูเหมือนมาจากผู้เข้าชมแยกกันหลายราย สำหรับ axios ให้ระบุ host, port และข้อมูลรับรองของ proxy ใน request config ตัวอย่างด้านล่างส่งผ่าน gateway ของ DataImpulse:
import axios from 'axios';

const { data } = await axios.get('https://example.com', {
  proxy: {
    protocol: 'http',
    host: 'gw.dataimpulse.com',
    port: 823,
    auth: { username: 'YOUR_USERNAME', password: 'YOUR_PASSWORD' }
  },
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
});
console.log(data.length, 'bytes received through the proxy');
Puppeteer รับ proxy เป็น launch argument แล้วจึงยืนยันตัวตนบนหน้าเว็บ เพราะ Chrome ไม่รับข้อมูลรับรองภายใน URL ของ proxy รูปแบบเดียวกันใช้ได้กับ Playwright ซึ่งรับ proxy object ที่มี username และ password โดยตรง:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({
  headless: 'new',
  args: ['--proxy-server=gw.dataimpulse.com:823']
});
const page = await browser.newPage();
await page.authenticate({
  username: 'YOUR_USERNAME',
  password: 'YOUR_PASSWORD'
});
await page.goto('https://example.com', { waitUntil: 'networkidle2' });
console.log(await page.title());
await browser.close();
DataImpulse มี residential proxies, datacenter proxies และ mobile proxies ผ่าน HTTP, HTTPS และ SOCKS5 พร้อม rotating และ sticky sessions รวมการกำหนดเป้าหมายตามประเทศไว้แล้ว ขณะที่การกำหนดเป้าหมายตามรัฐ เมือง ZIP และ ASN เป็นส่วนเสริมแบบชำระเงิน หากคำขอ proxy ส่งข้อผิดพลาดการยืนยันตัวตน คู่มือ ข้อผิดพลาด HTTP 407 ของเราอธิบายสาเหตุที่พบบ่อยที่สุด และคู่มือ การยืนยันตัวตน proxy ครอบคลุมรูปแบบข้อมูลรับรองอย่างละเอียดกว่า
ดักจับ XHR และ JSON endpoint อย่างไร?
แทนที่จะ scrape HTML ที่ render แล้ว ให้ดู network traffic ใน headless browser และอ่าน JSON response ที่หน้าเว็บดึงในเบื้องหลัง ซึ่งมักสะอาดกว่าและเร็วกว่า
หน้าแบบไดนามิกมักได้รับข้อมูลจาก API ที่ซ่อนอยู่ซึ่งส่ง JSON กลับมา การอ่าน response นั้นโดยตรงช่วยข้ามการแยกวิเคราะห์ DOM ทั้งหมดและให้ระเบียนที่มีโครงสร้างดี ทั้ง Puppeteer และ Playwright ให้คุณรับฟัง response และเก็บ response ที่ต้องการได้ ตัวอย่าง Puppeteer ด้านล่างเก็บ JSON response ใดก็ตามจาก path ของ API:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();

const captured = [];
page.on('response', async (response) => {
  const url = response.url();
  if (url.includes('/api/') && response.headers()['content-type']?.includes('application/json')) {
    try {
      captured.push(await response.json());
    } catch (err) {
      // non-JSON body, ignore
    }
  }
});

await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });
console.log(`Captured ${captured.length} JSON payloads`);
await browser.close();
เมื่อทราบ URL ของ endpoint และพารามิเตอร์แล้ว คุณมักเลิกใช้ browser ได้ทั้งหมด และเรียก JSON API ด้วย fetch ธรรมดาโดยส่ง headers เดียวกับที่หน้าเว็บส่ง วิธีนี้ให้ความเร็วของ scraper แบบคงที่พร้อมความครบถ้วนของแบบ render และเป็นการเพิ่มประสิทธิภาพที่สำคัญที่สุดสำหรับเว็บไซต์แบบไดนามิก
ขอบเขตด้านจริยธรรมและกฎหมายของการ scraping คืออะไร?
scrape เฉพาะข้อมูลสาธารณะ เคารพ robots.txt และเงื่อนไขการให้บริการของเว็บไซต์ หลีกเลี่ยงข้อมูลส่วนบุคคล และอย่าทำให้เซิร์ฟเวอร์ทำงานหนักเกินไป แนวปฏิบัติเหล่านี้ช่วยให้โครงการมีเหตุผลรองรับและยั่งยืน
ตรวจไฟล์ robots.txt ที่รากโดเมนเพื่อดูว่าเว็บไซต์ขอให้ crawler หลีกเลี่ยง path ใด และให้ความสำคัญกับคำขอเหล่านั้น ระบุ scraper ด้วย User-Agent ที่ซื่อตรง ลดอัตราคำขอ และ cache response เพื่อไม่ต้องดึงหน้าเดิมซ้ำโดยไม่จำเป็น ในด้านโครงสร้างพื้นฐาน แหล่งที่มาของ IP มีความสำคัญ DataImpulse ดำเนินการ ethical proxies ที่ได้มาจากผู้ใช้ซึ่งเลือกเข้าร่วมและได้รับค่าตอบแทน สอดคล้องกับ GDPR และมีข้อตกลงการประมวลผลข้อมูลให้ใช้ได้ จริยธรรมไม่ใช่แค่เรื่องการปฏิบัติตามข้อกำหนดเท่านั้น scraper ที่สุภาพและโปร่งใสยังเป็น scraper ที่ทำงานต่อไปได้ สำหรับหลักการเบื้องหลังการเก็บข้อมูลอย่างยั่งยืน โปรดดูคู่มือเรื่อง web scraping อย่างมีจริยธรรม
คำถามที่พบบ่อย
จำเป็นต้องใช้ Node.js เพื่อ scrape ด้วย JavaScript หรือไม่?
สำหรับงานที่มากกว่าการทดสอบหน้าเดียวอย่างรวดเร็ว จำเป็น Node.js ช่วยให้รัน scraper บนเซิร์ฟเวอร์ วนผ่าน URL จำนวนมาก จัดการการลองใหม่ ส่งออกข้อมูล และใช้ proxy ได้ ซึ่ง browser console ทำได้ไม่ดี
ควรใช้ Puppeteer แทน fetch และ cheerio เมื่อใด?
ใช้ fetch หรือ axios กับ cheerio เมื่อข้อมูลอยู่ใน HTML response แรก เปลี่ยนไปใช้ Puppeteer หรือ Playwright เฉพาะเมื่อเนื้อหาถูก render ด้วย JavaScript หลังหน้าเว็บโหลด เพราะ headless browser ใช้ทรัพยากรมากกว่าอย่างมาก
ส่งออกข้อมูลที่ scrape เป็น CSV ใน Node.js อย่างไร?
รวบรวมระเบียนเป็น array ของ object แล้วสร้างแถวคั่นด้วยจุลภาคโดยเชื่อมค่าของแต่ละ object และ escape เครื่องหมายอัญประกาศกับจุลภาค เขียนผลลัพธ์ลงไฟล์ด้วยโมดูล fs ที่มีมาให้ หรือใช้ไลบรารี เช่น csv-stringify
ทำไมจึงถูกบล็อกเมื่อ scrape ด้วย JavaScript?
สาเหตุทั่วไปคือส่งคำขอจาก IP เดียวมากเกินไป User-Agent ไม่มีหรือดูน่าสงสัย และไม่มีช่วงหน่วงระหว่างคำขอ rotating proxies, headers ที่สมจริง การลองใหม่พร้อม backoff และการจำกัดอัตราช่วยลดการบล็อก
proxy ประเภทใดเหมาะที่สุดสำหรับ JavaScript scraping?
Datacenter proxies รวดเร็วและราคาประหยัดสำหรับเป้าหมายที่ยอมรับได้ ขณะที่ residential และ mobile proxies ดูเหมือนผู้ใช้จริงมากกว่าสำหรับเว็บไซต์ที่เข้มงวด rotating sessions ช่วยกระจายคำขอไปยังหลายที่อยู่
เมื่อใดที่ DataImpulse ไม่เหมาะกับงาน?
หากต้องการ static ISP proxies, scraping API ที่มีการจัดการครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและหน่วยงานรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้น rotating residential, mobile และ datacenter proxies สำหรับเก็บข้อมูลสาธารณะและเข้าถึงเนื้อหา
คู่มือที่เกี่ยวข้อง
เริ่ม scraping ด้วย proxy ที่เชื่อถือได้
พร้อมให้ JavaScript scraper ทำงานต่อโดยไม่ถูกบล็อกอยู่ตลอดหรือยัง? DataImpulse ให้บริการ IP แบบ residential, mobile และ datacenter ที่ได้มาอย่างมีจริยธรรม เริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกไม่หมดอายุและไม่มีค่าสมัครสมาชิก สร้างบัญชี และส่ง scraper ตัวแรกผ่าน proxy ได้วันนี้