
In this Article
Si vous cherchez comment contourner Cloudflare, commencez par identifier la réponse reçue, confirmer que l’accès est autorisé et tester la couche précise qui a échoué. Il n’existe aucun proxy, aucun en-tête ni aucun réglage de navigateur universel qui garantisse l’accès.
Dans cet article, contourner Cloudflare signifie résoudre un problème d’accès pour l’automatisation grâce à un diagnostic, à des clients compatibles ou à un accès approuvé par le propriétaire. Cela ne signifie pas exploiter un pare-feu, découvrir un serveur d’origine pour échapper à la protection, ni franchir une barrière d’authentification.
Nous distinguons l’identité réseau, les empreintes de transport, JavaScript, l’état de vérification et le comportement des requêtes. Notre propre instantané sur sept sites, réalisé le 15 octobre 2026, montre pourquoi la modification d’une seule couche peut aider sur une destination et ne rien changer sur une autre.
Points clés
- Notre instantané du 15 octobre 2026 a envoyé 28 requêtes HTTP à sept sites protégés par Cloudflare, avec quatre combinaisons de client et de route réseau.
- Une seconde passe a chargé six des sites dans Chromium headless par défaut : aucun challenge n’a été franchi.
- Changer uniquement la route réseau n’a produit aucun résultat HTTP différent dans la comparaison sur sept sites.
- Coinbase a renvoyé HTTP 200 via curl_cffi sur les deux routes réseau testées.
- Une page de blocage qui se transforme en challenge ne constitue pas une récupération de données réussie.
- Une route résidentielle seule n’a modifié le résultat sur aucun des sept sites.
Que vérifie Cloudflare lorsqu’il vous bloque ?
Cloudflare peut évaluer plusieurs types d’indices liés à la requête et au navigateur. Notre échelle de confiance Cloudflare en 5 couches structure le dépannage ; c’est un modèle d’ingénierie, et non une séquence documentée que suivrait chaque requête.
Cloudflare documente les en-têtes de requête, les caractéristiques de session et les signaux du navigateur comme des données d’entrée de la détection. Sa documentation sur la détection des bots explique pourquoi modifier un seul attribut visible constitue une expérience incomplète.
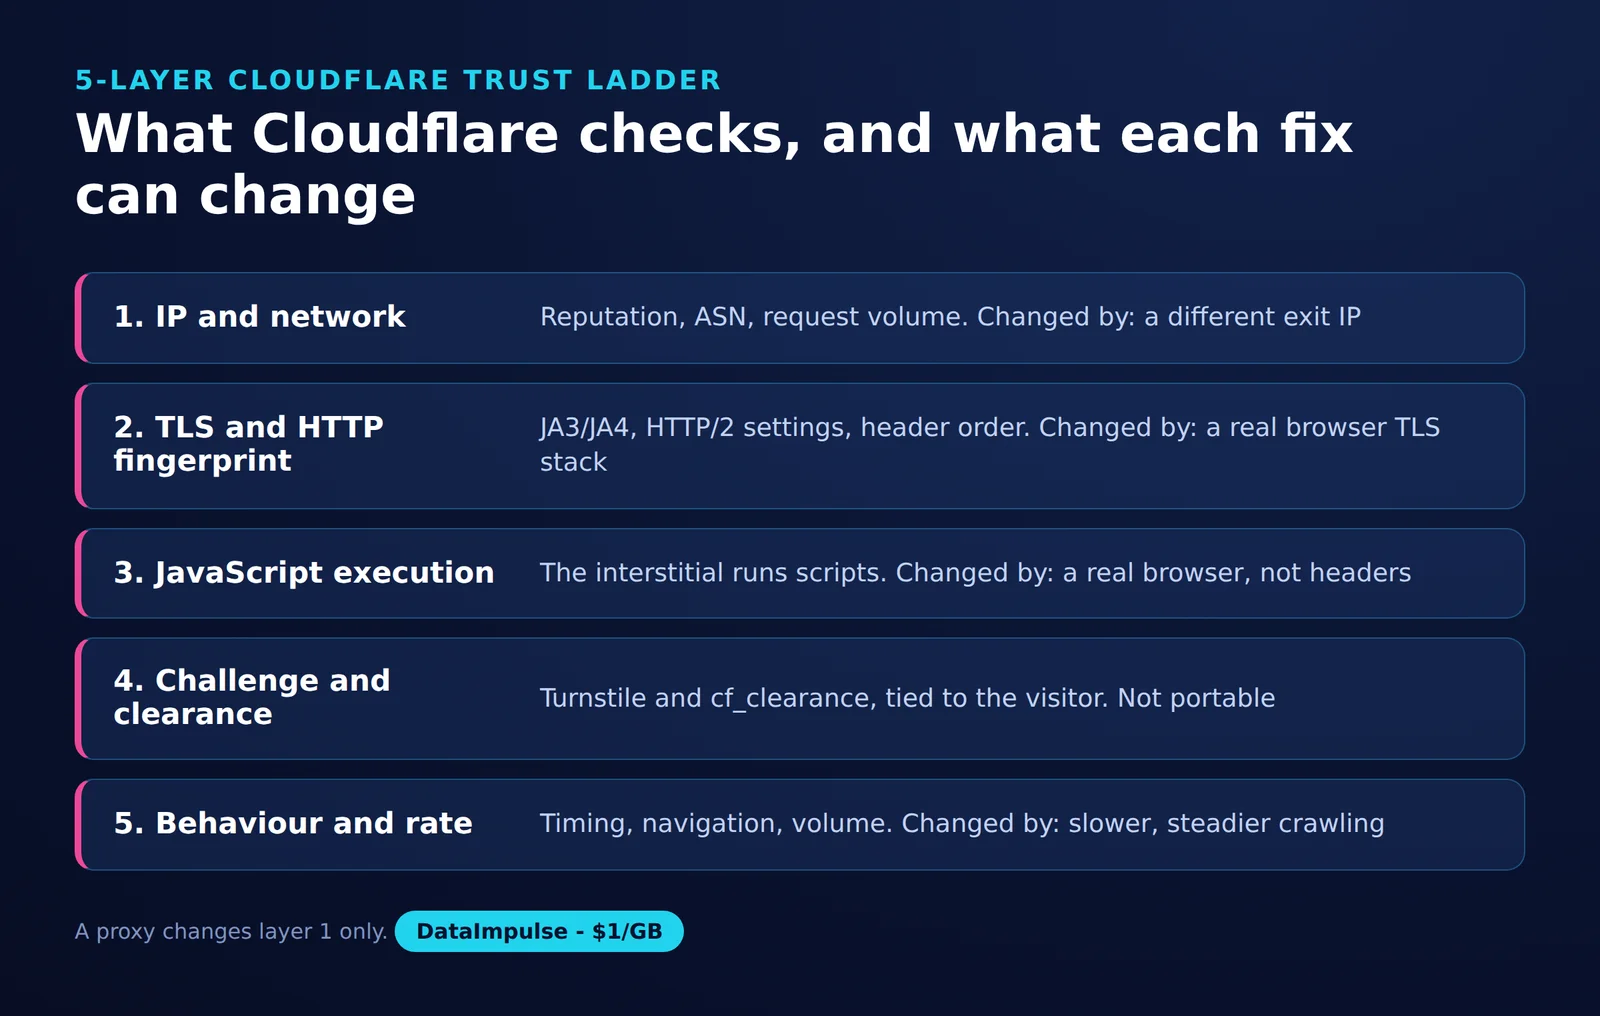
- Couche 1 : identité réseau. Notez l’IP de sortie, l’opérateur réseau ou l’ASN, et la localisation. Comparez les routes sans supposer que chaque refus relève d’un problème de réputation d’IP.
- Couche 2 : identité de transport et HTTP. Examinez la pile cliente, la négociation TLS et le comportement HTTP. Le nom d’un navigateur dans un en-tête n’est qu’un indice parmi d’autres.
- Couche 3 : exécution de JavaScript. Déterminez si le flux de travail nécessite un environnement de navigateur, plutôt qu’une simple réponse HTTP.
- Couche 4 : état de vérification. Distinguez un jeton de widget d’une clearance détenue par une session de navigateur donnée.
- Couche 5 : comportement et cadence. Suivez l’espacement des requêtes, la concurrence, les échecs répétés et la continuité de session.
La documentation de Cloudflare sur JA3 et JA4 décrit des empreintes dérivées de la manière dont les clients TLS initient leurs connexions. Modifier le User-Agent ne change ni cette négociation ni l’exécution de JavaScript. Conservez ensemble le comportement TLS et HTTP/2 dans votre inventaire de diagnostic, sans présumer qu’une empreinte particulière a causé le refus.
L’échelle aide à isoler les questions. Un autre réseau a-t-il changé le résultat ? Un autre client HTTP l’a-t-il changé ? L’exécution dans un navigateur a-t-elle révélé le contenu attendu ? Chaque réponse restreint l’enquête, mais aucune ne vaut autorisation de collecter des données.
S’agit-il d’un challenge Cloudflare ou d’un simple 403 ?
Une page de challenge Cloudflare porte l’en-tête cf-mitigated: challenge et utilise text/html, même lorsque la ressource demandée était du JSON. Un 403 accompagné du seul cf-ray n’établit pas la cause.
Utilisez conjointement la documentation de Cloudflare sur les réponses de challenge, son guide de dépannage des erreurs 403 et sa référence des en-têtes HTTP. Sa documentation distingue les échecs de permission côté origine de plusieurs réponses de sécurité en périphérie ; le Ray ID sert à corréler une requête, et non à nommer la règle qui l’a rejetée.
| Symptôme observé | Interprétation | Prochaine action de diagnostic |
|---|---|---|
| Page intermédiaire « Just a moment… » | Page de challenge possible | Vérifier cf-mitigated et le type de contenu. |
| Widget Turnstile | Vérification intégrée à une page | Séparer la validation du widget de la récupération de la page. |
| 403 avec cf-ray | Cause non résolue | Inspecter le corps de la réponse et demander au propriétaire de corréler les journaux. |
| 403 sans indice de challenge | Peut être un refus de l’origine ou un blocage en périphérie | Ne pas l’étiqueter comme un bannissement d’IP sans preuve. |
| Erreur 1020 | Une règle de pare-feu a refusé l’accès | Communiquer au propriétaire le Ray ID et l’horodatage. |
| Erreur 1015 | Limitation de débit | Cesser les nouvelles tentatives et revoir le débit de requêtes autorisé. |
| Erreur 1010 | Signature du navigateur rejetée | Demander au propriétaire de revoir les paramètres de vérification de l’intégrité du navigateur. |
Les descriptions d’erreurs reprennent les pages officielles de Cloudflare pour 1020, 1015 et 1010.
Conservez ensemble le statut, l’URL finale, les en-têtes de réponse et une classification assainie du corps. Un statut de succès accompagné d’une page de vérification inattendue reste une extraction ratée. Pour les autres échecs de permission et d’application, consultez notre guide de diagnostic des erreurs 403 en scraping.
Avant d’apprendre à contourner Cloudflare, pouvez-vous organiser un accès autorisé ?
Une API, un export ou une exception du propriétaire strictement délimitée peut supprimer le problème d’accès à la source. Établissez le jeu de données autorisé, la fréquence, l’identité et les exigences de conservation avant d’investir dans des modifications côté client.
Envoyez au propriétaire une demande concrète : les champs nécessaires, les modèles d’URL, le calendrier prévu, la concurrence proposée et une adresse de contact. Joignez l’horodatage et le Ray ID d’une requête ayant échoué lorsqu’ils sont disponibles. Demandez une intégration authentifiée ou une identité de crawler approuvée qu’il puisse reconnaître et révoquer.
À l’attention des propriétaires, les conseils de Cloudflare sur les faux positifs indiquent que les règles WAF Skip peuvent exempter du Super Bot Fight Mode, mais ne peuvent pas contourner le Bot Fight Mode. Limitez les exceptions au flux de travail approuvé et confirmez l’événement de sécurité correspondant avant de modifier la protection.
La documentation de Cloudflare sur les bots vérifiés intègre l’ancienne distinction des agents signés dans des métadonnées d’accès Direct ou Intermediary à partir du 1er juillet 2026. La vérification ne prévaut pas sur la politique du propriétaire. Notre article sur les tests de crawlers apporte un éclairage complémentaire.
La visibilité publique ne vaut pas évaluation juridique complète. La RFC 9309 sépare explicitement les règles du fichier robots.txt de l’autorisation d’accès. La déclaration commune des autorités de protection de la vie privée sur le scraping explique que les informations personnelles accessibles publiquement restent soumises au droit de la vie privée et de la protection des données.
L’arrêt hiQ de 2022 de la Cour d’appel du neuvième circuit portait sur un litige précis concernant des profils publics et sur une injonction préliminaire. La politique de poursuites du DOJ relative au CFAA guide les procureurs fédéraux ; elle ne constitue ni une autorisation générale ni une protection contre les actions civiles. Les règles britanniques sur l’accès non autorisé et les contrôles d’accès relevant du droit d’auteur appellent un examen distinct, notamment la section 1 du Computer Misuse Act et la section 1201 du DMCA.
Faites examiner par un conseil compétent les conditions d’utilisation, les barrières d’authentification, les données personnelles et la réutilisation envisagée. Ceci ne constitue pas un avis juridique ; notre aperçu juridique du web scraping aide à cadrer les questions.
Comment diagnostiquer une requête Python avant de changer de client ?
Effectuez une seule requête contrôlée et notez les indices de challenge avant d’ajouter des nouvelles tentatives ou de changer de réseau. Conservez les cookies au sein de la session de test, définissez un délai d’expiration et évitez d’afficher les valeurs des cookies ou les identifiants.
Le diagnostic suivant utilise la gestion des sessions et des en-têtes documentée par Requests. Fournissez une URL HTTPS dont vous êtes propriétaire ou que vous avez l’autorisation de tester. Le script ne suit aucune redirection, ce qui rend la première réponse explicite.
python -m pip install requests
python diagnose.py https://example.com/
# Save as diagnose.py
import json
import sys
from urllib.parse import urlsplit
import requests
url = sys.argv[1]
if urlsplit(url).scheme != "https":
raise SystemExit("Use an authorized HTTPS URL")
with requests.Session() as session:
session.headers.update({
"User-Agent": "AuthorizedDiagnostics/1.0",
"Accept": "application/json, text/html;q=0.9",
})
# The session retains cookies issued during this workflow.
response = session.get(
url,
timeout=(10, 25),
allow_redirects=False,
)
print(json.dumps({
"status": response.status_code,
"content_type": response.headers.get("content-type"),
"cf_mitigated": response.headers.get("cf-mitigated"),
"cf_ray": response.headers.get("cf-ray"),
"challenge": (
response.headers.get("cf-mitigated", "").lower()
== "challenge"
),
"cookie_count": len(session.cookies),
}, indent=2))Ensuite, une comparaison autorisée peut modifier le client de transport. Le projet curl_cffi documente l’imitation TLS et HTTP/2 de navigateurs ; l’exemple fixe la version 0.16.3, celle que nous avons utilisée lors de notre test du 15 octobre 2026.
python -m pip install curl_cffi==0.16.3
python transport_check.py https://example.com/
# Save as transport_check.py
import sys
from curl_cffi import requests
response = requests.get(
sys.argv[1],
impersonate="chrome",
timeout=25,
allow_redirects=False,
)
print({
"status": response.status_code,
"content_type": response.headers.get("content-type"),
"cf_mitigated": response.headers.get("cf-mitigated"),
"cf_ray": response.headers.get("cf-ray"),
})Cette comparaison modifie le comportement du client, y compris potentiellement les en-têtes par défaut, et ne peut donc pas isoler TLS comme cause unique. Elle ne reproduit pas non plus exactement notre dispositif de mesure. Notez les versions et les paramètres de requête, inspectez le contenu attendu et arrêtez-vous après la comparaison prévue.
Quelles méthodes agissent sur quelles couches quand on cherche à contourner Cloudflare ?
Choisissez une méthode en fonction de l’échec que vous avez mesuré. Les changements de réseau, la compatibilité de transport, l’exécution dans un navigateur et la continuité de session répondent à des problèmes différents et ont des coûts d’exploitation différents.
Routes résidentielles ou mobiles
Une autre route modifie l’identité réseau présentée à la destination. Elle ne fournit ni exécution de JavaScript, ni état de vérification, ni autorisation.
DataImpulse fournit la couche IP, avec des sessions rotatives ou sticky et un ciblage par pays. Ce n’est ni une API de scraping, ni un unblocker managé, ni un VPN. Gardez la route réseau d’une session cohérente lorsque vous évaluez un flux de travail qui dépend de la continuité.
Clients HTTP compatibles au niveau transport
curl_cffi traite l’imitation de client TLS et HTTP/2, comme le documente son projet officiel. Il ne transforme pas une requête HTTP en navigateur qui exécute la page.
Consultez notre guide sur l’empreinte TLS pour les concepts sous-jacents. Considérez une réponse modifiée comme un indice sur la configuration du client, et non comme la preuve qu’une vérification d’empreinte en particulier était responsable.
cloudscraper
Le projet cloudscraper fournit un client Python censé gérer les flux de challenge anti-bot pris en charge. Son existence n’établit pas sa compatibilité avec la protection actuelle d’un site donné.
Gardez-le comme candidat pour un test de compatibilité borné, plutôt que comme réponse universelle. Notre tutoriel sur cloudscraper et les proxies couvre la mise en œuvre sans que nous la dupliquions ici.
Exécution dans un navigateur et outils spécialisés
Un navigateur peut exécuter l’application et exposer le résultat rendu. L’exécution dans un navigateur ne prouve pas à elle seule que la vérification en production acceptera la session.
| Outil | Ce qu’il traite | Ce qui reste non résolu |
|---|---|---|
| nodriver | Automatisation de navigateur via les interfaces décrites dans son dépôt officiel. | Aucune acceptation de challenge garantie. Voir notre configuration de proxy pour nodriver. |
| Camoufox | Un environnement de navigateur axé sur le contrôle des empreintes, d’après sa documentation officielle. | Aucun résultat démontré dans cet instantané. Voir notre guide du proxy pour Camoufox. |
| FlareSolverr | Un service adossé à un navigateur qui renvoie du HTML et des cookies, décrit dans son dépôt officiel. | Les coûts en ressources du navigateur et les échecs de challenge subsistent. Les cookies renvoyés ne sont pas universellement portables. |
| Services de résolution de CAPTCHA | Des fournisseurs tels que CapSolver documentent la gestion des tâches Turnstile. | Un jeton ne vaut ni accès général au site, ni autorisation du propriétaire, ni clearance garantie. |
Continuité de session et collecte plus lente
Préserver une session valide évite de perdre inutilement son état. Cela ne rend pas cet état réutilisable sur des appareils quelconques et n’exempte pas les requêtes des vérifications ultérieures.
Réduire la concurrence et les requêtes en double agit sur la charge et sur les échecs répétés. Cela ne corrige pas un refus d’accès explicite. Mettez en cache les résultats autorisés, procédez à une collecte incrémentale et fixez un budget de nouvelles tentatives fini plutôt que de réessayer après chaque rejet.
Pourquoi Playwright ou Puppeteer restent-ils bloqués sur « Just a moment », et comment tester Turnstile ?
Exécuter JavaScript ne garantit pas de franchir un challenge en production. Cloudflare indique que les navigateurs automatisés, dont Playwright et Puppeteer, ne sont pas pris en charge pour résoudre les challenges en production.
Cette distinction figure dans sa documentation sur les navigateurs pris en charge. Un délai d’attente plus long peut révéler une application lente, mais attendre à répétition ne prouve pas qu’une boucle de vérification finira par se résoudre. Vérifiez le contenu réel de la page et fixez un point d’arrêt borné.
Sur votre propre site, utilisez les sitekeys et clés secrètes factices de Cloudflare. Elles produisent des résultats de test contrôlés, alors que les secrets de production rejettent les jetons factices. Configurez ensemble la sitekey de test côté frontend et le secret de test côté backend.
Testez la soumission réussie, l’échec de vérification, la gestion des jetons en double et l’affichage des erreurs par l’application. Gardez les identifiants de test dans l’environnement de test et vérifiez que la configuration de production ne les hérite pas. Vous testez ainsi votre intégration sans que votre CI dépende de la résolution d’un challenge réel.
Pour la mise en réseau d’un navigateur autorisé, notre guide du proxy pour Playwright couvre la couche de connexion. La configuration du proxy et la prise en charge des challenges en production restent deux questions distinctes.
Peut-on réutiliser cf_clearance ou un jeton Turnstile ?
Conservez une clearance obtenue en bonne et due forme dans sa session d’origine, mais ne la traitez pas comme des identifiants d’accès transférables. Les jetons Turnstile et cf_clearance ont des finalités différentes.
La documentation de Cloudflare sur la clearance indique que Turnstile délivre normalement un jeton à usage unique destiné à la validation côté serveur. Lorsque la pré-clearance est activée, il peut en outre délivrer un cookie de clearance ; ce cookie est lié au visiteur et à l’appareil.
Maintenez stables le contexte de navigateur autorisé et ses conditions réseau pendant un flux de travail. Copier un cookie vers une autre machine ou un autre client n’est pas une stratégie de continuité fiable. Consignez l’expiration ou le retour des challenges comme des événements de session, et ne placez jamais de valeurs de cookies dans des journaux de diagnostic partagés.
Une clearance n’est pas non plus une promesse de trafic futur sans restriction. Concevez le collecteur de manière à ce qu’il se mette en pause et signale toute modification des conditions d’accès, au lieu de supposer qu’une réponse acceptée plus tôt autorise chaque requête ultérieure.
Que montre notre instantané de routes sur sept sites ?
Changer uniquement la route réseau n’a modifié le résultat HTTP d’aucun des sept sites. Changer de client HTTP a bien modifié certaines réponses, mais une page de blocage modifiée n’était pas forcément un contenu exploitable.
Source et date : mesure DataImpulse, 15 octobre 2026, entre 15:00 et 15:30 UTC. Ces résultats constituent un instantané observationnel, et non un benchmark.
Méthode : un GET par cellule site/client/route, soit 28 requêtes HTTP au total. Les requêtes utilisaient des en-têtes Chrome identiques ; curl_cffi utilisait impersonate=chrome. La route datacenter correspondait à l’IP de notre serveur d’hébergement. La route résidentielle utilisait une sortie DataImpulse aux États-Unis, avec une nouvelle session par cellule. Aucun des deux clients HTTP n’exécutait le JavaScript de la page.
Une comparaison distincte a utilisé Chromium headless par défaut via Playwright, sans stealth : un chargement par cellule, une attente de 25 secondes et une vérification du titre final. Elle portait sur six sites et deux routes, soit 12 chargements au total. Discord n’a fait l’objet d’aucune mesure dans un navigateur.
| Site | Datacenter : requests / curl_cffi | Résidentiel : requests / curl_cffi | Headless : les deux routes |
|---|---|---|---|
| g2.com | 403 non classifié / 403 non classifié | 403 non classifié / 403 non classifié | 403, page de blocage non classifiée |
| indeed.com | 403 challenge / 403 challenge | 403 challenge / 403 challenge | Toujours en challenge ou bloqué |
| glassdoor.com | 403 challenge / 403 challenge | 403 challenge / 403 challenge | Toujours en challenge ou bloqué |
| capterra.com | 403 blocage / 403 challenge | 403 blocage / 403 challenge | Toujours en challenge ou bloqué |
| discord.com | 200 / 200 | 200 / 200 | Non testé |
| crunchbase.com | 403 blocage / 403 blocage | 403 blocage / 403 challenge | Toujours en challenge ou bloqué |
| coinbase.com | 403 challenge / 200 | 403 challenge / 200 | Toujours en challenge ou bloqué |
Résidentiel + requests : 1 sur 7
Datacenter + curl_cffi : 2 sur 7
Résidentiel + curl_cffi : 2 sur 7
Coinbase a renvoyé 200 avec curl_cffi sur les deux routes. Capterra est passé d’une page de blocage à un challenge avec ce client. Crunchbase n’a atteint un challenge qu’avec résidentiel + curl_cffi. Ce sont des observations différentes, qui ne devraient pas partager une même étiquette « réussi ».
G2 a renvoyé 403 sans cf-mitigated sur toutes les routes, navigateur compris ; son refus ne peut donc pas être attribué à un challenge Cloudflare. La comparaison avec le navigateur n’a produit aucun challenge franchi, quel que soit le site.
Notre exécution a consigné le statut, les en-têtes et le titre de la page pour chaque cellule. Un collecteur de production devrait consigner cf-mitigated, le type de contenu, le Ray ID, l’horodatage et la validation du contenu attendu. Les réglages inconnus des sites, une seule observation par cellule et des vérifications limitées au titre dans le navigateur restreignent les conclusions causales.
Faut-il utiliser un proxy ou un unblocker managé ?
Un proxy change la route, tandis que votre application garde la maîtrise du comportement du client. Un service d’accès managé prend en charge une plus grande partie du processus de récupération, mais son modèle de session et son unité de facturation doivent être évalués séparément.
Les capacités des fournisseurs ci-dessous proviennent de la documentation produit officielle de chacun, consultée en octobre 2026. Elles décrivent les limites des services, et non des taux de réussite mesurés de façon indépendante.
| Option | Qui exécute les navigateurs et gère les challenges ? | Stabilité de session | Unité de coût |
|---|---|---|---|
| Proxy de datacenter | Votre application | Dépend de l’allocation des sorties et de votre client | Vérifier la facturation par IP ou par trafic du forfait choisi |
| Proxy résidentiel | Votre application | Choisir délibérément entre rotation et routage sticky | Trafic pour l’offre dont il est question ici |
| Proxy mobile | Votre application | Vérifier la continuité lors de véritables changements de réseau | Vérifier le forfait choisi |
| Zyte API | Récupération gérée par le fournisseur, avec options de navigateur | Évaluer le flux de travail d’API choisi | Réponses réussies, variables selon le type de requête et le niveau |
| Bright Data Web Unlocker | Nouvelles tentatives et gestion des CAPTCHA par le fournisseur | Vérifier le flux de travail requis avant l’achat | Requêtes |
| Oxylabs Web Unblocker | Service du fournisseur avec rendu JavaScript | Contrôle des sessions proposé | Go |
| Decodo Site Unblocker | Déblocage géré par le fournisseur | Contrôle des sessions proposé | Requêtes |
Sources : documentation tarifaire de Zyte, tarifs de Bright Data Web Unlocker, tarifs d’Oxylabs Web Unblocker et Decodo Site Unblocker.
Comparez le coût total par enregistrement validé : transfert, rendu, nouvelles tentatives, extractions ratées et maintenance. Une réponse facturée comme réussie peut encore nécessiter vos propres contrôles de schéma et de fraîcheur.
| Méthode | À privilégier quand… | À éviter quand… | Principal coût d’exploitation |
|---|---|---|---|
| Routage résidentiel ou mobile | Recourez aux changements de routage lorsqu’une comparaison autorisée met en cause l’identité réseau. | Évitez les changements de routage lorsque le problème non résolu concerne la permission de l’application ou JavaScript. | Trafic et gestion des sessions |
| curl_cffi | Utilisez curl_cffi lorsque la récupération HTTP suffit et que la compatibilité du client doit être testée. | Évitez curl_cffi comme seule réponse lorsque le flux de travail exige l’exécution dans un navigateur. | Intégration et contrôles de non-régression |
| cloudscraper | Utilisez cloudscraper lorsqu’un test borné confirme la compatibilité. | Évitez cloudscraper lorsque son nom est votre seul élément de preuve. | Maintenance de la compatibilité |
| Outils de navigateur | Utilisez des navigateurs lorsque vous avez besoin du comportement rendu de l’application. | Évitez les navigateurs au seul motif que JavaScript garantirait l’acceptation. | Calcul, mémoire et débogage |
| Intégration d’un solveur | N’évaluez un solveur que dans un flux de travail explicitement autorisé. | Évitez-le pour tester votre propre intégration Turnstile, où les clés factices s’appliquent. | Frais de service et travail de validation |
| Réutilisation de session | Réutilisez une session pour assurer la continuité dans le contexte autorisé d’origine. | Évitez de transférer une clearance entre des clients sans lien. | Gestion de l’état |
| Collecte plus lente | Ralentissez la collecte pour respecter un débit convenu et réduire le travail en double. | Évitez d’y voir un remède à un refus explicite. | Durée d’exécution plus longue |
| Accès managé | Recourez à l’accès managé lorsque l’externalisation de la récupération répond à vos besoins. | Évitez d’acheter avant d’avoir testé la qualité du contenu et les besoins de session. | Frais de service et intégration du fournisseur |
Quelles limites doivent mettre fin aux nouvelles tentatives ?
Arrêtez-vous lorsque la permission fait défaut, que les tentatives répétées n’apportent aucun élément nouveau ou que le contenu récupéré échoue à la validation. Une expérience réussie sur une URL ne peut pas établir la fiabilité sur l’ensemble d’un site.
| Point de contrôle | Poursuivre uniquement avec | S’arrêter ou escalader lorsque |
|---|---|---|
| Permission | Un périmètre de collecte défini et approuvé | Le flux de travail franchit une barrière d’authentification ou de données non approuvée |
| Diagnostic | Un test borné d’une hypothèse précise | Les nouvelles tentatives répètent le même refus sans information nouvelle |
| Contenu | Les champs attendus et une fraîcheur acceptable | Une réponse 200 contient une vérification ou du HTML sans rapport |
| Exploitation | Des débits convenus et un budget de nouvelles tentatives fini | Les coûts ou le volume de requêtes dépassent le plan |
Limitez vos conclusions à ce que les éléments de preuve permettent. Notre instantané n’a pas testé les routes mobiles, les navigateurs spécialisés, les unblockers managés ni les services de résolution. Il n’a pas non plus établi l’exactitude de l’extraction à partir de jeux de données complets. Évaluez ces points séparément, uniquement lorsque le cas d’usage le justifie.
Foire aux questions
Comment savoir si Cloudflare a soumis ma requête Python à un challenge ?
Vérifiez si cf-mitigated a la valeur challenge avant d’essayer d’analyser la charge utile attendue. Cloudflare documente ce marqueur et le type de réponse text/html pour les pages de challenge (voir les sources de diagnostic officielles ci-dessus). Un code de statut seul laisse la cause non résolue.
Pourquoi ne puis-je pas contourner Cloudflare avec un proxy résidentiel ?
Une route résidentielle change l’identité réseau, alors que le client et le flux de travail de l’application peuvent rester incompatibles. Dans notre instantané, changer uniquement la route n’a modifié aucun résultat HTTP sur sept sites. Diagnostiquez les couches restantes avant d’acheter davantage de trafic.
Pourquoi mon navigateur headless affiche-t-il sans cesse « Just a moment » ?
L’exécution dans un navigateur et l’acceptation du challenge sont deux résultats distincts. Cloudflare indique que les navigateurs automatisés ne sont pas pris en charge pour résoudre les challenges en production (voir sa documentation sur les navigateurs pris en charge ci-dessus). Utilisez une attente bornée et signalez la condition d’accès non résolue.
Comment tester Turnstile avec Playwright ou Puppeteer sur mon propre site ?
Utilisez la sitekey factice documentée avec un secret de test correspondant dans votre environnement de test. Les secrets de production rejettent les jetons factices (voir la documentation de test de Cloudflare ci-dessus). Testez à la fois les parcours de vérification acceptés et rejetés.
Pourquoi la page affiche-t-elle « please unblock challenges.cloudflare.com to proceed » ?
Vérifiez si une extension de navigateur ou une politique réseau empêche le chargement des ressources de vérification. Les propriétaires de sites doivent aussi contrôler leur Content Security Policy : Cloudflare documente les autorisations de script et de frame pour challenges.cloudflare.com. La référence officielle est https://developers.cloudflare.com/turnstile/reference/content-security-policy/.
Comment désactiver le CAPTCHA de Cloudflare ?
En tant que visiteur, vous ne pouvez pas modifier la configuration de sécurité d’un autre site. Demandez au propriétaire d’examiner le problème ; les propriétaires peuvent ajuster les paramètres concernés, comme le décrivent les conseils de Cloudflare sur les faux positifs.
L’accessibilité publique ou l’autorisation du fichier robots.txt rendent-elles le scraping licite ?
Ni l’une ni l’autre n’établit une base juridique complète pour la collecte et la réutilisation. Tenez compte de l’autorisation, des restrictions contractuelles, des obligations en matière de vie privée et des règles de droit d’auteur applicables. Les sources primaires de la section sur l’accès autorisé traitent différentes parties de cette évaluation.
Testez la couche IP avec une hypothèse claire
Si vos diagnostics autorisés pointent vers l’identité réseau, comparez une charge de travail réduite et contrôlée avec les proxies résidentiels DataImpulse, disponibles à partir de 1 $ par Go, avec ciblage par pays et sessions rotatives ou sticky. Validez le contenu renvoyé avant de passer à l’échelle : un proxy fournit la route, tandis que votre application reste responsable de la récupération et du comportement des sessions.
Dernière mise à jour : 15 octobre 2026.