
Dalam artikel ini
Python dapat menjadi keterampilan wajib bagi siapa pun yang bekerja jarak jauh dan ingin berkembang dalam kariernya. Bahasa ini fleksibel, ramah bagi pemula, dan sintaksnya sederhana. Terkadang kami memiliki proyek dengan tumpukan data, dan hasil akhirnya sering bergantung pada cara memprioritaskan tugas tertentu. Web scraping data dengan Python menghemat banyak waktu dan tenaga.
Dalam tutorial sebelumnya, kami telah membahas web scraping untuk Amazon, eBay, ChatGPT, dan panduan ini dikhususkan untuk scraping konten video. Kami akan menjelaskan beberapa teknik dan membagikan kode akhirnya kepada pembaca.
Konten apa yang boleh di-scrape?
Mengambil data dari Web masih dianggap sebagai “wilayah abu-abu” secara hukum. Situs web menerapkan kebijakan ketat terkait web scraping karena tindakan ini dapat melanggar kode keamanan mereka. Saat melakukan scraping dan menganalisis data web, Anda harus berhati-hati. Bahkan temuan berbasis riset dapat tanpa sengaja mengungkap informasi pribadi seseorang atau menghasilkan kesimpulan yang bias dan tidak adil. Bukan hanya individu, data juga dapat mengungkap detail sensitif tentang organisasi di balik situs web. Jika data digunakan dengan cara yang keliru, hal itu dapat berdampak negatif pada reputasi platform dan hubungannya dengan audiens.
Anda perlu memahami bahwa tidak semuanya tersedia. Sebagaimana pengguna memiliki hak atas privasi, perusahaan juga berhak merahasiakan aspek tertentu. Jadi, jika ada batas yang jelas, jangan melampauinya. Di bawah ini, Anda dapat melihat informasi yang umumnya diizinkan atau dilarang untuk tujuan web scraping.

Tutorial ini berfokus pada metadata publik, atau sederhananya, “data tentang data”. Saat menelusuri video YouTube di perangkat Anda, Anda mungkin melihat detail seperti channel, tanggal dibuat, deskripsi singkat di bawah video, subscriber, dan komentar. Semua itu adalah metadata. Jika Anda membaca ketentuan layanan YouTube, Anda tahu bahwa pengumpulan data otomatis tidak diizinkan, TETAPI platform mengizinkan web scraping untuk kasus penggunaan nonkomersial, misalnya riset akademik. Salah satu aturannya adalah menggunakan YouTube Data API resmi, jadi pastikan Anda telah mengaktifkannya. Sekarang, mari lanjut ke proses utamanya.
*Tutorial ini hanya ditujukan untuk tujuan edukasi. Kami tidak mendorong atau mendukung tindakan apa pun yang melanggar kebijakan platform, ketentuan layanan, atau hukum yang berlaku. Pengguna harus selalu bertindak secara bertanggung jawab dan menanggung risikonya sendiri.
Instal Python dan beberapa kebutuhan tambahan
Unduh Python 3.x dari https://www.python.org/ lalu selesaikan instalasinya di komputer Anda. Buka terminal dan instal Requests menggunakan pip:
pip3 install requests
Untuk menjalankan semua perintah yang diperlukan, kami menggunakan terminal di Visual Studio Code (VS Code). Cukup unduh dari situs web resmi lalu ikuti petunjuk instalasi untuk sistem operasi Anda.
Untuk memastikan lingkungan kami aman dan privat, kami menggunakan proxy DataImpulse, yang menjadi jaminan kuat untuk request terenkripsi. Daftar dan buka bagian Proxy. Pilih paket yang Anda perlukan. Catat kredensial proxy (login, password, host, port) yang diberikan oleh DataImpulse. Kami akan memerlukan informasi ini untuk langkah berikutnya.
Terakhir, kita perlu menginstal library yt-dlp . Library ini adalah program command-line yang banyak digunakan untuk mengunduh video dari YouTube dan aplikasi video lainnya. Gunakan perintah ini:
pip install yt-dlp requests
Kode 1. Mengunduh video
Metode download() dijalankan dengan bantuan YouTubeDL, sebuah perangkat lunak open-source yang mengunduh segmen video dan audio. Alat ini gratis. Dalam tutorial ini, kami akan menggunakan video tentang proxy rotator dari channel YouTube.
Pastikan Anda mengganti User dan Password dengan kredensial proxy DataImpulse Anda yang sebenarnya.
Host-nya adalah gw.dataimpulse.com. Berikut kode yang Anda perlukan:
from yt_dlp import YoutubeDL
video_url = "https://youtu.be/S-9_AHRq-LI?si=07PJYpRm23m5uHCl"
opts = {
# Proxy format: "http://user:password@host:port" or "http://host:port"
'proxy': 'http://user:[email protected]:port',
"no_warnings": True,
}
with YoutubeDL(opts) as yt:
yt.download([video_url])
Kode 2. Scraping subtitle video
Subtitle berisi teks terstruktur yang merepresentasikan ucapan sebenarnya dalam video, jadi Anda tidak perlu memproses audionya. Subtitle berguna dalam banyak kasus, misalnya untuk melatih model bahasa atau mencari video berdasarkan kata kunci. Dengan kode di bawah ini, Anda dapat melakukan scraping subtitle dan membuat file .vtt yang memuatnya.
import yt_dlp
VIDEO_URL = "https://www.youtube.com/watch?v=S-9_AHRq-LI"
PROXY = "http://username:[email protected]:port"
LANGS = ["en"] # subtitle languages (or ["all"])
def download_subtitles():
ydl_opts = {
"writesubtitles": True,
"writeautomaticsub": True,
"subtitleslangs": LANGS,
"subtitlesformat": "vtt",
"no_warnings": True,
"skip_download": True,
"quiet": True,
}
if PROXY:
ydl_opts["proxy"] = PROXY
print(f"Downloading subtitles for: {VIDEO_URL}")
with yt_dlp.YoutubeDL(ydl_opts) as ydl:
info = ydl.extract_info(VIDEO_URL, download=True)
vid = info.get("id", "unknown")
title = info.get("title", "Untitled")
print(f"Subtitles downloaded for: {title} ({vid})")
subs = info.get("subtitles") or {}
auto = info.get("automatic_captions") or {}
if subs or auto:
print("Available subtitle languages:")
for lang in sorted(set(list(subs.keys()) + list(auto.keys()))):
print(" -", lang)
else:
print("No subtitles found.")
print("Files saved successfully.")
if __name__ == "__main__":
download_subtitles()
Kode 3. Mengambil data video
Di bawah setiap video YouTube, Anda dapat menemukan judul, durasi, bahasa, jumlah penayangan, dan detail lain yang menunjukkan apakah video tersebut relevan bagi Anda atau tidak. Bagian kode berikut menunjukkan cara mengambil metadata dasar tentang video YouTube tertentu. Simpan untuk nanti:
from yt_dlp import YoutubeDL
VIDEO_URL = "https://www.youtube.com/watch?v=S-9_AHRq-LI"
PROXY = "http://username:[email protected]:port" # your proxy (or None)
def fetch_video_info(url: str, proxy: str | None = None):
"""Fetch basic metadata about a YouTube video using yt-dlp (with proxy support)."""
opts = {
"quiet": True, # suppress yt-dlp internal output
"no_warnings": True,
"skip_download": True, # do not download the video
"proxy": proxy, # proxy configuration
}
with YoutubeDL(opts) as ydl:
info = ydl.extract_info(url, download=False)
video_data = {
"title": info.get("title", "Unknown"),
"uploader": info.get("uploader", "Unknown"),
"duration_sec": info.get("duration", 0),
"width": info.get("width"),
"height": info.get("height"),
"language": info.get("language", "Unknown"),
"view_count": info.get("view_count", 0),
"like_count": info.get("like_count", 0),
"upload_date": info.get("upload_date"),
}
return video_data
if __name__ == "__main__":
print(f"Fetching video info via proxy: {PROXY or 'No proxy'}")
info = fetch_video_info(VIDEO_URL, PROXY)
print("\nVideo Information:")
for key, value in info.items():
print(f"{key:>15}: {value}")
Kode 4. Mengumpulkan komentar video
Ingin memahami perasaan audiens terhadap konten, melatih data AI, dan menemukan ide viral? Lakukan scraping pada komentar video. Dalam kasus ini, gunakan getcomments dan atur nilainya menjadi True. Selanjutnya, cukup gunakan metode extract_info() untuk melihat lima komentar pertama dari video YouTube. Coba yang ini:
from yt_dlp import YoutubeDL
VIDEO_URL = "https://www.youtube.com/watch?v=S-9_AHRq-LI"
PROXY = "http://username:[email protected]:10000" # your proxy (or None)
def fetch_comments(url: str, proxy: str | None = None):
opts = {
"quiet": True,
"no_warnings": True,
"skip_download": True,
"extract_flat": False,
"getcomments": True,
"proxy": proxy,
}
print(f"Fetching comments for: {url}")
with YoutubeDL(opts) as ydl:
info = ydl.extract_info(url, download=False)
comments = info.get("comments") or []
comment_count = info.get("comment_count", len(comments))
print(f"\nTotal comments found: {comment_count}")
if not comments:
print("No comments available or comments disabled.")
return
print(f"\nShowing first 5 comments:\n")
for i, comm in enumerate(comments[:5], 1):
author = comm.get("author", "Anonymous")
text = comm.get("text", "").replace("\n", " ")
print(f"{i:02d}. {author}: {text}")
return comments
if __name__ == "__main__":
fetch_comments(VIDEO_URL, PROXY)
fetch_comments digunakan untuk meminta dan mengekstrak data komentar dari sebuah video melalui API platform.
Kode 5. Scraping informasi channel
Metode ini sangat baik untuk mengidentifikasi metrik SEO utama: topik yang memiliki peringkat baik, video yang mendorong lalu lintas, dan performa channel dalam pencarian. Sebelum beralih ke kode, kita harus mendapatkan API key dari Google Cloud Console.
1. Buka Google Cloud Console dan buat project baru. Tambahkan nama project, organisasi, lokasi, lalu klik Buat.


2. Buka Aktifkan API dan Layanan, lalu cari YouTube Data API v3 dan aktifkan.


3. Buka Kredensial, buat API key, lalu salin ke dalam kode Anda.

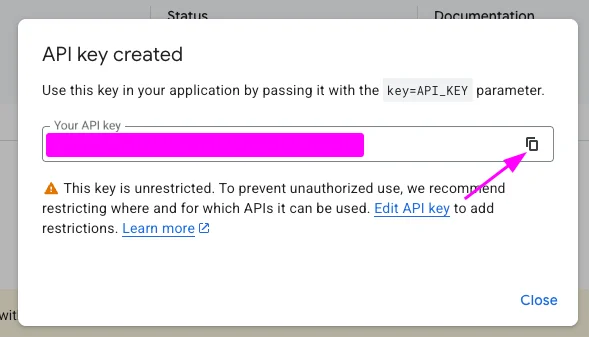

Sekarang, dengan YouTube API v3, Anda dapat melakukan scraping nama channel, deskripsinya, dan jumlah pengikutnya. Berikut kodenya:
import requests
API_KEY = "Your API key"
HANDLE = "@DataImpulseOfficial"
PROXY = "https://username:[email protected]:port"
HEADERS = {"Accept-Language": "en-US,en;q=0.9",
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
def get_channel_id_by_handle(handle):
url = f"https://www.googleapis.com/youtube/v3/channels"
params = {"part": "id", "forHandle": handle, "key": API_KEY}
r = requests.get(url, params=params, headers=HEADERS,
proxies={"http": PROXY, "https": PROXY} if PROXY else None)
r.raise_for_status()
items = r.json().get("items", [])
if not items:
raise SystemExit(f"No channel found for handle {handle}")
return items[0]["id"]
def get_channel_data(channel_id):
url = f"https://www.googleapis.com/youtube/v3/channels"
params = {"part": "snippet,statistics", "id": channel_id, "key": API_KEY}
r = requests.get(url, params=params, headers=HEADERS,
proxies={"http": PROXY, "https": PROXY} if PROXY else None)
r.raise_for_status()
return r.json()["items"][0]
def main():
channel_id = get_channel_id_by_handle(HANDLE)
data = get_channel_data(channel_id)
name = data["snippet"]["title"]
desc = data["snippet"].get("description", "")
subs = int(data["statistics"].get("subscriberCount", 0))
print("Channel:", name)
print("URL:", f"https://www.youtube.com/channel/{channel_id}")
print("Description: " + (desc or "(no description)"))
print(f"Subscribers: {subs:,}")
if __name__ == "__main__":
main()
Kode 6. Scraping hasil pencarian
Dalam contoh ini, kata kuncinya adalah “DataImpulse” dan script mengembalikan 5 hasil pertama (MAX_RESULTS = 5). Kami akan menggunakan beberapa pengaturan untuk menghindari playlist, peringatan, dan output yang tidak diperlukan. Untuk setiap video yang ditemukan, script mencetak detail utama di konsol: judul, nama channel, jumlah penayangan, durasi video, serta tautan ke video dan channel.
Simpan kodenya:
from yt_dlp import YoutubeDL
MAX_RESULTS = 5
QUERY = "DataImpulse"
PROXY = "http://username:[email protected]:port"
opts = {
"proxy": PROXY,
"default_search": "ytsearch",
"noplaylist": True,
"no_warnings": True,
"extract_flat": True,
"quiet": True
}
def format_duration(seconds):
"""Convert seconds → hh:mm:ss format"""
if not seconds:
return "00:00"
seconds = int(seconds)
h, m = divmod(seconds, 3600)
m, s = divmod(m, 60)
if h:
return f"{h:02d}:{m:02d}:{s:02d}"
else:
return f"{m:02d}:{s:02d}"
def main():
with YoutubeDL(opts) as yt:
search_query = f"ytsearch{MAX_RESULTS}:{QUERY}"
info = yt.extract_info(search_query, download=False)
entries = info.get("entries", [])
data = []
for video in entries:
data.append({
"title": video.get("title"),
"channel": video.get("channel"),
"view_count": video.get("view_count"),
"duration": video.get("duration"),
"url": video.get("url"),
"channel_url": video.get("channel_url"),
})
print(f"Showing {len(data)} video results:\n")
for info in data:
print("Title: " + info["title"])
print("Channel: " + info["channel"])
print("Views: " + str(info["view_count"]))
print("Duration: " + str(format_duration(info["duration"])))
print("Video URL: " + info["url"])
print("Channel URL: " + info["channel_url"])
print("-" * 60)
if __name__ == "__main__":
main()
Poin Utama:
- Web scraping masih berada dalam “wilayah abu-abu” secara hukum dan etika. Platform memiliki kebijakan ketat karena scraping dapat memengaruhi keamanan, privasi, atau konten berhak cipta.
- Tidak semuanya dapat di-scrape. Metadata domain publik dan yang dapat diakses secara publik mungkin diizinkan, tetapi konten privat atau yang dilindungi DRM dilarang.
- Anda memerlukan YouTubeDL dan library yt-dlp untuk mengunduh dan mengekstrak data video.
- Untuk mengumpulkan informasi tentang channel, dapatkan API key dari Google Cloud Console dan aktifkan YouTube Data API v3.
- Dengan proxy DataImpulse, Anda tidak perlu khawatir tentang kemungkinan penolakan akses atau lingkungan yang tidak aman. Kami melindungi privasi Anda, menjaga request tetap aman, dan membantu Anda mengakses data yang diperlukan.