
この記事の内容
エージェント型ブラウジングインフラとは、AIエージェントがWebを大規模に閲覧・操作するための基盤です。1つのアシスタントがページを開くだけでなく、多数のエージェントがリアルタイムのWebを巡回し、情報を読み取り、タスクを確実に完了できるようにします。AIが「回答する」段階から「実行する」段階へ移るにつれ、「ブラウザを使えるエージェント」に求められるものは、「多数のブラウザエージェントをブロックされずに稼働させる仕組み」へと変わります。本ガイドでは、エージェント型ブラウジングインフラの定義とレイヤー構成を整理し、エージェントごとのアイデンティティを持つプロキシからなるアクセスレイヤーが、なぜ基盤となるのかを解説します。
私はAndrii Byzovです。AIネイティブの非常勤CMOとして、エージェントとWebデータのシステムを構築しています。以下では、その定義、通常のブラウジングとの違い、構成要素、フリート規模で生じるブロックの問題、そしてプロキシの役割を解説します。この記事はAI向けWebデータインフラの一部です。
重要なポイント
- エージェント型ブラウジングインフラは、AIブラウザエージェントを大規模に稼働させるための基盤です。 オーケストレーション、ブラウザ自動化、アクセス、セッション管理で構成されます。
- これは単一のブラウザではなく、エージェントフリートの課題です。 多数のエージェント、タスク、市場を同時に扱います。
- ブロッキングが中核となる制約です。 1つのIPから繰り返し取得して操作するエージェントは、すぐにレート制限を受け、フラグが立てられます。
- エージェントごとのアイデンティティが重要です。 各エージェントは、1つのIPが数千件のリクエストを行っているように見えるのではなく、別々の実在ユーザーのように見えるべきです。
- セッション単位のアイデンティティを備えた住宅用プロキシがアクセスレイヤーです。 エージェントフリートの接続性と識別性を維持します。
エージェント型ブラウジングインフラとは?
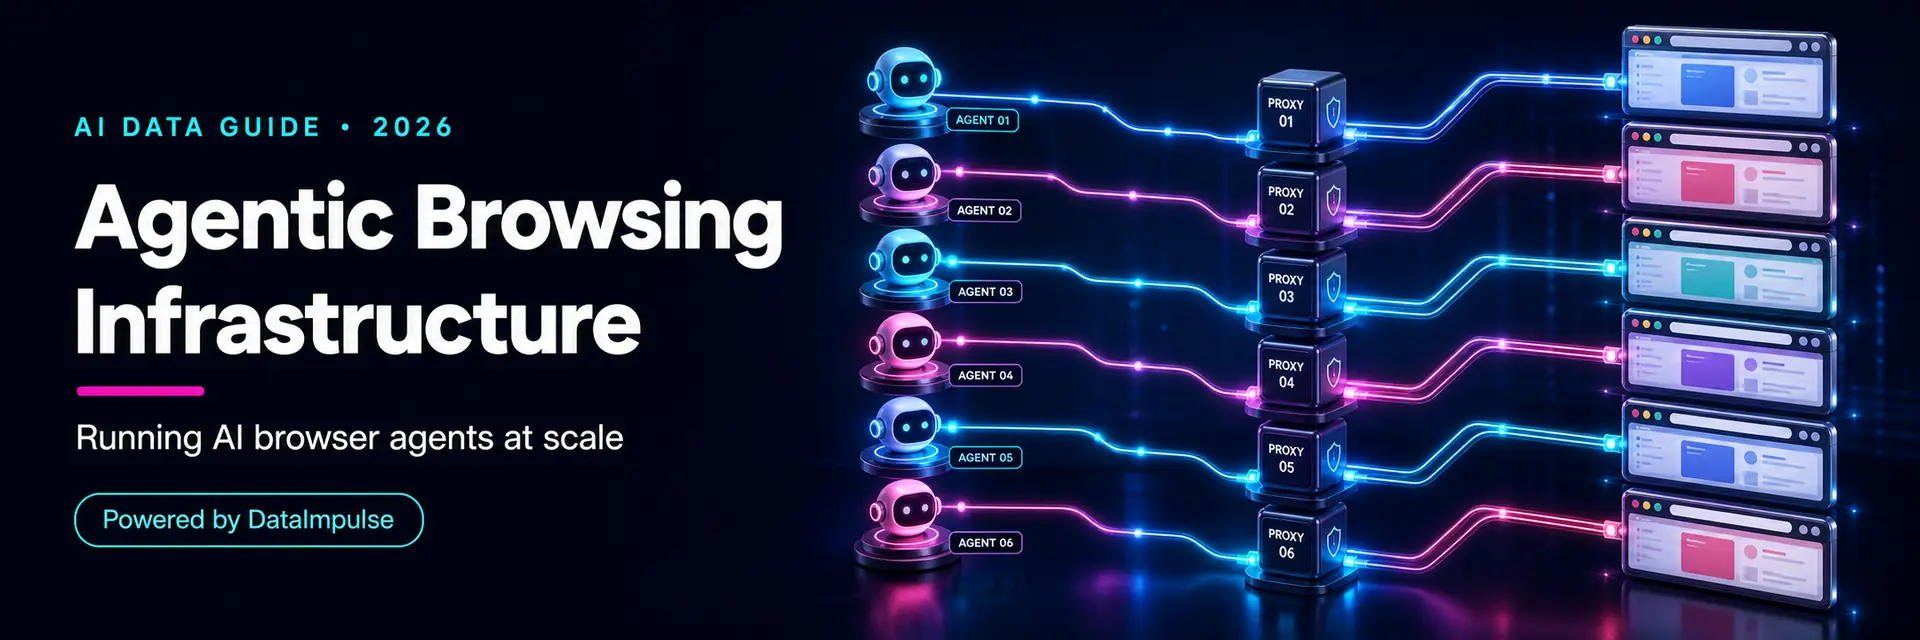
これは、Webを閲覧し、Web上で操作を行うAIエージェントを、大規模かつ安定して稼働させるための基盤全体を指します。単一のAIブラウザは製品です。一方、エージェント型ブラウジングのインフラは、リサーチ、モニタリング、ショッピング、テスト、自動化などのために、チームが多数のエージェントを運用するための基盤です。各エージェントがブロック、地域制限、検知に妨げられないようにします。これは、何をすべきかを判断するモデルであるエージェントロジックの下層で、生のWebの上層に位置します。「エージェントがこのページを開ける」状態を、「エージェント群が市場をまたいで何千回も実行できる」状態へと変えるものです。
通常のブラウジングとの違い
- 規模。 1人のユーザーは順に閲覧しますが、エージェント群は常時並列で閲覧します。
- 検知圧力。 サイトは人間による利用には寛容でも、同じ送信元から大量に発生する自動セッションには積極的に対策します。
- アイデンティティ。各エージェントは別々のユーザーに見える必要があります。共有IPを使うと、エージェント群全体が1つのボットのように見えてしまいます。
- 地域性。 エージェントは特定の市場から操作する必要があることが多く、接続元の地域もインフラの一部です。
構成要素
オーケストレーション。 多数のエージェント、リトライ、タスクキューのスケジューリングと調整。
ブラウザ自動化。 ヘッドレスブラウザ、またはエージェントがナビゲーションや操作を行うための自動化フレームワーク(AIブラウザエージェントの実行を参照)。
アクセスレイヤー。 ブロックされず、適切な地域からページにアクセスするためのレイヤーです。つまりプロキシであり、通常は規模を拡大する際の制約要因になります。
セッションとアイデンティティ。 各エージェントを個別かつ一貫したユーザーとして維持します。各エージェントに専用のIPセッションを割り当て、挙動の一貫性と分離を保ちます。
フリート規模でのブロッキング問題
単純なエージェントフリートが破綻する原因は、モデルではなくブロックです。1つのIPレンジから10体、あるいは1000体のエージェントを実行すると、ターゲットサイトには1つの発信元から自動化トラフィックが殺到しているように見えます。その結果、レート制限、CAPTCHA、ボット対策ウォール、そしてBANがすぐに発生します。そこから生じる2つのニーズは、個別のアイデンティティ(各エージェントがそれぞれ独立したユーザーに見えること)と、地域に適合したアクセス(エージェントが必要な市場から操作すること)です。これらに対処すれば、IPレベルのボトルネックは緩和されます。ただし、フィンガープリンティング、CAPTCHA、認証、レート制限は依然として個別タスクを停止させる可能性があります。これらを無視すると、フリートはまずブロックによって崩壊します。
# Give each agent in the fleet its own proxy session so it looks like a
# distinct real user (the ;sid keeps an agent on the same exit IP for the
# session; the exit can change if that residential peer drops).
def proxy_for_agent(agent_id, country="us"):
return (f"http://LOGIN__cr.{country};sid.agent{agent_id}:"
f"[email protected]:823")
# e.g. launch each browser-automation worker with its own session
for agent_id in range(10):
proxy = proxy_for_agent(agent_id)
# browser.launch(proxy=proxy) -> each agent = a separate apparent user
プロキシの役割
プロキシが役割を果たすのは、アクセスレイヤーとアイデンティティレイヤーです。フリート規模では、これが基盤そのものになります。住宅用プロキシは各エージェントを実在の消費者IP経由でルーティングし、セッションごとのアイデンティティ(sid)によって、各エージェントをそのセッション中は固有の出口IPに固定します。そのため、群れの一部ではなく、個別で一貫性のあるユーザーとして認識されます(その住宅ピアが切断された場合、出口は変更されることがあります)。高い同時接続性を備えたローテーション型の住宅用プロキシプールにより、多数のエージェントを適切な市場から並列に実行できます。DataImpulseの住宅用プロキシは195+のロケーションで$1/GBから、モバイルは$2/GBから利用でき、フリート向けの高い同時接続性にも対応しています。プロキシはアクセスとアイデンティティを処理し、オーケストレーションはエージェントを処理します。すべての防御を突破できるわけではありません。サイトは依然としてCAPTCHAや行動検知を使用しますが、フリートを最初に止めるIPレベルのボトルネックを取り除きます。
エージェント型ブラウジングを大規模に実行することは合法ですか?
ブラウザエージェントの実行には、あらゆる自動化されたWebアクセスと同じルールが適用されます。また、アクセスパターンが似ている場合でも、規模が大きくなると、法務、プライバシー、契約、迂回防止に関するリスクが高まる可能性があります。正当性を保つには、各サイトの利用規約を尊重し、robots.txtをポリシー上のシグナルとして扱うこと、ログイン、ペイウォール、アクセス制御を回避しないこと、リクエストを集中させず適切な間隔で送信すること、公開されている非個人データに限定することが重要です。許可された自動化にプロキシを使用することは一般的に合法ですが、禁止措置、アクセス制御、契約上の制限を回避するために使用すると、法的リスクやアカウントリスクが生じます。合法的な範囲は、公開タスクの実際の自動化であり、迂回ではありません。Webスクレイピングが合法かどうかをご覧ください。これは一般的な情報であり、法的助言ではありません。
よくある質問
エージェント型ブラウジングインフラとは何ですか?
AIエージェントがWeb上で大規模にブラウズし、操作できるようにするスタックです。オーケストレーション、ブラウザ自動化、アクセスレイヤー(プロキシ)、セッション/アイデンティティ管理で構成されます。エージェントの意思決定ロジックの下層で、生のWebの上層に位置し、「エージェントがページを開ける」状態を「エージェントのフリートが市場をまたいで信頼性高く実行できる」状態へ変換します。
単一のAIブラウザとは何が違いますか?
単一のAIブラウザは1人が使うプロダクトですが、エージェント型ブラウジングインフラは多数のエージェントを並列に稼働させます。これにより、単一ブラウザでは直面しないフリート特有の課題、つまり検知圧力、エージェントごとのアイデンティティ、地理条件が生じます。難しいのは、1つのブラウザを操作することではなく、フリート全体を到達可能かつ個別に識別された状態に保つことです。
なぜエージェントのフリートはブロックされるのですか?
1つのIPレンジから多数の自動化セッションが発生すると、1つのボットのように見えるためです。サイトは人間の利用は許容しますが、同じ送信元からの自動化トラフィックの大量発生には、レート制限、CAPTCHA、BANで積極的に防御します。エージェントごとの個別アイデンティティと地域に適したアクセスがなければ、フリートはすぐにこれらの防御に引っかかります。
エージェント型ブラウジングにおいてプロキシはどこに位置づけられますか?
プロキシはアクセスとアイデンティティのレイヤーです。住宅用プロキシは各エージェントを実際の消費者IP経由でルーティングし、セッションごとのアイデンティティによって各エージェントをそれぞれの出口IPに維持するため、個別のユーザーとして認識されます。高い同時接続性を備えたローテーションプールにより、多数のエージェントを適切な市場から並列に実行でき、フリートを最初に止めるIPレベルのボトルネックを取り除きます。
ブラウザエージェントを大規模に運用することは合法ですか?
自動化されたWebアクセス一般と同じルールに従います。サイトの利用規約とrobots.txtを尊重し、ログインやアクセス制御を迂回せず、リクエストの間隔を適切に取り、公開されている非個人データに限定してください。許可された自動化のためにプロキシを使用することは一般的に合法ですが、BANやアクセス制御を回避するために使用すると、法的リスクやアカウントリスクが生じます。法的助言ではありません。
結論
エージェント型ブラウジングインフラは、「ブラウザを使えるエージェント」を実際に機能するフリートへと変えるものです。そして、その制約となるのは知能ではなくアクセスです。多くのエージェントが並行して動作する場合、それぞれが適切な市場の別個のユーザーに見えなければブロックされます。そこで必要になるのが、プロキシとアイデンティティのレイヤーです。オーケストレーションとエージェントロジックは自社で構築し、セッション単位のアイデンティティと高い同時実行性を備えた住宅プロキシのアクセスレイヤーはレンタルしましょう。各要素について詳しくは、AIブラウザエージェントの実行、OpenAI Operator向けプロキシ、AI向けWebデータインフラをご覧ください。
最終更新日:2026年6月28日。