
In this Article
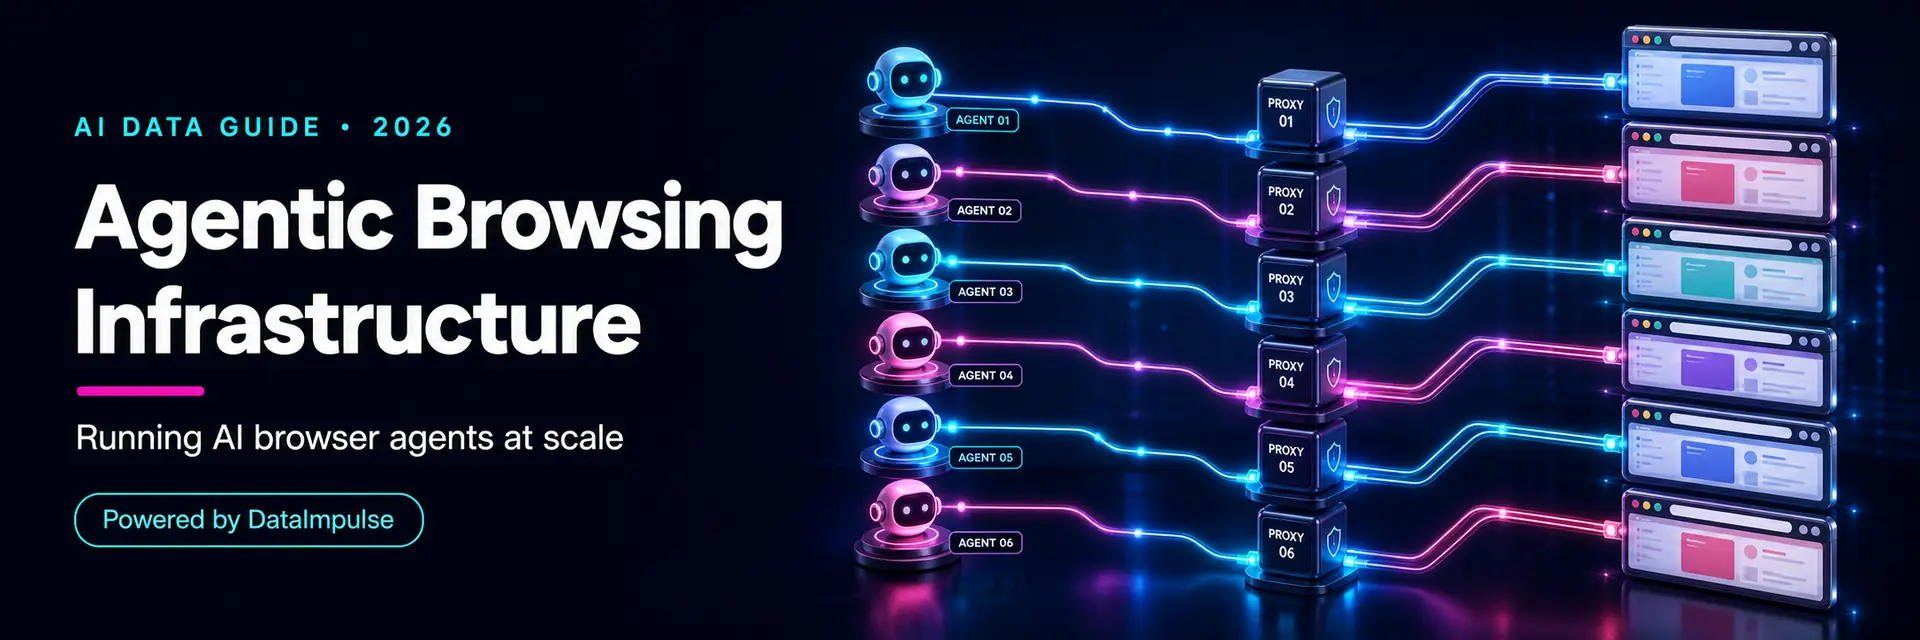
โครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์คือชุดระบบที่ทำให้เอเจนต์ AI ท่องเว็บและดำเนินการบนเว็บได้ในระดับขนาดใหญ่ ไม่ใช่ผู้ช่วยเพียงตัวเดียวที่เปิดหน้าเว็บ แต่เป็นกลุ่มเอเจนต์จำนวนมากที่นำทาง อ่าน และทำงานให้เสร็จบนเว็บจริงได้อย่างน่าเชื่อถือ เมื่อ AI เปลี่ยนจากการตอบคำถามสู่การลงมือทำ “เอเจนต์ที่ใช้เบราว์เซอร์ได้” จึงกลายเป็น “ระบบที่รันเอเจนต์เบราว์เซอร์จำนวนมากโดยไม่ถูกบล็อก” คู่มือนี้อธิบายความหมายของโครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์ แยกองค์ประกอบเป็นชั้นต่าง ๆ และอธิบายเหตุผลที่ชั้นการเข้าถึง ซึ่งก็คือ proxy ที่มีตัวตนแยกตามเอเจนต์ เป็นรากฐานสำคัญ
ผมคือ Andrii Byzov, ผู้บริหารการตลาดแบบพาร์ตไทม์ที่มี AI เป็นแกนหลัก ผู้สร้างระบบเอเจนต์และข้อมูลเว็บ เนื้อหาด้านล่างอธิบายความหมายอย่างตรงไปตรงมา ความแตกต่างจากการท่องเว็บทั่วไป องค์ประกอบ ปัญหาการถูกบล็อกเมื่อใช้งานเป็นกลุ่ม และตำแหน่งของ proxy โดยเป็นส่วนหนึ่งของ โครงสร้างพื้นฐานข้อมูลเว็บสำหรับ AI.
ข้อเท็จจริงสำคัญ
- โครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์ = ชุดระบบสำหรับรันเอเจนต์เบราว์เซอร์ AI ในระดับขนาดใหญ่ ซึ่งรวมถึงการประสานงาน ระบบอัตโนมัติของเบราว์เซอร์ การเข้าถึง และการจัดการเซสชัน
- นี่คือปัญหาของกลุ่มเอเจนต์ ไม่ใช่ปัญหาของเบราว์เซอร์เพียงตัวเดียว เอเจนต์มากมาย งานมากมาย หลายตลาด ในเวลาเดียวกัน
- การถูกบล็อกคือข้อจำกัดหลัก เอเจนต์ที่ดึงข้อมูลและดำเนินการซ้ำ ๆ จาก IP เดียวจะถูกจำกัดอัตราและถูกระบุได้อย่างรวดเร็ว
- ตัวตนแยกตามเอเจนต์มีความสำคัญ เอเจนต์แต่ละตัวควรดูเหมือนผู้ใช้จริงที่แยกจากกัน ไม่ใช่ IP เดียวที่ส่งคำขอนับพันครั้ง
- Residential proxy ที่มีตัวตนแยกตามเซสชันคือชั้นการเข้าถึง ซึ่งทำให้กลุ่มเอเจนต์เข้าถึงได้และมีตัวตนแยกกัน
โครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์คืออะไร?
นี่คือทุกสิ่งที่จำเป็นต่อการรันเอเจนต์ AI ที่ท่องเว็บและดำเนินการได้อย่างน่าเชื่อถือในระดับขนาดใหญ่ เบราว์เซอร์ AI เพียงตัวเดียวคือผลิตภัณฑ์ ส่วนโครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์คือสิ่งที่ช่วยให้ทีมรันเอเจนต์จำนวนมากเพื่อการวิจัย การติดตาม การช้อปปิ้ง การทดสอบ และระบบอัตโนมัติได้ โดยแต่ละตัวไม่สะดุดกับการบล็อก กำแพงตามภูมิศาสตร์ หรือการตรวจจับ ระบบนี้อยู่ใต้ตรรกะของเอเจนต์ ซึ่งเป็นโมเดลที่ตัดสินใจว่าจะทำอะไร และอยู่เหนือเว็บดิบ เปลี่ยนจาก “เอเจนต์อาจเปิดหน้านี้ได้” เป็น “กลุ่มเอเจนต์ทำสิ่งนี้ได้หลายพันครั้งในหลายตลาด”
แตกต่างจากการท่องเว็บทั่วไปอย่างไร
- ขนาดการใช้งาน คนหนึ่งคนท่องเว็บทีละอย่าง แต่กลุ่มเอเจนต์ท่องเว็บแบบขนานอย่างต่อเนื่อง
- แรงกดดันจากการตรวจจับ เว็บไซต์ยอมรับผู้ใช้มนุษย์ แต่จะป้องกันเซสชันอัตโนมัติจำนวนมากจากแหล่งเดียวกันอย่างจริงจัง
- ตัวตน เอเจนต์แต่ละตัวต้องดูเหมือนผู้ใช้คนละราย IP ที่ใช้ร่วมกันทำให้กลุ่มเอเจนต์ดูเหมือนบอตตัวเดียว
- ภูมิศาสตร์ เอเจนต์มักต้องดำเนินการจากตลาดที่เฉพาะเจาะจง ดังนั้นตำแหน่งที่ตั้งจึงเป็นส่วนหนึ่งของโครงสร้างพื้นฐาน
องค์ประกอบ
การประสานงาน การจัดตารางและประสานงานเอเจนต์จำนวนมาก การลองใหม่ และคิวงาน
ระบบอัตโนมัติของเบราว์เซอร์ เบราว์เซอร์แบบ ไร้ส่วนติดต่อกราฟิก หรือเฟรมเวิร์กระบบอัตโนมัติที่เอเจนต์ใช้เพื่อนำทางและดำเนินการ (ดู การรันเอเจนต์เบราว์เซอร์ AI)
ชั้นการเข้าถึง การเข้าถึงหน้าเว็บจากตำแหน่งที่ถูกต้องโดยไม่ถูกบล็อก ซึ่งก็คือ proxy นี่มักเป็นข้อจำกัดที่กำหนดขีดความสามารถเมื่อใช้งานในระดับขนาดใหญ่
เซสชันและตัวตน ทำให้เอเจนต์แต่ละตัวเป็นผู้ใช้ที่มีตัวตนแยกและสม่ำเสมอ ด้วยเซสชัน IP ของตัวเอง เพื่อให้พฤติกรรมยังคงต่อเนื่องและแยกออกจากกันได้
ปัญหาการถูกบล็อกเมื่อใช้งานเป็นกลุ่มเอเจนต์
สิ่งที่ทำให้กลุ่มเอเจนต์แบบพื้นฐานใช้งานไม่ได้ไม่ใช่โมเดล แต่คือการถูกบล็อก เมื่อรันเอเจนต์สิบหรือหนึ่งพันตัวจากช่วง IP เดียว เว็บไซต์เป้าหมายจะเห็นทราฟฟิกอัตโนมัติหลั่งไหลจากแหล่งเดียว และการจำกัดอัตรา CAPTCHAs กำแพงบอต และการแบนจะตามมาอย่างรวดเร็ว สิ่งที่จำเป็นจึงมีสองอย่าง คือ ตัวตนที่แยกกัน (เอเจนต์แต่ละตัวดูเหมือนผู้ใช้ของตัวเอง) และ การเข้าถึงจากภูมิศาสตร์ที่ถูกต้อง (เอเจนต์ดำเนินการจากตลาดที่ต้องการ) หากจัดการสองสิ่งนี้ได้ คอขวดระดับ IP จะลดลง แม้ว่าการทำ การระบุลายนิ้วมือ, CAPTCHAs, การยืนยันตัวตน และการจำกัดอัตรายังคงหยุดงานแต่ละงานได้ การละเลยสิ่งเหล่านี้ทำให้กลุ่มเอเจนต์ล้มเหลวเพราะถูกบล็อกก่อน
# Give each agent in the fleet its own proxy session so it looks like a
# distinct real user (the ;sid keeps an agent on the same exit IP for the
# session; the exit can change if that residential peer drops).
def proxy_for_agent(agent_id, country="us"):
return (f"http://LOGIN__cr.{country};sid.agent{agent_id}:"
f"[email protected]:823")
# e.g. launch each browser-automation worker with its own session
for agent_id in range(10):
proxy = proxy_for_agent(agent_id)
# browser.launch(proxy=proxy) -> each agent = a separate apparent user
proxy อยู่ตรงไหน
ชั้นการเข้าถึงและตัวตนคือจุดที่ proxy ทำงาน และเมื่อใช้งานเป็นกลุ่มเอเจนต์ สิ่งนี้คือรากฐาน Residential proxy ส่งเอเจนต์แต่ละตัวผ่าน IP ของผู้บริโภคจริง และตัวตนแยกตามเซสชัน (คือ sid) ทำให้เอเจนต์แต่ละตัวใช้ IP ขาออก ของตัวเองตลอดเซสชัน จึงดูเป็นผู้ใช้ที่แยกและสม่ำเสมอ ไม่ใช่ส่วนหนึ่งของกลุ่มจำนวนมาก (IP ขาออกอาจเปลี่ยนได้หาก โหนด residential นั้นหลุด) กลุ่ม residential ที่หมุนเวียน IP พร้อม การทำงานพร้อมกันสูง ทำให้เอเจนต์จำนวนมากทำงานแบบขนานจากตลาดที่ถูกต้องได้ โดย DataImpulse residential เริ่มที่ $1/GB (mobile เริ่มที่ $2/GB) ครอบคลุม 195+ ตำแหน่ง พร้อมการทำงานพร้อมกันสูง สำหรับกลุ่มเอเจนต์ proxy จัดการการเข้าถึงและตัวตน ส่วนการประสานงานของคุณจัดการเอเจนต์ ระบบนี้ไม่ได้เอาชนะทุกการป้องกัน เว็บไซต์ยังใช้ CAPTCHAs และการตรวจจับพฤติกรรม แต่ช่วยขจัดคอขวดระดับ IP ที่ทำให้กลุ่มเอเจนต์หยุดทำงานก่อน
การรันการท่องเว็บแบบเอเจนต์ในระดับขนาดใหญ่ถูกกฎหมายหรือไม่?
การรันเอเจนต์เบราว์เซอร์อยู่ภายใต้กฎเดียวกับการเข้าถึงเว็บแบบอัตโนมัติทุกประเภท และขนาดการใช้งานอาจเพิ่มประเด็นด้านกฎหมาย ความเป็นส่วนตัว สัญญา และการหลีกเลี่ยงมาตรการ แม้รูปแบบการเข้าถึงจะดูคล้ายกัน ควรทำให้การใช้งานมีเหตุผลรองรับ: เคารพข้อกำหนดของแต่ละเว็บไซต์และถือว่า robots.txt เป็นสัญญาณด้านนโยบาย อย่าข้ามการเข้าสู่ระบบ กำแพงการชำระเงิน หรือการควบคุมการเข้าถึง ส่งคำขออย่างพอเหมาะแทนการถล่ม และใช้เฉพาะข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคล โดยทั่วไปการใช้ proxy สำหรับระบบอัตโนมัติที่ได้รับอนุญาตนั้นชอบด้วยกฎหมาย แต่การใช้เพื่อหลบเลี่ยงการแบน การควบคุมการเข้าถึง หรือข้อจำกัดตามสัญญา ก่อให้เกิดความเสี่ยงทางกฎหมายและต่อบัญชี แนวทางที่ชอบด้วยกฎหมายคือระบบอัตโนมัติจริงสำหรับงานสาธารณะ ไม่ใช่การหลีกเลี่ยงมาตรการ ดู web scraping ถูกกฎหมายหรือไม่ เนื้อหานี้เป็นข้อมูลทั่วไป ไม่ใช่คำแนะนำทางกฎหมาย
คำถามที่พบบ่อย
โครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์คืออะไร?
นี่คือชุดระบบที่ทำให้เอเจนต์ AI ท่องเว็บและดำเนินการบนเว็บได้ในระดับขนาดใหญ่ ประกอบด้วยการประสานงาน ระบบอัตโนมัติของเบราว์เซอร์ ชั้นการเข้าถึง (proxy) และการจัดการเซสชัน/ตัวตน ระบบนี้อยู่ใต้ตรรกะการตัดสินใจของเอเจนต์และอยู่เหนือเว็บดิบ เปลี่ยนจาก “เอเจนต์อาจเปิดหน้าเว็บได้” เป็น “กลุ่มเอเจนต์ทำได้อย่างน่าเชื่อถือในหลายตลาด”
แตกต่างจาก เบราว์เซอร์ AI เพียงตัวเดียวอย่างไร?
เบราว์เซอร์ AI เพียงตัวเดียวคือผลิตภัณฑ์ที่คนหนึ่งคนใช้ ส่วนโครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์รันเอเจนต์จำนวนมากแบบขนาน สิ่งนี้นำมาซึ่งปัญหาเฉพาะของกลุ่มเอเจนต์ เช่น แรงกดดันจากการตรวจจับ ตัวตนแยกตามเอเจนต์ และภูมิศาสตร์ ซึ่งเบราว์เซอร์เพียงตัวเดียวไม่ต้องเผชิญ ส่วนที่ยากคือการทำให้กลุ่มเอเจนต์เข้าถึงได้และมีตัวตนแยกกัน ไม่ใช่การควบคุมเบราว์เซอร์ตัวเดียว
เหตุใดกลุ่มเอเจนต์จึงถูกบล็อก?
เพราะเซสชันอัตโนมัติจำนวนมากจากช่วง IP เดียวดูเหมือนบอตตัวเดียว เว็บไซต์ยอมรับผู้ใช้มนุษย์ แต่จะป้องกันทราฟฟิกอัตโนมัติที่หลั่งไหลจากแหล่งเดียวกันอย่างจริงจังด้วยการจำกัดอัตรา CAPTCHAs และการแบน หากไม่มีตัวตนแยกตามเอเจนต์และการเข้าถึงจากภูมิศาสตร์ที่ถูกต้อง กลุ่มเอเจนต์จะกระตุ้นการป้องกันเหล่านั้นอย่างรวดเร็ว
proxy มีบทบาทใดในการท่องเว็บแบบเอเจนต์?
proxy คือชั้นการเข้าถึงและตัวตน Residential proxy ส่งเอเจนต์แต่ละตัวผ่าน IP ของผู้บริโภคจริง และตัวตนแยกตามเซสชันทำให้เอเจนต์แต่ละตัวใช้ IP ขาออก ของตัวเอง จึงดูเป็นผู้ใช้ที่แยกกัน กลุ่มที่หมุนเวียน IP พร้อม การทำงานพร้อมกันสูง ช่วยให้เอเจนต์จำนวนมากทำงานแบบขนานจากตลาดที่ถูกต้อง โดยขจัดคอขวดระดับ IP ที่ทำให้กลุ่มเอเจนต์หยุดทำงานก่อน
การรันเอเจนต์เบราว์เซอร์ในระดับขนาดใหญ่ถูกกฎหมายหรือไม่?
การดำเนินการนี้อยู่ภายใต้กฎเดียวกับการเข้าถึงเว็บแบบอัตโนมัติทุกประเภท ควรเคารพข้อกำหนดของเว็บไซต์และ robots.txt อย่าข้ามการเข้าสู่ระบบหรือการควบคุมการเข้าถึง ส่งคำขออย่างพอเหมาะ และใช้เฉพาะข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคล โดยทั่วไปการใช้ proxy สำหรับระบบอัตโนมัติที่ได้รับอนุญาตนั้นชอบด้วยกฎหมาย การใช้เพื่อหลบเลี่ยงการแบนหรือการควบคุมการเข้าถึงก่อให้เกิดความเสี่ยงทางกฎหมายและต่อบัญชี ไม่ใช่คำแนะนำทางกฎหมาย
บทสรุป
โครงสร้างพื้นฐานสำหรับการท่องเว็บแบบเอเจนต์คือสิ่งที่เปลี่ยน “เอเจนต์ที่ใช้เบราว์เซอร์ได้” ให้เป็นกลุ่มเอเจนต์ที่ทำงานได้จริง และข้อจำกัดที่กำหนดขีดความสามารถคือการเข้าถึง ไม่ใช่ความฉลาด เอเจนต์จำนวนมากที่ทำงานแบบขนานจะถูกบล็อก เว้นแต่แต่ละตัวจะดูเหมือนผู้ใช้ที่แยกจากกันและมาจากตลาดที่ถูกต้อง ซึ่งเป็นหน้าที่ของชั้น proxy และตัวตน สร้างระบบประสานงานและตรรกะเอเจนต์ของคุณ แล้วเช่าชั้นการเข้าถึง residential proxy ที่มีตัวตนแยกตามเซสชันและ การทำงานพร้อมกันสูง ดูองค์ประกอบเพิ่มเติมได้ที่ การรันเอเจนต์เบราว์เซอร์ AI, proxy สำหรับ OpenAI Operator และ โครงสร้างพื้นฐานข้อมูลเว็บสำหรับ AI.
อัปเดตล่าสุด: 28 มิถุนายน 2026.