
In this Article
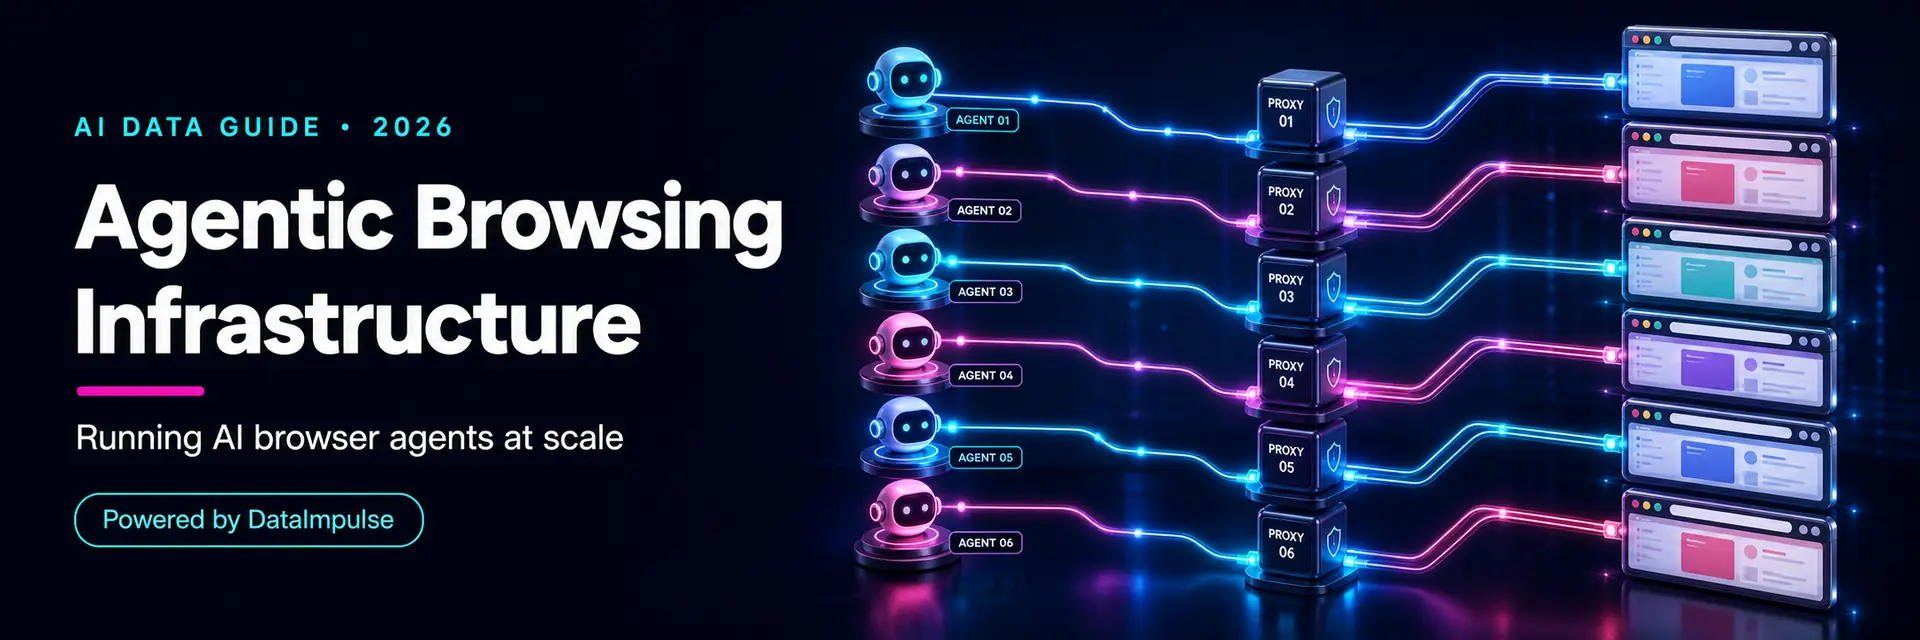
Infrastruktura agentowego przeglądania to stos technologiczny, który pozwala agentom AI przeglądać internet i wykonywać w nim działania niezawodnie oraz na dużą skalę – nie jednemu asystentowi otwierającemu stronę, lecz flotom agentów, które na bieżąco poruszają się po internecie, czytają i realizują zadania. Wraz z przejściem AI od udzielania odpowiedzi do działania, “agent, który potrafi używać przeglądarki” staje się “systemem, który uruchamia wielu agentów przeglądarkowych bez blokad”. Ten przewodnik definiuje infrastrukturę agentowego przeglądania, omawia jej warstwy i wyjaśnia, dlaczego warstwa dostępu – proxy z tożsamością przypisaną do każdego agenta – ma podstawowe znaczenie.
Jestem Andrii Byzov, częściowym dyrektorem marketingu wyspecjalizowanym w AI, który tworzy systemy agentowe i systemy danych internetowych. Poniżej znajdziesz: prostą definicję, różnice względem zwykłego przeglądania, komponenty, problem blokowania na skalę floty oraz miejsce proxy w tym rozwiązaniu. To część infrastruktury danych internetowych dla AI.
Najważniejsze fakty
- Infrastruktura agentowego przeglądania = stos technologiczny do uruchamiania agentów przeglądarkowych AI na dużą skalę – orkiestracja, automatyzacja przeglądarki, dostęp i zarządzanie sesjami.
- To problem floty, a nie pojedynczej przeglądarki. Wielu agentów, wiele zadań, wiele rynków, jednocześnie.
- Blokowanie jest głównym ograniczeniem. Agenci, którzy wielokrotnie pobierają dane i wykonują działania z jednego IP, szybko otrzymują ograniczenia liczby żądań i są oznaczani.
- Tożsamość każdego agenta ma znaczenie. Każdy agent powinien wyglądać jak odrębny prawdziwy użytkownik, a nie jak jedno IP wysyłające tysiące żądań.
- Residential proxy z tożsamością dla każdej sesji stanowią warstwę dostępu – utrzymują flotę dostępną i odrębną.
Czym jest infrastruktura agentowego przeglądania?
To wszystko, czego potrzeba do niezawodnego uruchamiania na dużą skalę agentów AI, którzy przeglądają internet i wykonują w nim działania. Pojedyncza przeglądarka AI jest produktem; agentowa infrastruktura przeglądania pozwala zespołowi uruchamiać wielu agentów – do badań, monitorowania, zakupów, testowania i automatyzacji – bez tego, by każdy z nich natrafiał na blokady, bariery geograficzne lub wykrywanie. Znajduje się poniżej logiki agenta (modelu decydującego, co zrobić) i ponad surowym internetem, zmieniając “agent mógłby otworzyć tę stronę” w “flota agentów może robić to tysiące razy na różnych rynkach”.
Czym różni się od zwykłego przeglądania?
- Skala. Jedna osoba przegląda strony kolejno; flota agentów przegląda je stale i równolegle.
- Presja wykrywania. Witryny tolerują człowieka, ale aktywnie chronią się przed wieloma zautomatyzowanymi sesjami z tego samego źródła.
- Tożsamość. Każdy agent musi wyglądać jak osobny użytkownik – współdzielone IP sprawiają, że flota wygląda jak jeden bot.
- Geografia. Agenci często muszą działać z konkretnych rynków, więc lokalizacja jest częścią infrastruktury.
Komponenty
Orkiestracja. Planowanie i koordynowanie wielu agentów, ponowień oraz kolejek zadań.
Automatyzacja przeglądarki. Przeglądarki bez interfejsu graficznego lub narzędzia automatyzacji, którymi agenci sterują, aby poruszać się po stronach i wykonywać działania (zobacz uruchamianie agentów przeglądarkowych AI).
Warstwa dostępu. Docieranie do stron z właściwego miejsca bez blokad – proxy. W dużej skali zwykle jest to wiążące ograniczenie.
Sesja i tożsamość. Utrzymywanie każdego agenta jako odrębnego, spójnego użytkownika – jego własnej sesji IP, aby zachowanie pozostawało spójne i możliwe do rozdzielenia.
Problem blokowania na skalę floty
To, co psuje naiwne floty agentów, nie jest modelem – to blokowanie. Uruchom dziesięciu lub tysiąc agentów z jednego zakresu IP, a docelowe witryny zobaczą zalew zautomatyzowanego ruchu z jednego źródła: szybko pojawią się limity liczby żądań, CAPTCHA, zapory botów i bany. Wynikają z tego dwie potrzeby: odrębna tożsamość (każdy agent wygląda jak własny użytkownik) oraz dostęp poprawny geograficznie (agenci działają z rynków, których potrzebują). Zadbaj o to, a wąskie gardło na poziomie IP zmniejszy się – choć fingerprinting, CAPTCHA, uwierzytelnianie i limity liczby żądań nadal mogą zatrzymać pojedyncze zadania; zignoruj je, a flota najpierw załamie się przez blokady.
# Give each agent in the fleet its own proxy session so it looks like a
# distinct real user (the ;sid keeps an agent on the same exit IP for the
# session; the exit can change if that residential peer drops).
def proxy_for_agent(agent_id, country="us"):
return (f"http://LOGIN__cr.{country};sid.agent{agent_id}:"
f"[email protected]:823")
# e.g. launch each browser-automation worker with its own session
for agent_id in range(10):
proxy = proxy_for_agent(agent_id)
# browser.launch(proxy=proxy) -> each agent = a separate apparent user
Gdzie pasują proxy?
Warstwy dostępu i tożsamości to miejsce dla proxy, a w skali floty mają one podstawowe znaczenie. Residential proxy kierują każdego agenta przez rzeczywiste IP użytkownika, a tożsamość przypisana do sesji (sid) utrzymuje każdego agenta na jego własnym wyjściowym IP podczas sesji – dzięki czemu jest odczytywany jako odrębny, spójny użytkownik, a nie część roju (wyjście może się zmienić, jeśli dany użytkownik residential proxy przestanie być dostępny). Rotujące pule residential proxy z wysoką współbieżnością pozwalają wielu agentom działać równolegle na właściwych rynkach – residential proxy DataImpulse od $1/GB (mobile od $2/GB) w ponad 195 lokalizacjach, z wysoką współbieżnością dla flot. Proxy obsługują dostęp i tożsamość; Twoja orkiestracja obsługuje agentów. Nie pokonują każdej ochrony – witryny nadal stosują CAPTCHA i wykrywanie behawioralne – ale usuwają wąskie gardło na poziomie IP, które najpierw zatrzymuje floty.
Czy uruchamianie agentowego przeglądania na dużą skalę jest legalne?
Uruchamianie agentów przeglądarkowych podlega tym samym zasadom co każdy zautomatyzowany dostęp do internetu – a skala może zwiększać stawkę prawną, związaną z prywatnością, umowami i obchodzeniem zabezpieczeń, nawet gdy wzorzec dostępu wygląda podobnie. Dbaj o to, aby działanie było uzasadnione: respektuj warunki każdej witryny i traktuj robots.txt jako sygnał dotyczący zasad, nie omijaj logowania, płatnych ścian dostępu ani kontroli dostępu, dostosowuj tempo żądań zamiast je zasypywać oraz ograniczaj się do publicznych, nieosobowych danych. Używanie proxy do dozwolonej automatyzacji jest zasadniczo zgodne z prawem, ale używanie ich do omijania banów, kontroli dostępu lub ograniczeń umownych wiąże się z ryzykiem prawnym i ryzykiem dla konta. Zgodna z prawem ścieżka to rzeczywista automatyzacja publicznych zadań, a nie obchodzenie zabezpieczeń. Zobacz czy web scraping jest legalny. To informacje ogólne, a nie porada prawna.
Najczęściej zadawane pytania
Czym jest infrastruktura agentowego przeglądania?
To stos technologiczny, który pozwala agentom AI przeglądać internet i wykonywać w nim działania na dużą skalę – orkiestracja, automatyzacja przeglądarki, warstwa dostępu (proxy) oraz zarządzanie sesjami i tożsamością. Znajduje się poniżej logiki decyzyjnej agenta i ponad surowym internetem, zmieniając “agent mógłby otworzyć stronę” w “flota agentów może robić to niezawodnie na różnych rynkach”.
Czym różni się od pojedynczej przeglądarki AI?
Pojedyncza przeglądarka AI to produkt używany przez jedną osobę; infrastruktura agentowego przeglądania uruchamia wielu agentów równolegle. Wiąże się to z problemami specyficznymi dla floty – presją wykrywania, tożsamością każdego agenta i geografią – których pojedyncza przeglądarka nigdy nie napotyka. Trudność polega na utrzymaniu dostępności i odrębności floty, a nie na sterowaniu jedną przeglądarką.
Dlaczego floty agentów są blokowane?
Ponieważ wiele zautomatyzowanych sesji z jednego zakresu IP wygląda jak jeden bot. Witryny tolerują człowieka, lecz aktywnie bronią się przed zalewem zautomatyzowanego ruchu z tego samego źródła za pomocą limitów liczby żądań, CAPTCHA i banów. Bez odrębnej tożsamości każdego agenta i dostępu poprawnego geograficznie flota szybko uruchamia te zabezpieczenia.
Gdzie proxy pasują do agentowego przeglądania?
Stanowią warstwę dostępu i tożsamości. Residential proxy kierują każdego agenta przez rzeczywiste IP użytkownika, a tożsamość przypisana do sesji utrzymuje każdego agenta na jego własnym wyjściowym IP, dzięki czemu jest odczytywany jako odrębny użytkownik. Rotujące pule o wysokiej współbieżności pozwalają wielu agentom działać równolegle na właściwych rynkach – usuwając wąskie gardło na poziomie IP, które najpierw zatrzymuje floty.
Czy uruchamianie agentów przeglądarkowych na dużą skalę jest legalne?
Podlega tym samym zasadom co każdy zautomatyzowany dostęp do internetu. Respektuj warunki witryny i robots.txt, nie omijaj logowania ani kontroli dostępu, dostosowuj tempo żądań i ograniczaj się do publicznych, nieosobowych danych. Używanie proxy do dozwolonej automatyzacji jest zasadniczo zgodne z prawem; używanie ich do omijania banów lub kontroli dostępu wiąże się z ryzykiem prawnym i ryzykiem dla konta. To nie jest porada prawna.
Podsumowanie
Infrastruktura agentowego przeglądania zmienia “agenta, który potrafi używać przeglądarki” we flotę, która rzeczywiście działa – a jej wiążącym ograniczeniem jest dostęp, nie inteligencja. Wielu agentów działających równolegle jest blokowanych, o ile każdy nie wygląda jak odrębny użytkownik z właściwego rynku, co zapewnia warstwa proxy i tożsamości. Zbuduj orkiestrację i logikę agentów; wynajmij warstwę dostępu residential proxy z tożsamością przypisaną do sesji oraz wysoką współbieżnością. Poznaj elementy rozwiązania: uruchamianie agentów przeglądarkowych AI, proxy dla OpenAI Operator oraz infrastruktura danych internetowych dla AI.
Ostatnia aktualizacja: 28 czerwca 2026 r.