
本文内容
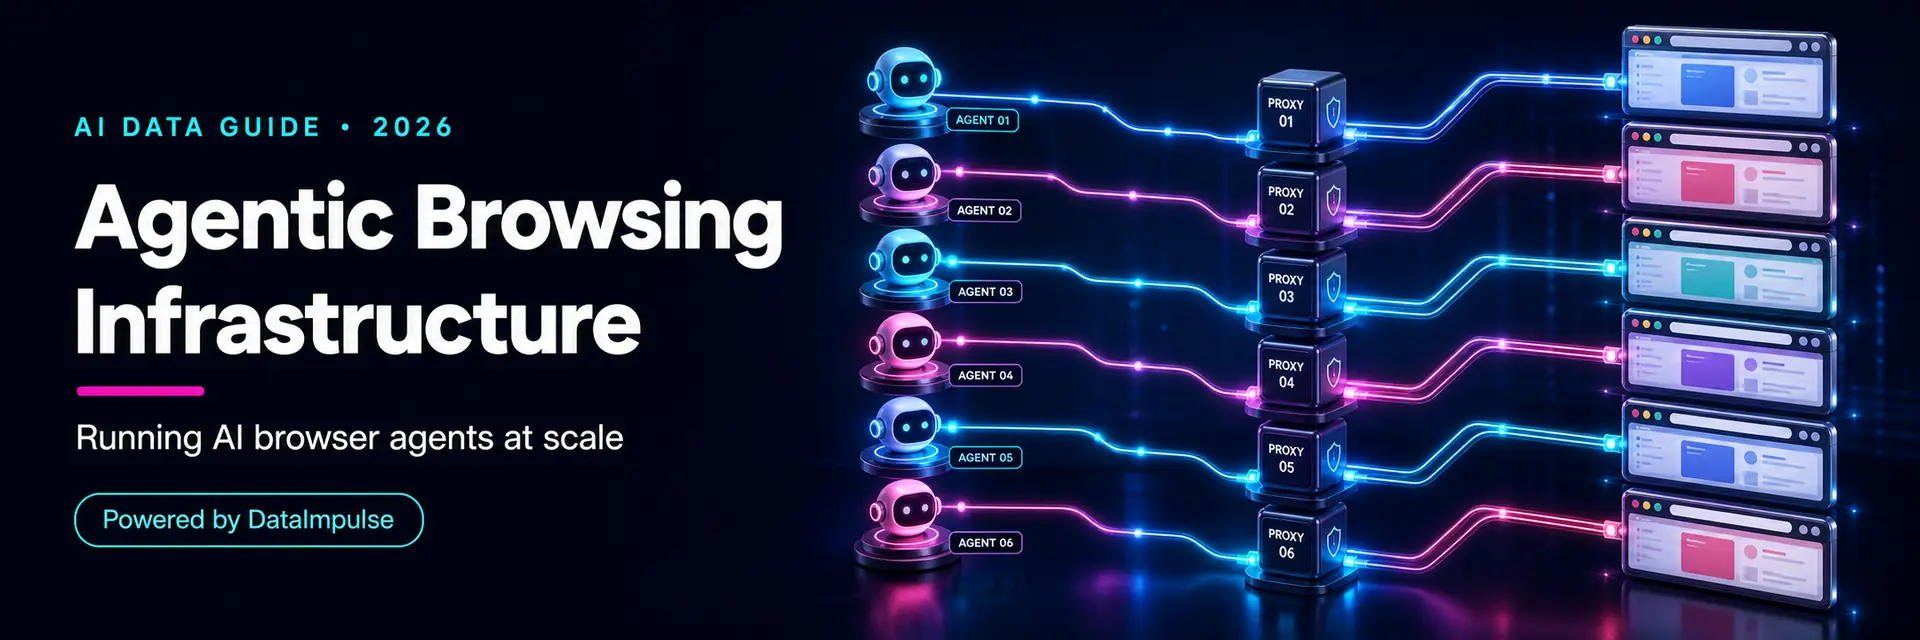
智能体浏览基础设施是一套技术栈,让 AI 智能体能够大规模浏览网页并在网上执行操作。它不只是让一个助手打开一个页面,而是让成批的智能体在实时 Web 上可靠地导航、阅读和完成任务。随着 AI 从“回答”转向“执行”,需求也从“一个会用浏览器的智能体”变成“一个能运行多个浏览器智能体且不被封禁的系统”。本指南将介绍智能体浏览基础设施的定义、各个层级,以及为什么为每个智能体提供独立身份的代理访问层是其中的基础。
我是 Andrii Byzov,一名专注于 AI 原生业务的兼职 CMO,致力于构建智能体和 Web 数据系统。本文将用通俗的方式说明它的定义、与普通浏览的区别、组成部分、集群规模下的封禁问题,以及代理在其中的作用。本文也是 web data infrastructure for AI 的一部分。
关键事实
- Agentic browsing infrastructure = 用于大规模运行 AI 浏览器智能体的技术栈,包括编排、浏览器自动化、访问和会话管理。
- 这是集群问题,而非单一浏览器问题。 它同时涉及大量智能体、任务和市场。
- 封禁是核心限制。 从同一个 IP 反复抓取数据和执行操作的智能体,很快就会被限速和标记。
- 每个智能体的身份都很重要。 每个智能体都应呈现为不同的真实用户,而不是由一个 IP 发出数千个请求。
- 带有会话级身份的住宅代理构成访问层,让整个集群保持可访问性且彼此可区分。
什么是智能体浏览基础设施?
它涵盖了可靠且大规模运行能够浏览网页并执行操作的 AI 智能体所需的一切。单个 AI 浏览器 是一种产品;而智能体浏览基础设施让团队能够运行大量智能体,用于研究、监控、购物、测试和自动化,同时避免每个智能体都受制于封禁、地理限制或检测。它位于智能体逻辑之下,模型在这里决定要做什么;又位于底层网络之上,把“一个智能体可以打开这个页面”转化为“一组智能体可以在不同市场中成千上万次完成这件事”。
它与普通浏览有何不同
- 规模。 一个人按顺序浏览;一组智能体则持续并行浏览。
- 检测压力。 网站会容忍人类用户;但会主动防御来自同一来源的大量自动化会话。
- 身份。 每个智能体都需要呈现为独立用户,共享 IP 会让一组智能体看起来像同一个机器人。
- 地理位置。 智能体通常需要从特定市场执行操作,因此地理位置也是基础设施的一部分。
组成部分
编排。 调度和协调大量智能体、重试机制及任务队列。
浏览器自动化。 供智能体导航和执行操作的无头浏览器或自动化框架(参见 运行 AI 浏览器代理)。
访问层。 从正确的地理位置访问页面并避免被封禁的能力,即代理。这通常是规模化时的主要瓶颈。
会话与身份。 让每个智能体保持独立且一致的用户身份,拥有各自的 IP 会话,使其行为连贯且可区分。
集群规模下的封禁问题
让缺乏准备的智能体集群无法运行的往往不是模型,而是封禁。若从一个 IP 段运行十个乃至一千个智能体,目标网站会看到来自单一来源的大量自动化流量,随后很快触发速率限制、CAPTCHA、反机器人机制和封禁。因此,系统需要具备独立身份,让每个智能体看起来都像独立用户;还需要符合地理位置要求的访问能力,让智能体从所需市场发起操作。解决这些问题能缓解 IP 层面的瓶颈,但指纹识别、CAPTCHA、身份验证和速率限制仍可能阻碍单个任务。若忽视这些因素,集群很快就会因封禁而停摆。
# Give each agent in the fleet its own proxy session so it looks like a
# distinct real user (the ;sid keeps an agent on the same exit IP for the
# session; the exit can change if that residential peer drops).
def proxy_for_agent(agent_id, country="us"):
return (f"http://LOGIN__cr.{country};sid.agent{agent_id}:"
f"[email protected]:823")
# e.g. launch each browser-automation worker with its own session
for agent_id in range(10):
proxy = proxy_for_agent(agent_id)
# browser.launch(proxy=proxy) -> each agent = a separate apparent user
代理的作用位置
访问层和身份层正是代理发挥作用的地方;在大规模集群场景下,它们本身就是基础设施。住宅代理会让每个智能体通过真实的消费者 IP 访问网络,而会话级身份(一个 sid)可使每个智能体在整个会话期间保持使用自己的出口 IP,从而呈现为独立且一致的用户,而非集群中的一员(若住宅节点掉线,出口 IP 可能会变化)。具备高并发能力的轮换住宅代理池可让大量智能体从合适的市场并行运行。DataImpulse 住宅代理覆盖 195+ 个地区,价格从 $1/GB 起(移动代理从 $2/GB 起),并为集群提供高并发能力。代理负责访问和身份;编排系统负责智能体本身。代理无法绕过所有防护,网站仍会使用 CAPTCHA 和行为检测,但能消除最先阻碍集群运行的 IP 级瓶颈。
大规模运行代理式浏览合法吗?
运行浏览器智能体遵循与其他自动化 Web 访问相同的规则。即使访问模式看似相同,规模化也可能增加法律、隐私、合同和反规避方面的风险。要保持合规:尊重各网站的条款,并将 robots.txt 视为政策信号;不要绕过登录、付费墙或访问控制;控制请求频率,避免集中轰炸;并仅使用公开的非个人数据。将智能体用于获准的自动化通常是合法的,但用它们规避封禁、访问控制或合同限制会带来法律和账号风险。合规的做法是对公开任务进行真正的自动化,而不是规避限制。请参阅网络抓取是否合法。这是一般信息,不构成法律建议。
常见问题
什么是智能体浏览基础设施?
它是让 AI 智能体能够大规模浏览网页并执行操作的技术栈,包括编排、浏览器自动化、访问层(代理)以及会话和身份管理。它位于智能体的决策逻辑之下、底层网络之上,把“一个智能体可以打开页面”变成“一组智能体可以在多个市场可靠地完成这件事”。
它与单个 AI 浏览器有什么不同?
单个 AI 浏览器是供个人使用的产品;智能体浏览基础设施则并行运行大量智能体。这会带来单个浏览器不会遇到的集群级问题,包括检测压力、每个智能体的身份和地理位置。难点在于让整个集群保持可访问性并彼此可区分,而非仅仅驱动一个浏览器。
为什么代理集群会被封锁?
因为来自同一 IP 段的大量自动化会话看起来像同一个机器人。网站可以容忍人类用户,却会通过速率限制、CAPTCHA 和封禁主动防御来自同一来源的大量自动化流量。若没有每个智能体独立的身份,以及符合地理位置要求的访问能力,集群很快就会触发这些防御机制。
代理在代理式浏览中起什么作用?
它们构成访问和身份层。住宅代理让每个智能体通过真实的消费者 IP 访问网络,而会话级身份让每个智能体保持使用自己的出口 IP,从而呈现为独立用户。支持高并发的轮换池让大量智能体能够从合适的市场并行运行,消除最先阻碍集群运行的 IP 级瓶颈。
大规模运行浏览器代理合法吗?
它遵循与其他自动化网页访问相同的规则。应尊重网站条款和 robots.txt,不要绕过登录或访问控制,控制请求频率,并且只访问公开的非个人数据。将智能体用于获准的自动化通常是合法的;用它们规避封禁或访问控制会带来法律和账号风险。这并非法律建议。
结论
智能体浏览基础设施能将“会使用浏览器的智能体”转变为真正可运行的智能体集群。它的主要瓶颈在于访问能力,而非智能本身。许多并行运行的智能体会遭到拦截,除非每个智能体都呈现为来自相应市场的不同用户,这正是代理和身份层的作用。构建自己的编排和智能体逻辑;租用具备会话级身份和高并发能力的住宅代理访问层。探索相关内容:运行 AI 浏览器代理、OpenAI Operator 代理和面向 AI 的网络数据基础设施。
最后更新:2026 年 6 月 28 日。