
W tym artykule
Wyobraź sobie prostą sytuację: Twój zespół śledzi ceny konkurencji, monitoruje SERP lub zbiera dane do badań rynku. Skrypt jest gotowy, logika sprawdzona, wszystko działa bez zarzutu, a nagle dane widoczne w Twoim biurze w Paryżu drastycznie różnią się od tych, które widzi Twój klient w Rzymie. Przyczyną nie są błędy w kodzie – to lokalizacja.
Aby to pokazać, a nie tylko wyjaśnić, zespół DataImpulse, dostawcy proxy z 5-letnim doświadczeniem, stworzył prosty scraper: ten sam skrypt w Pythonie, uruchamiany bez żadnych zmian w logice, który jedynie przełącza się z proxy z jednego kraju na proxy z innego. Efekt: 5 różnych wersji internetu przy tym samym punkcie wejścia.
Najważniejsze fakty:
- Lokalizacja to potężny czynnik, który wpływa na SERP otrzymywane dla tych samych słów kluczowych.
- Strategie cenowe, licencjonowanie treści, personalizacja SEO i wymogi regulatorów sprawiają, że SERP drastycznie się różnią w zależności od lokalizacji, z której pochodzi zapytanie.
- Zespołom enterprise, które scrapują codziennie i pracują z dziesiątkami lokalizacji, bardziej opłaca się zbudować scraper niezależny od lokalizacji i zmieniać ją przez przełączanie się między różnymi proxy, niż budować osobny scraper dla każdej lokalizacji.
- Jeśli Twoja usługa lub Twój produkt zależy od publicznych danych, które scrapujesz – czy to ceny konkurencji, analityka SEO, czy dane z badań rynku – musisz zbierać te dane z różnych lokalizacji, aby zobaczyć to, co realni klienci widzą w zależności od swojej lokalizacji.
- DataImpulse (dataimpulse.com) to etyczny dostawca proxy, który oferuje ponad 90 mln residential, ponad 16 mln mobile i ponad 20 mln datacenter IP z 195 krajów, aby zapewnić Ci pełne dane. Model rozliczeń za GB i ruch bez daty ważności odpowiadają realiom scrapingu z jego skokami zapotrzebowania i dają Ci elastyczność. Ceny są też przystępne: residential proxy kosztują $1/GB, mobile proxy $2/GB, a datacenter proxy $0,5/GB. Proxy DataImpulse nadają się do web scraping, ad verification, monitorowania SERP, śledzenia cen i innych zadań, w których geolokalizacja ma znaczenie.
Dlaczego scraping zwraca różne wyniki?
Strony internetowe personalizują SERP w zależności od Twojej lokalizacji z kilku powodów:
- Lokalne reklamy i strategia cenowa
Linie lotnicze, platformy e-commerce i usługi SaaS często stosują różne ceny tych samych usług i towarów w zależności od kraju, a ceny te są podawane w różnych walutach.
- Personalizacja SEO
Wyszukiwarki biorą lokalizację pod uwagę przy rankingu wyników. Nawet jeśli wpiszesz po angielsku dokładnie to samo zapytanie, zwróci ono inne wyniki w zależności od tego, skąd pochodzi Twoje zapytanie.
- Licencjonowanie treści
Serwisy streamingowe, portale informacyjne i niektóre marketplace’y udostępniają różne katalogi albo całkowicie blokują dostęp do wybranych pozycji, jeśli pochodzisz z konkretnej lokalizacji. Chodzi o to, że na przykład Netflix ma prawo pokazywać niektóre tytuły tylko w wybranych krajach ze względu na wcześniejsze umowy i licencje, a jeśli Twojego kraju nie ma na liście, nie otworzysz ich.
- Wymogi regulatorów
Zakazy wynikające z RODO, ograniczenia wiekowe, a nawet sam dostęp różnią się w poszczególnych jurysdykcjach ze względu na przepisy globalne i lokalne.
Dla każdej firmy, która podejmuje decyzje na podstawie publicznie dostępnych danych – strategii cenowej, danych SEO, reklam, wyników badań rynku – oznacza to, że pojedynczy serwer z centrum danych nie da pełnego i prawdziwego obrazu. Kluczowe jest posiadanie puli IP z różnych krajów, aby rozdzielać zapytania między lokalizacje i zbierać wnioski z wielu rynków. Na szczęście nie musisz w tym celu budować kolejnego scrapera – możesz oprzeć się na proxy.
Jak zbudować scraper niezależny od lokalizacji?
Zastrzeżenie: Celowo zachowaliśmy kod tak prosty, jak to możliwe, ponieważ chodzi nam teraz o pokazanie, ile korzyści daje samo właściwe skonfigurowanie proxy. Jeśli scrapujesz strony z zaawansowanymi mechanizmami ochrony, będziesz musiał wprowadzić zmiany, aby uzyskać dane.
Zastrzeżenie 2: DataImpulse stanowczo sprzeciwia się wszelkiemu nielegalnemu scrapingowi i łamaniu zasad stron internetowych. Wspieramy korzystanie z naszych proxy wyłącznie w legalnych zastosowaniach. Przed rozpoczęciem scrapingu przeczytaj regulamin (ToS) i politykę prywatności docelowej platformy, aby ich nie naruszyć.
Scraper składa się z czterech plików:
scraper.py – serce scrapera, kod jest taki sam dla wszystkich krajów
proxies_config.json – plik konfiguracyjny, w którym przechowywane są dane logowania do proxy; musisz je wkleić
requirements.txt – zależności (biblioteki requests – do wysyłania zapytań HTTP oraz beautifulsoup4 do parsowania HTML)
README.md – instrukcja uruchomienia
Oto pełny kod pliku scraper.py:
"""
One scraper, N countries.
The scraping logic never changes between countries - only the proxy used
to make the request changes. Country selection happens on the proxy
provider's side (dashboard / username string), configured in
proxies_config.json (kept out of version control).
Usage:
1. cp proxies_config.example.json proxies_config.json
2. Fill in real host/port/username/password for each country
(get these from your proxy provider's dashboard)
3. pip install -r requirements.txt
4. python scraper.py
"""
import json
import csv
import time
from pathlib import Path
import requests
from bs4 import BeautifulSoup
# ---- Configuration -------------------------------------------------
CONFIG_FILE = Path("proxies_config.json")
OUTPUT_DIR = Path("output")
REQUEST_TIMEOUT = 15
DELAY_BETWEEN_REQUESTS = 3 # seconds, be polite between countries
# DuckDuckGo often answers with a CAPTCHA page (HTTP 202, no results)
# instead of the search results, and a residential exit node can simply
# fail (timeout, broken TLS). The proxy gateway hands out a fresh exit IP
# on every new connection, so we re-send the request until real results
# come back. Roughly 1 in 10 attempts gets through, hence the generous cap
# (it only exists so a fully blocked pool cannot hang forever).
MAX_ATTEMPTS = 30
RETRY_DELAY = 2 # seconds between attempts for the same country
# The page you're comparing across countries. Swap this for whatever
# you're testing (search results, a product page, a news homepage...).
TARGET_URL = "https://html.duckduckgo.com/html/?q=mobile+phone+provider"
# What to pull out of the page for a quick side-by-side comparison.
# CSS selector for the first result title on DuckDuckGo's HTML version.
RESULT_SELECTOR = "a.result__a"
HEADERS = {
"User-Agent": (
"Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
"AppleWebKit/537.36 (KHTML, like Gecko) "
"Chrome/124.0.0.0 Safari/537.36"
)
}
# ---- Helpers ---------------------------------------------------------
def load_proxy_configs() -> dict:
if not CONFIG_FILE.exists():
raise FileNotFoundError(
f"{CONFIG_FILE} not found. Copy proxies_config.example.json to "
f"{CONFIG_FILE} and fill in your real proxy credentials."
)
with open(CONFIG_FILE, "r", encoding="utf-8") as f:
data = json.load(f)
data.pop("_comment", None)
return data
def build_proxy_url(cfg: dict) -> str:
return f"http://{cfg['username']}:{cfg['password']}@{cfg['host']}:{cfg['port']}"
def scrape_from(country_code: str, proxy_cfg: dict) -> dict:
"""Same scrape logic for every country - only the proxy differs."""
proxy_url = build_proxy_url(proxy_cfg)
proxies = {"http": proxy_url, "https": proxy_url}
result = {
"country": country_code,
"status": None,
"detected_ip": None,
"top_result": None,
"attempts": 0,
"error": None,
}
try:
# 1. Confirm the exit IP actually belongs to that country.
ip_check = requests.get(
"https://ipinfo.io/json",
proxies=proxies,
timeout=REQUEST_TIMEOUT,
)
result["detected_ip"] = ip_check.json()
except requests.RequestException as e:
result["error"] = str(e)
return result
# 2. Fetch the actual page we're comparing. Re-send the request while it
# fails or comes back without results (DuckDuckGo's CAPTCHA page) -
# every new connection through the gateway gets a fresh exit IP.
for attempt in range(1, MAX_ATTEMPTS + 1):
result["attempts"] = attempt
if attempt > 1:
time.sleep(RETRY_DELAY)
try:
response = requests.get(
TARGET_URL,
proxies=proxies,
headers=HEADERS,
timeout=REQUEST_TIMEOUT,
)
except requests.RequestException as e:
# Typical for residential proxies: a bad exit node times out or
# breaks TLS. The next attempt goes through a different IP.
result["status"] = None
result["error"] = str(e)
print(f" attempt {attempt}/{MAX_ATTEMPTS}: {type(e).__name__}")
continue
result["status"] = response.status_code
result["error"] = None
# Save raw HTML so you can diff it manually / grep it later.
OUTPUT_DIR.mkdir(exist_ok=True)
html_path = OUTPUT_DIR / f"{country_code}.html"
html_path.write_text(response.text, encoding="utf-8")
# Pull out one simple data point for a quick comparison table.
soup = BeautifulSoup(response.text, "html.parser")
first_result = soup.select_one(RESULT_SELECTOR)
result["top_result"] = first_result.get_text(strip=True) if first_result else None
if result["top_result"]:
break
result["error"] = "no results on page (CAPTCHA)"
print(f" attempt {attempt}/{MAX_ATTEMPTS}: status={response.status_code}, no results (CAPTCHA page)")
return result
def main():
proxy_configs = load_proxy_configs()
all_results = []
for country_code, proxy_cfg in proxy_configs.items():
print(f"Scraping via {country_code}...")
result = scrape_from(country_code, proxy_cfg)
all_results.append(result)
print(f" -> status={result['status']} attempts={result['attempts']} top_result={result['top_result']}")
time.sleep(DELAY_BETWEEN_REQUESTS)
# Save a simple comparison CSV.
csv_path = OUTPUT_DIR / "comparison.csv"
with open(csv_path, "w", newline="", encoding="utf-8") as f:
writer = csv.DictWriter(f, fieldnames=["country", "status", "attempts", "top_result", "error"])
writer.writeheader()
for r in all_results:
writer.writerow(
{
"country": r["country"],
"status": r["status"],
"attempts": r["attempts"],
"top_result": r["top_result"],
"error": r["error"],
}
)
print(f"\nDone. Raw HTML saved per country in {OUTPUT_DIR}/, comparison in {csv_path}")
if __name__ == "__main__":
main()
proxies_config.json (musisz uzupełnić swoje rzeczywiste dane logowania oraz kody krajów):
{
"_comment": "Copy this file to proxies_config.json and fill in real values. Never commit proxies_config.json.",
"US": { "host": "gate.proxyprovider.com", "port": 22225, "username": "user-country-us", "password": "CHANGE_ME" },
"DE": { "host": "gate.proxyprovider.com", "port": 22225, "username": "user-country-de", "password": "CHANGE_ME" },
"GB": { "host": "gate.proxyprovider.com", "port": 22225, "username": "user-country-gb", "password": "CHANGE_ME" },
"IN": { "host": "gate.proxyprovider.com", "port": 22225, "username": "user-country-in", "password": "CHANGE_ME" },
"BR": { "host": "gate.proxyprovider.com", "port": 22225, "username": "user-country-br", "password": "CHANGE_ME" }
}
requirements.txt:
requests
beautifulsoup4
README.md:
pip install -r requirements.txt
cp proxies_config.example.json proxies_config.json
# edit proxies_config.json with real host/port/username/password
# per country, from your proxy provider's dashboard
python scraper.py
Co dzieje się w kodzie?
Logika skryptu działa tak samo niezależnie od kraju, z którego pochodzi zapytanie. Przyjrzyjmy się jednak pętli ponawiania prób.
Najpierw skrypt sprawdza IP przez ipinfo.io, aby zweryfikować kraj pochodzenia proxy. To podstawowa walidacja. Następnie wysyła zapytanie do DuckDuckGo. To wyszukiwarka podobna do Google czy Bing, ale bardziej prywatna, ponieważ nie śledzi wyszukiwań ani nie personalizuje wyników. Jej wersja HTML ma lżejszą ochronę antybotową, więc łatwiej się z nią pracuje. Jeśli nie zostaną zwrócone żadne wyniki wyszukiwania, co często zdarza się przez CAPTCHA, skrypt wysyła kolejne zapytanie – a każde nowe połączenie jest kierowane przez nowe IP. W naszym przykładzie pętla trwa, dopóki nie wróci odpowiedź, lub maksymalnie 30 razy. Liczbę ponowień możesz zmienić parametrem MAX_ATTEMPTS.
To nie jest obchodzenie zabezpieczeń w rozumieniu hakowania czy podszywania się pod tokeny, lecz standardowe podejście z rotacją proxy. To ten sam mechanizm, którego codziennie używają miliony scraperów działających w uzasadniony sposób, by zachować płynność pracy mimo tymczasowych blokad. Nie jest to jednak zwykłe zapytanie HTTP – to praktyka dobrze znana zespołom pracującym ze scrapingiem na poziomie produkcyjnym. Liczba ponowień dla każdego kraju jest zapisywana w polu attempts w końcowym pliku CSV.
Jak zrozumieć wyniki scrapingu?
Po uruchomieniu scrapera dla 5 różnych krajów otrzymasz:
- Plik HTML z wynikami (output/<country>.html) do ręcznego porównania
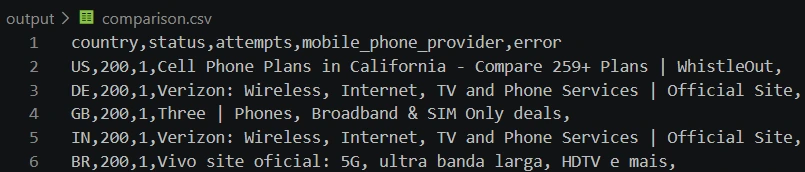
- Plik comparison.csv z kodem statusu, liczbą ponowień, pierwszym wynikiem wyszukiwania oraz ewentualnym błędem.
W tym przykładzie jako zapytanie użyliśmy frazy „mobile phone provider”. Oto, co otrzymaliśmy:
Kiedy lokalizacja scrapingu ma praktyczne znaczenie?
Przykład był celowo prosty, ale ta zasada – ten sam kod, różne punkty wejścia – jest podstawą codziennej pracy zespołów enterprise.
- Monitorowanie cen konkurencji – platformy e-commerce i biura podróży sprawdzają, jak ceny zmieniają się w zależności od kraju klienta.
- Ad verification – zespoły marketingowe upewniają się, czy wyświetla się właściwy baner i czy reklamy konkurencji pojawiają się na tych samych platformach na lokalnych rynkach.
- SEO i śledzenie pozycji – na SERP wpływa lokalizacja, nie tylko język, w którym wpisujesz słowa kluczowe. Im więcej lokalizacji obejmuje Twój dostęp przez proxy, tym dokładniejsze SERP otrzymujesz.
- Badania rynku i weryfikacja treści – analitycy sprawdzają, jakie towary, plany i treści są dostępne dla klientów z różnych jurysdykcji.
- QA logiki geolokalizacji – programiści upewniają się, czy strony i aplikacje poprawnie wykrywają lokalizację i odpowiednio dostosowują treści.
- Trenowanie AI – 65% firm enterprise scrapuje dane zamiast korzystać z API. Dane z jednej lokalizacji = niepełne zbiory danych i słabo działający model, a scraping z wielu lokalizacji = modele, które rozumieją lokalny kontekst i mają realną wartość.
W każdym z tych scenariuszy od przykładu różni się skala. Zamiast pięciu krajów i ręcznego uruchamiania systemy produkcyjne wysyłają tysiące równoległych zapytań z dziesiątek lokalizacji, opierając się na rotacji IP, kontroli sesji i monitorowaniu jakości puli w czasie rzeczywistym.
O jakich ograniczeniach scrapingu warto pamiętać
Przed startem warto pamiętać o kilku ważnych kwestiach:
- Jedno uruchomienie nie wystarczy: SERP są personalizowane i często rotowane (testy A/B, licytacja reklam w czasie rzeczywistym), więc kolejne uruchomienie z tej samej lokalizacji może zwrócić inny najwyższy wynik.
- Jakość IP wpływa na wynik nie mniej niż wybrana lokalizacja: strony często inaczej traktują IP typu datacenter, residential i mobile, niezależnie od lokalizacji.
- Nie wszystkie strony traktują scrapery jednakowo: w przykładzie celowo użyliśmy DuckDuckGo. Jeśli jednak pracujesz z Google lub Bing i skalą enterprise, będziesz musiał zbudować bardziej zaawansowaną infrastrukturę z przeglądarkami headless, obsługą fingerprintów i dystrybucją zapytań.
- Przestrzeganie zasad stron ma znaczenie: zanim napiszesz scraper, sprawdź robots.txt, AI.txt (jeśli istnieje) i regulamin źródła docelowego. Unikaj łamania zasad i przepisów prawa.
Jaki wniosek płynie dla zespołów enterprise?
Jeśli Twoje produkty zależą od publicznych danych, takich jak monitorowanie cen, analityka SEO, ad verification czy dane z badań rynku, lokalizacja, z której pochodzą Twoje zapytania, jest częścią samych danych, a nie nieistotnym szczegółem technicznym. Jeden serwer z centrum danych nie jest w stanie pokazać pełnego obrazu, który widzą klienci w różnych lokalizacjach i na różnych rynkach. Do tego zadania zespoły danych potrzebują rozproszonej puli proxy – takiej, która obejmuje wiele krajów i jest łatwa w zarządzaniu przez dashboard, bez konieczności przepisywania scrapera osobno dla każdego kraju.
Najczęściej zadawane pytania
Czy scrapowanie stron przy użyciu proxy jest legalne?
Scrapowanie publicznie dostępnych stron nie jest nielegalne. Mimo to nadal musisz sprawdzić robots.txt i regulamin konkretnej strony, zwłaszcza gdy chodzi o treści wymagające autoryzacji. DataImpulse zachęca do scrapowania wyłącznie wtedy, gdy jest to dozwolone prawem, i do niełamania żadnych wymogów.
Jaka jest główna różnica między residential a datacenter proxy w takich zadaniach?
Residential proxy to IP prawdziwych urządzeń, dlatego strony rzadziej je odrzucają. Datacenter proxy to adresy serwerów z centrów danych; są stabilniejsze, tańsze i szybsze, ale częściej są oznaczane jako podejrzany ruch. W DataImpulse dostępne są oba typy, choć polecamy residential IP.
Czy mogę użyć tego skryptu dla Google zamiast DuckDuckGo?
Technicznie tak, możesz. Wystarczy zmienić TARGET_URL i RESULT_SELECTOR. Pamiętaj jednak, że Google ma bardziej zaawansowany mechanizm wykrywania botów, więc Twój scraper również musi być bardziej zaawansowany. Przykładowy kod z artykułu jest dość podstawowy, więc trzeba będzie go dostosować.
Czy jedno uruchomienie skryptu wystarczy, by uzyskać pełne i wiarygodne dane?
Nie, jedno uruchomienie daje tylko jedną próbkę. SERP i ceny są często personalizowane i rotowane, więc aby uzyskać wiarygodne wyniki, musisz uruchamiać scraper cyklicznie.
Ile lokalizacji potrzebuję do pełnowartościowego monitoringu enterprise?
To zależy od zadania i rynków, na których działasz. Zwróć też uwagę na precyzję targetowania - czy wystarczą dane na poziomie kraju, czy potrzebujesz dokładniejszych, na przykład na poziomie miasta lub kodu ZIP. DataImpulse oferuje targetowanie według kraju, stanu, miasta, ASN i ZIP, przy czym targetowanie według kraju jest automatycznie wliczone w cenę, a pozostałe filtry kosztują x2 w stosunku do opłaty podstawowej.
Czy są jakieś ograniczenia w tym, co mogę uzyskać z DataImpulse?
Tak, DataImpulse nie oferuje gotowego do użycia API do scrapingu. To samo dotyczy dostępu do danych rządowych i bankowych. Pod względem lokalizacji dostawca nie ma IP z Syrii, Iranu, Korei Północnej, Białorusi, Federacji Rosyjskiej, Kuby ani z tymczasowo okupowanych części Ukrainy.