
In this Article
Konwersja HTML do Markdown polega na zastąpieniu znaczników HTML lekką składnią tekstową przy zachowaniu obsługiwanych nagłówków, linków, list i kodu. W przypadku pobranych stron wyodrębnij potrzebną treść jeszcze przed konwersją, następnie ujednolić linki i zapisz metadane źródła.
Użyteczny wynik to dokument, który możesz sprawdzić, zacytować i zaindeksować. Ten poradnik omawia Pythona, JavaScript, trudne tabele i eksport całych witryn, a także zawiera migawkę liczby tokenów, która pokazuje również ryzyko usunięcia przydatnej treści.
Najważniejsze fakty
- Konwersja HTML do Markdown zachowuje obsługiwaną strukturę dokumentu, a odrzuca większość znaczników prezentacyjnych.
- Wyodrębnianie głównej treści i konwersja do Markdown to dwie osobne operacje.
- Nasza migawka z 15 października 2026 obejmuje 11 publicznych stron, od Wikipedii i MDN po indeks BBC i dokument RFC.
- Konwersja całych stron do Markdown zmniejszyła łączną liczbę tokenów o 84,7% w tej migawce.
- Ekstrakcja wraz z wyjściem w Markdown zmniejszyła łączną liczbę tokenów o 94,3%, ale na niektórych stronach z istotną utratą tekstu.
- Mniejsza liczba tokenów nie dowodzi wyższej trafności odpowiedzi.
- Znaczniki czasu pobrania powinny opisywać moment zebrania danych, a nie datę publikacji.
Co zachowuje, a co traci konwersja HTML do Markdown?
Konwersja zachowuje tekst i obsługiwaną strukturę dokumentu. Zwykle traci układ CSS, zachowania interaktywne oraz atrybuty HTML, które nie mają odpowiednika w Markdown. Składnia obrazów zachowuje odwołanie, a nie informacje zawarte w samym obrazie.
Poniższe odwzorowania opierają się na CommonMark oraz specyfikacji GitHub Flavored Markdown. Dokładny wynik zależy od ustawień konwertera.
| HTML | Typowy Markdown |
|---|---|
| h1-h6 | Nagłówki od # do ###### |
| p | Akapity oddzielone pustymi wierszami |
| a | [etykieta](URL) |
| img |  |
| ul / ol | Listy punktowane / numerowane |
| table | Tabela GFM z kreskami pionowymi lub zachowany HTML |
| pre / code | Bloki kodu w ogrodzeniu / odwrotne apostrofy w tekście |
| strong / em | **pogrubienie** / *wyróżnienie* |
| blockquote | > cytowany tekst |
Skorzystaj z poniższego 4-etapowego potoku czystej konwersji. Ekstrakcję traktuj jako decyzję o treści, a konwersję jako decyzję o reprezentacji. Szerzej tę różnicę wyjaśnia nasz poradnik o parsowaniu danych.
Czy konwersja HTML do Markdown zmniejsza liczbę tokenów i poprawia trafność LLM?
Markdown może zmniejszyć liczbę tokenów i szum znaczników, ale mniejsze dane wejściowe nie dowodzą lepszych odpowiedzi. Zachowanie treści i trafność w zadaniu mierz oddzielnie od oszczędności tokenów.
Nasza migawka z 15 października 2026, godz. 14:48 UTC obejmuje 11 stron (10 stron zewnętrznych i jeden wpis na blogu DataImpulse). Łączna liczba tokenów spadła z 742 763 dla surowego HTML do 113 844 dla Markdown całych stron (markdownify), a następnie do 42 037 dla Markdown głównej treści (Trafilatura): odpowiednio o 84,7% i 94,3% mniej niż w surowym HTML.
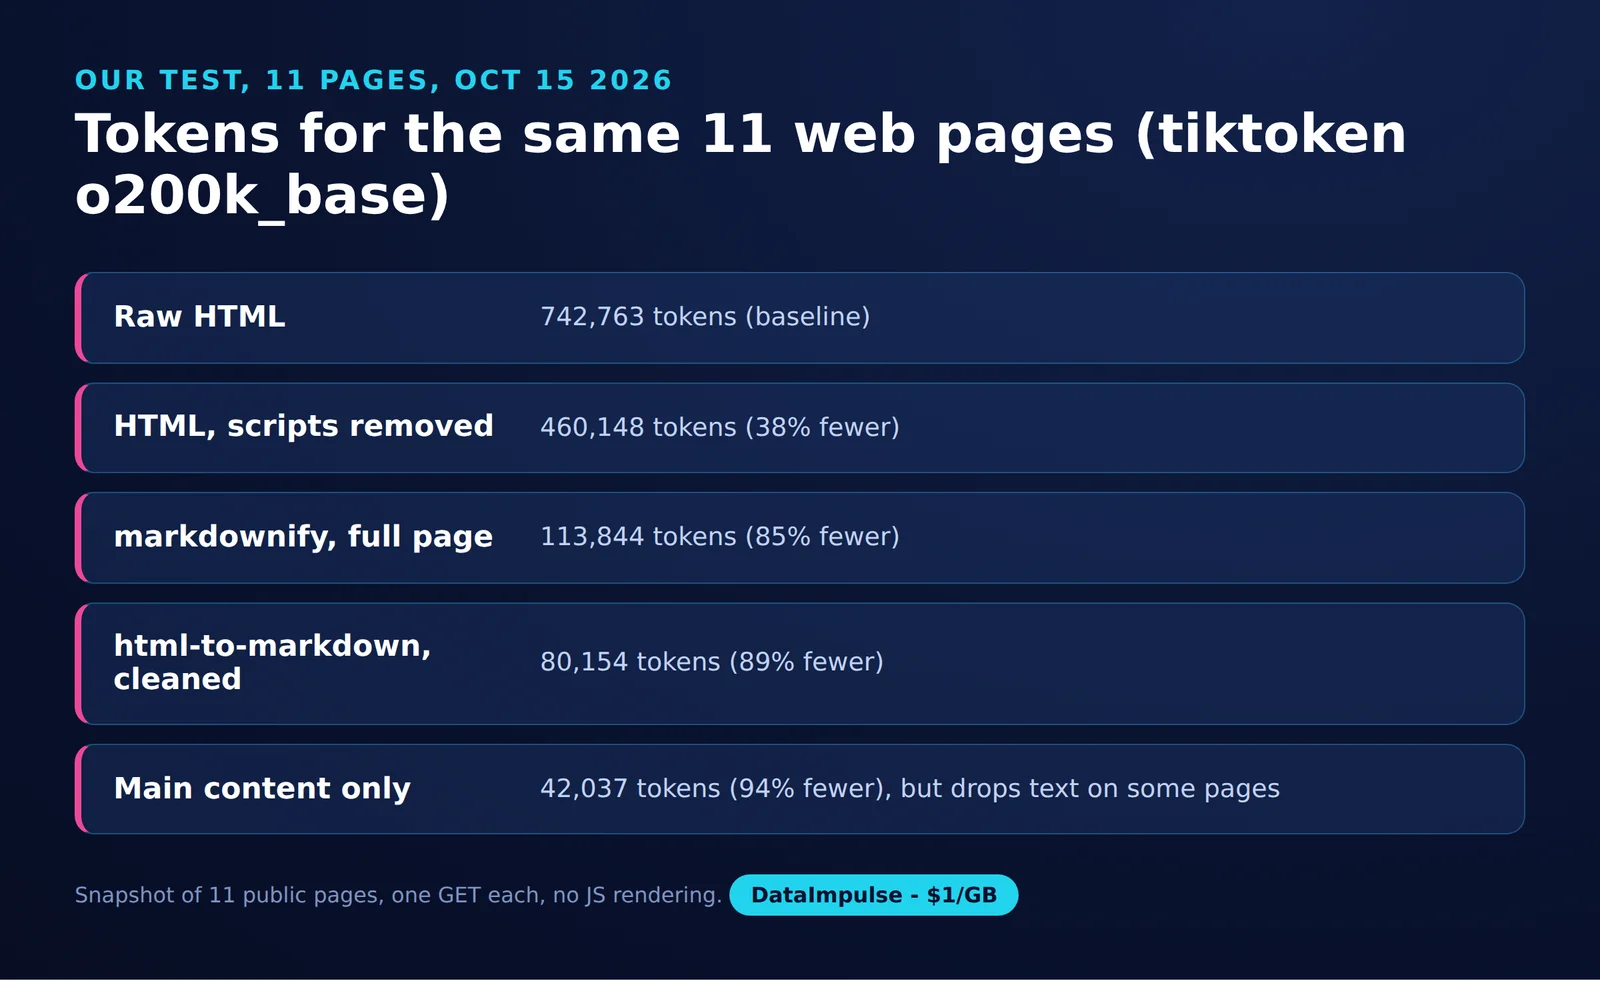
Źródło: pomiar DataImpulse z 15 października 2026. W metodzie użyto jednego żądania GET na adres URL, user agenta desktopowej Chrome, bez renderowania JavaScript i tego samego HTML dla każdego konwertera. Tokenizację wykonano z użyciem o200k_base i tiktoken 0.14.0; zapisane zależności to markdownify 1.2.3, Trafilatura 2.3.1, html-to-markdown 3.18.1 i Beautiful Soup 4.15.0.
| Reprezentacja | Łączna liczba tokenów | Redukcja względem surowego HTML |
|---|---|---|
| Surowy HTML | 742 763 | 0% |
| HTML bez skryptów | 460 148 | 38,0% |
| markdownify, cała strona | 113 844 | 84,7% |
| html-to-markdown, cała strona | 171 882 | 76,9% |
| html-to-markdown, po wcześniejszym usunięciu script/style | 80 154 | 89,2% |
| Markdown głównej treści z Trafilatura | 42 037 | 94,3% |
To migawka, a nie benchmark. Końcowy wynik jest o 63,1% mniejszy niż wynik markdownify, ale ta różnica łączy ekstrakcję i zachowanie konwertera. Nie wyodrębnia ona przyczynowego udziału samej ekstrakcji.
Kontrola zachowania treści ma znaczenie: liczba słów po ekstrakcji wyniosła 1 314 wobec 2 676 widocznych słów w artykule Cloudflare, 1 677 wobec 3 289 w RFC 9309 oraz 410 wobec 1 251 w indeksie BBC. Takie porównania wskazują możliwe straty, ale nie są dokładnymi wskaźnikami kompletności.
Cloudflare osobno podaje 16 180 tokenów HTML wobec 3 150 tokenów Markdown, czyli około 80% mniej, w swoim przykładzie Markdown for Agents. Z kolei TABVERSE wskazuje, że HTML jest często najbardziej odporną reprezentacją tekstową w zadaniach z tabelami. Żaden z tych wyników nie wskazuje uniwersalnie najlepszego formatu.
Której biblioteki do konwersji powinieneś użyć?
Wybieraj według środowiska uruchomieniowego, potrzeb w zakresie ekstrakcji i wierności tabel. Udokumentowane możliwości poniżej są aktualne na październik 2026; szybkości nie porządkujemy w ranking, bo jej nie mierzyliśmy.
| Biblioteka | Środowisko | Tabele | Obsługa zbędnych elementów | Najlepsze zastosowanie |
|---|---|---|---|---|
| markdownify | Python | Tabele z kreskami pionowymi; wnioskowanie nagłówka | DOM czyścisz osobno | Własne reguły konwersji |
| html2text | Python | Markdown lub pominięcie konwersji (HTML) | Ekstrakcja osobno | Konwersja nastawiona na tekst |
| Turndown | JavaScript | Wtyczka GFM | Reguły usuwania; ekstrakcja osobno | Potoki w JavaScript |
| JohannesKaufmann/html-to-markdown | Go | Wtyczka do tabel | Selektory i reguły | Usługi w Go |
| Pandoc | CLI | Zależy od dialektu wyjściowego | Ekstrakcja osobno | Przepływy pracy z dokumentami |
| Trafilatura | Python | Opcja ekstrakcji tabel | Wyodrębnianie głównej treści | Kolekcje artykułów |
- Wybierz markdownify, gdy chcesz kontrolować czyszczenie. Unikaj markdownify, gdy oczekujesz automatycznego wyboru artykułu.
- Wybierz html2text, gdy priorytetem jest czytelny tekst. Unikaj html2text, gdy nieprzetestowana rekonstrukcja tabel jest nie do zaakceptowania.
- Wybierz Turndown, gdy konwersja ma działać w JavaScript. Unikaj Turndown, gdy oczekujesz, że konwerter sam pobierze lub wyrenderuje strony.
- Wybierz Trafilatura, gdy ekstrakcja artykułów pasuje do Twoich źródeł. Unikaj Trafilatura, gdy liczy się każdy element paska bocznego lub indeksu, a nie robisz kontroli zachowania treści.
- Wybierz hostowane reader API, gdy chcesz pobierać i konwertować treści zdalnie. Unikaj hostowanego reader API, gdy dokumenty muszą pozostać offline.
Jak przekonwertować HTML do Markdown w Pythonie?
Sparsuj HTML, wybierz właściwy kontener, usuń zbędne węzły i przekaż wynik do markdownify. W przypadku lokalnych partii zachowaj ścieżki katalogów i przenoś metadane zbierania z pliku pomocniczego.
Ten przepis korzysta z operacji na DOM w Beautiful Soup oraz z udokumentowanych opcji markdownify dotyczących nagłówków i języka kodu. Zapisz go jako convert_batch.py.
python -m pip install markdownify beautifulsoup4
python convert_batch.py saved-html markdown-output
import json
import sys
from pathlib import Path
from urllib.parse import urljoin
from bs4 import BeautifulSoup
from markdownify import markdownify
def code_language(pre):
for node in (pre, pre.find('code')):
if node:
for name in node.get('class', []):
if name.startswith('language-'):
return name[len('language-'):]
return None
def convert(html, source_url):
soup = BeautifulSoup(html, 'html.parser')
title = soup.title.get_text(' ', strip=True) if soup.title else ''
base_tag = soup.find('base', href=True)
base = urljoin(source_url, base_tag['href']) if base_tag else source_url
root = soup.find('main') or soup.find('article') or soup
for node in root.select('script, style, nav, footer'):
node.decompose()
for tag, attr in [('a', 'href'), ('img', 'src')]:
for node in root.find_all(tag):
if node.get(attr):
node[attr] = urljoin(base, node[attr])
body = markdownify(
str(root), heading_style='ATX',
table_infer_header=False,
code_language_callback=code_language,
).strip() + '\n'
return title, body
def write_document(path, metadata, body):
path.parent.mkdir(parents=True, exist_ok=True)
fields = '\n'.join(
f'{key}: {json.dumps(value, ensure_ascii=True)}'
for key, value in metadata.items()
)
path.write_text(f'---\n{fields}\n---\n\n{body}', encoding='utf-8')
def batch(source, destination):
for path in sorted(source.rglob('*.html')):
metadata = json.loads(
path.with_suffix('.html.json').read_text(encoding='utf-8')
)
title, body = convert(path.read_bytes(), metadata['source_url'])
output = destination / path.relative_to(source).with_suffix('.md')
write_document(output, {
'title': title,
'source_url': metadata['source_url'],
'retrieved_at': metadata['retrieved_at'],
}, body)
if __name__ == '__main__':
batch(Path(sys.argv[1]), Path(sys.argv[2]))Każdy plik page.html.json musi zawierać source_url oraz oryginalny znacznik czasu retrieved_at. Nie podstawiaj w jego miejsce czasu modyfikacji pliku ani daty publikacji. Wynik używa frontmatter w YAML z wartościami skalarnymi w cudzysłowie; brakujące pliki pomocnicze powodują widoczny błąd zamiast zmyślania pochodzenia danych.
Jak przekonwertować HTML do Markdown w JavaScripcie?
Użyj Turndown na wyodrębnionym fragmencie HTML i włącz jego wtyczkę do tabel GFM. Poniższy przykład w Node.js jest zgodny z oficjalną instrukcją wtyczki.
npm install turndown turndown-plugin-gfm
node convert.cjs
const TurndownService = require('turndown');
const { tables } = require('turndown-plugin-gfm');
const converter = new TurndownService({
headingStyle: 'atx',
codeBlockStyle: 'fenced'
});
converter.use(tables);
converter.remove(['script', 'style', 'nav', 'footer']);
const html = `
<article>
<h1>Inventory</h1>
<p>Read the <a href="https://example.com/docs">documentation</a>.</p>
<table>
<thead><tr><th>Item</th><th>Count</th></tr></thead>
<tbody><tr><td>Books</td><td>12</td></tr></tbody>
</table>
</article>`;
console.log(converter.turndown(html));Przykład używa linków bezwzględnych. W środowisku produkcyjnym przed konwersją rozwiąż odwołania względne względem bazowego adresu URL pobranego dokumentu, a adnotacje języka kodu przetestuj osobno.
Której biblioteki Pythona użyć do zachowania tabel HTML?
Użyj konwertera z wyraźnymi ustawieniami dla tabel, a potem przetestuj swoje rzeczywiste struktury komórek. W przypadku scalonych komórek lub zagnieżdżonej treści zachowaj oryginalny HTML tabeli zamiast zakładać, że tabele z kreskami pionowymi oddają znaczenie.
Tabele z kreskami pionowymi są rozszerzeniem GFM i nie należą do rdzenia CommonMark. Specyfikacja tabel GFM obsługuje treść liniową w komórkach, ale nie potrafi wyrazić rowspan, colspan ani list blokowych wewnątrz komórek.
| Biblioteka | Udokumentowane ustawienie, stan na październik 2026 | Priorytet testu |
|---|---|---|
| markdownify | table_infer_header=False zostawia pusty nagłówek; True awansuje pierwszy wiersz | Nie zamieniaj przypadkiem danych w etykiety |
| html2text | bypass_tables zwraca tabele jako HTML | Sprawdź zachowane atrybuty i strukturę komórek |
| Python html-to-markdown, xberg | br_in_tables i compact_tables | Sprawdź komórki wielowierszowe i znaki ucieczki separatorów |
Pakiet xberg dla Pythona to osobny projekt, niezależny od konwertera w Go autorstwa JohannesKaufmann. To są udokumentowane ustawienia, a nie wyniki przeprowadzonego porównania wierności.
Przepuść te cztery przypadki testowe przez każdego kandydata i sprawdź wyrenderowany wynik:
| Przypadek | Komórka lub wiersz wejściowy | Warunek zaliczenia |
|---|---|---|
| Bez nagłówka | <tr><td>Alice</td><td>7</td></tr> |
Alice pozostaje danymi |
| Scalona komórka | <td colspan="2">Total</td> |
Semantyka scalenia przetrwa w zachowanym HTML |
| Dosłowna kreska pionowa | <td>A | B</td> |
Jedna komórka, z kreską pionową poprzedzoną znakiem ucieczki w Markdown |
| Zagnieżdżona lista | <td><ul><li>A</li></ul></td> |
Hierarchia listy przetrwa w zachowanym HTML |
W przypadku przekazywania bez zmian zachowaj złożone węzły tabel przed konwersją i przywróć je później jako bloki HTML. Upewnij się, że docelowy renderer akceptuje HTML.
Jak zamienić adres URL na czysty Markdown za pomocą API?
Wyślij adres URL do endpointu reader, poproś o wynik skoncentrowany na treści i zachowaj metadane źródła razem z odpowiedzią. Przed zaindeksowaniem sprawdź zwrócony dokument pod kątem brakujących sekcji.
Tabela porównuje udokumentowane rozwiązania na październik 2026. Offline oznacza przetwarzanie bez usługi hostowanej; pobranie aktywnego adresu URL nadal wymaga dostępu do sieci.
| Opcja | Uwierzytelnianie | Główna treść | Renderowanie JS | Metadane | Offline | Zakres |
|---|---|---|---|---|---|---|
| Jina Reader | Anonimowo lub klucz API | Tryby oparte na Readability | Dostępny silnik przeglądarki | Tryb frontmatter | Nie dla hostowanego endpointu | Pojedynczy URL; udokumentowano też tryb spider |
| Firecrawl | Start bez klucza; klucz dla wyższych limitów | Opcja onlyMainContent | Obsługiwane | Metadane odpowiedzi | Nie dla hostowanego API | Scrape i crawl |
| Crawl4AI, lokalnie | Brak klucza hostowanego dla użycia lokalnego | Skonfiguruj filtr treści | Przepływ z przeglądarką | Metadane wyniku | Lokalny przepływ HTML | Pojedynczy URL i głębokie crawlowanie |
| Cloudflare Markdown for Agents | Obowiązują reguły dostępu serwera źródłowego | Udokumentowane przetwarzanie wstępne | Brak kroku przeglądarki w negocjacji | Frontmatter, gdy dostępny | Nie | Żądana strona |
| Cloudflare Browser Rendering /markdown | Token API dla REST | Sprawdź wynik ekstrakcji | Renderowanie w przeglądarce | URL i czas zapisz samodzielnie | Nie | Żądana strona |
W przypadku Jina Reader poniższe polecenie żąda frontmatter i ekstrakcji treści:
curl --fail --show-error \
  -H 'X-Respond-With: frontmatter' \
  'https://r.jina.ai/https://example.com/'
Negocjacja Accept: text/markdown w Cloudflare działa w strefach z włączonym Markdown for Agents. Endpoint /markdown usługi Browser Rendering to osobna trasa, a nie nagłówek włączający renderowanie w przeglądarce na dowolnych witrynach.
Jak przekonwertować całą witrynę na pliki Markdown?
Zacznij od adresów początkowych lub adresów URL z mapy witryny, ogranicz wykrywanie stron i wyeksportuj jeden dokument na każdy źródłowy adres URL. Przy każdym pliku zapisz tytuł, czas pobrania i źródłowy adres URL, aby późniejsze odpowiedzi pozostały możliwe do prześledzenia.
| Opcja, stan na październik 2026 | Przepływ pracy | Uwagi dotyczące eksportu |
|---|---|---|
| Firecrawl Crawl | Wykrywanie przez mapę witryny i linki; renderowanie | Zapisz zwrócone dokumenty i metadane do plików |
| Crawl4AI deep crawling | Lokalne crawlowanie z kontrolą głębokości i liczby stron | Markdown wyniku i metadane zapisz samodzielnie |
| SiteOne Crawler | Crawlowanie witryny i eksport do Markdown | Wynik w wielu plikach lub połączony |
| Website Content Crawler, apify/website-content-crawler | Crawlowanie przez HTTP lub przeglądarkę z czyszczeniem | Wyeksportuj pola Markdown ze zbioru danych do plików |
Dla małej statycznej witryny, którą kontrolujesz, zapisz ten skrypt jako crawl_static.py obok konwertera w Pythonie. Do pobierania przez HTTP używa on biblioteki Requests, ogranicza głębokość i liczbę prób oraz zapisuje znaczniki czasu zbierania. Pomija przekierowania i nie renderuje JavaScript.
python -m pip install requests
python crawl_static.py https://example.com/
import hashlib
import sys
import time
from collections import deque
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urldefrag, urljoin, urlsplit
import requests
from bs4 import BeautifulSoup
from convert_batch import convert, write_document
seed = urldefrag(sys.argv[1])[0]
origin = urlsplit(seed)
queue = deque([(seed, 0)])
seen = {seed}
content_files = {}
attempts = 0
while queue and attempts < 20:
url, depth = queue.popleft()
attempts += 1
time.sleep(1)
try:
response = requests.get(url, timeout=30, allow_redirects=False)
if response.status_code != 200:
print('Skipped:', response.status_code, url)
continue
if 'text/html' not in response.headers.get('Content-Type', ''):
continue
html = response.content
retrieved_at = datetime.now(timezone.utc).isoformat()
title, body = convert(html, url)
digest = hashlib.sha256(body.encode('utf-8')).hexdigest()
filename = hashlib.sha256(url.encode('utf-8')).hexdigest() + '.md'
metadata = {
'title': title, 'source_url': url,
'retrieved_at': retrieved_at,
}
if digest in content_files:
metadata['duplicate_of'] = content_files[digest]
else:
content_files[digest] = filename
write_document(Path('site-md') / filename, metadata, body)
if depth < 2:
soup = BeautifulSoup(html, 'html.parser')
base_tag = soup.find('base', href=True)
base = urljoin(url, base_tag['href']) if base_tag else url
for link in soup.select('a[href]'):
target = urldefrag(urljoin(base, link['href']))[0]
parts = urlsplit(target)
if (parts.scheme, parts.netloc) != (origin.scheme, origin.netloc):
continue
if target not in seen and len(seen) < 500:
seen.add(target)
queue.append((target, depth + 1))
except requests.RequestException as error:
print('Failed:', url, error)Zduplikowana treść jest oznaczana bez utraty informacji o pochodzeniu źródła; oznaczone kopie pomijaj podczas indeksowania. Skróty adresów URL zapewniają stabilne nazwy plików. Przy większych zadaniach dodaj wczytywanie map witryn, trwałe kolejki, renderowanie tam, gdzie jest potrzebne, oraz eksporty z punktami kontrolnymi.
Przestrzegaj zasad dostępu do witryn, ograniczaj tempo żądań i ponawiaj próby po przejściowych błędach z wykorzystaniem backoff. Routing residential może pomóc w diagnozowaniu ograniczeń przepustowości powiązanych z konkretnym IP, ale nie zastępuje kontroli tempa żądań. Zobacz konfigurację proxy dla Crawl4AI, architekturę proxy dla RAG i zgodne z zasadami przepływy zbierania danych.
Co psuje się podczas konwersji i jak to naprawić?
Większość błędów wynika z niekompletnych danych wejściowych, zbyt agresywnej ekstrakcji lub struktur, których Markdown nie potrafi odwzorować. Zachowaj źródłowy HTML i przed skalowaniem porównaj reprezentatywne wyniki.
| Sygnał błędu | Prawdopodobna przyczyna | Naprawa |
|---|---|---|
| Pusty artykuł | Tekst dostarczył JavaScript | Wyrenderuj stronę i poczekaj na element z treścią |
| Tekst menu lub cookies | Czyszczenie pominęło zbędne elementy | Dostosuj selektory do konkretnej witryny |
| Uszkodzone linki/obrazy | Odwołania względne utraciły bazę | Rozwiąż je względem dokumentu/bazowego adresu URL |
| Kod traci język | Odrzucono metadane klas | Odwzoruj klasy języka w ogrodzeniach kodu |
| Myląca tabela | Spłaszczone scalenia lub zagnieżdżona treść | Zachowaj HTML tabeli |
| Podejrzanie mały wynik | Ekstrakcja odrzuciła przydatne sekcje | Porównaj nagłówki, komórki i tekst |
Regex czy parser DOM? Do zagnieżdżonych znaczników i obsługi encji użyj parsera. Regex zostaw do wąsko określonego czyszczenia tekstu po parsowaniu.
Narzędzie online: przydatne dla małego, niewrażliwego fragmentu, który możesz od razu sprawdzić.
Rozszerzenie przeglądarki: przydatne przy wybieraniu treści z już wyrenderowanej strony; sprawdź uprawnienia.
Biblioteka offline: przydatna przy powtarzalnych partiach i dokumentach, które muszą pozostać lokalnie.
Konwersja do Markdown nie oczyszcza zachowanego HTML ani nie usuwa prompt injection z tekstu strony. Trzymaj pobraną treść oddzielnie od instrukcji i testuj jakość wyszukiwania na pytaniach, których odpowiedzi możesz zweryfikować.
Najczęściej zadawane pytania
Czy mogę przekonwertować HTML do Markdown bez utraty czegokolwiek?
Na ogół nie. Układ, zachowania interaktywne i niektóre relacje strukturalne nie mają bezpośredniego odpowiednika w Markdown, więc gdy te szczegóły mają znaczenie, zachowaj źródłowy HTML.
Czy przed konwersją warto usuwać skrypty?
Zwykle tak, w przypadku dokumentu skoncentrowanego na tekście. Jeśli dane strukturalne wewnątrz skryptów są przydatne, wyodrębnij je do osobnych metadanych przed usunięciem tych węzłów.
Czy najmniejszy wynik w Markdown to najlepsze dane wejściowe dla RAG?
Nie. Ekstraktor może wytworzyć bardzo mały dokument, odrzucając treść zawierającą odpowiedź, dlatego obok liczby tokenów oceniaj zachowanie treści i jakość wyszukiwania.
Czy tabela bez nagłówka powinna zyskać wiersz nagłówka?
Tylko wtedy, gdy uzasadnia to semantyka źródła. Automatyczne awansowanie pierwszego wiersza danych może zmienić znaczenie każdego kolejnego wiersza.
Czy lokalny przepis na przetwarzanie wsadowe może działać bez dostępu do internetu?
Tak, po zainstalowaniu zależności oraz zebraniu plików HTML i plików pomocniczych z metadanymi. Sama konwersja nie musi pobierać oryginalnych stron.
Jaki znacznik czasu należy do frontmatter w Markdown?
Użyj czasu pobrania źródła dla rekordu kolekcji. Daty publikacji trzymaj w osobnym polu, gdy wiarygodne metadane źródła je podają.
Czy crawlowanie witryny gwarantuje kompletny eksport?
Nie. Limity wykrywania, niedostępne strony, przekierowania i błędy renderowania mogą zostawić luki, dlatego porównaj wyeksportowane adresy URL z zakładanym spisem.
Potrzebujesz routingu residential dla swojego potoku zbierania danych?
Jeśli Twój przepływ zbierania danych wymaga routingu przez residential IP, poznaj residential proxy DataImpulse. DataImpulse zapewnia infrastrukturę proxy, a nie API do scrapingu, zarządzany unblocker ani VPN; pobieranie, ekstrakcja, konwersja i walidacja pozostają częścią Twojego potoku.
Ostatnia aktualizacja: 15 października 2026.