
In this Article
Convertir du html en markdown consiste à remplacer le balisage HTML par une syntaxe texte légère, tout en conservant les titres, liens, listes et blocs de code pris en charge. Pour des pages issues de web scraping, extrayez d’abord le contenu dont vous avez besoin, puis convertissez, normalisez les liens et enregistrez les métadonnées de la source.
Le résultat utile est un document que vous pouvez inspecter, citer et indexer. Ce guide couvre Python, JavaScript, les tableaux difficiles et l’export de sites entiers, avec un aperçu chiffré des tokens qui met aussi en évidence le risque de supprimer du contenu utile.
L’essentiel
- La conversion de HTML en Markdown conserve la structure prise en charge du document, tout en écartant la plupart du balisage de présentation.
- L’extraction du contenu principal et la conversion en Markdown sont deux opérations distinctes.
- Notre relevé du 15 octobre 2026 porte sur 11 pages publiques, de Wikipedia et MDN à un index de la BBC et une RFC.
- La conversion de la page complète en Markdown a réduit le total de tokens de 84,7 % dans ce relevé.
- L’extraction suivie d’une sortie Markdown a réduit le total de tokens de 94,3 %, avec une perte de texte importante sur certaines pages.
- Un nombre de tokens plus faible ne prouve pas une meilleure précision des réponses.
- Les horodatages de récupération doivent indiquer la date de collecte, pas la date de publication.
Que conserve et que perd la conversion de html en markdown ?
La conversion conserve le texte et la structure de document prise en charge. Elle perd généralement la mise en page CSS, les comportements interactifs et les attributs HTML sans équivalent en Markdown ; la syntaxe d’image conserve une référence, pas l’information que contient l’image.
Les correspondances suivantes suivent la spécification CommonMark et la spécification GitHub Flavored Markdown. Les réglages du convertisseur déterminent le résultat exact.
| HTML | Markdown typique |
|---|---|
| h1-h6 | Titres de # à ###### |
| p | Paragraphes séparés par des lignes vides |
| a | [libellé](URL) |
| img |  |
| ul / ol | Listes à puces / numérotées |
| table | Tableau GFM à barres verticales ou HTML conservé |
| pre / code | Blocs délimités / accents graves en ligne |
| strong / em | **gras** / *emphase* |
| blockquote | > texte cité |
Utilisez le pipeline de conversion propre en 4 étapes ci-dessous. Considérez l’extraction comme une décision de contenu et la conversion comme une décision de représentation. Notre guide du parsing de données explique plus en détail cette distinction.
Convertir du html en markdown réduit-il les tokens et améliore-t-il la précision des LLM ?
Le Markdown peut réduire les tokens et le bruit de balisage, mais une entrée plus petite ne prouve pas de meilleures réponses. Mesurez la rétention du contenu et la précision sur la tâche séparément des économies de tokens.
Notre relevé du 15 octobre 2026 à 14:48 UTC porte sur 11 pages (10 pages externes et un article du blog DataImpulse). Le total de tokens est passé de 742 763 en HTML brut à 113 844 en Markdown pleine page avec markdownify, puis à 42 037 en Markdown du contenu principal avec Trafilatura : respectivement 84,7 % et 94,3 % de moins que le HTML brut.
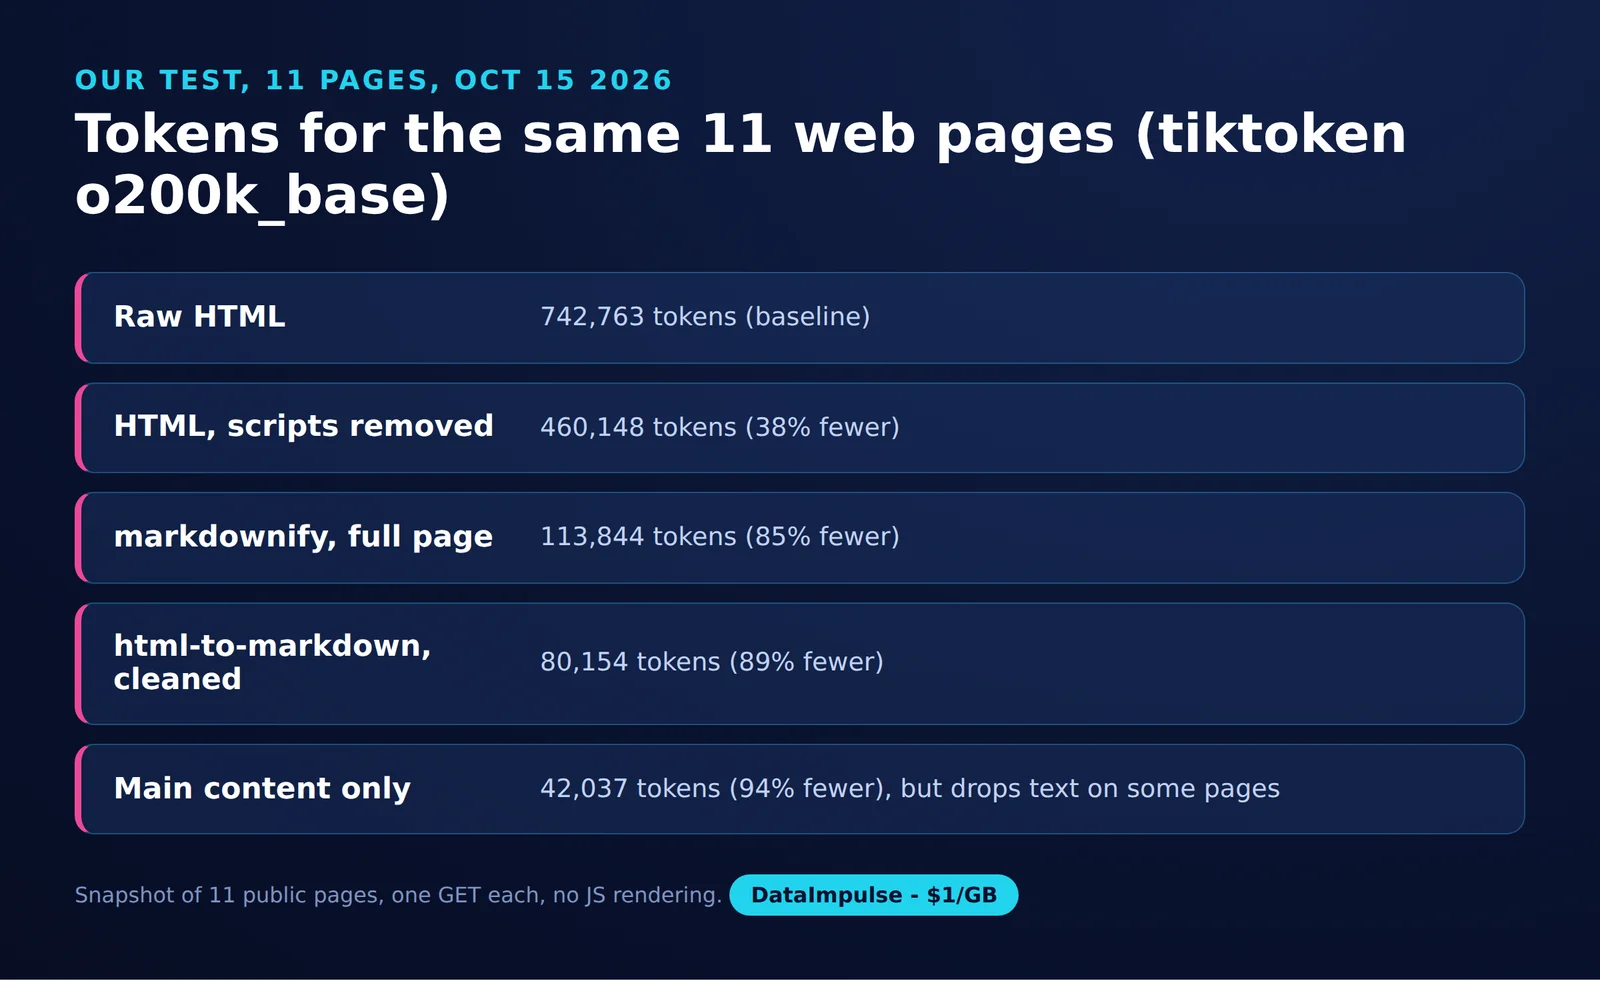
Source : mesure DataImpulse, 15 octobre 2026. La méthode reposait sur une requête GET par URL, un user agent Chrome de bureau, aucun rendu JavaScript et le même HTML pour tous les convertisseurs. La tokenisation a utilisé o200k_base avec tiktoken 0.14.0 ; les dépendances relevées étaient markdownify 1.2.3, Trafilatura 2.3.1, html-to-markdown 3.18.1 et Beautiful Soup 4.15.0.
| Représentation | Total de tokens | Réduction par rapport au brut |
|---|---|---|
| HTML brut | 742 763 | 0 % |
| HTML sans scripts | 460 148 | 38,0 % |
| markdownify, page complète | 113 844 | 84,7 % |
| html-to-markdown, page complète | 171 882 | 76,9 % |
| html-to-markdown, script/style supprimés d’abord | 80 154 | 89,2 % |
| Markdown du contenu principal par Trafilatura | 42 037 | 94,3 % |
Il s’agit d’un relevé, pas d’un benchmark. Le résultat final est 63,1 % plus petit que celui de markdownify, mais cet écart combine l’extraction et le comportement du convertisseur. Il n’isole pas la contribution causale de l’extraction.
Les contrôles de rétention comptent : les nombres de mots extraits étaient de 1 314 contre 2 676 mots visibles sur l’article de Cloudflare, de 1 677 contre 3 289 sur la RFC 9309 et de 410 contre 1 251 sur l’index de la BBC. Ces comparaisons signalent une perte possible ; ce ne sont pas des scores de rappel exacts.
De son côté, Cloudflare rapporte 16 180 tokens HTML contre 3 150 tokens Markdown, soit environ 80 % de moins, dans son exemple Markdown for Agents. Par ailleurs, TABVERSE constate que le HTML est souvent la représentation textuelle la plus robuste pour ses tâches sur les tableaux. Aucun de ces résultats n’établit un format universellement meilleur.
Quelle bibliothèque de conversion choisir ?
Choisissez selon l’environnement d’exécution, les besoins d’extraction et la fidélité des tableaux. Les fonctionnalités documentées ci-dessous sont à jour en octobre 2026 ; la vitesse n’est pas classée, car nous ne l’avons pas mesurée.
| Bibliothèque | Environnement | Tableaux | Gestion du contenu parasite | Usage idéal |
|---|---|---|---|---|
| markdownify | Python | Tableaux à barres verticales ; déduction de l’en-tête | Nettoyer le DOM séparément | Règles de conversion personnalisées |
| html2text | Python | Markdown ou contournement en HTML | Extraire séparément | Conversion orientée texte |
| Turndown | JavaScript | Plugin GFM | Règles de suppression ; extraire séparément | Pipelines JavaScript |
| JohannesKaufmann/html-to-markdown | Go | Plugin de tableaux | Sélecteurs et règles | Services Go |
| Pandoc | CLI | Dépend du dialecte de sortie | Extraire séparément | Flux de travail documentaires |
| Trafilatura | Python | Option d’extraction des tableaux | Extraction du contenu principal | Collections d’articles |
- Utilisez markdownify si vous maîtrisez le nettoyage. Évitez markdownify si vous attendez une sélection automatique de l’article.
- Utilisez html2text si un texte lisible est la priorité. Évitez html2text si une reconstruction de tableaux non testée est inacceptable.
- Utilisez Turndown si la conversion doit se faire en JavaScript. Évitez Turndown si vous attendez du convertisseur qu’il récupère ou rende les pages.
- Utilisez Trafilatura si l’extraction d’articles convient à vos sources. Évitez Trafilatura si chaque barre latérale ou entrée d’index compte et que vous ne faites pas de contrôles de rétention.
- Utilisez une API de lecture hébergée si vous voulez déléguer la récupération et la conversion. Évitez une API de lecture hébergée si les documents doivent rester hors ligne.
Comment convertir du html en markdown avec Python ?
Analysez le HTML, sélectionnez le conteneur pertinent, supprimez les nœuds indésirables et passez le résultat à markdownify. Pour des lots locaux, conservez l’arborescence des répertoires et reprenez les métadonnées de collecte depuis un fichier annexe.
Cette recette utilise les opérations DOM de Beautiful Soup ainsi que les options documentées de markdownify pour les titres et les langages de code. Enregistrez-la sous le nom convert_batch.py.
python -m pip install markdownify beautifulsoup4
python convert_batch.py saved-html markdown-output
import json
import sys
from pathlib import Path
from urllib.parse import urljoin
from bs4 import BeautifulSoup
from markdownify import markdownify
def code_language(pre):
for node in (pre, pre.find('code')):
if node:
for name in node.get('class', []):
if name.startswith('language-'):
return name[len('language-'):]
return None
def convert(html, source_url):
soup = BeautifulSoup(html, 'html.parser')
title = soup.title.get_text(' ', strip=True) if soup.title else ''
base_tag = soup.find('base', href=True)
base = urljoin(source_url, base_tag['href']) if base_tag else source_url
root = soup.find('main') or soup.find('article') or soup
for node in root.select('script, style, nav, footer'):
node.decompose()
for tag, attr in [('a', 'href'), ('img', 'src')]:
for node in root.find_all(tag):
if node.get(attr):
node[attr] = urljoin(base, node[attr])
body = markdownify(
str(root), heading_style='ATX',
table_infer_header=False,
code_language_callback=code_language,
).strip() + '\n'
return title, body
def write_document(path, metadata, body):
path.parent.mkdir(parents=True, exist_ok=True)
fields = '\n'.join(
f'{key}: {json.dumps(value, ensure_ascii=True)}'
for key, value in metadata.items()
)
path.write_text(f'---\n{fields}\n---\n\n{body}', encoding='utf-8')
def batch(source, destination):
for path in sorted(source.rglob('*.html')):
metadata = json.loads(
path.with_suffix('.html.json').read_text(encoding='utf-8')
)
title, body = convert(path.read_bytes(), metadata['source_url'])
output = destination / path.relative_to(source).with_suffix('.md')
write_document(output, {
'title': title,
'source_url': metadata['source_url'],
'retrieved_at': metadata['retrieved_at'],
}, body)
if __name__ == '__main__':
batch(Path(sys.argv[1]), Path(sys.argv[2]))Chaque fichier page.html.json doit contenir source_url et l’horodatage d’origine retrieved_at. Ne les remplacez ni par la date de modification du fichier ni par la date de publication. La sortie utilise un frontmatter YAML avec des valeurs scalaires entre guillemets ; l’absence d’un fichier annexe provoque une erreur visible au lieu d’inventer une provenance.
Comment convertir du HTML en Markdown avec JavaScript ?
Utilisez Turndown sur un fragment HTML extrait et activez son plugin de tableaux GFM. L’exemple Node.js suivant reprend les instructions officielles du plugin.
npm install turndown turndown-plugin-gfm
node convert.cjs
const TurndownService = require('turndown');
const { tables } = require('turndown-plugin-gfm');
const converter = new TurndownService({
headingStyle: 'atx',
codeBlockStyle: 'fenced'
});
converter.use(tables);
converter.remove(['script', 'style', 'nav', 'footer']);
const html = `
<article>
<h1>Inventory</h1>
<p>Read the <a href="https://example.com/docs">documentation</a>.</p>
<table>
<thead><tr><th>Item</th><th>Count</th></tr></thead>
<tbody><tr><td>Books</td><td>12</td></tr></tbody>
</table>
</article>`;
console.log(converter.turndown(html));L’exemple utilise des liens absolus. En production, résolvez les références relatives par rapport à l’URL de base du document récupéré avant la conversion, et testez séparément les annotations de langage de code.
Quelle bibliothèque Python utiliser pour conserver les tableaux HTML ?
Utilisez un convertisseur doté de contrôles explicites pour les tableaux, puis testez vos structures de cellules réelles. Pour les cellules fusionnées ou le contenu imbriqué, conservez le HTML d’origine du tableau plutôt que de supposer que les tableaux à barres verticales préservent le sens.
Les tableaux à barres verticales sont une extension de GFM, absente du noyau de CommonMark. La spécification des tableaux GFM prend en charge le contenu en ligne dans les cellules, mais ne peut exprimer ni rowspan, ni colspan, ni listes en bloc dans les cellules.
| Bibliothèque | Contrôle documenté, état en octobre 2026 | Priorité de test |
|---|---|---|
| markdownify | table_infer_header=False laisse un en-tête vide ; True promeut la première ligne | Ne pas transformer des données en libellés par accident |
| html2text | bypass_tables produit les tableaux en HTML | Inspecter les attributs conservés et la structure des cellules |
| html-to-markdown pour Python, xberg | br_in_tables et compact_tables | Vérifier les cellules multilignes et les délimiteurs échappés |
Le paquet Python xberg est un projet distinct du convertisseur Go de JohannesKaufmann. Ce sont des contrôles documentés, pas les résultats d’une comparaison de fidélité réellement exécutée.
Faites passer ces quatre cas de test dans chaque candidat et inspectez le rendu obtenu :
| Cas de test | Cellule ou ligne d’entrée | Condition de réussite |
|---|---|---|
| Sans en-tête | <tr><td>Alice</td><td>7</td></tr> |
Alice reste une donnée |
| Cellule fusionnée | <td colspan="2">Total</td> |
La sémantique de fusion survit dans le HTML conservé |
| Barre verticale littérale | <td>A | B</td> |
Une seule cellule, avec la barre verticale échappée en Markdown |
| Liste imbriquée | <td><ul><li>A</li></ul></td> |
La hiérarchie de la liste survit dans le HTML conservé |
Pour un passage direct, préservez les nœuds de tableaux complexes avant la conversion, puis restaurez-les ensuite sous forme de blocs HTML. Vérifiez que le moteur de rendu en aval accepte le HTML.
Comment transformer une URL en Markdown propre avec une API ?
Envoyez l’URL à un point d’accès de lecture, demandez sa sortie centrée sur le contenu et conservez les métadonnées de la source avec la réponse. Vérifiez que le document retourné ne présente pas de sections manquantes avant de l’indexer.
Le tableau compare les approches documentées en octobre 2026. Hors ligne signifie un traitement sans service hébergé ; récupérer une URL en direct nécessite toujours un accès réseau.
| Option | Authentification | Contenu principal | Rendu JS | Métadonnées | Hors ligne | Périmètre |
|---|---|---|---|---|---|---|
| Jina Reader | Anonyme ou clé API | Modes basés sur Readability | Moteur de navigateur disponible | Mode frontmatter | Non pour le point d’accès hébergé | URL unique ; mode spider également documenté |
| Firecrawl | Démarrage sans clé ; clé pour des quotas plus élevés | Option onlyMainContent | Pris en charge | Métadonnées de la réponse | Non pour l’API hébergée | Scrape et crawl |
| Crawl4AI, en local | Pas de clé hébergée pour un usage local | Configurer un filtre de contenu | Flux avec navigateur | Métadonnées du résultat | Flux HTML local | URL unique et crawl en profondeur |
| Cloudflare Markdown for Agents | Les règles d’accès de l’origine s’appliquent | Prétraitement documenté | Pas d’étape de navigateur dans la négociation | Frontmatter si disponible | Non | Page demandée |
| Cloudflare Browser Rendering /markdown | Jeton d’API pour REST | Inspecter la sortie d’extraction | Rendu par navigateur | Stocker vous-même l’URL et l’heure | Non | Page demandée |
Pour Jina Reader, la commande suivante demande le frontmatter et l’extraction du contenu :
curl --fail --show-error \
  -H 'X-Respond-With: frontmatter' \
  'https://r.jina.ai/https://example.com/'
La négociation Accept: text/markdown de Cloudflare fonctionne sur les zones où Markdown for Agents est activé. Son point d’accès Browser Rendering /markdown est une route distincte, pas un en-tête qui active le rendu par navigateur sur des sites web arbitraires.
Comment convertir un site web entier en fichiers Markdown ?
Partez d’URL de départ ou d’un sitemap, limitez la découverte et exportez un document par URL source. Enregistrez le titre, l’heure de récupération et l’URL source dans chaque fichier afin que les réponses en aval restent traçables.
| Option, état en octobre 2026 | Flux de travail | Point d’attention pour l’export |
|---|---|---|
| Firecrawl Crawl | Découverte via sitemap et liens ; rendu | Écrire les documents et métadonnées retournés dans des fichiers |
| Crawl4AI deep crawling | Crawl local avec contrôles de profondeur et de nombre de pages | Écrire vous-même le Markdown et les métadonnées du résultat |
| SiteOne Crawler | Crawl de site web et export en Markdown | Sortie en plusieurs fichiers ou combinée |
| Website Content Crawler, apify/website-content-crawler | Crawl HTTP ou par navigateur avec nettoyage | Exporter les champs Markdown du dataset vers des fichiers |
Pour un petit site statique que vous maîtrisez, enregistrez ce script sous le nom crawl_static.py, à côté du convertisseur Python. Il utilise Requests pour la récupération HTTP, limite la profondeur et le nombre de tentatives, et enregistre les horodatages de collecte. Il ignore les redirections et ne rend pas le JavaScript.
python -m pip install requests
python crawl_static.py https://example.com/
import hashlib
import sys
import time
from collections import deque
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urldefrag, urljoin, urlsplit
import requests
from bs4 import BeautifulSoup
from convert_batch import convert, write_document
seed = urldefrag(sys.argv[1])[0]
origin = urlsplit(seed)
queue = deque([(seed, 0)])
seen = {seed}
content_files = {}
attempts = 0
while queue and attempts < 20:
url, depth = queue.popleft()
attempts += 1
time.sleep(1)
try:
response = requests.get(url, timeout=30, allow_redirects=False)
if response.status_code != 200:
print('Skipped:', response.status_code, url)
continue
if 'text/html' not in response.headers.get('Content-Type', ''):
continue
html = response.content
retrieved_at = datetime.now(timezone.utc).isoformat()
title, body = convert(html, url)
digest = hashlib.sha256(body.encode('utf-8')).hexdigest()
filename = hashlib.sha256(url.encode('utf-8')).hexdigest() + '.md'
metadata = {
'title': title, 'source_url': url,
'retrieved_at': retrieved_at,
}
if digest in content_files:
metadata['duplicate_of'] = content_files[digest]
else:
content_files[digest] = filename
write_document(Path('site-md') / filename, metadata, body)
if depth < 2:
soup = BeautifulSoup(html, 'html.parser')
base_tag = soup.find('base', href=True)
base = urljoin(url, base_tag['href']) if base_tag else url
for link in soup.select('a[href]'):
target = urldefrag(urljoin(base, link['href']))[0]
parts = urlsplit(target)
if (parts.scheme, parts.netloc) != (origin.scheme, origin.netloc):
continue
if target not in seen and len(seen) < 500:
seen.add(target)
queue.append((target, depth + 1))
except requests.RequestException as error:
print('Failed:', url, error)Les contenus en double sont signalés sans perdre la provenance de la source ; ignorez les copies signalées lors de l’indexation. Les hachages d’URL donnent des noms de fichiers stables. Pour des tâches plus volumineuses, ajoutez l’ingestion de sitemap, des files d’attente persistantes, du rendu lorsque nécessaire et des exports avec points de reprise.
Respectez les politiques d’accès des sites, limitez le débit des requêtes et relancez les échecs transitoires avec un backoff. Un routage résidentiel peut aider à diagnostiquer une limitation liée à une IP, mais ne remplace pas le contrôle du débit. Consultez la configuration de proxy pour Crawl4AI, l’architecture de proxies pour le RAG et les flux de collecte conformes.
Qu’est-ce qui échoue pendant la conversion, et comment y remédier ?
La plupart des échecs viennent d’une entrée incomplète, d’une extraction trop agressive ou de structures que le Markdown ne peut pas représenter. Conservez le HTML source et comparez des sorties représentatives avant de passer à l’échelle.
| Signal d’échec | Cause probable | Correction |
|---|---|---|
| Article vide | Le texte est fourni par JavaScript | Rendre la page et attendre l’élément de contenu |
| Texte de menu ou de cookies | Le nettoyage a laissé passer du contenu parasite | Ajuster les sélecteurs propres au site |
| Liens ou images cassés | Les références relatives ont perdu leur base | Résoudre par rapport à l’URL du document ou de base |
| Le code perd son langage | Métadonnées de classe écartées | Reporter les classes de langage dans les blocs délimités |
| Tableau trompeur | Fusions aplaties ou contenu imbriqué | Conserver le HTML du tableau |
| Sortie suspecte par sa petite taille | L’extraction a supprimé des sections utiles | Comparer les titres, les cellules et le texte |
Regex ou analyseur DOM ? Utilisez un analyseur pour le balisage imbriqué et la gestion des entités. Réservez les regex à un nettoyage de texte strictement délimité, après l’analyse.
Outil en ligne : utile pour un petit fragment non sensible que vous pouvez inspecter immédiatement.
Extension de navigateur : utile pour sélectionner du contenu sur une page déjà rendue ; vérifiez les permissions.
Bibliothèque hors ligne : utile pour des lots reproductibles et des documents qui doivent rester en local.
La conversion en Markdown ne nettoie pas le HTML conservé et ne supprime pas les injections de prompt présentes dans le texte des pages. Gardez le contenu récupéré séparé des instructions, et testez la qualité de la recherche avec des questions dont vous pouvez vérifier les réponses.
Foire aux questions
Puis-je convertir du HTML en Markdown sans rien perdre ?
En général, non. La mise en page, les comportements interactifs et certaines relations structurelles n’ont pas d’équivalent direct en Markdown ; conservez donc le HTML source lorsque ces détails comptent.
Dois-je supprimer les scripts avant la conversion ?
Le plus souvent, oui, pour un document centré sur le texte. Si les données structurées contenues dans les scripts sont utiles, extrayez-les dans des métadonnées séparées avant de supprimer ces nœuds.
Le Markdown le plus court est-il la meilleure entrée pour le RAG ?
Non. Un extracteur peut produire un document très petit en écartant le contenu qui porte la réponse ; évaluez donc la rétention et la recherche en plus du nombre de tokens.
Un tableau sans en-tête doit-il recevoir une ligne d’en-tête ?
Seulement lorsque la sémantique de la source le justifie. Promouvoir automatiquement la première ligne de données peut changer le sens de toutes les lignes suivantes.
La recette de traitement par lots local peut-elle fonctionner sans accès à Internet ?
Oui, une fois ses dépendances installées et le HTML ainsi que les fichiers annexes de métadonnées collectés. La conversion elle-même n’a pas besoin de récupérer les pages d’origine.
Quel horodatage placer dans le frontmatter Markdown ?
Utilisez l’heure à laquelle la source a été récupérée pour l’enregistrement de collecte. Conservez les dates de publication dans un champ séparé lorsque des métadonnées de source fiables les fournissent.
Le crawl d’un site web garantit-il un export complet ?
Non. Les limites de découverte, les pages inaccessibles, les redirections et les échecs de rendu peuvent laisser des lacunes ; rapprochez donc les URL exportées de votre inventaire prévu.
Besoin d’un routage résidentiel pour votre pipeline de collecte ?
Si votre flux de collecte nécessite un routage par IP résidentielles, découvrez les proxies résidentiels DataImpulse. DataImpulse fournit une infrastructure de proxies, pas une API de scraping, ni un unblocker managé, ni un VPN ; la récupération, l’extraction, la conversion et la validation restent à la charge de votre pipeline.
Dernière mise à jour : 15 octobre 2026.