
In this Article
Apollo scraper to narzędzie lub proces, którego celem jest wyciągnięcie danych o prospektach z Apollo do pliku nadającego się do ponownego użycia. Przed importem do CRM zacznij od oceny autoryzowanych eksportów CSV lub dostępu przez API pod kątem pól, wolumenu i uprawnień, których wymaga Twoje zadanie.
Wartością jest plik kontaktów z możliwością prześledzenia pochodzenia danych, a nie sama większa liczba wierszy. Ten poradnik rozdziela kwestie mechaniki eksportu, kosztów wzbogacania danych, ograniczeń konta i walidacji. Nasz syntetyczny test z 15 października 2026 pokazuje, dlaczego nawet udane pobranie pliku wymaga kontroli.
Najważniejsze fakty
- Nasz syntetyczny test wykorzystał 1 000 fikcyjnych rekordów kontaktów.
- Oba testowane formaty zawierały po 1 050 sparsowanych wierszy po wstrzyknięciu duplikatów.
- Deduplikacja po stałym ID wykryła 50 zduplikowanych wierszy.
- Każdy format zawierał 40 pustych wartości e-mail.
- Każdy format zawierał 20 niepoprawnie zapisanych wartości e-mail.
- Walidator zachował 940 unikalnych rekordów ze składniowo poprawnymi adresami e-mail.
Co tak naprawdę eksportuje apollo scraper?
Apollo scraper ma zamieniać informacje o prospektach w uporządkowane rekordy, ale sama nazwa nie mówi, jakie pola potrafi pobrać ani czy takie pobieranie jest autoryzowane. Oceń rzeczywisty wynik i sposób dostępu na tle warunków Apollo.
Rozdziel cztery rzeczy: informacje wyświetlane na ekranie, rekordy zapisane na koncie, dodatkowe wzbogacanie danych oraz obietnice dostawcy narzędzia. Zrzut ekranu wypełnionego profilu nie jest testem akceptacyjnym dla pobieranego zbioru danych.
Zanim wybierzesz oprogramowanie, zdefiniuj minimalny schemat: stałe ID kontaktu, imię i nazwisko, firma, stanowisko, e-mail, źródło i data zebrania. Pola opcjonalne oznacz osobno. Wymagaj wyjaśnienia brakujących wartości zamiast traktować pustą komórkę jako dowód, że dana informacja nie istnieje.
Dane kontaktowe różnią się też od dowodu zainteresowania zakupem. Jeśli faktycznie potrzebujesz identyfikować sygnały zakupowe, zajrzyj do naszego poradnika o zbieraniu danych o intencjach zakupowych B2B.
Potrzebujesz apollo scrapera czy oficjalnego eksportu Apollo?
Wybierz najprostszą autoryzowaną drogę, która spełnia Twoje wymagania co do wyniku. Zanim kupisz narzędzie lub zaplanujesz zadanie cykliczne, wykonaj ten 4-krokowy test gotowości do eksportu.
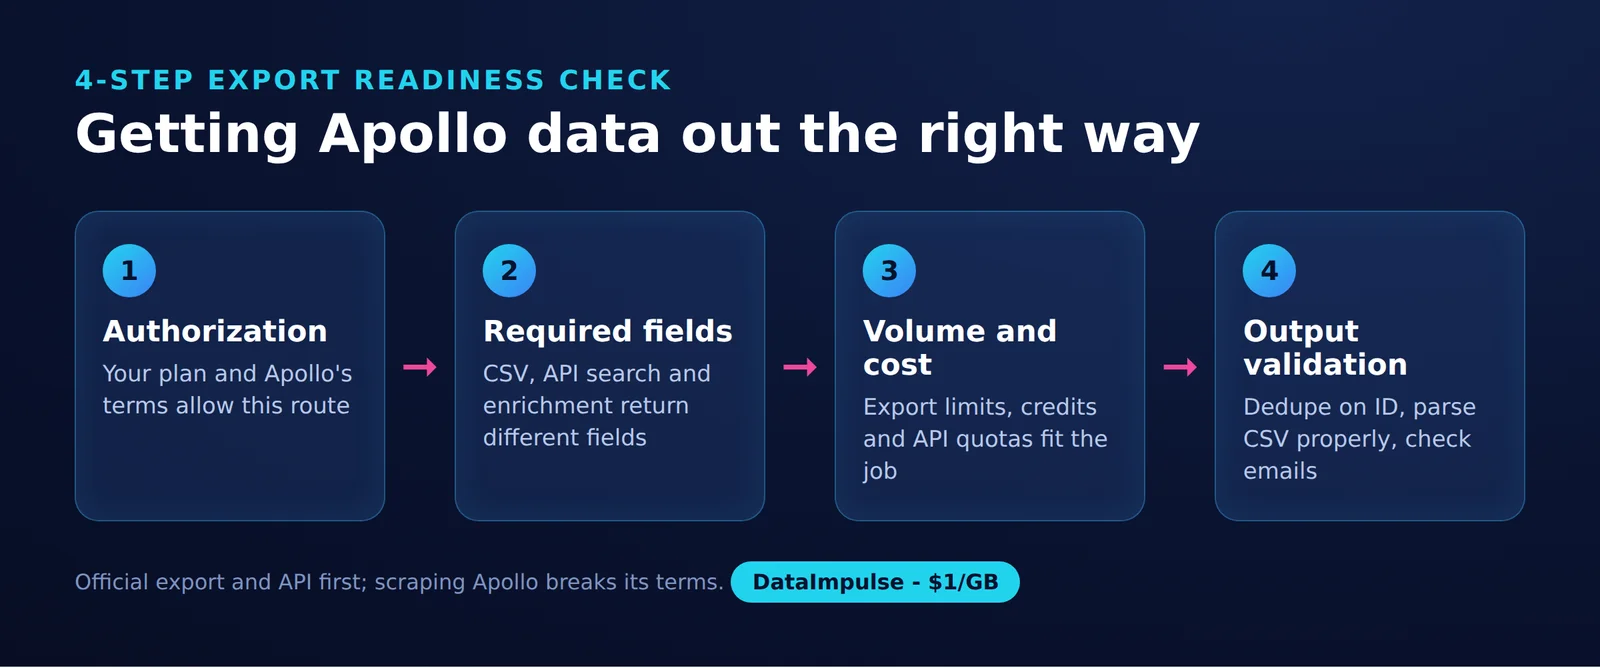
- Krok 1: Autoryzacja. Ustal, kto jest właścicielem konta, kto może z niego korzystać i czy planowane pobieranie oraz dalsze wykorzystanie danych są dozwolone.
- Krok 2: Wymagane pola. Określ niezbędne kolumny i akceptowalny poziom braków. Pobieranie danych trzymaj osobno od próśb o dodatkowe informacje.
- Krok 3: Wolumen i koszt. Oszacuj liczbę unikalnych, użytecznych kontaktów, częstotliwość odświeżania, kredyty, opłaty dostawcy i czas potrzebny na utrzymanie.
- Krok 4: Walidacja wyniku. Przed importem przetestuj parsowanie, stałe ID, duplikaty, składnię e-maili i pochodzenie danych.
| Opcja | Używaj X, gdy… | Unikaj X, gdy… |
|---|---|---|
| Natywny CSV | Używaj natywnego CSV, gdy wystarczają okazjonalne autoryzowane eksporty. | Unikaj natywnego CSV, gdy cykliczna integracja wymaga automatyzacji. |
| Oficjalne API | Używaj oficjalnego API, gdy udokumentowany dostęp obejmuje wymagane pola i wolumen. | Unikaj oficjalnego API, gdy wymagany dostęp lub budżet są niedostępne. |
| Narzędzie firmy trzeciej | Używaj narzędzia firmy trzeciej, gdy autoryzacja i sposób obsługi danych są udokumentowane. | Unikaj narzędzia firmy trzeciej, gdy wymaga obchodzenia zabezpieczeń lub przekazania cookies sesji. |
| Proxy | Używaj proxy, gdy dozwolone zewnętrzne zadanie zbierania danych wymaga routingu. | Unikaj proxy, gdy celem jest obejście ograniczeń Apollo. |
Jak wyeksportować kontakty przez Apollo?
Leady z Apollo możesz wyeksportować bez scrapingu narzędziami firm trzecich, korzystając z natywnego procesu CSV. Eksport zapisanych kontaktów nie zużywa kredytów (stan na październik 2026), ale eksport istniejących rekordów nie wzbogaca automatycznie adresów e-mail ani numerów telefonów komórkowych. Postępuj zgodnie z instrukcją eksportu CSV od Apollo.
- Otwórz Search, następnie People, i zastosuj filtry, zapisane wyszukiwanie lub listę.
- Zaznacz kontakty i wybierz Export.
- Wybierz e-maile wszystkich zaznaczonych kontaktów albo tylko zweryfikowane e-maile.
- Sprawdź ustawienia eksportu i uwzględnij wymagane pola.
- Wybierz Export records, a po zakończeniu zadania kliknij Download.
W przypadku zupełnie nowych osób Apollo zapisuje rekordy przed eksportem, a każda nowa osoba ze zweryfikowanym adresem e-mail zużywa jeden kredyt. Pusta kolumna może wynikać z ustawień eksportu, więc zanim uznasz, że potrzebne jest wzbogacanie danych, sprawdź wybór pól.
Oryginalny plik zachowaj bez zmian. Obok oczyszczonej kopii zapisz czas eksportu, kryteria wyboru i docelowe miejsce w CRM. Dzięki temu łatwiej będzie wyjaśnić późniejsze rozbieżności.
Kiedy warto użyć API Apollo?
API Apollo może zastąpić ręczne pobieranie danych, jeśli udokumentowany dostęp obejmuje Twój proces. People API Search nie zwraca adresów e-mail ani numerów telefonów i ma limit wyświetlania 50 000 rekordów (stan na październik 2026), dlatego samo wyszukiwanie nie wystarczy do stworzenia pliku z kontaktami e-mail. Zobacz dokumentację People API Search.
Udokumentowany endpoint wyszukiwania to POST /api/v1/mixed_people/api_search. Jego paginacja pozwala na 100 rekordów na stronę i maksymalnie 500 stron, a dokumentacja odsyła do people enrichment lub bulk people enrichment po dodatkowe dane kontaktowe.
Przed wdrożeniem upewnij się, że konto się kwalifikuje, i sprawdź uprawnienia klucza. Wyszukiwanie, wzbogacanie, walidację i ładowanie do CRM traktuj jako osobne operacje, każdą z własną obsługą błędów.
Zapisuj postęp po udanych stronach, deduplikuj przed zleceniem wzbogacania i zadbaj o to, by import można było bezpiecznie powtarzać bez tworzenia zduplikowanych kontaktów. Zaplanuj przechowywanie kluczy, ponawianie żądań, zmiany schematu i monitoring. Filtrów używaj do określenia docelowej grupy odbiorców, a nie do obchodzenia limitów.
Jakie limity i koszty obowiązują?
Wielkość zaznaczenia, kredyty danych, limity żądań i opłaty firm trzecich to osobne ograniczenia. Limity API Apollo zależą od endpointu i planu (stan na październik 2026), więc nie ma jednego limitu żądań odpowiedniego dla każdej integracji. Sprawdź dokumentację limitów żądań.
- Zaznaczenie: Sprawdź, co Twoje konto pozwala zaznaczyć i wyeksportować.
- Kredyty: Ustal, która czynność jest płatna i jakie dane zwraca.
- Żądania: Planuj liczbę wywołań niezależnie od liczby kontaktów.
- Opłaty dostawcy: Uwzględnij subskrypcje, przetwarzanie, przechowywanie i czas pracy inżynierów.
Dokumentacja cennika API Apollo rozróżnia endpointy zużywające kredyty i ostrzega, że powtarzane żądania lub paginacja mogą zwiększyć zużycie. Zanim oszacujesz większe zadanie, zweryfikuj uprawnienia konta i przetestuj niewielkie autoryzowane żądanie.
Porównuj koszt przypadający na zachowany unikalny rekord, a nie na pobrany wiersz. Uwzględnij czas czyszczenia i odrzucone rekordy. Jeśli potrzebne pola nadal są niedostępne, rozważ inne źródło danych, korzystając z naszego poradnika o dostawcach danych B2B.
Jak oceniać darmowe rozszerzenia i narzędzia w chmurze?
Zanim zwrócisz uwagę na szybkość lub cenę, oceń autoryzację i sposób obsługi danych. Apollo ogranicza zautomatyzowane pobieranie danych oraz obchodzenie limitów użycia (stan na październik 2026), z wyjątkiem funkcji wyraźnie dołączonych do usługi lub pisemnej zgody na zautomatyzowany dostęp. Jego warunki ograniczają też publikowanie benchmarków platformy bez uprzedniej pisemnej zgody.
W przypadku darmowego apollo scrapera, rozszerzenia przeglądarki, porównania Scrupp i Thunderbit albo rozwiązania opartego na Apify stosuj tę samą listę kontrolną i nie zakładaj, że sama nazwa produktu daje zgodę:
- O jakie uprawnienia przeglądarki, dane logowania lub dostęp do sesji prosi to narzędzie?
- Jakie dowody potwierdzają autoryzację jego metody zbierania danych?
- Gdzie rekordy są przetwarzane, przechowywane i usuwane?
- Czy próbka zachowuje ID, źródła i rozróżnienie między różnymi rodzajami braków?
- Co dzieje się z rozliczeniami i przechowywanymi danymi po rezygnacji?
Odrzucaj procesy, które wymagają udostępnienia cookies sesji lub obejścia zabezpieczeń. Nasz poradnik o narzędziach do lead scrapingu daje szerszy kontekst oceny.
Dostęp przez API nie rozstrzyga zobowiązań dotyczących prywatności ani kontaktu z odbiorcami. Wytyczne ICO dotyczące pozyskiwania leadów wyjaśniają, że publicznie dostępne informacje nadal wymagają rzetelnego, zgodnego z prawem i przejrzystego traktowania. Obowiązujące zasady kontaktu, polityki prywatności i listy wykluczeń sprawdzaj osobno, niezależnie od zgody wynikającej z umowy.
Co zrobić w przypadku blokad, błędów 403 i 429?
Zanim ponowisz żądanie, zdiagnozuj odpowiedź. Kod 403 oznacza, że serwer odmawia wykonania żądania, a 429 wskazuje na zbyt wiele żądań.
W przypadku 403 sprawdź treść odpowiedzi, dane uwierzytelniające, uprawnienia i żądaną operację. Jeśli proces nie ma autoryzacji, przerwij go. Wielokrotne próby z innych kont lub adresów nie rozwiążą tego problemu.
Apollo dokumentuje okna limitów oraz odpowiedź retry-after przy błędach 429 związanych z limitem żądań na endpoint (stan na październik 2026). Postępuj zgodnie z jego wskazówkami dotyczącymi odzyskiwania po przekroczeniu limitu, odczekaj podany czas i ogranicz liczbę równoległych zadań.
Zapisuj znacznik czasu, endpoint, status i ewentualny identyfikator żądania, nie przechowując przy tym sekretów. Niewyjaśnione awarie zgłaszaj administratorowi konta lub do wsparcia, dołączając minimalne żądanie pozwalające je odtworzyć. Ustaw limit ponowień, aby nieudane zadanie nie mogło działać w nieskończonej pętli.
Jak zwalidować wyeksportowane dane?
Przed importem poprawnie sparsuj format, zdeduplikuj dane po stałym ID i sprawdź wymagane pola. Nasz test z 15 października 2026 wykazał identyczne liczby w kategoriach jakości rekordów w CSV i JSON, mimo różnych rozmiarów plików.
Ten test na systemie Linux wykorzystał Python 3.12.3 i seed 20261015: 1 000 fikcyjnych kontaktów z adresami example.com, a następnie 50 zduplikowanych wierszy. Osobne rekordy zawierały 40 pustych e-maili i 20 niepoprawnie zapisanych e-maili, 100 nazw firm zawierało przecinki, a 40 stanowisk zawierało osadzone znaki nowej linii. Nie użyto żadnych kont, prawdziwych danych osobowych ani scrapingu narzędziami firm trzecich.
| Format | Data uruchomienia | Python | Sparsowane wiersze | Unikalne ID | Zduplikowane wiersze | Puste e-maile | Niepoprawne e-maile | Zachowane unikalne poprawne rekordy | Bajty |
|---|---|---|---|---|---|---|---|---|---|
| CSV | 2026-10-15 | 3.12.3 | 1 050 | 1 000 | 50 | 40 | 20 | 940 | 71 313 |
| JSON | 2026-10-15 | 3.12.3 | 1 050 | 1 000 | 50 | 40 | 20 | 940 | 132 977 |
Źródło: nasz test z 15 października 2026. Zachowane 940 rekordów to 89,5% wierszy wejściowych. JSON zajął około 1,9 raza więcej bajtów niż CSV. Naiwne dzielenie po znakach nowej linii i przecinkach naliczyło 1 093 pozorne wiersze, ponieważ osadzone znaki nowej linii tworzyły fałszywe granice, a przecinki w cudzysłowach również rozbijały kolumny.
To syntetyczny dowód dotyczący formatu i walidacji, a nie benchmark Apollo, test dostarczalności ani pomiar rzeczywistej jakości leadów.
Poniższy samodzielny generator i walidator odtwarza liczby wad i generuje skróty SHA-256 dla wygenerowanych plików testowych. Uruchomiliśmy go 15 października 2026: odtwarza liczby z tabeli powyżej (1 050 wierszy, 1 000 ID, 50 duplikatów, 40 pustych, 20 niepoprawnych, 940 zachowanych).
import csv
import hashlib
import json
import random
import re
import sys
from pathlib import Path

SEED = 20261015
rng = random.Random(SEED)
rows = []
for i in range(1, 1001):
    email = f'person{i}@example.com'
    if 101 <= i <= 140:
        email = ''
    elif 141 <= i <= 160:
        email = f'person{i}.example.com'
    rows.append({
        'id': str(i),
        'name': f'Person {i}',
        'company': f'Example Co {i}, Inc.' if i <= 100 else f'Example Co {i}',
        'title': 'Sales\nManager' if i <= 40 else 'Manager',
        'email': email,
    })
duplicate_indexes = [0, 1, 2] + rng.sample(range(160, 1000), 47)
rows.extend(dict(rows[i]) for i in duplicate_indexes)
rng.shuffle(rows)

with open('synthetic.csv', 'w', encoding='utf-8', newline='') as f:
    writer = csv.DictWriter(f, fieldnames=list(rows[0]))
    writer.writeheader()
    writer.writerows(rows)
Path('synthetic.json').write_bytes(
    json.dumps(rows, ensure_ascii=True, indent=2).encode('utf-8')
)

# Deliberately narrow syntax check for these fictional fixtures.
pattern = re.compile(r'[^\s@]+@[^\s@]+\.[^\s@]+')
def validate(records):
    seen, usable = set(), set()
    blank = malformed = duplicates = 0
    for row in records:
        ident, email = row['id'], row['email'].strip()
        duplicates += int(ident in seen)
        seen.add(ident)
        if not email:
            blank += 1
        elif not pattern.fullmatch(email):
            malformed += 1
        else:
            usable.add(ident)
    return (len(records), len(seen), duplicates, blank, malformed, len(usable))

print('Python:', sys.version.split()[0], 'seed:', SEED)
print('Counts: rows, IDs, duplicates, blank, malformed, retained')
manifest = {}
for filename in ('synthetic.csv', 'synthetic.json'):
    path = Path(filename)
    if path.suffix == '.csv':
        with path.open(encoding='utf-8', newline='') as f:
            parsed = list(csv.DictReader(f))
    else:
        parsed = json.loads(path.read_text(encoding='utf-8'))
    counts = validate(parsed)
    assert counts == (1050, 1000, 50, 40, 20, 940)
    raw = path.read_bytes()
    manifest[filename] = {
        'bytes': len(raw),
        'sha256': hashlib.sha256(raw).hexdigest(),
    }
    print(filename, counts)
print(json.dumps(manifest, indent=2))
Zapisz kod jako export_quality.py i uruchom go w pustym katalogu roboczym:
python3 --version
python3 export_quality.py > validation-results.txt
W plikach produkcyjnych rekordy o tym samym ID, ale z konfliktującymi wartościami, poddawaj kwarantannie zamiast po cichu je nadpisywać. Zachowuj znaczniki czasu źródła i zapisuj powody odrzucenia. Przykład sprawdza wyłącznie prostą składnię, nie potwierdza istnienia skrzynki ani zgody. Zagadnienia na dalszych etapach znajdziesz w materiałach o masowej weryfikacji adresów e-mail oraz testowaniu dostarczalności e-maili.
Jaką rolę odgrywa proxy w autoryzowanym procesie?
Proxy nie przyznaje limitów eksportu Apollo ani nie gwarantuje ochrony przed ograniczeniami konta. Routing sieciowy nie zmienia Twoich uprawnień wynikających z umowy, a dozwolony dostęp i obchodzenie zabezpieczeń reguluje regulamin Apollo.
Proxy może się sprawdzić w osobnym, dozwolonym zadaniu zbierania danych, które wymaga kontrolowanego routingu. Zanim dodasz taką infrastrukturę, udokumentuj zgodę serwisu docelowego, wymagania geograficzne i spodziewany ruch.
DataImpulse dostarcza infrastrukturę proxy, a nie API do scrapingu, zarządzanego unblockera, VPN ani dostawcę danych kontaktowych. Dodanie proxy nie uzupełni brakującego adresu e-mail, nie naprawi uszkodzonego CSV ani nie stworzy praw dostępu. Zanim wybierzesz infrastrukturę sieciową, rozstrzygnij kwestie danych i autoryzacji.
Najczęściej zadawane pytania
O co warto poprosić przed zakupem scrapera leadów z Apollo?
Poproś o autoryzowany przykładowy eksport, słownik pól i opis metody zbierania danych. Zanim udzielisz dostępu, wymagaj warunków przechowywania i usuwania danych.
Czy darmowy apollo scraper to z pewnością najtańsza opcja?
Nie. Porównując koszty, uwzględnij czyszczenie danych, nieudane zadania, przegląd bezpieczeństwa i utrzymanie. Mierz koszt przypadający na użyteczny, unikalny kontakt.
Czy do importu do CRM wybrać CSV, czy JSON?
Wybierz format, który Twój system docelowy przyjmuje niezawodnie. Nasz syntetyczny test dał identyczne liczby walidacyjne w obu formatach, więc sam format pliku nie poprawił jakości rekordów.
Czy składniowo poprawny e-mail oznacza, że mogę dotrzeć do tej osoby?
Nie. Kontrola składni sprawdza tylko, czy adres pasuje do struktury akceptowanej przez walidator. Nie potwierdza ani dostępności skrzynki, ani zgody na wysyłanie marketingu.
Dlaczego deduplikować po ID, a nie po nazwie?
Nazwy mogą się powtarzać lub zmieniać. Stałe ID ze źródła daje lepszą podstawę do dopasowywania powtarzanych eksportów, a konfliktujące wartości nadal wymagają przeglądu.
Czy wyniki syntetyczne pozwalają przewidzieć wydajność eksportu z Apollo?
Nie. Test oceniał parsowanie i walidację fikcyjnych plików, bez kontaktu z Apollo. Nic nie mówi o szybkości platformy, zasięgu danych ani rzeczywistej dokładności kontaktów.
Dopasuj infrastrukturę routingu do dozwolonego zadania
Jeśli Twój proces obejmuje autoryzowane zewnętrzne zbieranie danych wymagające routingu przez proxy, poznaj residential proxy DataImpulse. Infrastrukturę wybieraj dopiero po potwierdzeniu uprawnień i wymagań co do wyniku.
Ostatnia aktualizacja: 15 października 2026.