
In this Article
Thunderbit to AI web scraper, który zamienia treść stron internetowych w uporządkowane tabele bez pisania kodu do ekstrakcji, według jego oficjalnej strony, sprawdzonej 15 października 2026 roku. Przy niewielkim, autoryzowanym zadaniu typu strona do arkusza warto go przetestować, zanim zaczniesz budować własny scraper.
W praktyce liczy się to, czy wynik jest dokładny, ile kredytów pochłonie całe zadanie i gdzie odbywa się wykonanie. Nasz test z 15 października 2026 roku mierzy też osobne obciążenie sieci w rozwiązaniu DIY, aby pokazać, co obejmuje zakup proxy.
Najważniejsze fakty
- Oszacuj nakład pracy na podstawie liczby wierszy wyniku, wzbogacania danych i powtórnych uruchomień.
- Udany eksport nadal wymaga sprawdzenia dokładności.
- W naszym teście z 15 października 2026 roku pobrano 1 000 wierszy z produktami.
- Nasze sekwencyjne uruchomienie w piaskownicy zarejestrowało zero nieudanych żądań.
- Szacunkowy koszt ruchu sieciowego wyniósł około $0,0026.
- Ten pomiar to migawka, a nie benchmark Thunderbit.
Czym jest Thunderbit i dla kogo jest przeznaczony?
Thunderbit sprawdzi się u osób z działów sprzedaży, operacji i badań, które potrzebują tabel ze stron internetowych. Jego oficjalny przewodnik po produkcie, sprawdzony 15 października 2026 roku, opisuje rozszerzenie przeglądarki, które analizuje stronę, proponuje kolumny i wyodrębnia wyniki.
Zacznij od oficjalnej strony Thunderbit, na której znajdziesz link do instalacji, a następnie zaloguj się w rozszerzeniu. Dzięki temu nie pomylisz scrapera z produktami o podobnych nazwach.
Dobrym pierwszym zadaniem jest publiczna lista produktów z wyraźnie widocznymi nazwami, cenami i linkami. Przed ekstrakcją zdefiniuj, co oznacza jeden wiersz: jeden produkt, jeden wariant czy jedną ofertę. Struktura wygenerowana przez AI nadal wymaga przeglądu, zwłaszcza gdy kolumna streszcza lub interpretuje treść. Tę różnicę omawiamy w naszym artykule o AI web scraping.
Czy Thunderbit jest darmowy i jak działają kredyty?
Thunderbit oferuje darmowy limit sześciu stron miesięcznie, z maksymalnie 30 kredytami na stronę (stan na październik 2026). To dwa osobne ograniczenia, zgodnie ze stroną z cennikiem dostawcy, sprawdzoną 15 października 2026 roku.
Wyjaśnienie kredytów od dostawcy podaje, że standardowe wiersze wyniku zużywają jeden kredyt, a wiersze wzbogacone o podstrony dwa (stan na październik 2026). Dodatkowe operacje wlicz do budżetu osobno i nie zakładaj, że każda funkcja wzbogacania korzysta ze stawki za podstrony.
Miesięczny plan Starter kosztuje $15 za 500 kredytów miesięcznie. Roczny Starter to $9 miesięcznie przy rozliczeniu rocznym, z 5 000 kredytów rocznych przyznawanych z góry. Miesięczny plan Pro zaczyna się od $38 za 3 000 kredytów miesięcznie (stan na październik 2026). Źródło: strona z cennikiem dostawcy, sprawdzona 15 października 2026 roku.
Poniższe obliczenia zakładają standardową ekstrakcję, chyba że wskazano wzbogacanie. Wydatek na subskrypcję to coś innego niż przypisanie części istniejącego limitu do zadania.
| Zadanie | Obliczone kredyty | Znaczenie dla budżetu |
|---|---|---|
| 500 wierszy z produktami z list | 500 | Mieści się w miesięcznym Starterze: wydatek na subskrypcję $15. |
| 500 wierszy ze wzbogacaniem o podstrony | 1 000 | Mieści się w miesięcznym Pro: wydatek na subskrypcję $38; przekracza miesięczny Starter. |
| 5 000 standardowych wierszy co miesiąc | 5 000 miesięcznie; 60 000 rocznie | Przekracza podstawowy limit miesięcznego Pro; poproś o cenę dla większej pojemności. |
Wszystkie dane w tabeli pochodzą ze strony z cennikiem dostawcy i z wyjaśnienia kredytów, sprawdzonych 15 października 2026 roku (stan na październik 2026); sumy kredytów to nasze obliczenia. Roczny Starter kosztuje $108 z góry: przypisanie całego jego limitu daje $10,80 za pierwsze zadanie lub $21,60 za drugie, ale żadna z tych kwot nie jest samodzielną ceną zakupu.
Pełny roczny limit dostępny od razu nie jest miesięcznym odnawianiem. Zanim wybierzesz rozliczenie roczne, oszacuj powtórne uruchomienia i sprawdź warunki zamówienia pod kątem promocji, zmiany planu i wyczerpania kredytów.
Jak wyeksportować stronę do Arkuszy Google?
Zdefiniuj pola, wyodrębnij małą próbkę, sprawdź wyniki, a potem autoryzuj eksport do arkusza. Oficjalny przewodnik po Arkuszach Thunderbit, sprawdzony 15 października 2026 roku, opisuje autoryzację konta Google i wybór miejsca docelowego.
Wybierz źródło i kolumny. Otwórz stronę, z której masz prawo zbierać dane. Wskaż pola, takie jak nazwa produktu, wyświetlana cena, tekst o dostępności i URL źródła. Zachowaj oryginalne wartości, zanim zaczniesz je przekształcać.
Uruchom małą ekstrakcję. Nowszy oficjalny przewodnik używa opcji One Click Extract i Run Now, a przewodnik po Arkuszach opcji AI Suggest Fields i Scrape. Kieruj się interfejsem, który widzisz, bo dokumenty używają różnych nazw.
Zweryfikuj tabelę. Porównaj kilka wierszy z ich stronami źródłowymi. Sprawdź walutę, brakujące wartości, zduplikowane produkty i to, czy cena promocyjna nie wyparła ceny regularnej. Tabela, która wygląda wiarygodnie, może nadal zawierać błędne powiązania.
Autoryzuj i wyeksportuj. Wybierz Export, następnie Google Sheets, połącz właściwe konto Google i wybierz lub utwórz miejsce docelowe. Przed udzieleniem dostępu przejrzyj żądane uprawnienia.
Sprawdź miejsce docelowe. Porównaj liczbę wierszy i sprawdź, czy w identyfikatorach nie zniknęły początkowe zera. Zachowaj URL źródła i datę zbierania, aby ktoś inny mógł zweryfikować wynik. Podobne podejścia znajdziesz w naszym przewodniku po scrapingu w arkuszach.
Jak paginacja, podstrony i cykliczne uruchomienia wpływają na przepływ pracy?
Każdy z tych elementów rozszerza pracę poza pierwszą widoczną tabelę. Thunderbit opisuje paginację, wzbogacanie danych z połączonych stron i zaplanowaną ekstrakcję w swoim przewodniku po produkcie, sprawdzonym 15 października 2026 roku.
Paginacja przechodzi przez kolejne strony list, a podstrony dodają informacje z pojedynczych stron szczegółów. Zanim włączysz jedno lub drugie, zdefiniuj warunek zatrzymania i sprawdź ostatnią stronę. W przeciwnym razie poprawna próbka może ukryć brakujące rekordy lub powtórzone oferty.
Cykliczne zadania mnożą budżet na ekstrakcję. Zbieranie 500 standardowych wierszy dziesięć razy oznacza planowanie 5 000 wierszy wyniku, nawet jeśli w końcowym arkuszu zostanie tylko najnowsza wersja.
Zanim zaufasz uruchomieniom bez nadzoru, potwierdź zakres paginacji w swoim planie, limit harmonogramu, częstotliwość i okres przechowywania. Sprawdź też, czy powtarzane eksporty dopisują, zastępują czy w inny sposób aktualizują miejsce docelowe. Nie wnioskuj o tym zachowaniu na podstawie udanego jednorazowego eksportu.
Co zmienia się między scrapingiem w przeglądarce a w chmurze?
Miejsce wykonania zmienia kontekst sesji dostępny dla scrapera. Oficjalne wyjaśnienie trybu przeglądarki i chmury od Thunderbit, sprawdzone 15 października 2026 roku, mówi, że tryb przeglądarki korzysta z aktywnej sesji przeglądarki, a tryb chmury obsługuje publiczne strony i nie przenosi tej sesji.
Do oceny użyj autoryzowanej, publicznej strony i porównaj uzyskane pola. Sprawdź treści zależne od lokalizacji oraz to, czy pełna lista jest widoczna w każdym środowisku wykonania.
Samo ustawienie przeglądarki nie dowodzi, jak zdalne zadanie kieruje żądania. Jeśli Twoja organizacja wymaga określonej ścieżki sieciowej lub lokalizacji wykonania, rozstrzygnij to, zanim zaplanujesz zadania produkcyjne.
Czy możesz używać własnych proxy i co się dzieje, gdy żądania zawodzą?
W oficjalnych materiałach sprawdzonych 15 października 2026 roku nie udało nam się potwierdzić udokumentowanej konfiguracji własnego proxy dla rozszerzenia. Zgodność pozostaje więc nierozstrzygnięta, ale nie oznacza to niezgodności.
Zapytaj wsparcie, czy wymagany przez Ciebie tryb wykonania akceptuje zewnętrzny endpoint proxy i jak można zweryfikować routing. Oddziel to pytanie od kwestii, czy dostawca zarządza siecią wewnętrznie.
Gdy uruchomienie się nie powiedzie, najpierw ustal etap: dostęp do strony, ekstrakcja czy eksport. Zapisz URL, czas, widoczny błąd i to, czy zwykłe, autoryzowane przeglądanie nadal działa. Brakujące kolumny po udanym załadowaniu strony wymagają innego dochodzenia niż odrzucone żądanie.
Proxy nie gwarantuje dostępu i nie naprawi błędnej logiki ekstrakcji. Zanim zmienisz infrastrukturę, przeczytaj nasz przewodnik o błędach scrapingu i blokowaniu. DataImpulse sprzedaje dostęp do sieci; nie jest to API do scrapingu, zarządzany unblocker ani VPN, a ten artykuł nie potwierdza żadnej integracji z Thunderbit.
Co pokazał nasz kontrolowany test sieciowy?
Nasz test z 15 października 2026 roku oszacował ruch sieciowy dla prostej ekstrakcji DIY na około $0,0026. To migawka jednego obciążenia w piaskownicy, a nie benchmark Thunderbit.
O 16:12 UTC użyliśmy Pythona z bibliotekami requests i BeautifulSoup, aby sekwencyjnie pobrać 50 stron z listami z serwisu Books to Scrape, publicznej piaskownicy do scrapingu. Żądania przechodziły przez rotujące residential proxy DataImpulse z USA; parser zbierał pola z tytułem, ceną i dostępnością.
| Pomiar | Zaobserwowany wynik |
|---|---|
| Próbka | 50 stron z listami |
| Sparsowane wiersze z produktami | 1 000 |
| Nieudane żądania | 0 |
| Czas wykonania | 18,4 sekundy |
| Szacunkowa ilość przesłanych danych | Około 2,59 MB |
| Szacunkowy koszt ruchu przy $1/GB | Około $0,0026 |
Źródło: nasz test z 15 października 2026 roku. HTML dotarł bez kompresji; szacunek transferu obejmuje szacunkowe nagłówki. Przy jednostkach dziesiętnych 2,59 MB podzielone przez 1 000 i pomnożone przez $1 daje $0,00259.
Rzeczywiste rozliczenie proxy obejmuje cały ruch, w tym TLS i nagłówki, więc ten szacunek nie jest pomiarem z faktury. Test pomija zasoby przeglądarki, renderowanie JavaScript, wzbogacanie o podstrony i powtarzane próby na innych witrynach.
Usługa residential proxy zaczyna się od $1 za GB. To kupuje warstwę sieciową. Czas inżynierów nadal jest potrzebny, aby pisać selektory, obsługiwać paginację, weryfikować wyniki i utrzymywać scraper; tych godzin nie mierzyliśmy. Przy małych zadaniach no-code uniknięcie tej pracy może uzasadniać subskrypcję.
Kiedy warto wybrać alternatywę?
Wybieraj według tego, za jaką część pracy chcesz odpowiadać: walidację, ustrukturyzowany dostęp czy utrzymywany potok ekstrakcji. Skorzystaj z tej macierzy decyzyjnej, zanim zaczniesz porównywać ceny z nagłówków.
| Opcja | Wybierz X, gdy… | Unikaj X, gdy… |
|---|---|---|
| Thunderbit | Wybierz Thunderbit, gdy jego udokumentowany przepływ ekstrakcji i eksportu pasuje do małego, zweryfikowanego zadania. | Unikaj Thunderbit, gdy wymagane mechanizmy routingu lub kontroli wykonania pozostają niezweryfikowane. |
| Oficjalne API/eksport | Wybierz oficjalne API/eksport, gdy autoryzowany ustrukturyzowany dostęp spełnia wymagania. | Unikaj oficjalnego API/eksportu, gdy wymagane pola lub uprawnienia są niedostępne. |
| Własny scraper z proxy | Wybierz własny scraper z proxy, gdy potrzebujesz kontroli nad routingiem i możesz utrzymywać kod ekstrakcji. | Unikaj własnego scrapera z proxy, gdy oczekujesz, że proxy wyodrębni dane lub zagwarantuje dostęp. |
Aby szerzej rozejrzeć się po rynku, zajrzyj do naszego porównania AI web scraperów. Porównuj całkowity nakład pracy na jeden użyteczny zbiór danych, wraz z przeglądem i utrzymaniem, zamiast traktować kredyty różnych dostawców jako wymienne.
Jak zweryfikować przepływ pracy przed skalowaniem?
Użyj 4-krokowej kontroli dopasowania przepływu pracy, aby zamienić udaną próbkę w praktyczną decyzję operacyjną. Przechodź dalej tylko wtedy, gdy każdy krok ma jasną odpowiedź.
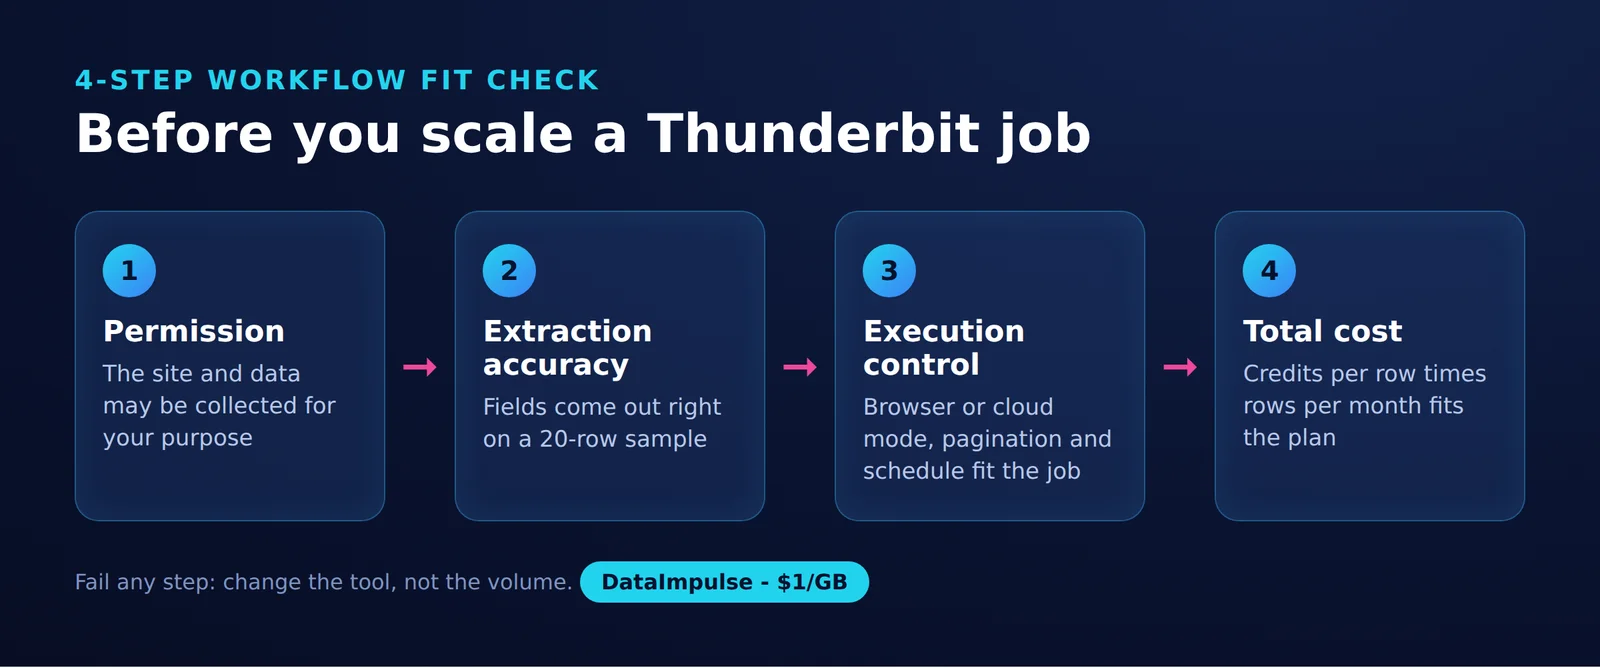
Krok 1: Zgoda. Potwierdź uprawnienia do źródła, zamierzonego zbierania danych i miejsca docelowego. Sam dostęp do strony nie rozstrzyga wszystkich kwestii uprawnień.
Krok 2: Dokładność ekstrakcji. Porównaj próbkę rekordów ze źródłem. Zdefiniuj dopuszczalną liczbę brakujących pól i duplikatów oraz zachowaj URL pozwalające na prześledzenie danych.
Krok 3: Kontrola wykonania. Potwierdź potrzeby dotyczące sesji, lokalizację wykonania, zachowanie harmonogramu i wymagany routing. Nierozstrzygnięte wymaganie potraktuj jako powód do ograniczenia pilotażu.
Krok 4: Całkowity koszt. Policz wiersze, wzbogacanie, powtórne uruchomienia, czas przeglądu i utrzymanie. Ustal limit wydatków i wskaż, kto bada niekompletne wyniki.
Najczęściej zadawane pytania
Czym jest Thunderbit i jak wyodrębnia dane?
Thunderbit analizuje treść strony internetowej i porządkuje wybrane informacje w kolumnach tabeli. Jego oficjalna strona, sprawdzona 15 października 2026 roku i podlinkowana powyżej, opisuje ten przepływ od przeglądarki do arkusza; użytkownicy nadal powinni weryfikować wyodrębnione wartości.
Czy Thunderbit jest darmowy?
Tak. Oficjalna strona z cennikiem podaje sześć stron miesięcznie, z maksymalnie 30 kredytami na stronę (stan na październik 2026), sprawdzone 15 października 2026 roku. Traktuj ten limit jako budżet pilotażowy, a nie nieograniczoną ekstrakcję.
Jak wyeksportować wyniki do Arkuszy Google?
Oficjalny przewodnik po Arkuszach, sprawdzony 15 października 2026 roku i podlinkowany powyżej, każe wybrać Google Sheets podczas eksportu i autoryzować swoje konto Google. Sprawdź konto docelowe i przejrzyj powstały arkusz, zanim go udostępnisz.
Czy Thunderbit może używać mojego własnego proxy?
Konfiguracja własnego proxy pozostaje niezweryfikowana w sprawdzonych przez nas oficjalnych materiałach. Poproś o potwierdzenie dla konkretnego trybu wykonania, zanim kupisz infrastrukturę pod taką integrację.
Czy proxy mogą zapobiec każdej blokadzie scrapingu?
Żadne proxy nie gwarantuje udanego dostępu. Zmiana sieci nie naprawi też brakujących pól, niedokładnego parsowania ani błędu autoryzacji eksportu.
Który przepływ pracy wybrać?
Zacznij od autoryzowanego oficjalnego eksportu, jeśli zawiera wymagane pola. Przetestuj Thunderbit w małym zadaniu z arkuszem i rozważ własny kod, gdy kontrola nad wykonaniem uzasadnia bieżące utrzymanie.
Potrzebujesz kontroli nad siecią dla własnego scrapera?
Jeśli Twój przepływ pracy wymaga własnego kodu i kontroli nad routingiem, rozważ DataImpulse jako warstwę sieciową. Oszacuj ruch na podstawie małego, autoryzowanego testu, a potem osobno zaplanuj budżet na ekstrakcję, walidację i utrzymanie.
Ostatnia aktualizacja: 15 października 2026 roku.