
In this Article
AI drapanie stron przekroczyło punkt zwrotny w 2026 – podział rynku pomiędzy użytkowymi API gotowych LLM- (Firecrawl, Olostep, Crawl4AI) i przedpokoleniowe generalne scrapery wyposażone w funkcje ZAI (Apify, Octoparse, Browse AI, ScrapingBee, ScraperAPI, ZenRows). Dla zespołów danych budujących rurociągi RAG, dostęp do sieci web agenta,Fine- tuning zestawów danych, lub konkurencyjnych korporacji wywiadowczych, pytanie nie jest już “powinniśmy użyć narzędzia scrating”, ale “które narzędzie kształt danych, anty-bot postawy, i model cen pasuje do naszego potoku LLM?” Common Crawl + Firecrawl + Apify Aktorzy są jednym z największych źródeł publicznych danych internetowych płynących do szkoleń AI i systemów RAG dzisiaj; Bright Data wygrał Meta vBright Data (Jan 2024) ustanawiająca precedens w zakresie przetwarzania danych publicznych, na którym opiera się cały przemysł; Reddit pozwała Anthropic (June 2025) i Perplexity (Październik 2025) za nielicencjonowane skrobanie, sygnalizując, że umowy wydawców są rzeczywistą ekspozycją prawną – nie CFAA, nie scratingnarzędzie.
Ten przewodnik przegląda 10 najbardziej używanych w AI scrappers web w 2026, rozbija ZLLM-gazociąg wyrównania, modele cenowe i anty-bot możliwości, przechodzi tam, gdzie każde narzędzie wygrywa, i wyjaśnia, gdzie proxy infrastructure (warstwa pod każdym scrapper) decyduje, czy program kolekcji wagi lub stragany. Przejdź do szybkie porównanie dla trzydziestej drugiej krótkiej listy.
Kluczowe fakty
AI rynek skrobania stron w 2026 ma unikalną dynamikę warto wiedzieć przed wybraniem narzędzia. Pięć rzeczy do poznania z góry:
- LLM- gotowe wyjście > surowe HTML. Modern AI scrappers (Firecrawl, Crawl4AI, Olostep, Spider.cloud) przekonwertować strony internetowe do czyszczenia markdown lub strukturyzowane JSON gotowe do osadzenia, RAG spożycie lub model fine- tuning. Firecrawl twierdzi, że jego marża wykorzystuje ~67 o% mniej żetonów niż surowe HTML – bezpośrednio istotne, jeśli płacisz za nią OpenAI / Anthropic. Apify, ScrapingBee,ScraperAPI) zwraca HTML / JSON i wymaga dalszego przetwarzania.
- Modele cenowe podzielone na trzy obozy. Stawka ryczałtowa na stronę / kredyt (Firecrawl ~ $0.0008/scrape at scale, Olostep credit-based), compute- based (Apify ~ $0.20- $0.30/compute unit + Actor rental + proxy passthrough), oraz Per- żądanie z mnożnikami (ScrapingBee, ScraperAPI, ZenRows, Decodo Scraping API – JS rendering i premium proxy mogą pomnożyć koszt proxy 5 × -75 ×). Koncepcja jest najtrudniejsza do przewidzenia; stopa ryczałtowa jest najprostsza.
- Antyrobot to prawdziwa brama. 2024- 2025: Bright Data ~98% średni wskaźnik sukcesu (100% na Indeed, Zillow, Capterra, Google). ZenRows + Decodo + Bright Data + Zyte zawierają domyślnie obejście antybotowe; Firecrawl, Apify, ScrapingBee oferują go jako add- on lub wyższy poziom. Dla celów twardych (Cloudflare / Akamai / ZZPROTECT18Z- chronionestron), możliwość bajpasu ma większe znaczenie niż szerokość funkcji.
- Open- source ma większe znaczenie w 2026. Crawl4AI (open- source, AI- native, LangChain / LlamaIndex integrations) i Scrapy + Playwright stealth stosy zyskały udział w porównaniu z zarządzanymi API, ponieważ zespoły ML ściągnęły do domu łupanie dla IP- przyczyny audytu pochodzenia ZZPROTECT7Z-. Hand- off jest warstwa proxy – scrapers open- source potrzebują surowej infrastruktury proxy pod spodem.
- Publiczne skrobanie jest legalne, umowy nie są – i Reddit zmienił wszystko. Bartz / Anthropic (Jun 23, 2025) + Kadrey / Meta (Jun 25, 2025) potwierdzone szkolenie w zakresie publicznych danych internetowych jest sprawiedliwe. Meta PRZECIWKO Bright Data (Jan 23, 2024) potwierdzone pobranie danych publicznych jest CFAA- safe + ToS- safe. Ale Reddit przeciwko Anthropic (Jun 2025), Reddit przeciwko Perplexity + Oxylabs (październik2025), Stack Overflow + Cloudflare pay- per- crawl (Feb 2026) oraz protokół RSL (Sep 2025, 1,500+ wydawcy) zlecił wydawcy zawarcie nowej ekspozycjiwarstwa. Legalne wybrzeże jest jaśniejsze; wybrzeże umowy jest trudniejsze.
Jak wybraliśmy te AI Web Scrappers
Wybraliśmy te narzędzia 10, ponieważ mają one wiarygodne zastosowanie w zakresie produkcji w 2026, publicznej przejrzystości cen, udokumentowane przypadki użycia AI / LLM (produkcja znacznikowa, ekstrakcja JSON-LD, punkty końcowe dotyczące danych strukturalnych, integracja LangChain / LlamaIndex, wsparcie agent- MCP) oraz rzeczywisty pas na łańcuchu wartości ZAI- potoku – od samego źródła (Crawl4AI) dozarządzane API przedsiębiorstwa (Bright Data Web Scraper, Oxylabs). Narzędzia bez opublikowanych cen, ze złymi twierdzeniami marketingowymi 2024-era, lub bez historii integracji AI-gazociągu zostały wycięte. Testujemy scrappers regularnie na reprezentatywnej AI-workflow targets (Reddit, Stack Overflow, news, Wikipedia, GitHub, e-commerce catalogs) w celu zatwierdzenia gazociągu ZLLM-roszczenia.
Co sprawia, że dobry AI Web Scraper?
Silny skaner sieci AI dla 2026 rozwiązuje cztery problemy naraz. LLM- gotowa struktura wyjściowa – markdown lub strukturyzowane JSON jest dramatycznie tańsze do spożycia w wektor DBs i LLM okna kontekstowe niż surowe HTML; narzędzia, które nie wysyłają ZLLM- wyjście dodać krok czyszczenia, który kosztuje czas inżynierii i pertoken wydać. bajpas anty-bot bez osobnego zakupu proxy – dla najtrudniejszych celów (Cloudflare / Akamai / ZZPROTECT2Z- chronione), scraper albo obejścia lub przynieść proxy na boku; podejście połączone oszczędza czas operacji, Bring- your- własne podejście oszczędza pieniądze na objętości. Przewidywalne ceny dostosowane do modeli kosztów LLM – ryczałtowa stawka na stronę bije compute- oparty na kontroli budżetowej, zwłaszcza, gdy koszty niższego szczebla LLM jest również per- token; składanie mnożników (JS rendering + premium proxy + retry- on- fail) sprawiają, że ceny oparte na Compute- based nieprzezroczyste. Integracja z rest stosu LLM – native connects to LangChain, LlamaIndex, AI coding agents via MCP, structured- output schemas (Pydantic, Zod) – these matter more in 2026 than they did in 2024.
Szybkie porównanie: Najlepsze AI Web Scrappers at a Glance
| Narzędzie | Najlepiej dla | Wycena | Wyjście LLM- | Przeciw-bot |
|---|---|---|---|---|
| Firecrawl | RAG / ZZPROTECT1Z- gotowy markdown | $16/mo (kredyty 5K); $0.0008/scrape w skali | Markdown + JSON (rodzimy) | Dodawanie / wyższy poziom |
| Apify | Szerokość rynku (aktorzy 10K+) | Compute- based + Actor rent + proxy | HTML / JSON (po zakończeniu procesu) | Zróżnicowany aktor |
| Octoparse | Visual point- and- click, no-code | $69/mo Standard (roczny) | HTML / CSV (po zakończeniu procesu) | Built- in (na bazie template- based) |
| Browse AI | Numer kodu prompt- driven | $19/mo wpis | JSON | Autoadaptuje się |
| ScrapingBee | API | $49/mo Freelance | HTML / JSON | Dodawanie / wyższy poziom |
| ScraperAPI | Cele twarde (Amazon, Google) | $49/mo Hobby (kredyty 100K) | HTML / JSON, ustrukturyzowane punkty końcowe | Pozostałe |
| ZenRows | Bypass Cloudflare / DataDome / PerimeterX | Prośba + mnożniki | HTML / JSON | Związane (specjalność) |
| Crawl4AI | Open- source LLM- przyjazny | Free (self-host) | Markdown + JSON (rodzimy) | Przyprowadź własne. |
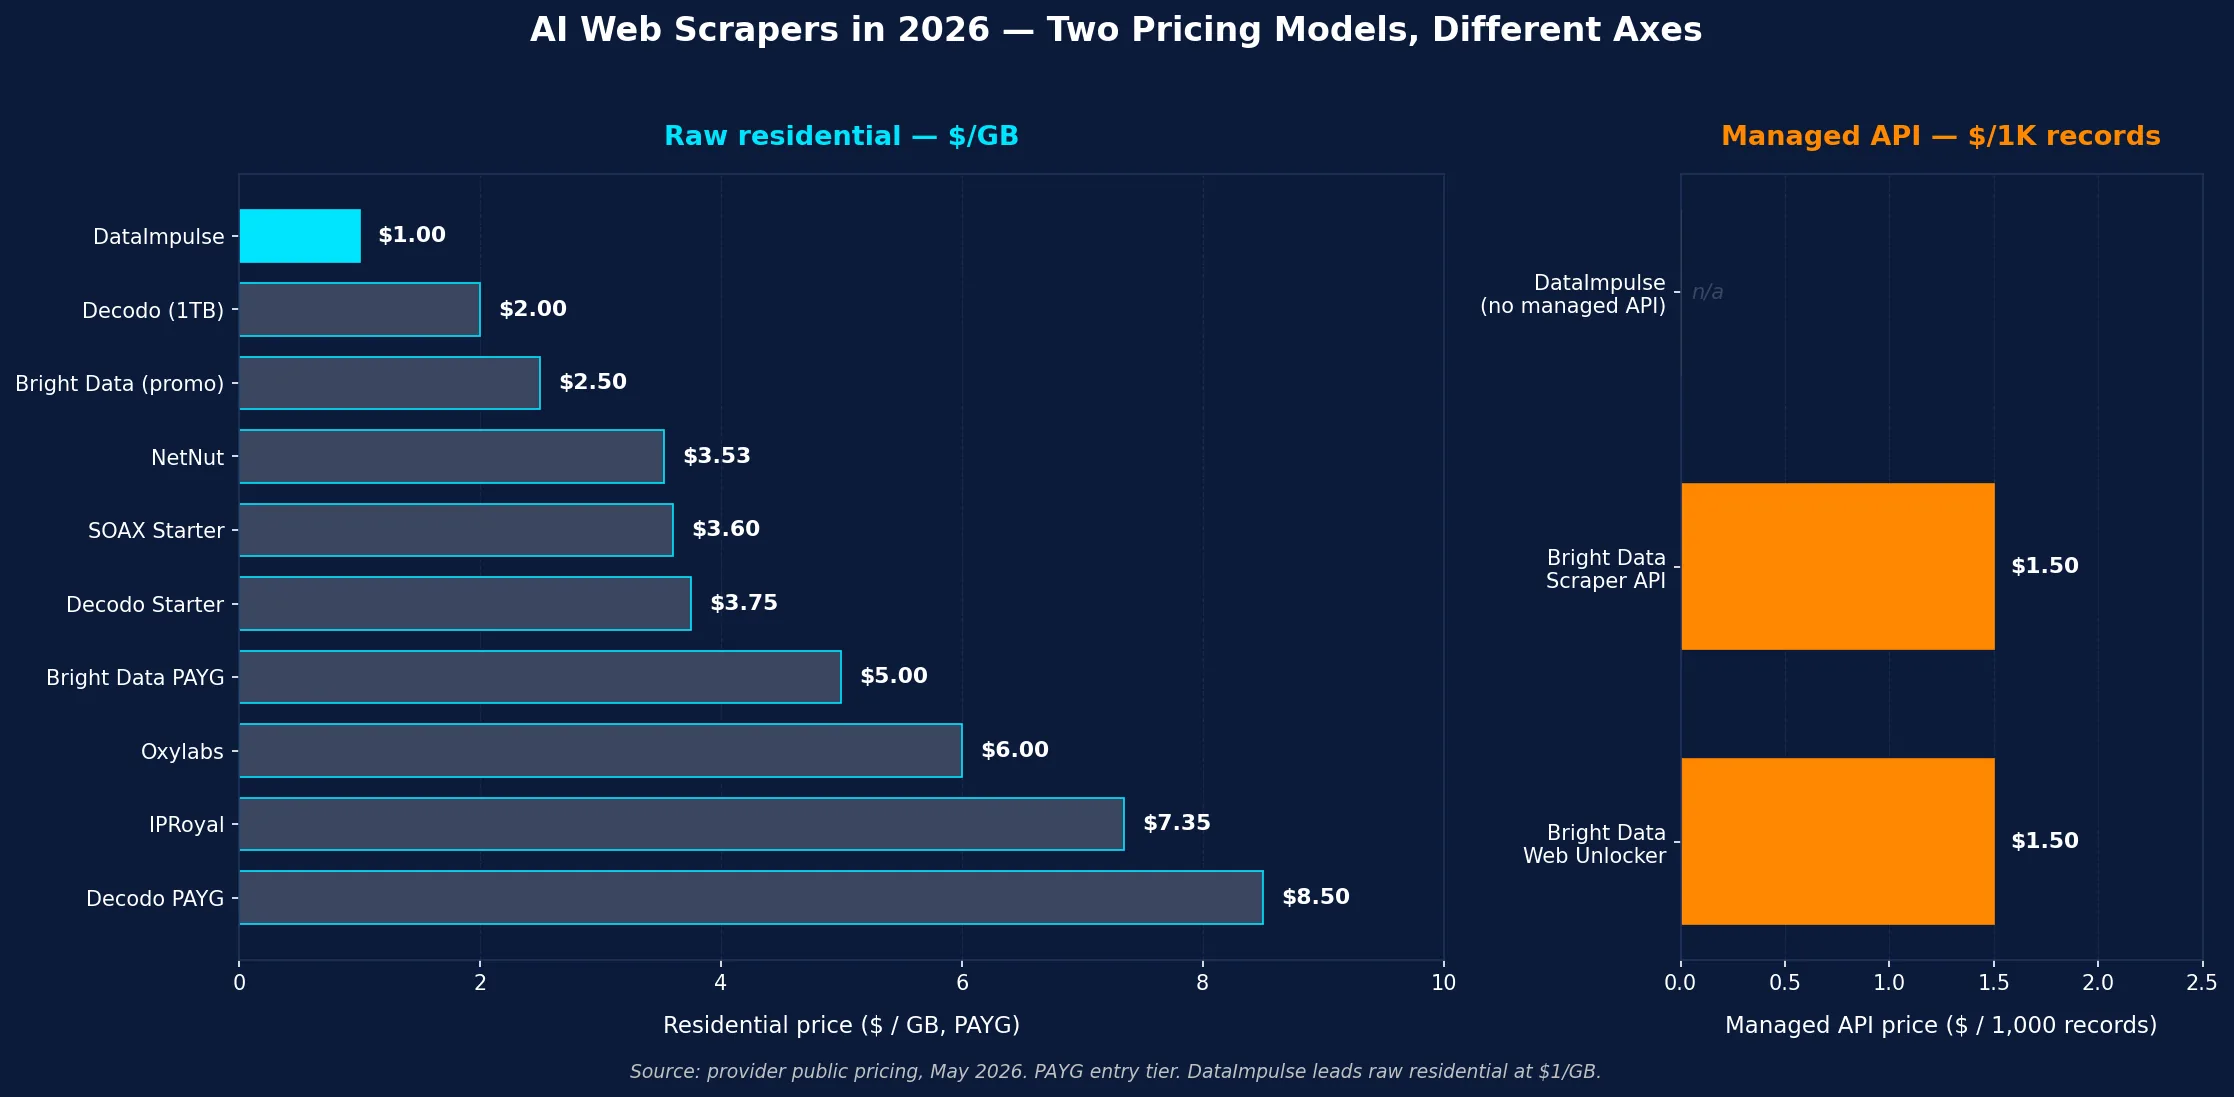
| Bright Data Web Scraper | Enterprise, najtrudniejsze cele | $1.50/1K odnotowuje PAYG (~ $1.30 na $499/mo) | JSON, ustrukturyzowane punkty końcowe | Związane (best- in- class) |
| Olostep / Spider.cloud | LLM- ready + open- source- friendly | Kredytowe, przejrzyste | Markdown + JSON | Pozostałe |
AI Scraper Lanes in 2026
AI zeskrobywanie stron internetowych w 2026 podzielone na pięć pasów ruchu; wybrać przy pasie zespołu, a nie przez liczbę funkcji.
Lane 1 – LLM-Ready API (specjalnie zbudowany dla AI)
Najnowszy i szybko rosnący pas: skrobacze, które istnieją specjalnie do karmienia LLM. Firecrawl jest liderem pasa ruchu – wyjście markdown, obsługa serwera MCP-, LangChain + LlamaIndex rodzimej integracji, twierdził 67% redukcji żetonów w porównaniu do surowego HTML. Olostep, Spider.cloudoraz fastCRW wszystkie grać w tym pasie z podobnych AI-pierwszy projekt produktu. Crawl4AI jest grą open- source z tą samą propozycją wartości. Wybierz ten pas, jeśli wyjście jest bezpośrednio do wektora RAG DB lub agenta okno kontekstowe.
Lane 2 – Marketplace + Actor Ecosystem
Apify dominuje tym pasem z wcześniej zbudowanymi drapaczami 10,000+ (“Aktorzy”) dla określonych celów (Amazon, LinkedIn, TikTok, Instagram, Twitter/X, Reddit itp.). Ceny oparte na obliczeniach są trudniejsze do przewidzenia, ale szerokość rynku oznacza, że większość wspólnych celów ma już utrzymany scraper. Wybierz Apify, jeśli potrzebujesz scrapers dla wielu różnych stron i nie chcesz budować każdy z nich.
Lane 3 – Nr kodu / Visual Builders
Octoparse (wizualna aplikacja na pulpit wskazów- i- click, $89/mo Standard, template- napędzany dla popularnych stron), Browse AI (prompt- driven AI selection, $19/mo entry, auto- adapts wmomencie zmiany miejsc), Bardeen Przewodniczący (AI automatyzacja z web extractor, freemium). Wybierz ten pas, jeśli Twój zespół nie zawiera inżynierów wygodne z Playwright / Scrapy.
Lane 4 – Programista zarządzanych API (cel ogólny)
ScrapingBee ($49/mo Freelance), ScraperAPI ($49/mo Hobby, 100K creds; special structured- data endpoints for Amazon / Google / Walmart), ZenRows (specjalność obwodnicy Cloudflare / DataDome / PerimeterX), Decodo API $19/mo). Ogólny cel, perrequest cena, z mnożnikami dla JS renderowania i premium proxy. Wybierz ten pas dla twardych celów o umiarkowanej objętości.
Lane 5 – Skraplacze zarządzane przez przedsiębiorstwa
Bright Data (Reddit / Stack Overflow / news / social / LinkedIn / Amazon; $1.50/1K rejestruje PAYG, ~ $1.30/1K na planie $499/mo; najlepszy wskaźnik sukcesu ~98%). Oxylabs (wpis $49/mo, stopień SLA-, ISO 27001 + SOC 2). Zyte (specjalność w celach chronionych). Wybierz ten pas dla najtrudniejszych celów w skali przedsiębiorstwa + gotowe do kontroli zgodności.
Najlepsze AI Web Scrappers – pełne opinie
Poniższe typy są uszeregowane według wartości potoku AI- markdown / JSON, integracji LLM- stosu, sukcesu anty-bot, przewidywalnych cen, i dynamiki 2026. Narzędzia wygrywają różne pasy ruchu; wybieraj przez obciążenie pracą, nie przez ogólną rangę.
1. Firecrawl
Firecrawl jest liderem w dziedzinie zeskrobywania gotowych LLM-. URL przekształca każdą sieć URL w czyste markdown lub strukturyzowane ZJSON gotowe do umieszczenia w gazociągach RAG, z żądaniem 67% mniej żetonów niż surowe HTML (istotne: koszt symbolu jest Twoim rachunkiem LLM). Native LangChain + LlamaIndex integration, MCP server for AI codes (Claude)Code, Cursor), built- in PDF extraction, JavaScript rendering on Hobby + tiers, and a transparent 1- credit- per- page pricing model starting at $16/mo for 5,000 creds. Nieudane wnioski nie zużywają kredytów – znacząca właściwość zarządzania kosztami w skali, gdzie powtórzenia są powszechne. Przy głośności koszt zeskrobywania kompresji ~ $0.0008. 1 chronionycele (Cloudflare / Akamai / PerimeterX) jest na wyższych poziomach lub jako add- on; dla najtrudniejszych celów nadal może być konieczne pary z surowcemProxy.
Szybkie specyfikacje – Wyjście: markdown + strukturyzowane JSON (rodzime ZZPROTECT1Z- gotowe) · Cena: 1 kredyt = 1 strona; $16/mo dla 5K kredytów; ~ $0.0008/scrape w skali · Anti- bot: uwzględniony na wyższych poziomach / Hobby posiada podstawowe · Integracje: LangChain, LlamaIndex, ZMCP (Claude Code / Cursor), ZPython / ZPROTECT11ZZ SDKs · Open- source: ZAPI klient klient + niektóre składniki open- source,produkt hostingowy płatny.
Najlepiej dla: RAG gazociąg spożycie, LLM agent dostęp do sieci Web, montaż zbioru danych, gdzie markdown wyjście oszczędza koszty token.
2. Apify
Apify jest rynkiem 10,000+ wstępnie zbudowane drapacze (“Aktorzy”) dla celów szczegółowych – Amazon, LinkedIn, Reddit, TikTok, Instagram, Twitter/X, serwisy informacyjne, handel elektroniczny, nieruchomości, miejsca pracy. Każdy aktor jest niezależnie utrzymywany (przez Apify + społeczności), z opłat za wynajem na Aktora na dodatek do korzystania z obliczeń. Ceny oparte na kosztach: ~ $0.25/CU na poziomie startowym $49, $0.40/CU na poziomie pay- as-you- go (spada do $0.16 / $0.13 w wyższej objętościTiers) + Actor rental + proxy passthrough (Apify łączy swój własny basen mieszkalny lub można BYO). Szerokość rynku jest nieporównywalna – większość wspólnych celów ma już roboczy scraper, więc czas inżynieryjny idzie do integracji, a nie parserbuilding. Handel-off: ceny są najtrudniejsze do przewidzenia w przestrzeni AI- scraper. JS rendering + premium proxy + retryonfail compoundwydatki na obliczenia; budżetowanie wymaga ostrożnej oceny per- Actor. W przypadku przypadków szerokiego zastosowania lub zespołów pierwszego zastosowania, wartość rynkowa Apify jest trudna doBeat.
Szybkie specyfikacje – Wyjście: HTML, JSON, CSV w zależności od Aktora · Cena: na bazie porównawczej ~ $0.25- $0.40/CU (w niższej skali: $0.16- $0.13) + per- Actor rental + proxy passthrough · Anti- bot: per- Actor (niektóre połączone, niektóre BYO proxy) · Integracje: Python / Node ZSDKs, webhaki, zaplanowane operacje, MCP integracja w beta · Open- source: ZApify ZSDKjest open- source.
Najlepiej dla: zespoły, które potrzebują scrapers w wielu różnych miejscach i wolą nie budować każdego.
3. Octoparse
Octoparse jest wizualny wskaż i kliknij no- kod scrapper – aplikacja pulpitu, gdzie kliknij przez stronę docelową, aby określić, co do wydobycia, ze scrappers szablon utrzymywane dla popularnych celów (Amazon, eBay, Twitter, nieruchomości stron, itp.), że auto- aktualizacji, gdy te strony zmieniają swój układ. $69/mo Standardowy plan (rozliczany co roku; ~ $119 w odniesieniu do rozliczeń miesięcznych) z cenami ryczałtowymi dla setektysiące stron, bez przestronnych pomiarów – przewidywalne dla wysokiej głośności nie-AI- specyficznych przepływów pracy. Wykonanie w chmurze dostępne; built- in anti- bot dla obsługiwanych celów szablonu. Trade- off: wyjście jest HTML / CSV / Excel domyślnie, nie ZZPROTECT7Z-gotowy markdown – trzeba będzie po-przetwarzania krok do czyszczenia LLM do spożycia. Jeśli Twój zespół jest nietechniczny lub jesteś marketing / badania orgktóre potrzebują uporządkowanych danych bez inżyniera, Octoparse jest najłagodniejszym uczeniem sięKrzywa.
Szybkie specyfikacje – Wyjście: CSV, Excel, JSON, HTML (post-process needed for LLM) · Cena: $69/mo Standard (coroczne; ~ $119/mo miesięcznie); płaska cena, brak przestronnych pomiarów · Antybot: built- in dla celów szablonu · Integracje: API dostęp na wyższych poziomach · Open- source: zamknięty.
Najlepiej dla: nietechniczne zespoły; budowniczowie wizualni; struktura- ekstrakcja danych dla BI / analityka gdzie LLM wyjście nie jest bramka.
4. Browse AI
Browse AI jest prostym no- kodem AI scrapper – można opisać w prostym języku angielskim, co chcesz wydobyć, AI generuje scrapper, i samoadaptuje się, gdy miejsca docelowe się zmieniają. Poziom wejścia $19/mo – wśród najtańszych skrobali AI. Autoadaptacją jest mechanizm różnicujący: kiedy miejsce docelowe zmienia układ, Browse AI AI ponownie identyfikuje elementy bez CiebieZmieniam konfigurację. Produkcja ma strukturę JSON. Browse AI jest kosztowne na modelu kredytowym Browse AI; dla setek tysięcy stron, ScrapingBee / ScraperAPI / Firecrawl przewyższa go. Najlepsze dla zespołów nietechnicznych działających w trybie dziennym / tygodniowymstron internetowych.
Szybkie specyfikacje – Output: structured JSON · Pricing: $19/mo entry tier, credit- based · Anti- bot: auto- adapts; built- in · Integrations: API, webhacks, Zapapier · Open- source: closed.
Najlepiej dla: nietechniczne zespoły prowadzące structured-extraction workflow na znanych miejscach docelowych; szybkie prototypowanie.
5. ScrapingBee
ScrapingBee jest developer-friendly zarządzany API – czysta dokumentacja, oficjalna Python i Node ZSDKs, JavaScript rendering na wszystkich planach, mieszkaniowych i premierowych-proxy add- on, Perrequest cennik począwszy od $49/mo Freelance plan. Rynki same w sobie są łatwe w obsłudze i jasne dokumenty, a nie posiadają szerokość. JS rendering 5 ×,premium proxy 25 ×, screenshot 50 ×) sprawiają, że efektywna perpage koszt znacznie wyższy niż podstawa; budżet na górnym końcu. Wyjście to HTML / JSON, nie rodzime LLMmarkdown.
Szybkie specyfikacje – Wyjście: HTML + JSON, BeautifulSoup- przyjazne · Cena: $49/mo Freelance; perrequest with multimilliers (JS 5 ×, premium 25 ×) · Antibot: built- in on higher tiers · Integrations: Python + Node SDKs, simple ZREST · Open- source: closed.
Najlepiej dla: zespoły deweloperskie, które chcą czystego zarządzanego API dla celów obrony umiarkowanej.
6. ScraperAPI
ScraperAPI specjalizuje się w najtrudniejszych celów handlu elektronicznego z dedykowane punkty końcowe danych strukturalnych – punkt na Amazon ASIN, odzyskać obiekt produktu JSON; podobnie dla Google SERP, Walmart, eBay. $49/mo Hobby plan z 100,000 kredytów dla prostych stron HTML, więcej dla punktów końcowych premii. Bundled anty-bot dla celów specjalnych, basen mieszkalny zawarte. Lane: Special managed API for e- commerce + SERP. Handel-off: pozacel strukturalny-punkt końcowy, jest to scraper żądanie podobne do ScrapingBee z podobnychmnożniki.
Szybkie specyfikacje – Wyjście: HTML + strukturyzowane JSON dla celów specjalnych (Amazon, Google SERP, Walmart, eBay) · Ceny: $49/mo Hobby (kredyty 100K); strukturyzowane punkty końcowe wyższe koszty · Antybot: połączone dla celów specjalnych · Integracje: Python SDK + ZREST · Open-source: zamknięte.
Najlepiej dla: Cena e-commerce-tracking, Amazon / Walmart / Google SERP w skali, gdzie ustrukturyzowane punkty końcowe oszczędzają czas parsowania.
7. ZenRows
ZenRows specjalizuje się w bajpas anty-bot – omijanie Cloudflare, DataDome, PerimeterX (obecnie HUMAN Security) i podobnych przedsiębiorstw WAF stosy. Perrequest cennik with multimilliers, JS rendering on all plans, premium- proxy bonded. Na podstawie wskaźnika referencyjnego 2024 z grudnia, ZenRows osiągnął wskaźnik sukcesu 51% z 15.4s czas odpowiedzi na wnioski $4.62/1K w sprawie twardych celów – solidne, ale paczka średnia vsBright Data Lane: Special managed API for hard- defense targets where general scrapers stall. APILane.
Szybkie specyfikacje – Output: HTML + JSON · Pricing: perrequest with multimilliers · Anti- bot: separed, specialy in Cloudflare / DataDome / PerimeterX · Integracje: Python SDK + REST · Open- source: closed.
Najlepiej dla: cele obrony twardej (Cloudflare / PerimeterX- chronione), w przypadku których nie udaje się uzyskać ogólnych scraperów.
8. Crawl4AI
Crawl4AI jest źródłem otwartym i wolnym – czołowy czołg AI- rodzimy open-source crawler, zaprojektowany specjalnie dla rurociągów RAG i zespołu danych szkoleniowych LLM. Zwraca czysty markdown + ustrukturyzowany JSON, pochodzący z LangChain i LlamaIndex, JavaScript rendering poprzez Playwright, ekstrakcja oparta na schematach (Pydantic / Zod), screenshot capture, wsadź. Self-host, więc jedynym kosztem jest infrastruktura(Playwright + proxy + obliczenia). Dla zespołów ML, które potrzebują ścieżki audytu IP- prinenance NYT- v- OpenAI Styczeń 2026 orzeczenie, odkrycie danych szkoleniowych jest nową powierzchnią ekspozycji) lub chcą pełnej kontroli nad rurociągiem, Crawl4AI jest właściwym wyborem. Trade- off: można przynieść warstwę anty-bot (Playwright stealth + proxy mieszkaniowe); za darmo, aż do rozliczenia proxyBill.
Szybkie specyfikacje – Wyjście: markdown + strukturyzowane JSON (rodzime ZZPROTECT1Z-ready) · Ceny: wolne, samodzielnie hostowane · Anti- bot: bring- your- own (Playwright stealth + residential proxy) · Integrations: LangChain, LlamaIndex, MCP, niestandardowy ZPython · Open- source: y( ZApache 2.0).
Najlepiej dla: ML zespoły, które chcą pełnej kontroli + IP-prinenance ścieżki audytu + za darmo w skali (tylko koszty proxy).
Ile kosztują AI Web Scrapers?
Cena w 2026 mieści się w czterech pasmach:
- Darmowe źródło open- – Crawl4AI, Scrapy, Playwright. Koszt = twój rachunek za podsłuch + proxy.
- Zarządzanie budżetem ($16- $49/mo) – Firecrawl Hobby ($16), Browse AI entry ($19), Decodo Scraping API ($19), Octoparse Freelance, ScrapingBee Freelance ($49), ScraperAPI Hobby ($49).
- Średnia wartość ($49- $499/mo) – Apify Personal +, Octoparse Standard ($89), Browse AI mid- plans, Oxylabs Web Scraper API ($49+), ZenRows mid- plans.
- PERSONEL ($1.30- $1.50/1K + $499+/mo) – Bright Data Web Scraper API, Oxylabs enterprise, Zyte enterprise.
Prawdziwe pytanie dotyczące kosztów zeskrobywania AI nie jest “co jest najtańszym narzędziem”, ale “jaki jest najniższy koszt za zużywalny LLM- gotowy rekord na moich stronach docelowych na mojej głośności”. Przetestuj narzędzia 5Z10 przeciwko Twoim rzeczywistym celom i gazociągowi kolejnemu LLM; perpage-page cost difference between ZLLM- ready markdown scraper (Firecrawl) and raw- HTML scrapper (Octoparse, Apify generyc) shows up pheel cost in token cost, not just the scraper Bill.
Czy AI Web Scraping Legal?
Orzecznictwo 2025- 2026 radykalnie wyjaśniło prawo zeskrobania sieci AI – i drastycznie zmieniło powierzchnię ekspozycji. Podstawy:
- Szkolenie w zakresie publicznych danych internetowych jest sprawiedliwe (USA). Bartz przeciwko Anthropic (Jun 23, 2025, Judge Alsup) rządził szkoleniem na temat publicznych danych internetowych “niezwykle transformacyjnych” i sprawiedliwego wykorzystania w ramach 17 USC §107 – ale z wymiennikiem, że pobieranie Z~7M pirackich książek dla biblioteki Anthropic nie było sprawiedliwe. Kadrey przeciwko Meta (Jun 25, 2025, Judge Chhabria) orzekł w imieniu Meta, aleWyraźnie ostrzegano, że nie jest to szerokie AI- szkolenia-jest sprawiedliwy autorytet.
- Publiczne drapanie jest CFAA- bezpieczne. hiQ / LinkedIn (9th Cir. April 2022) + Meta / Bright Data (Jan 23, 2024) – publiczne, zablokowane pobieranie danych internetowych nie narusza ustawy o oszustwach komputerowych i nadużyciach.
- Umowy wydawnicze są nową warstwą ekspozycji. Reddit pozwał Anthropic (Jun 2025) i Perplexity + Oxylabs (Oct 2025) za nielicencjonowane skrobanie. Stack Overflow + Cloudflare uruchomił pay- per- crawl (Feb 2026). Protokół RSL (Sep 2025, wydawcy 1,500+) zawiera warunki licencyjne do odczytu maszynowego. Naruszenie Wydawcy ToS powoduje naruszenie umowy + narażenie na działanie tortu nawet wtedy, gdy CFAA jest bezpieczne. Jest to dokładnie wzór, który uderzył hiQ (CFAA-bezpieczne ZZ- pod 9th Circuit 2022 ‘s orzeczenie 2022, ale 2022 osada na podstawie prawa umów i stanu Kalifornii-tort).
- Dane osobowe uruchamiają równoległe prawo prywatności. RODO (UE), CCPA / CPRA (Kalifornia), LGPD (Brazylia), DPDP (Indie, stopniowo przez maj 2027), KVKK (Türkiye) wszystkie mają zastosowanie do korpusów szkoleniowych ZAI zawierających dane osobowe mieszkańców tych jurysdykcji. Rozbieraj dane osobowe; dokumentuj krok.
- Odkrycie produkcji jest prawdziwe. NYT przeciwko OpenAI (wyrok Jana 2026 SDNY): OpenAI został zmuszony do produkcji wszystkich dzienników 20M ChatGPT dla powodów. Production AI rurociągi powinny teraz zakładać ostateczne odkrycie – utrzymuj rejestry scrating, robot.txt- respect records, proxy- seller IP-printenance zaświadczenia, i dokumentacji licencji.
Szczere czytanie: szkolenie na temat publicznych danych internetowych jest prawnie chronione w 2026 w ramach Bartz / Kadrey + hiQ + Meta / Bright Data. Ekspozycja w ramach umowy wydawniczej (Reddit / SO / RSL sygnatariusze) jest rzeczywistą powierzchnią ryzyka. Skradanie danych osobowych jest najwyższym ryzykiem. Dostać US + EU + relevant- jurysdyction privacy + tech- transactions adwokat przed skalowaniem. To nie jest porada prawna.
Jak wybrać AI Web Scraper
Trzy etapy procesu decyzyjnego:
- Struktura wyjściowa. RAG gazociąg / agent kontekst → Firecrawl, Crawl4AI, Olostep, Spider.cloud (ZZPROTECT5Z- gotowy markdown rodzimy). Wydobycie danych ogólnych → Apify, Octoparse, Browse AI, ScrapingBee (po zakończeniu procesu). Cele specjalne (Amazon / Google / LinkedIn / Reddit) → Bright Data Web Scraper, ScraperAPI strukturyzowane punkty końcowe.
2. Antybot potrzebuje. Cele publiczne + niskiego poziomu ochrony (Wikipedia, Common Crawl, GitHub, arXiv, publiczne API) → Proxy danych + Crawl4AI lub tanich aktorów ZZPROTECT5Z-. Medium- defense (większość wiadomości, fora, katalogi e-commerce) → ScrapingBee / ScraperAPI / Firecrawl / Apify mieszkalnych. Hard targets (Cloudflare / Akamai / PerimeterX / HUMAN- protected) → ZenRows special, Bright Data Web Scraper,lub Crawl4AI + premium mieszkalnych.
3. Tom + budżet. < 10K strony / miesiąc → tanie zarządzane (Browse AI, Firecrawl Hobby, Decodo Scraping API). 10K- 1M strony / miesiąc → Zarządzanie średnimi poziomami (Firecrawl wzrost, ScrapingBee, ScraperAPI, Apify, Octoparse). 1M+ pages / month → enterprise managed (Bright Data per- record, Oxylabs) OR self-host Crawl4AI + DataImpulse residential at $1/GB.
Dla większości produkcji zespoły AI / ML w 2026, odpowiedź jest stos: Firecrawl dla RAG / LLM spożycie źródeł wysokiej jakości + Apify dla szerokiego rynku + Crawl4AI + DataImpulse mieszkalnych pod spodem dla samobudowanych rurociągów, które wymagają kontroli IP- i kontroli kosztów wolumenu + Bright Data Web Scraper dla garstki najtrudniejszych celów przedsiębiorstwa. Nie wybieraj jednego narzędzia, wybierz warstwowy stos.
Więcej na temat infrastruktury proxy pod spodem, zobacz nasz strona produktów proxy mieszkalnych, strona produktu datacenter proxy (dla warstw danych publicznych takich jak Common Crawl lusterka), najlepsze proxy dla ML i AI zbierania danych szkoleniowych oraz najlepsze proxy do skrobania stron internetowych Round up.
FAQ
Jaki jest najlepszy gazociąg AI dla rurociągów RAG w 2026?
Firecrawl jest liderem dla RAG – celowo zbudowany LLM- gotowy markdown wyjście, twierdzi Z~67% mniej żetonów niż surowe HTML (oszczędza na kosztach tokena), rodzimy LangChain + LlamaIndex integracje, MCP wsparcie serwera dla środków kodujących ZAI. $16/mo wpis, $0.0008/scrape w skali. Crawl4AI jest open- source alternatywą dla zespołów pragnących pełnej kontroli +Ścieżka audytu pochodzenia IP-.
Apify vs Firecrawl – który?
Apify wygrywa na szerokości rynku (10K+ Aktory obejmujące większość wspólnych celów) i jest właściwym wyborem, gdy potrzebujesz scrappers dla wielu różnych stron. Firecrawl wygrywa na osiowaniu rurociągów LLM-, przewidywalnych cen przestronnych i łatwości użytkowania dla RAG / środek spożywania. Dla najnowocześniejszych strumieni roboczych AI Firecrawl bije Apify na ROI; dla spuścizny ekstrakcji danych w wielustrony, Apify wygrywa. Wiele drużyn używa obu.
Czy Crawl4AI jest naprawdę wystarczająco dobry vs płatnych scrappers?
Tak, z jaskółkami. Crawl4AI jest open- source, AI- rodzimy, LangChain / LlamaIndex zintegrowany, zwraca markdown + JSON gotowy do LLM – i za darmo. Trade- off jest anty-bot: Crawl4AI działa przez Playwright stealth + cokolwiek proxy można wnieść, tak dla celów twardej obrony (Cloudflare / Akamai / PerimeterX) trzeba połączyć z proxy mieszkalne lub premium. Dla zespołów ML, które jużuruchomić proxy (DataImpulse dom mieszkalny w $1/GB) i chcą IP- szlak audytu pochodzenia, Crawl4AI jest prawoWybieraj.
Który ze skrobaczy AI ma najlepszy bajpas antybotowy?
Per Scrapeway 2024- 2025 benchmarks: Bright Data Web Scraper API at ~98% measure success rate, highing 100% on Indeed, Zillow, Capterra, Google. ZenRows specjalizuje się w bajpasie Cloudflare / DataDome / PerimeterX / HUMAN przy współczynniku powodzenia w pakiecie średnim. Dla większości zespołów, które nie potrzebują 98%, ScrapingBee + premium residential lub Firecrawlna wyższych poziomach obsługuje tier- 1 celów.
Czy AI jest zgodne z prawem?
Szkolenie na temat publicznych danych internetowych jest uczciwym wykorzystaniem w ramach Bartz przeciwko Anthropic (Jun 2025) + Kadrey przeciwko Meta (Jun 2025); publiczne skrobanie w ramach ZZPROTECT6Z- bezpieczny pod hiQ + Meta przeciwko Bright Data. Ale umowy wydawcy (Reddit ToS, Stack Overflow pay- per- crawl, RSL sygnatariusze) są wykonalne – Reddit pozwany Anthropic + Perplexity za nielicencjonowane skrobanie.Dane osobowe uruchamiają RODO / CCPA / LGPD / DPDP / KVKK. Zdobądź adwokata przed skalowaniem. To nie jest legalne.rady.
Jakie jest najtańsze AI web scrapper?
Crawl4AI (free, self-host) jest najtańszy, jeśli masz inżynierów do uruchomienia go + proxy pod spodem. Wśród zarządzanych API: Firecrawl ($16/mo, 5K), Decodo Web Scraping API ($19/mo), Browse AI wpis ($19/mo) są najtańszym poziomem budżetu. Dla kontroli kosztów wolumenu powyżej 1M strony / miesiąc, samodzielnie hostowane Crawl4AI + DataImpulse mieszkalnych w $1/GB uderzeńkażde zarządzane API.
Czy nadal potrzebuję proxy, jeśli używam zarządzanego skrobacza AI?
W przypadku zarządzanych w całości API (Bright Data Web Scraper, Oxylabs Web Scraper, Zyte, ZenRows, ScraperAPI), proxy są wliczone – nie kupujesz ich osobno. Dla skrobaków częściowych lub własnych (Apify z BYO, Firecrawl na niższych poziomach, Crawl4AI, Scrapy + Playwright stosy), proxy mieszkaniowe ($1/GB na DataImpulse) są warstwą podstawową. Wtrade- off: zarządzane API koszt $1.30- $1.50/1K rekordy all- in; samodzielnie zbudowany z surowych kosztów proxy ~ $0.50- $1/1K na objętość, ale wymaga inżynieriiCzas.
Jak zeskrobać Reddit + Stack Overflow bez wypalania mojego dostępu?
Dla Reddit i Stack Overflow w szczególności ścieżką prawną w 2026 jest: Reddit Data API (licencjonowane) lub Stack Overflow Stack Exchange API (ograniczone rate-). Nielicencjonowane skrobanie powoduje narażenie na naruszenie umowy – Reddit pozwała Anthropic (Jun 2025) i Perplexity + Oxylabs (Oct 2025). W przypadku konieczności zadrapania: residential lub ISP proxy (DataImpulse residential at$1/GB lub Decodo ISP at $0.27/IP) + wolne human- podobne kadencja + Playwright stealth. Lub korzystać z pakietu danych Bright Data z licencją Reddit (paid,).
Open- source vs zarządzane – kiedy przełączam?
Przełączanie na open-source (Crawl4AI, Scrapy, Playwright), gdy: a) prowadzisz strony 1M+ miesięcznie i zarządzanie- API koszty przekraczają czas inżynierii, aby utrzymać się na samoutrzymaniu; b) potrzebujesz ścieżki audytu IP-printenance (post- NYT-v- OpenAI Stycznia 2026 wydanie orzeczenia o odkryciu, szkolenie-ekspozycja na dane jest prawdziwe); c) Twój zespół potrzebuje pełnej kontroli nad kształtem danych i potoku. Zostańzarządzany, gdy: time- to- first-data ma znaczenie więcej niż koszt strony, Twój zespół nie ma Playwright / proxy ops pojemności, lub potrzebujesz SLA + posture zgodności (ISO 27001 + SOC 2) dozamówienia.
Gotowy do uruchomienia zeskrobywania stron AI z warstwą proxy, która działa pod dowolnym skanerem open- source (Crawl4AI, Scrapy, Playwright) lub w połączeniu z zarządzanymi API, które potrzebują BYO? Zacznij od DataImpulse – mieszkaniowe z $1/GB, datacenter z $0.50/GB, komórkowe z $2/GB, pay- as-you- iść z etycznie pozyskiwanych 90M+ IP w krajach 195, kraj docelowy w tym (stan / miasto / ZIP / ASN jako płatny add- on), ruch, który nigdy nie wygasa, i 24/7 Zhuman wsparcia.