
In this Article
การทำเว็บสแครปด้วย AI ผ่านจุดเปลี่ยนสำคัญในปี 2026 โดยตลาดแยกออกเป็น API ที่สร้างมาเพื่อรองรับ LLM โดยเฉพาะ (Firecrawl, Olostep, Crawl4AI) และเครื่องมือสแครปอเนกประสงค์รุ่นก่อนหน้าที่ปรับเพิ่มฟีเจอร์ AI ภายหลัง (Apify, Octoparse, Browse AI, ScrapingBee, ScraperAPI, ZenRows) สำหรับทีมข้อมูลที่สร้างไปป์ไลน์ RAG, การเข้าถึงเว็บของเอเจนต์, ชุดข้อมูลสำหรับ fine-tuning หรือคลังข้อมูลข่าวกรองการแข่งขัน คำถามไม่ใช่ “เราควรใช้เครื่องมือสแครปหรือไม่” อีกต่อไป แต่เป็น “รูปร่างข้อมูล, ท่าทีรับมือบอต และโมเดลราคาของเครื่องมือใดเหมาะกับไปป์ไลน์ LLM ของเรา?” Common Crawl + Firecrawl + Apify Actors เป็นหนึ่งในแหล่งข้อมูลเว็บสาธารณะขนาดใหญ่ที่สุดที่ไหลเข้าสู่ระบบฝึก AI และ RAG ในปัจจุบัน; Bright Data ชนะคดี Meta v Bright Data (Jan 2024) ซึ่งวางบรรทัดฐานการสแครปข้อมูลสาธารณะที่ทั้งอุตสาหกรรมอาศัย; Reddit ฟ้อง Anthropic (June 2025) และ Perplexity (October 2025) กรณีสแครปโดยไม่ได้รับอนุญาต ซึ่งชี้ว่าข้อตกลงกับผู้เผยแพร่คือความเสี่ยงทางกฎหมายที่แท้จริง ไม่ใช่ CFAA และไม่ใช่เครื่องมือสแครป
คู่มือนี้รีวิวเครื่องมือทำเว็บสแครปด้วย AI ที่ถูกใช้งานมากที่สุด 10 รายการในปี 2026 แจกแจงความสอดคล้องกับไปป์ไลน์ LLM, โมเดลราคา และความสามารถรับมือบอต อธิบายว่าแต่ละเครื่องมือได้เปรียบตรงไหน และอธิบายว่าโครงสร้างพื้นฐานพร็อกซี (ชั้นที่อยู่ใต้เครื่องมือสแครปทุกตัว) เป็นตัวตัดสินอย่างไรว่างานเก็บข้อมูลของคุณจะขยายขนาดได้หรือหยุดชะงัก ไปที่ การเปรียบเทียบแบบรวดเร็ว เพื่อดูรายชื่อย่อภายในสามสิบวินาที
ข้อเท็จจริงสำคัญ
ตลาดการทำเว็บสแครปด้วย AI ในปี 2026 มีพลวัตเฉพาะที่ควรรู้ก่อนเลือกเครื่องมือ มีห้าเรื่องที่ควรรู้ตั้งแต่ต้น:
- ผลลัพธ์ที่พร้อมใช้กับ LLM > HTML ดิบ เครื่องมือสแครป AI สมัยใหม่ (Firecrawl, Crawl4AI, Olostep, Spider.cloud) แปลงหน้าเว็บเป็น markdown ที่สะอาดหรือ JSON ที่มีโครงสร้าง พร้อมสำหรับ embedding, การนำเข้า RAG หรือ fine-tuning โมเดล Firecrawl อ้างว่า markdown ของตนใช้โทเค็นน้อยกว่า HTML ดิบ ~67% ซึ่งเกี่ยวข้องโดยตรงหากคุณจ่ายค่าบริการ OpenAI/Anthropic ตามจำนวนโทเค็น เครื่องมือสแครปทั่วไป (Apify, ScrapingBee, ScraperAPI) ส่งคืน HTML/JSON และต้องมีการประมวลผลภายหลัง
- โมเดลราคาแบ่งเป็นสามกลุ่ม อัตราคงที่ต่อหน้า/เครดิต (Firecrawl ~$0.0008/scrape เมื่อใช้งานในขนาดใหญ่, Olostep คิดตามเครดิต), คิดตามการประมวลผล (Apify ~$0.20-$0.30/หน่วยการประมวลผล + ค่าเช่า Actor + ค่าใช้พร็อกซีตามจริง) และ คิดต่อคำขอพร้อมตัวคูณ (ScrapingBee, ScraperAPI, ZenRows, Decodo Scraping API โดยการเรนเดอร์ JS และพร็อกซีพรีเมียมอาจทำให้ต้นทุนต่อคำขอเพิ่มเป็น 5×-75×) การคิดตามการประมวลผลคาดการณ์ได้ยากที่สุด ส่วนอัตราคงที่ง่ายที่สุด
- การรับมือบอตคือด่านสำคัญที่แท้จริง ตามเกณฑ์วัด Scrapeway 2024-2025: Bright Data มีอัตราความสำเร็จเฉลี่ย ~98% (100% บน Indeed, Zillow, Capterra, Google) ZenRows + Decodo + Bright Data + Zyte มีการหลบเลี่ยง anti-bot เป็นค่าเริ่มต้น; Firecrawl, Apify, ScrapingBee เสนอเป็นส่วนเสริมหรือในระดับที่สูงกว่า สำหรับเป้าหมายที่ยาก (เว็บไซต์ที่ป้องกันด้วย Cloudflare/Akamai/PerimeterX) ความสามารถในการหลบเลี่ยงสำคัญกว่าความครอบคลุมของฟีเจอร์
- โอเพนซอร์สสำคัญมากขึ้นในปี 2026 Crawl4AI (โอเพนซอร์ส, ใช้ AI เป็นแกนหลัก, เชื่อมต่อกับ LangChain/LlamaIndex) และสแต็ก Scrapy + Playwright stealth มีส่วนแบ่งเพิ่มขึ้นเมื่อเทียบกับ API ที่มีผู้ดูแล เพราะทีม ML นำงานสแครปกลับมาทำภายในเพื่อเหตุผลด้านการตรวจสอบแหล่งที่มาของ IP สิ่งที่ต้องแลกคือชั้นพร็อกซี เนื่องจากเครื่องมือสแครปโอเพนซอร์สต้องมีโครงสร้างพื้นฐานพร็อกซีดิบอยู่ด้านล่าง
- การสแครปข้อมูลสาธารณะเป็นเรื่องถูกกฎหมาย แต่สัญญาไม่ใช่ และ Reddit เปลี่ยนทุกอย่าง Bartz v Anthropic (Jun 23, 2025) + Kadrey v Meta (Jun 25, 2025) ยืนยันว่าการฝึกด้วยข้อมูลเว็บสาธารณะเป็น การใช้งานโดยชอบธรรม Meta v Bright Data (Jan 23, 2024) ยืนยันว่าการสแครปข้อมูลสาธารณะในสถานะไม่ได้ล็อกอินปลอดภัยต่อ CFAA + ToS แต่ Reddit v Anthropic (Jun 2025), Reddit v Perplexity + Oxylabs (Oct 2025), Stack Overflow + Cloudflare pay-per-crawl (Feb 2026) และโปรโตคอล RSL (Sep 2025, 1,500+ ผู้เผยแพร่) ทำให้สัญญากับผู้เผยแพร่กลายเป็นชั้นความเสี่ยงใหม่ ด้านกฎหมายชัดเจนขึ้น; ด้านสัญญายากขึ้น
เราเลือกเครื่องมือทำเว็บสแครปด้วย AI เหล่านี้อย่างไร
เราเลือกเครื่องมือทั้ง 10 รายการนี้เพราะมีการใช้งานจริงในระดับการผลิตที่น่าเชื่อถือในปี 2026, มีการเปิดเผยราคาต่อสาธารณะ, มีกรณีใช้ AI/LLM ที่จัดทำเอกสารไว้ (ผลลัพธ์ markdown, การดึง JSON-LD, endpoint ข้อมูลที่มีโครงสร้าง, การเชื่อมต่อ LangChain/LlamaIndex, การรองรับ agent-MCP) และมีบทบาทที่ชัดเจนในห่วงโซ่คุณค่าของไปป์ไลน์ AI ตั้งแต่แบบโอเพนซอร์สที่โฮสต์เอง (Crawl4AI) จนถึง API ระดับองค์กรที่มีผู้ดูแล (Bright Data Web Scraper, Oxylabs) เครื่องมือที่ไม่เผยแพร่ราคา, มีคำกล่าวอ้างทางการตลาดยุค 2024 ที่ล้าสมัย หรือไม่มีเรื่องราวการเชื่อมต่อกับไปป์ไลน์ AI ถูกตัดออก เราทดสอบเครื่องมือสแครปอย่างสม่ำเสมอกับเป้าหมายที่เป็นตัวแทนของเวิร์กโฟลว์ AI (Reddit, Stack Overflow, ข่าว, Wikipedia, GitHub, แค็ตตาล็อกอีคอมเมิร์ซ) เพื่อตรวจสอบคำกล่าวอ้างเกี่ยวกับไปป์ไลน์ LLM
อะไรทำให้เครื่องมือทำเว็บสแครปด้วย AI ดี?
เครื่องมือทำเว็บสแครปด้วย AI ที่ดีสำหรับปี 2026 แก้ปัญหาสี่อย่างพร้อมกัน โครงสร้างผลลัพธ์ที่พร้อมใช้กับ LLM markdown หรือ JSON ที่มีโครงสร้างมีต้นทุนการนำเข้าเข้าสู่ vector DB และหน้าต่างบริบท LLM ต่ำกว่า HTML ดิบอย่างมาก เครื่องมือที่ไม่ส่งผลลัพธ์ที่เป็นมิตรกับ LLM จะเพิ่มขั้นตอนการทำความสะอาดที่ใช้ทั้งเวลาวิศวกรรมและค่าใช้จ่ายต่อโทเค็น การหลบเลี่ยง anti-bot โดยไม่ต้องซื้อพร็อกซีแยก สำหรับเป้าหมายที่ยากที่สุด (ที่ป้องกันด้วย Cloudflare/Akamai/PerimeterX) เครื่องมือสแครปจะหลบเลี่ยงได้ หรือคุณต้องนำพร็อกซีมาใช้เอง แนวทางที่รวมไว้ช่วยประหยัดเวลาปฏิบัติการ ส่วนแนวทางนำมาเองประหยัดเงินเมื่อมีปริมาณมาก ราคาที่คาดการณ์ได้และสอดคล้องกับโมเดลต้นทุน LLM อัตราคงที่ต่อหน้าดีกว่าการคิดตามการประมวลผลสำหรับการควบคุมงบประมาณ โดยเฉพาะเมื่อค่าใช้จ่าย LLM ปลายทางของคุณคิดตามโทเค็นเช่นกัน ตัวคูณที่ทบซ้อนกัน (การเรนเดอร์ JS + พร็อกซีพรีเมียม + ลองใหม่เมื่อล้มเหลว) ทำให้การคิดราคาตามการประมวลผลไม่โปร่งใส การเชื่อมต่อกับส่วนที่เหลือของสแต็ก LLM ตัวเชื่อมต่อแบบเนทีฟกับ LangChain, LlamaIndex, เอเจนต์เขียนโค้ด AI ผ่าน MCP, สคีมาผลลัพธ์แบบมีโครงสร้าง (Pydantic, Zod) สิ่งเหล่านี้สำคัญกว่าในปี 2026 เมื่อเทียบกับปี 2024
เปรียบเทียบอย่างรวดเร็ว: AI Web Scrapers ที่ดีที่สุดโดยสรุป
| เครื่องมือ | เหมาะที่สุดสำหรับ | ราคา | ผลลัพธ์ LLM | ต้านบอต |
|---|---|---|---|---|
| Firecrawl | มาร์กดาวน์พร้อมใช้สำหรับ RAG / LLM | $16/mo (5K เครดิต); $0.0008/การสแครปเมื่อใช้งานในปริมาณมาก | Markdown + JSON (เนทีฟ) | ส่วนเสริม / ระดับสูงกว่า |
| Apify | ความครอบคลุมของมาร์เก็ตเพลส (10K+ actors) | คิดตามคอมพิวต์ + ค่าเช่า Actor + พร็อกซี | HTML/JSON (ประมวลผลภายหลัง) | แตกต่างไปตาม Actor |
| Octoparse | ภาพแบบชี้แล้วคลิก, ไม่ต้องเขียนโค้ด | $69/mo Standard (รายปี) | HTML/CSV (ประมวลผลภายหลัง) | มีในตัว (อิงเทมเพลต) |
| Browse AI | ไม่ต้องเขียนโค้ด, ขับเคลื่อนด้วยพรอมป์ต์ | เริ่มต้น $19/mo | JSON | ปรับตัวอัตโนมัติ |
| ScrapingBee | API ที่จัดการให้และเป็นมิตรกับนักพัฒนา | $49/mo Freelance | HTML/JSON | ส่วนเสริม / ระดับสูงกว่า |
| ScraperAPI | เป้าหมายที่ยาก (Amazon, Google) | $49/mo Hobby (100K เครดิต) | HTML/JSON, เอนด์พอยต์แบบมีโครงสร้าง | รวมมาให้ |
| ZenRows | หลบเลี่ยง Cloudflare/DataDome/PerimeterX | ต่อคำขอ + ตัวคูณ | HTML/JSON | รวมมาให้ (เฉพาะทาง) |
| Crawl4AI | โอเพนซอร์สที่เป็นมิตรกับ LLM | ฟรี (โฮสต์เอง) | Markdown + JSON (เนทีฟ) | นำของคุณมาเอง |
| Bright Data Web Scraper | ระดับองค์กร, เป้าหมายที่ยากที่สุด | $1.50/1K ระเบียน PAYG (~$1.30 บน $499/mo) | JSON, เอนด์พอยต์แบบมีโครงสร้าง | รวมมาให้ (ดีที่สุดในระดับเดียวกัน) |
| Olostep / Spider.cloud | พร้อมใช้กับ LLM + เป็นมิตรกับโอเพนซอร์ส | อิงเครดิต, โปร่งใส | Markdown + JSON | รวมมาให้ |
แนวทางของ AI Scraper ในปี 2026
การสแครปเว็บด้วย AI ในปี 2026 แบ่งออกเป็นห้าแนวทาง; เลือกตามแนวทางของทีมคุณ ไม่ใช่ตามจำนวนฟีเจอร์
แนวทาง 1 — APIs ที่พร้อมสำหรับ LLM (สร้างขึ้นเพื่อ AI โดยเฉพาะ)
แนวทางใหม่ล่าสุดและเติบโตเร็วที่สุด: scraper ที่มีไว้เพื่อป้อนข้อมูลให้ LLMs โดยเฉพาะ Firecrawl เป็นผู้นำแนวทางนี้ — ผลลัพธ์ markdown, รองรับ MCP-server, การผสานรวม LangChain + LlamaIndex แบบเนทีฟ, อ้างว่าลดโทเค็นได้ 67% เทียบกับ HTML ดิบ Olostep, Spider.cloud และ fastCRW ล้วนอยู่ในแนวทางนี้ด้วยการออกแบบผลิตภัณฑ์ที่ให้ AI มาก่อนในลักษณะคล้ายกัน Crawl4AI คือตัวเลือกโอเพนซอร์สที่มีคุณค่าที่นำเสนอแบบเดียวกัน เลือกแนวทางนี้หากผลลัพธ์ของคุณป้อนเข้า RAG vector DB หรือหน้าต่างบริบทของเอเจนต์โดยตรง
แนวทาง 2 — มาร์เก็ตเพลส + ระบบนิเวศ Actor
Apify ครองแนวทางนี้ด้วย scraper ที่สร้างไว้ล่วงหน้า 10,000+ รายการ (“Actors”) สำหรับเป้าหมายเฉพาะ (Amazon, LinkedIn, TikTok, Instagram, Twitter/X, Reddit ฯลฯ) การคิดราคาแบบอิงคอมพิวต์คาดการณ์ได้ยากกว่า แต่ความครอบคลุมของมาร์เก็ตเพลสหมายความว่าเป้าหมายทั่วไปส่วนใหญ่มี scraper ที่ดูแลรักษาอยู่แล้ว เลือก Apify หากคุณต้องการ scraper สำหรับหลายเว็บไซต์และไม่อยากสร้างแต่ละตัวเอง
แนวทาง 3 — เครื่องมือสร้างแบบไม่ต้องเขียนโค้ด / แบบภาพ
Octoparse (แอปเดสก์ท็อปแบบภาพ ชี้แล้วคลิก, $89/mo Standard, ขับเคลื่อนด้วยเทมเพลตสำหรับเว็บไซต์ยอดนิยม), Browse AI (การเลือกด้วย AI ที่ขับเคลื่อนด้วยพรอมป์ต์, เริ่มต้น $19/mo, ปรับตัวอัตโนมัติเมื่อเว็บไซต์เปลี่ยน), Bardeen (ระบบอัตโนมัติ AI พร้อมตัวดึงข้อมูลเว็บ, ฟรีเมียม) เลือกแนวทางนี้หากทีมของคุณไม่มีวิศวกรที่ใช้งาน Playwright/Scrapy ได้อย่างคล่องแคล่ว
แนวทาง 4 — APIs ที่จัดการให้สำหรับนักพัฒนา (อเนกประสงค์)
ScrapingBee ($49/mo Freelance), ScraperAPI ($49/mo Hobby, 100K เครดิต; เอนด์พอยต์ข้อมูลแบบมีโครงสร้างเฉพาะทางสำหรับ Amazon/Google/Walmart), ZenRows (เชี่ยวชาญด้านการหลบเลี่ยง Cloudflare/DataDome/PerimeterX), Decodo Web Scraping API ($19/mo) อเนกประสงค์, คิดราคาต่อคำขอ พร้อมตัวคูณสำหรับการเรนเดอร์ JS และพร็อกซีพรีเมียม เลือกแนวทางนี้สำหรับเป้าหมายที่ยากด้วยปริมาณปานกลาง
แนวทาง 5 — Scraper ที่จัดการให้ระดับองค์กร
Bright Data Web Scraper API (เอนด์พอยต์ Reddit/Stack Overflow/news/social/LinkedIn/Amazon; $1.50/1K ระเบียน PAYG, ~$1.30/1K ในแผน $499/mo; อัตราความสำเร็จดีที่สุดในระดับเดียวกัน ~98%) Oxylabs Web Scraper API (เริ่มต้น $49/mo, ระดับ SLA, ISO 27001 + SOC 2) Zyte (เชี่ยวชาญด้านเป้าหมายที่มีการป้องกัน) เลือกแนวทางนี้สำหรับเป้าหมายที่ยากที่สุดในระดับองค์กร + การปฏิบัติตามข้อกำหนดที่พร้อมรับการตรวจสอบ
AI Web Scrapers ที่ดีที่สุด — รีวิวฉบับเต็ม
ตัวเลือกด้านล่างจัดอันดับตามคุณค่าต่อไปป์ไลน์ AI — ผลลัพธ์ markdown/JSON, การผสานรวมกับสแตก LLM, ความสำเร็จในการต้านบอต, ราคาที่คาดการณ์ได้ และแรงส่งในปี 2026 เครื่องมือแต่ละตัวชนะในแนวทางต่างกัน; เลือกตามภาระงานของคุณ ไม่ใช่อันดับโดยรวม
1. Firecrawl
Firecrawl เป็นผู้นำแนวทางสำหรับการสแครปที่พร้อมใช้กับ LLM โดยจะแปลง URL เว็บใดๆ เป็น markdown ที่สะอาดหรือ JSON แบบมีโครงสร้างพร้อมสำหรับฝังลงในไปป์ไลน์ RAG โดยอ้างว่าใช้โทเค็นน้อยกว่า HTML ดิบ 67% (เกี่ยวข้อง: ค่าโทเค็นคือบิล LLM ในขั้นปลายทางของคุณ) มีการผสานรวม LangChain + LlamaIndex แบบเนทีฟ, MCP server สำหรับเอเจนต์เขียนโค้ด AI (Claude Code, Cursor), การดึงข้อมูล PDF ในตัว, การเรนเดอร์ JavaScript ในระดับ Hobby+ และโมเดลราคาโปร่งใส 1 เครดิตต่อหน้า เริ่มต้นที่ $16/mo สำหรับ 5,000 เครดิต คำขอที่ล้มเหลวไม่ใช้เครดิต — เป็นคุณสมบัติการจัดการต้นทุนที่มีความหมายเมื่อใช้งานในปริมาณมากซึ่งการลองใหม่เป็นเรื่องปกติ เมื่อปริมาณเพิ่มขึ้น ต้นทุนต่อการสแครปลดลงเหลือ ~$0.0008 ข้อแลกเปลี่ยนคือ: การหลบเลี่ยงบอตสำหรับเป้าหมายที่ได้รับการป้องกันระดับ 1 (Cloudflare/Akamai/PerimeterX) มีในระดับสูงกว่าหรือเป็นส่วนเสริม; สำหรับเป้าหมายที่ยากที่สุด คุณอาจยังต้องจับคู่กับพร็อกซีดิบ
ข้อมูลจำเพาะโดยย่อ — ผลลัพธ์: markdown + JSON แบบมีโครงสร้าง (พร้อมสำหรับ LLM แบบเนทีฟ) · ราคา: 1 เครดิต = 1 หน้า; $16/mo สำหรับ 5K เครดิต; ~$0.0008/การสแครปเมื่อใช้งานในปริมาณมาก · ต้านบอต: รวมในระดับสูงกว่า / Hobby มีขั้นพื้นฐาน · การผสานรวม: LangChain, LlamaIndex, MCP (Claude Code/Cursor), Python/Node SDKs · โอเพนซอร์ส: API client + บางคอมโพเนนต์เป็นโอเพนซอร์ส, ผลิตภัณฑ์ที่โฮสต์มีค่าใช้จ่าย
เหมาะที่สุดสำหรับ: การนำข้อมูลเข้าไปป์ไลน์ RAG, การเข้าถึงเว็บของเอเจนต์ LLM, การประกอบชุดข้อมูลที่ผลลัพธ์ markdown ช่วยประหยัดค่าโทเค็น
2. Apify
Apify คือเจ้าแห่งมาร์เก็ตเพลสที่มี สแครปเปอร์ที่สร้างไว้ล่วงหน้า 10,000+ รายการ (“Actors”) สำหรับเป้าหมายเฉพาะ — Amazon, LinkedIn, Reddit, TikTok, Instagram, Twitter/X, เว็บไซต์ข่าว, อีคอมเมิร์ซ, อสังหาริมทรัพย์, งาน แต่ละ Actor ได้รับการดูแลแยกกัน (โดย Apify + ชุมชน) โดยมีค่าบริการเช่าต่อ Actor เพิ่มจากค่าการใช้คอมพิวต์ การคิดราคาแบบอิงคอมพิวต์: ประมาณ $0.25/CU ในแพ็กเกจ Starter ราคา $49 และ $0.40/CU สำหรับจ่ายตามการใช้งาน (ลดลงเป็น $0.16/$0.13 ในแพ็กเกจปริมาณสูง) + ค่าเช่า Actor + การส่งผ่านพร็อกซี (Apify รวมพูล IP ที่อยู่อาศัยของตนเองไว้ หรือคุณสามารถ BYO ได้) ความหลากหลายของมาร์เก็ตเพลสนั้นไร้คู่แข่ง — เป้าหมายทั่วไปส่วนใหญ่มีสแครปเปอร์ที่ใช้งานได้อยู่แล้ว ดังนั้นเวลาวิศวกรรมของคุณจึงไปกับการผสานระบบ ไม่ใช่การสร้างตัวแยกวิเคราะห์ ข้อแลกเปลี่ยนคือ: การคาดการณ์ราคาทำได้ยากที่สุดในกลุ่ม AI-scraper การเรนเดอร์ JS + พร็อกซีพรีเมียม + การลองซ้ำเมื่อไม่สำเร็จ ทำให้ค่าใช้จ่ายคอมพิวต์เพิ่มพอกพูน การวางงบประมาณต้องอาศัยการประเมินอย่างรอบคอบต่อ Actor สำหรับกรณีใช้งานที่กว้าง หรือทีมที่นำไปใช้ครั้งแรก คุณค่าของมาร์เก็ตเพลส Apify ยากจะเอาชนะได้
สเปกโดยย่อ — ผลลัพธ์: HTML, JSON, CSV ขึ้นอยู่กับ Actor · ราคา: อิงคอมพิวต์ประมาณ $0.25-$0.40/CU (ต่ำลงเมื่อใช้ในระดับใหญ่: $0.16-$0.13) + ค่าเช่าต่อ Actor + การส่งผ่านพร็อกซี · การป้องกันบอต: ต่อ Actor (บางส่วนรวมมาให้ บางส่วนเป็นพร็อกซี BYO) · การผสานระบบ: Python/Node SDKs, webhooks, การรันตามกำหนดเวลา, การผสาน MCP ในเบต้า · โอเพนซอร์ส: Apify SDK เป็นโอเพนซอร์ส
เหมาะที่สุดสำหรับ: ทีมที่ต้องการสแครปเปอร์ข้ามเว็บไซต์ที่หลากหลาย และไม่ต้องการสร้างแต่ละตัวเอง
3. Octoparse
Octoparse คือสแครปเปอร์แบบไม่ต้องเขียนโค้ดที่มองเห็นและคลิกได้ — แอปพลิเคชันเดสก์ท็อปที่คุณคลิกผ่านเว็บไซต์เป้าหมายเพื่อกำหนดสิ่งที่ต้องการดึงออกมา พร้อมสแครปเปอร์แบบเทมเพลตสำหรับเป้าหมายยอดนิยม (Amazon, eBay, Twitter, เว็บไซต์อสังหาริมทรัพย์ เป็นต้น) ที่ได้รับการดูแลและอัปเดตอัตโนมัติเมื่อเว็บไซต์เหล่านั้นเปลี่ยนเลย์เอาต์ แพ็กเกจ Standard $69/mo (เรียกเก็บรายปี; ประมาณ $119 เมื่อเรียกเก็บรายเดือน) คิดราคาแบบคงที่สำหรับหลายแสนหน้า ไม่มีการคิดค่าบริการต่อหน้า — คาดการณ์ได้สำหรับเวิร์กโฟลว์ปริมาณสูงที่ไม่เจาะจง AI มีการประมวลผลบนคลาวด์; มี anti-bot ในตัวสำหรับเป้าหมายเทมเพลตที่รองรับ ข้อแลกเปลี่ยนคือ: ผลลัพธ์เริ่มต้นเป็น HTML/CSV/Excel ไม่ใช่ markdown ที่พร้อมสำหรับ LLM — คุณจะต้องมีขั้นตอนหลังการประมวลผลเพื่อทำความสะอาดสำหรับการนำเข้า LLM หากทีมของคุณไม่เชี่ยวชาญด้านเทคนิค หรือคุณเป็นองค์กรการตลาด/วิจัยที่ต้องการข้อมูลมีโครงสร้างโดยไม่ต้องมีวิศวกร Octoparse มีเส้นโค้งการเรียนรู้ที่ง่ายที่สุด
สเปกโดยย่อ — ผลลัพธ์: CSV, Excel, JSON, HTML (ต้องมีการประมวลผลภายหลังสำหรับ LLM) · ราคา: Standard $69/mo (รายปี; ประมาณ $119/mo รายเดือน); ราคาแบบคงที่ ไม่มีการคิดค่าบริการต่อหน้า · การป้องกันบอต: มีในตัวสำหรับเป้าหมายเทมเพลต · การผสานระบบ: การเข้าถึง API ในระดับแพ็กเกจสูงกว่า · โอเพนซอร์ส: ปิด
เหมาะที่สุดสำหรับ: ทีมที่ไม่เชี่ยวชาญด้านเทคนิค; เครื่องมือสร้างแบบภาพ; การดึงข้อมูลมีโครงสร้างสำหรับ BI/analytics ที่ผลลัพธ์ LLM ไม่ใช่ข้อกำหนดชี้ขาด
4. Browse AI
Browse AI คือสแครปเปอร์ AI แบบไม่ต้องเขียนโค้ดที่ขับเคลื่อนด้วยพรอมป์ต์ — คุณอธิบายด้วยภาษาอังกฤษธรรมดาว่าต้องการดึงอะไร AI จะสร้างสแครปเปอร์ และปรับตัวอัตโนมัติเมื่อเว็บไซต์เป้าหมายเปลี่ยน แพ็กเกจเริ่มต้น $19/mo — อยู่ในกลุ่มสแครปเปอร์ AI ที่ถูกที่สุด กลไกการปรับตัวอัตโนมัติคือจุดแตกต่าง: เมื่อเลย์เอาต์ของเว็บไซต์เป้าหมายเปลี่ยน AI ของ Browse AI จะระบุองค์ประกอบใหม่โดยไม่ต้องให้คุณกำหนดค่าอีกครั้ง ผลลัพธ์เป็น JSON ที่มีโครงสร้าง ข้อแลกเปลี่ยนคือ: การสแครปปริมาณมากมีราคาแพงในโมเดลเครดิตของ Browse AI; สำหรับหลายแสนหน้า อัตราต่อหน้าของ ScrapingBee/ScraperAPI/Firecrawl ดีกว่า เหมาะที่สุดสำหรับทีมที่ไม่เชี่ยวชาญด้านเทคนิคซึ่งดึงข้อมูลรายวัน/รายสัปดาห์แบบคัดสรรจากชุดเว็บไซต์ที่รู้จัก
สเปกโดยย่อ — ผลลัพธ์: JSON ที่มีโครงสร้าง · ราคา: แพ็กเกจเริ่มต้น $19/mo, อิงเครดิต · การป้องกันบอต: ปรับตัวอัตโนมัติ; มีในตัว · การผสานระบบ: API, webhooks, Zapier · โอเพนซอร์ส: ปิด
เหมาะที่สุดสำหรับ: ทีมที่ไม่เชี่ยวชาญด้านเทคนิคที่ใช้เวิร์กโฟลว์การดึงข้อมูลมีโครงสร้างบนเว็บไซต์เป้าหมายที่รู้จัก; การสร้างต้นแบบอย่างรวดเร็ว
5. ScrapingBee
ScrapingBee คือ API แบบจัดการที่เป็นมิตรกับนักพัฒนา — เอกสารสะอาดตา, Python และ Node SDKs อย่างเป็นทางการ, การเรนเดอร์ JavaScript ในทุกแพ็กเกจ, ส่วนเสริม residential และ premium-proxy, การคิดราคาต่อคำขอเริ่มต้นราวแพ็กเกจ Freelance $49/mo ทำการตลาดด้วยความง่ายในการใช้งานและเอกสารที่ชัดเจน มากกว่าความกว้างของฟีเจอร์ ข้อแลกเปลี่ยนคือ: ตัวคูณต่อคำขอ (การเรนเดอร์ JS 5×, พร็อกซีพรีเมียม 25×, screenshot 50×) ทำให้ต้นทุนต่อหน้าที่แท้จริงสูงกว่าราคาพื้นฐานมาก; ควรวางงบประมาณที่ระดับสูง ผลลัพธ์เป็น HTML/JSON ไม่ใช่ LLM markdown โดยกำเนิด
สเปกโดยย่อ — ผลลัพธ์: HTML + JSON, รองรับ BeautifulSoup · ราคา: Freelance $49/mo; ต่อคำขอพร้อมตัวคูณ (JS 5×, พรีเมียม 25×) · การป้องกันบอต: มีในตัวในระดับแพ็กเกจสูงกว่า · การผสานระบบ: Python + Node SDKs, REST แบบเรียบง่าย · โอเพนซอร์ส: ปิด
เหมาะที่สุดสำหรับ: ทีมนักพัฒนาที่ต้องการ API แบบจัดการที่สะอาดสำหรับเป้าหมายที่มีการป้องกันระดับปานกลาง
6. ScraperAPI
ScraperAPI เชี่ยวชาญด้านเป้าหมายอีคอมเมิร์ซที่ยากที่สุดด้วย ปลายทางข้อมูลแบบมีโครงสร้างโดยเฉพาะ — ชี้ไปที่ Amazon ASIN แล้วรับวัตถุผลิตภัณฑ์ JSON ที่แยกวิเคราะห์แล้วกลับมา; เช่นเดียวกันสำหรับ Google SERP, Walmart, eBay แพ็กเกจ Hobby $49/mo พร้อม 100,000 เครดิตสำหรับหน้า HTML แบบง่าย และมากกว่านั้นสำหรับปลายทางพรีเมียม มีการป้องกันบอตที่รวมมาให้สำหรับเป้าหมายเฉพาะทาง พร้อมพูล IP ที่อยู่อาศัย แนวทาง: API แบบจัดการเฉพาะทางสำหรับอีคอมเมิร์ซ + SERP ข้อแลกเปลี่ยนคือ: นอกเหนือจากเป้าหมายปลายทางข้อมูลแบบมีโครงสร้างแล้ว มันเป็นสแครปเปอร์ต่อคำขอที่คล้าย ScrapingBee พร้อมตัวคูณที่คล้ายกัน
สเปกโดยย่อ — ผลลัพธ์: HTML + JSON ที่มีโครงสร้างสำหรับเป้าหมายเฉพาะทาง (Amazon, Google SERP, Walmart, eBay) · ราคา: Hobby $49/mo (100K เครดิต); ปลายทางข้อมูลแบบมีโครงสร้างมีต้นทุนสูงกว่า · การป้องกันบอต: รวมมาให้สำหรับเป้าหมายเฉพาะทาง · การผสานระบบ: Python SDK + REST · โอเพนซอร์ส: ปิด
เหมาะที่สุดสำหรับ: การติดตามราคาอีคอมเมิร์ซ, Amazon/Walmart/Google SERP ในระดับใหญ่ ซึ่ง structured endpoints ช่วยประหยัดเวลาแยกวิเคราะห์
7. ZenRows
ZenRows เชี่ยวชาญด้าน การหลบเลี่ยง anti-bot; การผ่าน Cloudflare, DataDome, PerimeterX (ปัจจุบันคือ HUMAN Security) และชุด WAF ระดับองค์กรที่คล้ายกัน กำหนดราคาต่อคำขอพร้อมตัวคูณ, มีการเรนเดอร์ JS ในทุกแผน, รวม premium-proxy ไว้แล้ว ตามเกณฑ์ทดสอบ Scrapeway เดือนธันวาคม 2024 ZenRows มีอัตราความสำเร็จ 51% ด้วยเวลาตอบสนอง 15.4s ที่ $4.62/1K คำขอบนเป้าหมายที่ยาก; ทำได้ดีแต่อยู่ระดับกลางเมื่อเทียบกับ ~98% ของ Bright Data บทบาท: API ที่มีการจัดการแบบเฉพาะทางสำหรับเป้าหมายที่มีการป้องกันเข้มงวด ซึ่ง scraper ทั่วไปไปต่อไม่ได้ ข้อแลกเปลี่ยนคือราคาพรีเมียม; ไม่ใช่ตัวเลือกต่อหน้าที่ถูกที่สุดในกลุ่ม developer-API
สเปกโดยย่อ; เอาต์พุต: HTML + JSON · ราคา: ต่อคำขอพร้อมตัวคูณ · Anti-bot: รวมไว้แล้ว, เชี่ยวชาญ Cloudflare/DataDome/PerimeterX · การผสานรวม: Python SDK + REST · Open-source: ปิด
เหมาะที่สุดสำหรับ: เป้าหมายที่มีการป้องกันเข้มงวด (ป้องกันด้วย Cloudflare/PerimeterX) ซึ่ง scraper ทั่วไปล้มเหลว
8. Crawl4AI
Crawl4AI เป็น open-source และฟรี; เป็น crawler แบบ open-source ที่เน้น AI ชั้นนำ ออกแบบมาโดยเฉพาะสำหรับไปป์ไลน์ RAG และการประกอบข้อมูลฝึก LLM ส่งกลับ markdown ที่สะอาด + JSON แบบมีโครงสร้าง, ทำงานร่วมกับ LangChain และ LlamaIndex โดยกำเนิด, เรนเดอร์ JavaScript ผ่าน Playwright, ดึงข้อมูลตามสคีมา (Pydantic/Zod), จับภาพหน้าจอ, crawl แบบเป็นชุด โฮสต์เอง ดังนั้นค่าใช้จ่ายมีเพียงโครงสร้างพื้นฐานของคุณ (Playwright + proxy + การประมวลผล) สำหรับทีม ML ที่ต้องการร่องรอยการตรวจสอบแหล่งที่มาของ IP (หลังคำวินิจฉัย NYT-v-OpenAI เดือนมกราคม 2026 การค้นหาข้อมูลฝึกกลายเป็นจุดเสี่ยงใหม่) หรือต้องการควบคุมไปป์ไลน์ทั้งหมด Crawl4AI เป็นตัวเลือกที่เหมาะสม ข้อแลกเปลี่ยนคือคุณต้องจัดการชั้น anti-bot เอง (Playwright stealth + residential proxy); ฟรีจนกว่าจะนับบิล proxy
สเปกโดยย่อ; เอาต์พุต: markdown + JSON แบบมีโครงสร้าง (พร้อมสำหรับ LLM โดยกำเนิด) · ราคา: ฟรี, โฮสต์เอง · Anti-bot: จัดหาเอง (Playwright stealth + residential proxy) · การผสานรวม: LangChain, LlamaIndex, MCP, Python แบบกำหนดเอง · Open-source: ใช่ (Apache 2.0)
เหมาะที่สุดสำหรับ: ทีม ML ที่ต้องการการควบคุมเต็มรูปแบบ + ร่องรอยการตรวจสอบแหล่งที่มาของ IP + ฟรีเมื่อใช้ในขนาดใหญ่ (มีเพียงค่า proxy)
AI Web Scraper มีค่าใช้จ่ายเท่าไร?
ราคาในปี 2026 แบ่งเป็นสี่ระดับ:
- open-source ฟรี; Crawl4AI, Scrapy, Playwright ค่าใช้จ่าย = โครงสร้างพื้นฐานของคุณ + บิล proxy
- แบบมีการจัดการราคาประหยัด ($16-$49/mo); Firecrawl Hobby ($16), Browse AI entry ($19), Decodo Scraping API ($19), Octoparse Free trial, ScrapingBee Freelance ($49), ScraperAPI Hobby ($49)
- ระดับกลาง ($49-$499/mo); Apify Personal+, Octoparse Standard ($89), แผนระดับกลางของ Browse AI, Oxylabs Web Scraper API ($49+), แผนระดับกลางของ ZenRows
- องค์กรต่อระเบียน ($1.30-$1.50/1K + $499+/mo); Bright Data Web Scraper API, Oxylabs สำหรับองค์กร, Zyte สำหรับองค์กร
คำถามค่าใช้จ่ายที่แท้จริงสำหรับการ scraping ด้วย AI ไม่ใช่ “เครื่องมือใดถูกที่สุด” แต่คือ “ต้นทุนต่ำสุดต่อระเบียนที่พร้อมใช้กับ LLM บนเว็บไซต์เป้าหมายของฉันตามปริมาณของฉันคือเท่าไร” ทดสอบ 5-10 เครื่องมือกับเป้าหมายจริงและไปป์ไลน์ LLM ปลายน้ำของคุณ; ความต่างของต้นทุนต่อหน้าระหว่าง scraper markdown ที่พร้อมใช้กับ LLM (Firecrawl) และ scraper HTML ดิบ (Octoparse, Apify generic) จะปรากฏในต้นทุน token ปลายน้ำ ไม่ใช่เพียงบิล scraper
การ Scraping เว็บด้วย AI ถูกกฎหมายหรือไม่?
แนวคำพิพากษาในปี 2025-2026 ทำให้กฎหมายการ scraping เว็บด้วย AI ชัดเจนขึ้นอย่างมาก; และเปลี่ยนจุดเสี่ยงอย่างมากเช่นกัน ประเด็นพื้นฐานมีดังนี้:
- การฝึกด้วยข้อมูลเว็บสาธารณะเป็น fair use (US) Bartz v Anthropic (Jun 23, 2025, Judge Alsup) วินิจฉัยว่าการฝึกด้วยข้อมูลเว็บสาธารณะ “เปลี่ยนแปลงอย่างยิ่ง” และเป็น fair use ภายใต้ 17 USC §107; แต่มีข้อยกเว้นว่าการดาวน์โหลดหนังสือเถื่อน ~7M เล่มเพื่อห้องสมุดของ Anthropic ไม่เป็น fair use Kadrey v Meta (Jun 25, 2025, Judge Chhabria) วินิจฉัยให้ Meta ตามข้อเท็จจริงในสำนวน แต่เตือนอย่างชัดเจนว่าไม่ได้เป็นหลักยืนยันกว้าง ๆ ว่าการฝึก AI เป็น fair use
- การ scraping ข้อมูลสาธารณะปลอดภัยตาม CFAA hiQ v LinkedIn (9th Cir. April 2022) + Meta v Bright Data (Jan 23, 2024); การ scraping ข้อมูลเว็บสาธารณะที่ไม่ได้ล็อกอินไม่ละเมิด Computer Fraud and Abuse Act
- สัญญาของผู้เผยแพร่คือชั้นความเสี่ยงใหม่ Reddit ฟ้อง Anthropic (Jun 2025) และ Perplexity + Oxylabs (Oct 2025) จากการ scraping โดยไม่มีใบอนุญาต Stack Overflow + Cloudflare เปิดตัว pay-per-crawl (Feb 2026) โปรโตคอล RSL (Sep 2025, ผู้เผยแพร่ 1,500+ ราย) ให้เงื่อนไขการอนุญาตใช้งานที่เครื่องอ่านได้แก่เว็บไซต์ การละเมิด ToS ของผู้เผยแพร่ก่อให้เกิดความเสี่ยงจากการผิดสัญญา + การละเมิดทางแพ่งตามกฎหมายรัฐ แม้ CFAA จะปลอดภัย นี่คือลักษณะเดียวกับที่เกิดกับ hiQ (ปลอดภัยตาม CFAA ภายใต้คำวินิจฉัยของ 9th Circuit ปี 2022 แต่ยุติคดีในปี 2022 บนฐานกฎหมายสัญญาและการละเมิดทางแพ่งตามกฎหมายรัฐแคลิฟอร์เนีย)
- ข้อมูลส่วนบุคคลก่อให้เกิดกฎหมายความเป็นส่วนตัวที่ใช้คู่ขนาน GDPR (EU), CCPA/CPRA (California), LGPD (Brazil), DPDP (India, ทยอยมีผลบังคับใช้ถึง May 2027), KVKK (Türkiye) ล้วนใช้กับคลังข้อมูลฝึก AI ที่มีข้อมูลส่วนบุคคลของผู้อยู่อาศัยในเขตอำนาจเหล่านั้น ลบข้อมูลส่วนบุคคลออก; จัดทำเอกสารขั้นตอนการลบ
- การเปิดเผยข้อมูลในกระบวนการพิจารณาคดีเป็นเรื่องจริง NYT v OpenAI (คำวินิจฉัย SDNY เดือน Jan 2026): OpenAI ถูกบังคับให้ส่งมอบบันทึก ChatGPT ทั้งหมด 20M รายการแก่โจทก์ ไปป์ไลน์ AI สำหรับการใช้งานจริงควรตั้งสมมติฐานว่าท้ายที่สุดจะมีการเปิดเผยข้อมูล; เก็บบันทึกการ scraping, บันทึกการปฏิบัติตาม robots.txt, หนังสือรับรองแหล่งที่มาของ IP จากผู้ให้บริการ proxy และเอกสารใบอนุญาต
ข้อสรุปอย่างตรงไปตรงมา: การฝึกด้วยข้อมูลเว็บสาธารณะมีข้อโต้แย้งทางกฎหมายรองรับในปี 2026 ภายใต้ Bartz/Kadrey + hiQ + Meta v Bright Data ความเสี่ยงจากสัญญาของผู้เผยแพร่ (Reddit/SO/ผู้ลงนาม RSL) คือจุดเสี่ยงที่แท้จริง การ scraping ข้อมูลส่วนบุคคลมีความเสี่ยงสูงที่สุด ขอคำปรึกษาจากที่ปรึกษากฎหมาย US + EU + กฎหมายความเป็นส่วนตัวในเขตอำนาจที่เกี่ยวข้อง + ธุรกรรมเทคโนโลยีก่อนขยายขนาด นี่ไม่ใช่คำแนะนำทางกฎหมาย
วิธีเลือกเครื่องมือขูดเว็บ AI
กรอบการตัดสินใจสามขั้นตอน:
- โครงสร้างผลลัพธ์ ไปป์ไลน์ RAG / บริบทของเอเจนต์ → Firecrawl, Crawl4AI, Olostep, Spider.cloud (รองรับมาร์กดาวน์สำหรับ LLM โดยตรง) การดึงข้อมูลทั่วไป → Apify, Octoparse, Browse AI, ScrapingBee (ประมวลผลภายหลัง) เป้าหมายเฉพาะทาง (Amazon/Google/LinkedIn/Reddit) → Bright Data Web Scraper, ปลายทางแบบมีโครงสร้างของ ScraperAPI
2. ความต้องการรับมือบอต เป้าหมายสาธารณะ + มีการป้องกันต่ำ (Wikipedia, Common Crawl, GitHub, arXiv, API สาธารณะ) → พร็อกซีดาต้าเซ็นเตอร์ + Crawl4AI หรือ Apify-cheap-actors ใช้ได้ เป้าหมายที่ป้องกันระดับกลาง (ข่าวส่วนใหญ่ ฟอรัม แค็ตตาล็อกอีคอมเมิร์ซ) → ScrapingBee/ScraperAPI/Firecrawl/Apify แบบที่อยู่อาศัย เป้าหมายที่ยาก (มีการป้องกันด้วย Cloudflare/Akamai/PerimeterX/HUMAN) → ZenRows เฉพาะทาง, Bright Data Web Scraper หรือ Crawl4AI + แบบที่อยู่อาศัยระดับพรีเมียม
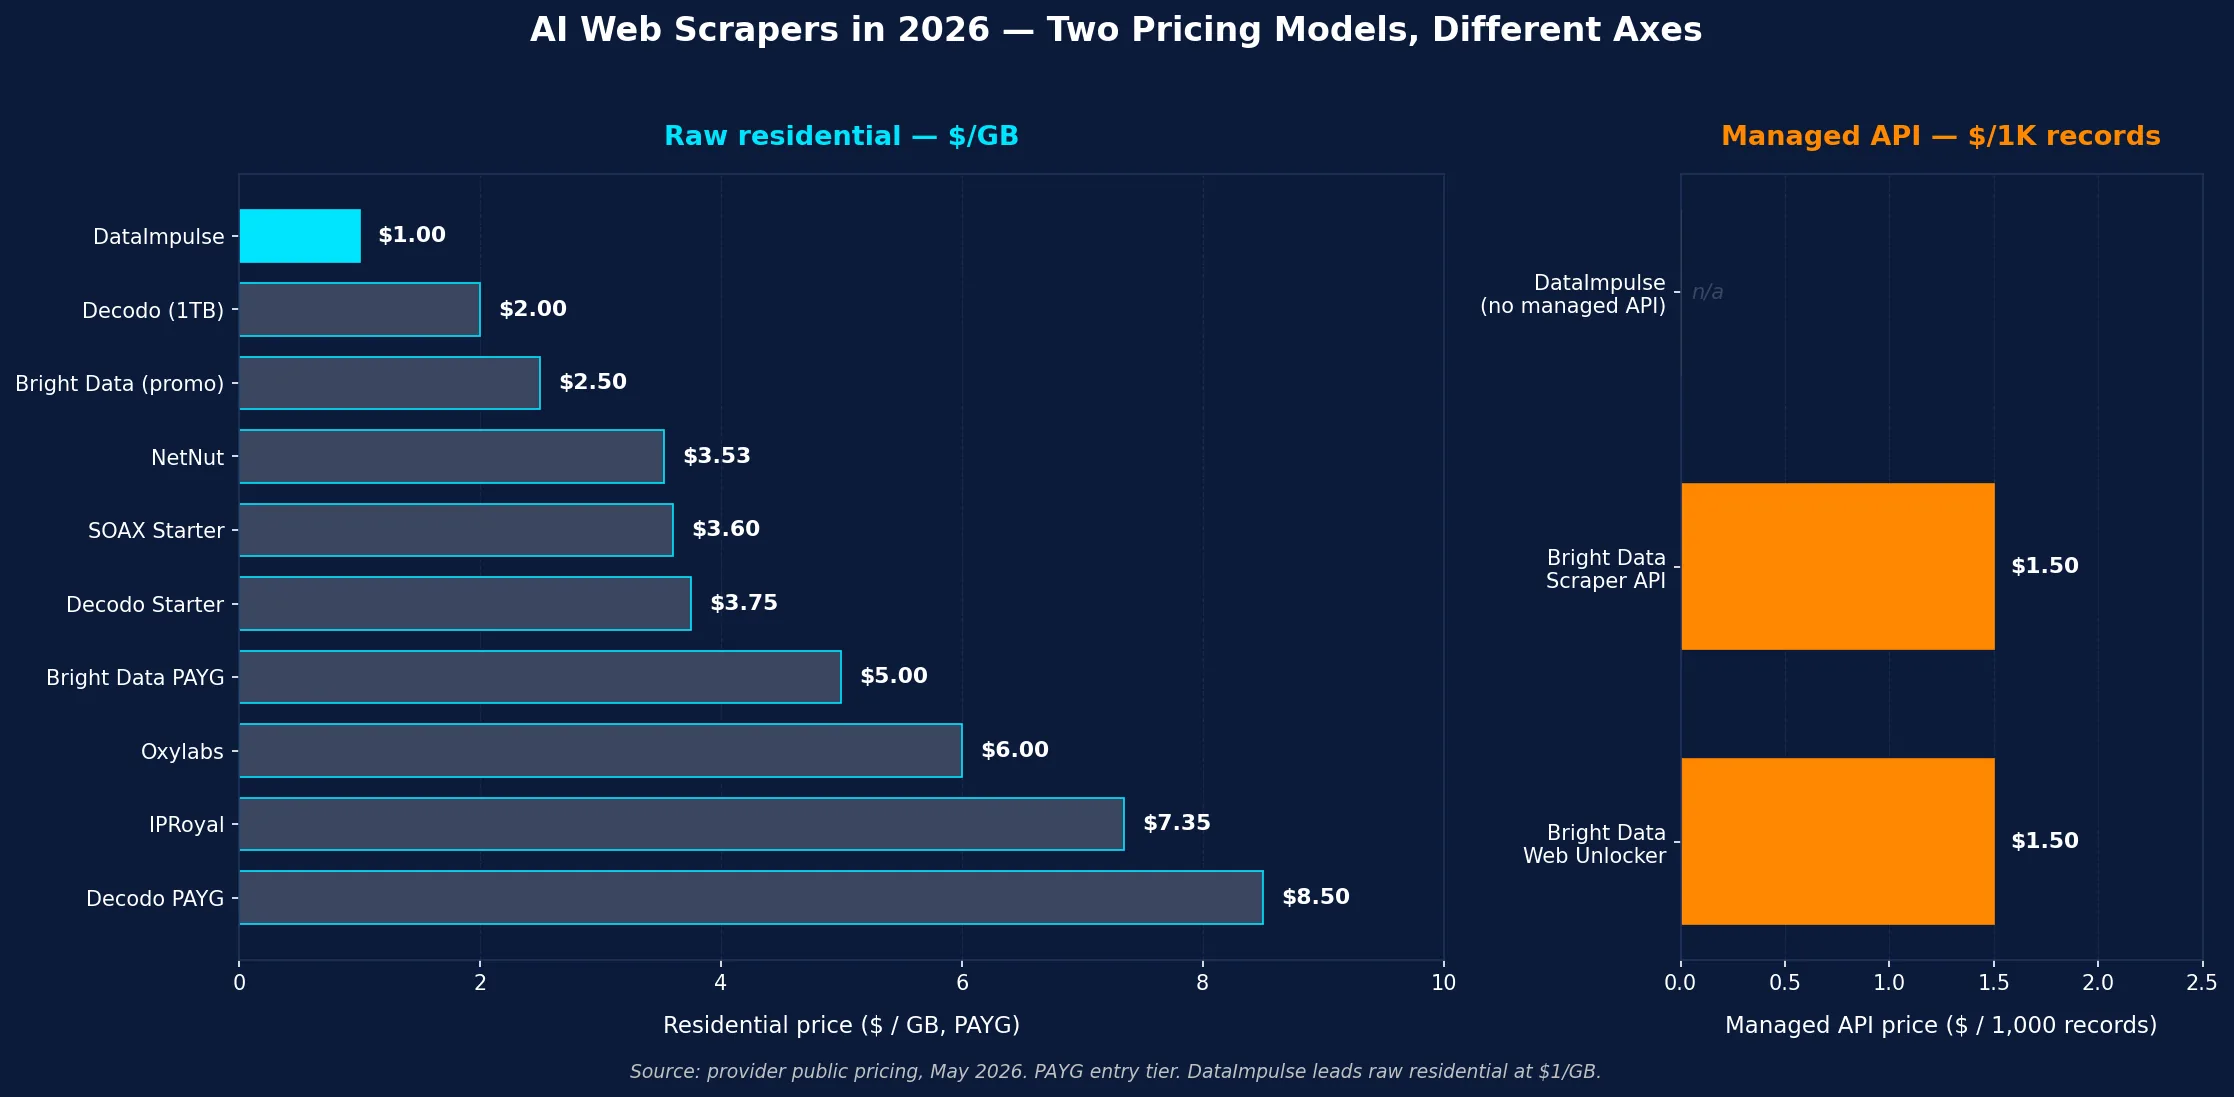
3. ปริมาณ + งบประมาณ <10K หน้าต่อเดือน → บริการจัดการราคาประหยัด (Browse AI, Firecrawl Hobby, Decodo Scraping API) 10K-1M หน้าต่อเดือน → บริการจัดการระดับกลาง (Firecrawl Growth, ScrapingBee, ScraperAPI, Apify, Octoparse) 1M+ หน้าต่อเดือน → บริการจัดการระดับองค์กร (Bright Data ต่อระเบียน, Oxylabs) หรือ Crawl4AI ที่โฮสต์เอง + DataImpulse แบบที่อยู่อาศัย ที่ $1/GB สำหรับทีม AI/ML ที่ใช้งานจริงส่วนใหญ่ในปี 2026 คำตอบคือ สแตก: Firecrawl สำหรับการนำเข้า RAG/LLM จากแหล่งข้อมูลคุณภาพสูง + Apify สำหรับการครอบคลุมมาร์เก็ตเพลสอย่างกว้างขวาง + Crawl4AI + DataImpulse แบบที่อยู่อาศัยที่อยู่เบื้องล่างสำหรับไปป์ไลน์ที่สร้างเองซึ่งต้องการการตรวจสอบแหล่งที่มาของ IP และการควบคุมต้นทุนตามปริมาณ + Bright Data Web Scraper สำหรับเป้าหมายระดับองค์กรที่ยากที่สุดเพียงไม่กี่แห่ง อย่าเลือกเครื่องมือเดียว; ให้เลือกสแตกแบบเป็นชั้น
สำหรับข้อมูลเพิ่มเติมเกี่ยวกับโครงสร้างพื้นฐานพร็อกซีที่อยู่เบื้องล่าง โปรดดู หน้าผลิตภัณฑ์พร็อกซีแบบที่อยู่อาศัย, หน้าผลิตภัณฑ์พร็อกซีดาต้าเซ็นเตอร์ (สำหรับชั้นข้อมูลสาธารณะ เช่นมิเรอร์ Common Crawl), บทสรุป พร็อกซีที่ดีที่สุดสำหรับการเก็บรวบรวมข้อมูลฝึก ML & AI และบทสรุป พร็อกซีที่ดีที่สุดสำหรับการขูดเว็บ
คำถามที่พบบ่อย
เครื่องมือดึงข้อมูลเว็บด้วย AI ตัวใดดีที่สุดสำหรับไปป์ไลน์ RAG ในปี 2026?
Firecrawl เป็นผู้นำสำหรับ RAG โดยสร้างมาเฉพาะเพื่อเอาต์พุต markdown ที่พร้อมสำหรับ LLM อ้างว่าสามารถใช้โทเค็นน้อยกว่า HTML ดิบ ~67% (ประหยัดค่าโทเค็นในขั้นตอนปลายทาง) มีการผสานรวม LangChain + LlamaIndex แบบเนทีฟ และรองรับเซิร์ฟเวอร์ MCP สำหรับเอเจนต์เขียนโค้ด AI ราคาเริ่มต้น $16/mo และ $0.0008/scrape เมื่อใช้งานในระดับใหญ่ Crawl4AI เป็นทางเลือกโอเพนซอร์สสำหรับทีมที่ต้องการการควบคุมเต็มรูปแบบ + เส้นทางตรวจสอบแหล่งที่มาของ IP
Apify เทียบกับ Firecrawl เลือกตัวไหน?
Apify เหนือกว่าด้านความหลากหลายของมาร์เก็ตเพลส (10K+ Actors ครอบคลุมเป้าหมายทั่วไปส่วนใหญ่) และเป็นตัวเลือกที่เหมาะเมื่อคุณต้องการเครื่องมือดึงข้อมูลสำหรับเว็บไซต์หลากหลายแห่ง Firecrawl เหนือกว่าด้านความสอดคล้องกับไปป์ไลน์ LLM ราคาต่อหน้าที่คาดการณ์ได้ และความง่ายต่อการใช้งานสำหรับการนำข้อมูลเข้า RAG/เอเจนต์ สำหรับเวิร์กโฟลว์ AI สมัยใหม่ส่วนใหญ่ Firecrawl ให้ ROI ดีกว่า Apify แต่สำหรับการดึงข้อมูลแบบเดิมจากหลายเว็บไซต์ Apify เหนือกว่า หลายทีมใช้ทั้งสองตัว
Crawl4AI ดีพอจริงหรือเมื่อเทียบกับเครื่องมือดึงข้อมูลแบบเสียเงิน?
ใช่ แต่มีข้อควรพิจารณา Crawl4AI เป็นโอเพนซอร์ส รองรับ AI โดยกำเนิด ผสานรวม LangChain/LlamaIndex ส่งคืน markdown + JSON ที่พร้อมสำหรับ LLM และใช้งานฟรี ข้อแลกเปลี่ยนคือการต่อต้านบอต: Crawl4AI ทำงานผ่าน Playwright โหมดพรางตัว + พร็อกซีที่คุณนำมาเอง ดังนั้นสำหรับเป้าหมายที่มีการป้องกันเข้มงวด (Cloudflare/Akamai/PerimeterX) คุณต้องใช้คู่กับพร็อกซีสำหรับที่อยู่อาศัยหรือระดับพรีเมียม สำหรับทีม ML ที่ใช้งานพร็อกซีอยู่แล้ว (DataImpulse สำหรับที่อยู่อาศัยที่ $1/GB) และต้องการเส้นทางตรวจสอบแหล่งที่มาของ IP นั้น Crawl4AI เป็นตัวเลือกที่เหมาะ
เครื่องมือดึงข้อมูลด้วย AI ตัวใดมีการหลบเลี่ยงการต่อต้านบอตดีที่สุด?
ตามเกณฑ์เปรียบเทียบของ Scrapeway 2024-2025: Bright Data Web Scraper API มีอัตราความสำเร็จเฉลี่ย ~98% และทำได้ 100% บน Indeed, Zillow, Capterra, Google ZenRows เชี่ยวชาญด้านการหลบเลี่ยง Cloudflare/DataDome/PerimeterX/HUMAN ด้วยอัตราความสำเร็จระดับกลาง สำหรับทีมส่วนใหญ่ที่ไม่ต้องการ 98% นั้น ScrapingBee + พร็อกซีสำหรับที่อยู่อาศัยระดับพรีเมียม หรือ Firecrawl ในแพ็กเกจระดับสูงกว่ารับมือเป้าหมายระดับ 1 ได้
การดึงข้อมูลเว็บด้วย AI ถูกกฎหมายหรือไม่?
การฝึกด้วยข้อมูลเว็บสาธารณะถือเป็นการใช้งานโดยชอบธรรมภายใต้ Bartz v Anthropic (มิ.ย. 2025) + Kadrey v Meta (มิ.ย. 2025); การดึงข้อมูลสาธารณะปลอดภัยตาม CFAA ภายใต้ hiQ + Meta v Bright Data แต่สัญญาของผู้เผยแพร่ (Reddit ToS, Stack Overflow แบบจ่ายต่อการรวบรวมข้อมูล, ผู้ลงนาม RSL) สามารถบังคับใช้ได้ โดย Reddit ฟ้อง Anthropic + Perplexity ฐานดึงข้อมูลโดยไม่มีใบอนุญาต ข้อมูลส่วนบุคคลทำให้เกิดข้อบังคับ GDPR/CCPA/LGPD/DPDP/KVKK ขอคำปรึกษาทางกฎหมายก่อนขยายขนาด นี่ไม่ใช่คำแนะนำทางกฎหมาย
เครื่องมือดึงข้อมูลเว็บด้วย AI ตัวใดถูกที่สุด?
Crawl4AI (ฟรี โฮสต์เอง) ถูกที่สุดหากคุณมีวิศวกรคอยดูแลการทำงาน + พร็อกซีเบื้องหลัง ในบรรดา API แบบจัดการให้: Firecrawl ($16/mo, 5K credits), Decodo Web Scraping API ($19/mo), Browse AI ระดับเริ่มต้น ($19/mo) อยู่ในระดับงบประมาณที่ถูกที่สุด สำหรับการควบคุมต้นทุนปริมาณงานมากกว่า 1M หน้า/เดือน การโฮสต์ Crawl4AI เอง + DataImpulse สำหรับที่อยู่อาศัยที่ $1/GB เหนือกว่า API แบบจัดการทุกตัว
ฉันยังต้องใช้พร็อกซีหรือไม่หากใช้เครื่องมือดึงข้อมูลด้วย AI แบบจัดการให้?
สำหรับ API แบบจัดการให้ที่รวมทุกอย่างแล้ว (Bright Data Web Scraper, Oxylabs Web Scraper, Zyte, ZenRows, ScraperAPI) จะรวมพร็อกซีไว้แล้ว คุณไม่ต้องซื้อแยก สำหรับเครื่องมือดึงข้อมูลแบบรวมบางส่วนหรือให้นำของตนเองมา (Apify ที่ใช้ BYO, Firecrawl ในแพ็กเกจระดับล่าง, Crawl4AI, สแต็ก Scrapy + Playwright) พร็อกซีสำหรับที่อยู่อาศัย ($1/GB บน DataImpulse) คือชั้นพื้นฐาน ข้อแลกเปลี่ยนคือ API แบบจัดการให้มีค่าใช้จ่ายรวม $1.30-$1.50/1K ระเบียน; การสร้างเองด้วยพร็อกซีดิบมีค่าใช้จ่าย ~$0.50-$1/1K เมื่อใช้ในปริมาณมาก แต่ต้องใช้เวลาวิศวกรรม
ฉันจะดึงข้อมูลจาก Reddit + Stack Overflow โดยไม่ทำให้การเข้าถึงของฉันเสียได้อย่างไร?
สำหรับ Reddit และ Stack Overflow โดยเฉพาะ เส้นทางทางกฎหมายในปี 2026 คือ: Reddit Data API (มีใบอนุญาต) หรือ Stack Overflow Stack Exchange API (จำกัดอัตรา) การดึงข้อมูลโดยไม่มีใบอนุญาตทำให้เสี่ยงต่อการผิดสัญญา โดย Reddit ฟ้อง Anthropic (มิ.ย. 2025) และ Perplexity + Oxylabs (ต.ค. 2025) หากจำเป็นต้องดึงข้อมูล: พร็อกซีสำหรับที่อยู่อาศัยหรือ ISP (DataImpulse สำหรับที่อยู่อาศัยที่ $1/GB หรือ Decodo ISP ที่ $0.27/IP) + จังหวะที่ช้าแบบมนุษย์ + Playwright โหมดพรางตัว หรือใช้ชุดข้อมูล Reddit ที่มีใบอนุญาตของ Bright Data (เสียเงิน และสามารถป้องกันได้ในการตรวจสอบ)
โอเพนซอร์สเทียบกับแบบจัดการให้ ควรเปลี่ยนเมื่อใด?
เปลี่ยนไปใช้โอเพนซอร์ส (Crawl4AI, Scrapy, Playwright) เมื่อ: (a) คุณประมวลผล 1M+ หน้า/เดือน และค่าใช้จ่าย API แบบจัดการสูงกว่าเวลาวิศวกรรมที่ใช้ดูแลแบบโฮสต์เอง; (b) คุณต้องการเส้นทางตรวจสอบแหล่งที่มาของ IP (หลังคำวินิจฉัยการเปิดเผยข้อมูลใน มกราคม 2026 หลัง NYT-v-OpenAI การเปิดเผยข้อมูลการฝึกเป็นเรื่องจริง); (c) ทีมของคุณต้องการควบคุมรูปร่างข้อมูลและไปป์ไลน์อย่างเต็มที่ ใช้แบบจัดการให้ต่อเมื่อ: เวลาจนได้ข้อมูลชุดแรกสำคัญกว่าค่าใช้จ่ายต่อหน้า ทีมของคุณไม่มีขีดความสามารถด้านปฏิบัติการ Playwright/พร็อกซี หรือคุณต้องการ SLA + สถานะการปฏิบัติตามข้อกำหนด (ISO 27001 + SOC 2) สำหรับการจัดซื้อ
พร้อมใช้งานการขูดเว็บด้วย AI พร้อมเลเยอร์พร็อกซีที่ทำงานอยู่เบื้องหลังตัวขูดเว็บโอเพนซอร์สใดก็ได้ (Crawl4AI, Scrapy, Playwright) หรือใช้งานคู่กับ API แบบมีการจัดการที่ต้องใช้ BYO หรือไม่? เริ่มต้นกับ DataImpulse – ที่อยู่อาศัยเริ่มต้นที่ $1/GB, ศูนย์ข้อมูลเริ่มต้นที่ $0.50/GB, มือถือเริ่มต้นที่ $2/GB, จ่ายตามการใช้งานด้วย IPs 90M+ ที่จัดหามาอย่างมีจริยธรรมใน 195 ประเทศ, รวมการกำหนดเป้าหมายระดับประเทศแล้ว (state/city/ZIP/ASN เป็นส่วนเสริมแบบชำระเงิน), ทราฟฟิกไม่มีวันหมดอายุ และมีฝ่ายสนับสนุนโดยมนุษย์ตลอด 24/7