
In this Article
Web scraping z Playwright ma sens wtedy, gdy autoryzowane zbieranie danych wymaga przeglądarki, która wyrenderuje rekordy lub pozwoli wejść w interakcję ze stroną. Niezawodny scraper w Pythonie musi potwierdzić, że zbiór danych jest gotowy, zwalidować jego pola i zakończyć pracę z jasnym statusem ukończenia.
W tym poradniku zbudujemy kontrolowany przykład na localhoście, wyeksportujemy zdeduplikowane rekordy do CSV i JSON oraz pokażemy, jak dostosować ten proces do paginacji. Nasz test z 15 października 2026 pokazuje też, dlaczego blokowanie obrazów może zmniejszyć liczbę przesłanych bajtów, nie przyspieszając przy tym ekstrakcji.
Najważniejsze fakty
- Zanim zaakceptujesz eksport, zastosuj 5-etapową kontrolę gotowości ekstrakcji.
- Środowisko testowe z poradnika zawiera 100 syntetycznych rekordów i opóźnia odpowiedź z danymi o 800 ms.
- Nasz test z 15 października 2026 obejmował dziesięć zmierzonych uruchomień dla każdego wariantu.
- Oba warianty odzyskały 100 ze 100 rekordów w każdym zmierzonym uruchomieniu.
- Blokowanie obrazów zmniejszyło medianę bajtów treści odpowiedzi serwowanych w naszym teście na localhoście o 99,7%.
- Blokowanie obrazów nie skróciło mediany czasu trwania w tej migawce.
Kiedy warto użyć Playwright do web scraping?
Wybierz przeglądarkę, gdy do pozyskania wymaganych rekordów konieczne jest renderowanie albo dozwolona interakcja. Najpierw sprawdź, czy autoryzowane API, eksport lub zwykła odpowiedź HTML nie spełniają już Twoich wymagań.
Zanim wybierzesz narzędzia, zdefiniuj zakres zbierania danych: dozwolone adresy URL, wymagane pola, stabilne identyfikatory, oczekiwane pokrycie i budżet żądań. Dzięki temu sam fakt udanego załadowania strony nie stanie się jedyną miarą sukcesu.
| Opcja | Użyj X, gdy… | Unikaj X, gdy… |
|---|---|---|
| Oficjalne API/eksport | Użyj oficjalnego API/eksportu, gdy autoryzowany dostęp dostarcza potrzebne pola. | Unikaj API/eksportu, gdy wymagane dane są niedostępne albo dostęp nie jest autoryzowany. |
| Klient HTTP/parser | Użyj klienta HTTP/parsera, gdy HTML odpowiedzi zawiera wymagane rekordy. | Unikaj klienta HTTP/parsera, gdy wymagane rekordy potrzebują wykonania kodu w przeglądarce. |
| Playwright | Użyj Playwright, gdy konieczne jest renderowanie albo dozwolona interakcja. | Unikaj Playwright, gdy prostsza, dozwolona droga spełnia wymaganie. |
| Proxy | Użyj proxy, gdy autoryzowane zbieranie danych wymaga routingu regionalnego lub zarządzania sesją. | Unikaj proxy, gdy celem jest obejście ograniczeń lub limitów zapytań. |
Tło tej decyzji o renderowaniu znajdziesz w naszym poradniku o scrapowaniu dynamicznych stron. Automatyzacja przeglądarki powinna odpowiadać na konkretną potrzebę dostępu do danych, a nie stawać się domyślnym rozwiązaniem dla każdego adresu URL.
Jak zacząć web scraping z Playwright w Pythonie?
Zainstaluj pakiet Pythona, przeglądarkę i wymagane biblioteki Linuksa, a potem zacznij od środowiska testowego, które sam kontrolujesz. Trzymaj je osobno od scrapera, by móc odtwarzać wolne odpowiedzi i błędy ekstrakcji.
Sam pakiet Pythona nie wystarcza do działającej instalacji przeglądarki (stan na październik 2026). Postępuj zgodnie z oficjalnymi instrukcjami: konfiguracja biblioteki Pythona i zależności przeglądarki. Instalacja zależności może wymagać uprawnień administratora.
python3 -m venv .venv
source .venv/bin/activate
python -m pip install playwright==1.58.0
python -m playwright install --with-deps chromium
W tym przykładzie użyj Pythona 3.12. Zapisz poniższy kod jako fixture.py. Serwer nasłuchuje wyłącznie na localhoście, zwraca 100 syntetycznych rekordów po 800 ms opóźnienia po stronie serwera i serwuje dziesięć obrazów, każdy o rozmiarze dokładnie 200 000 bajtów. Udane zapisy treści odpowiedzi są logowane jako CSV na standardowym wyjściu.
import csv
import json
import sys
import threading
import time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from urllib.parse import urlsplit

RECORDS = [{"id": str(i), "name": f"Item {i:03d}"}
           for i in range(1, 101)]
SVG = b'<svg xmlns="http://www.w3.org/2000/svg" width="1" height="1"/>'
IMAGE = SVG.ljust(200_000, b" ")
IMAGES = "".join(f'<img src="/image/{i}.svg" alt="">' for i in range(10))
HTML = ("""<!doctype html>
<html><head><meta charset="utf-8">
<link rel="icon" href="data:,"><title>Local records</title>
</head><body data-ready="0"><main id="records"></main>
""" + IMAGES + """
<script>
fetch('/records').then(response => {
  if (!response.ok) throw new Error('Data request failed');
  return response.json();
}).then(records => {
  const root = document.querySelector('#records');
  for (const record of records) {
    const row = document.createElement('article');
    row.dataset.id = record.id;
    const name = document.createElement('span');
    name.className = 'name';
    name.textContent = record.name;
    row.append(name);
    root.append(row);
  }
  document.body.dataset.ready = '1';
}).catch(error => {
  document.body.dataset.error = error.message;
});
</script></body></html>""").encode()

writer = csv.writer(sys.stdout)
lock = threading.Lock()
writer.writerow(["time_ns", "path", "status", "body_bytes"])
sys.stdout.flush()

class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        path = urlsplit(self.path).path
        status = 200
        if path == "/":
            body, kind = HTML, "text/html; charset=utf-8"
        elif path == "/records":
            time.sleep(0.8)
            body, kind = json.dumps(RECORDS).encode(), "application/json"
        elif path in {f"/image/{i}.svg" for i in range(10)}:
            body, kind = IMAGE, "image/svg+xml"
        else:
            status = 404
            body, kind = b"Not found", "text/plain"
        self.send_response(status)
        self.send_header("Content-Type", kind)
        self.send_header("Content-Length", str(len(body)))
        self.send_header("Cache-Control", "no-store")
        self.end_headers()
        try:
            self.wfile.write(body)
            self.wfile.flush()
        except (BrokenPipeError, ConnectionResetError):
            return
        with lock:
            writer.writerow([time.time_ns(), path, status, len(body)])
            sys.stdout.flush()

    def log_message(self, format, *args):
        pass

ThreadingHTTPServer(("127.0.0.1", 8000), Handler).serve_forever()
Uruchom serwer w jednym terminalu, a scraper z następnej sekcji w drugim, z aktywnym środowiskiem wirtualnym.
python fixture.py > server-log.csvOba skrypty uruchomiliśmy 15 października 2026: każdy wariant zwrócił 100 zwalidowanych rekordów bez brakujących pól. Odtwarzają one charakter obciążenia z naszego pomiaru, ale dokładne liczby bajtów mogą się różnić od tych z tabeli. Oczekiwany poprawny wynik to 100 zwalidowanych rekordów, nagłówek CSV plus 100 wierszy danych oraz tablica JSON zawierająca 100 obiektów.
Skąd wiesz, że dynamiczna treść jest gotowa?
Zastosuj 5-etapową kontrolę gotowości ekstrakcji: zgoda, status odpowiedzi, sygnał gotowości, walidacja pól i kompletność. Traktuj każdy etap jako warunek, który może zawieść niezależnie od pozostałych.
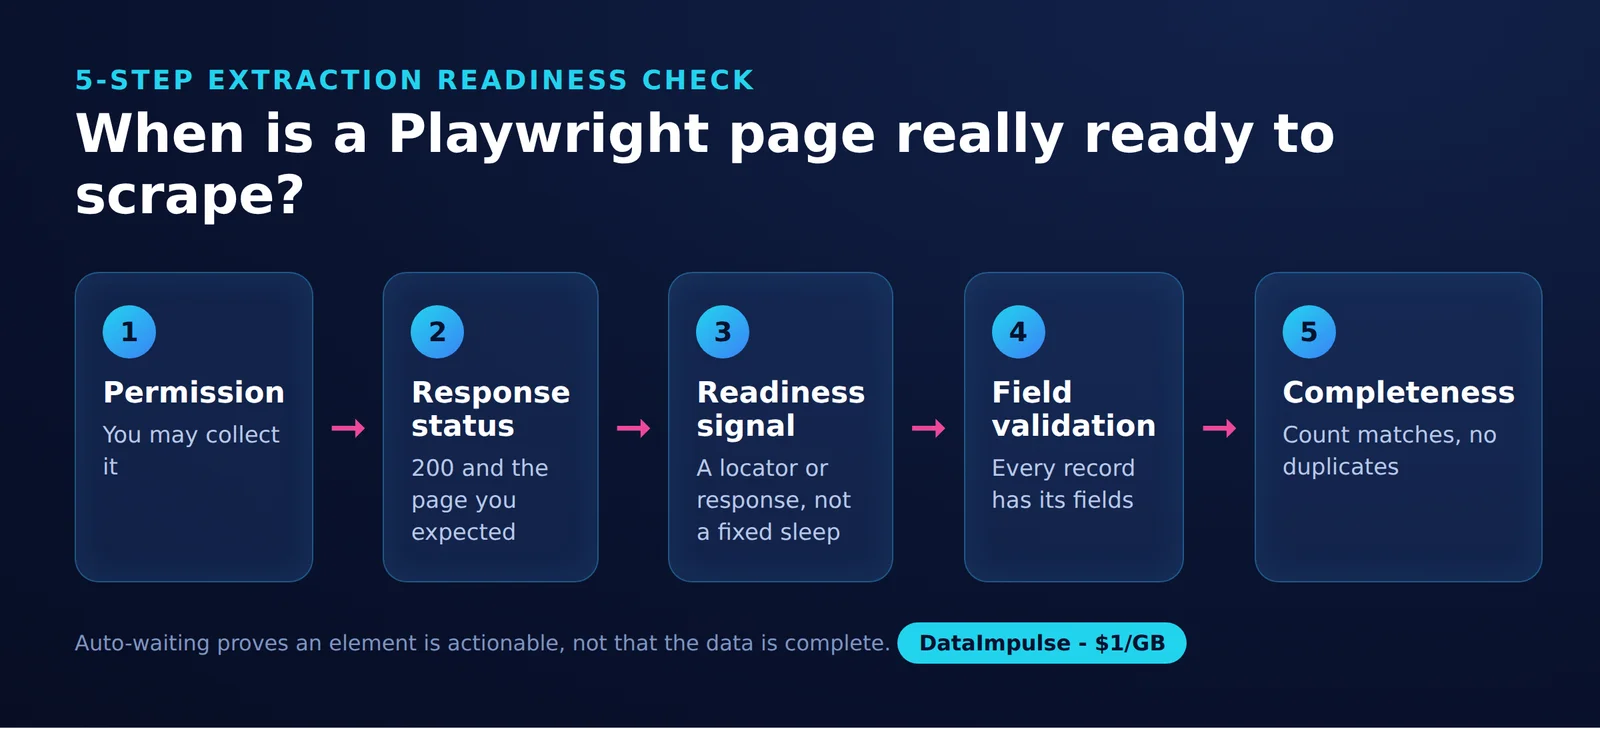
Etap 1: Zgoda. Upewnij się, że planowane zbieranie i ponowne wykorzystanie danych jest autoryzowane. Zapisz zakres, zanim otworzysz jakiekolwiek strony, łącznie z ograniczeniami dotyczącymi częstotliwości, pól, przechowywania lub redystrybucji.
Etap 2: Status odpowiedzi. Sprawdź zarówno dokument, jak i odpowiedź niosącą rekordy. Udany szkielet HTML nie dowodzi, że zapytanie o dane się powiodło, a strona błędu również może zawierać w pełni poprawny HTML.
Etap 3: Sygnał gotowości. Czekaj na warunek specyficzny dla aplikacji. Nasze środowisko testowe ustawia body[data-ready=’1′] dopiero po wstawieniu wszystkich rekordów, więc scraper czeka na ten atrybut, zamiast zgadywać opóźnienie.
Etap 4: Walidacja pól. Wymagaj niepustego identyfikatora i nazwy w każdym wierszu. Osobno zdecyduj, jak reprezentować wartości naprawdę opcjonalne, i nie zamieniaj po cichu brakującego wymaganego pola na pusty ciąg znaków.
Etap 5: Kompletność. Porównaj unikalne identyfikatory z oczekiwaną sumą lub jawnym znacznikiem końca. Jeden widoczny rekord świadczy o postępie, a nie o kompletnym zbiorze danych. Jeśli źródło nie podaje wiarygodnej sumy, opisz dokładnie, który warunek zatrzymania wyznacza pokrycie.
Kontrole actionability w Playwright nie potwierdzają kompletności zbioru danych, a dokumentacja klasy Page odradza używanie networkidle jako ogólnego warunku gotowości (stan na październik 2026). Zobacz oficjalne materiały: kontrole auto-waiting i API gotowości i nawigacji strony.
W web scraping z Playwright stałe opóźnienia (sleep) powodują dwa problemy: marnują czas przy szybkich odpowiedziach i prowadzą do przedwczesnej ekstrakcji przy wolnych. Zamiast tego ogranicz czasowo oczekiwanie na sensowny warunek.
Jak wyodrębnić rekordy i wyeksportować je do CSV lub JSON?
Po osiągnięciu gotowości pobierz spójną migawkę, zwaliduj każde wymagane pole i przed zapisem zdeduplikuj dane według stabilnego identyfikatora. Oddziel walidację od serializacji, aby błędne rekordy nie mogły po cichu zamienić się w udany eksport.
Zapisz ten kod jako scrape.py. Ekstrakcja opiera się na jawnym kontrakcie data-id z naszego środowiska testowego. Zobacz oficjalny przewodnik po lokatorach i dokumentację evaluate_all. Dziesięciosekundowe limity czasu i oczekiwana liczba rekordów to wybory właściwe dla tego przykładu.
import argparse
import csv
import json
from pathlib import Path
from time import perf_counter
from playwright.sync_api import sync_playwright

URL = "http://127.0.0.1:8000/"
EXPECTED_IDS = {str(i) for i in range(1, 101)}


def run(block_images=False, headed=False):
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=not headed)
        context = browser.new_context()
        try:
            page = context.new_page()
            page.set_default_timeout(10_000)
            page.set_default_navigation_timeout(10_000)
            if block_images:
                page.route(
                    "**/*",
                    lambda route: route.abort()
                    if route.request.resource_type == "image"
                    else route.continue_(),
                )
            started = perf_counter()
            with page.expect_response(URL + "records") as pending:
                response = page.goto(URL, wait_until="domcontentloaded")
            if response is None or response.status != 200:
                raise RuntimeError("Document request failed")
            if pending.value.status != 200:
                raise RuntimeError("Records request failed")
            page.locator("body[data-ready='1']").wait_for(state="attached")
            raw = page.locator("#records article").evaluate_all("""
                nodes => nodes.map(node => ({
                    id: node.getAttribute('data-id'),
                    name: node.querySelector('.name')?.textContent ?? null
                }))
            """)
            unique = {}
            for item in raw:
                if not isinstance(item["id"], str) or not item["id"].strip():
                    raise ValueError("Missing required id")
                if not isinstance(item["name"], str) or not item["name"].strip():
                    raise ValueError("Missing required name")
                row = {
                    "id": item["id"].strip(),
                    "name": " ".join(item["name"].split()),
                }
                previous = unique.get(row["id"])
                if previous is not None and previous != row:
                    raise ValueError("Conflicting duplicate id")
                unique[row["id"]] = row
            if set(unique) != EXPECTED_IDS:
                raise ValueError("Incomplete or unexpected identifier set")
            rows = sorted(unique.values(), key=lambda row: int(row["id"]))
            variant = "blocked" if block_images else "baseline"
            output = Path("output") / variant
            output.mkdir(parents=True, exist_ok=True)
            csv_path = output / "records.csv"
            json_path = output / "records.json"
            csv_temp = output / "records.csv.tmp"
            json_temp = output / "records.json.tmp"
            with csv_temp.open("w", newline="", encoding="utf-8") as handle:
                writer = csv.DictWriter(handle, fieldnames=["id", "name"])
                writer.writeheader()
                writer.writerows(rows)
            json_temp.write_text(
                json.dumps(rows, ensure_ascii=False, indent=2) + "\n",
                encoding="utf-8",
            )
            csv_temp.replace(csv_path)
            json_temp.replace(json_path)
            elapsed_ms = (perf_counter() - started) * 1000
            print(json.dumps({
                "variant": variant,
                "records": len(rows),
                "missing_required_fields": 0,
                "duration_ms": round(elapsed_ms, 1),
            }))
        finally:
            try:
                context.close()
            finally:
                browser.close()


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--block-images", action="store_true")
    parser.add_argument("--headed", action="store_true")
    args = parser.parse_args()
    run(args.block_images, args.headed)
python scrape.py
python scrape.py --block-imagesIdentyczne duplikaty zlewają się w jeden rekord, a sprzeczne duplikaty powodują błąd. Nazwy przechodzą normalizację białych znaków, natomiast identyfikatory zachowują swoje oryginalne znaczenie. Dla innego zbioru danych zdefiniuj własny schemat, zamiast przenosić regułę sortowania numerycznego z naszego środowiska testowego.
Skrypt waliduje dane przed zapisem i podmienia każdy ukończony plik tymczasowy. Obie podmiany nie tworzą transakcji: konsumenci produkcyjni powinni wymagać manifestu sukcesu całego uruchomienia, zanim odczytają oba pliki. Nieudana próba może pozostawić starszy, poprawny eksport, więc jeśli chcesz zachować historię, używaj osobnych katalogów dla każdego uruchomienia.
Jeśli zewnętrzny tekst trafia do arkuszy kalkulacyjnych, wybierz jawną politykę wobec wstrzykiwania formuł. Samo cytowanie w CSV nie powinno być Twoją granicą zaufania. Transformację bezpieczną dla arkuszy trzymaj osobno od danych kanonicznych.
Jak obsłużyć paginację, Load More i infinite scroll?
Zbieraj rekordy po każdym potwierdzonym zdarzeniu postępu i utrzymuj jedną mapę identyfikatorów przez cały przebieg. Zatrzymuj się na udokumentowanym warunku końca albo zadeklarowanym limicie bezpieczeństwa i rozróżniaj te przypadki w metadanych eksportu.
Numerowane strony: wyodrębnij bieżącą stronę, zanim klikniesz Dalej. Zapisz token bieżącej strony, wykonaj interakcję, a potem sprawdź, czy token lub identyfikatory rekordów się zmieniły. Kliknięcie, które wraca na tę samą stronę, nie jest postępem.
Load More: zapamiętaj bieżący zbiór identyfikatorów i uzbrój nasłuch oczekiwanej odpowiedzi z danymi, zanim klikniesz. Zwaliduj odpowiedź, poczekaj na odpowiadającą jej aktualizację renderowania i scal nowo widoczne rekordy. Zatrzymaj się, gdy aplikacja wyraźnie wskaże, że nie ma kolejnych wyników.
Infinite scroll: wyodrębnij każdą widoczną partię, zanim przewiniesz stronę ponownie. Niektóre interfejsy recyklują wiersze, więc czekanie z odczytem DOM do samego końca może zgubić wcześniejsze rekordy. Śledź skumulowane unikalne identyfikatory, a nie tylko liczbę aktualnie zamontowanych elementów.
Ustaw jawne budżety, na przykład 50 interakcji, 5000 rekordów i pięć minut. To ilustracyjne limity inżynieryjne, a nie dopuszczalne wartości usługi. Sprawdzaj upływający czas między operacjami i ogranicz poszczególne oczekiwania do pozostałego budżetu.
Powtórzony kursor, nieudana odpowiedź z danymi lub kilka interakcji bez nowych identyfikatorów powinny zakończyć próbę z podaniem przyczyny. Nie uznawaj zatrzymanego przebiegu za ukończony tylko dlatego, że liczba rekordów przestała rosnąć, bo kolejna partia mogła się nie załadować.
Przy zmieniających się zbiorach danych zapisuj też czas zbierania i kolejność. Deduplikacja zapobiega powtórzeniom identyfikatorów, ale nie dowodzi, że żaden rekord nie przeskoczył między stronami w trakcie zbierania. Jeśli autoryzowane źródło oferuje stabilną migawkę lub kontrakt oparty na kursorze, wybierz go.
Kiedy czytać odpowiedzi JSON zamiast DOM?
Czytaj odpowiedź JSON, gdy jest częścią autoryzowanego procesu i zawiera wymagane pola z czytelniejszymi identyfikatorami lub metadanymi paginacji. Zaobserwowanie odpowiedzi nie daje prawa do samodzielnego wywoływania jej endpointu.
W przykładzie w Pythonie nasłuch odpowiedzi jest uzbrajany przed nawigacją, aby mógł przechwycić żądanie rekordów z naszego środowiska testowego. W przypadku zatwierdzonej aplikacji dopasuj docelowy endpoint precyzyjnie, a przed zaakceptowaniem rekordów zwaliduj jego status, typ treści, schemat i stan paginacji.
Przechwytywanie ruchu sieciowego ma ograniczenie: service workery mogą sprawić, że oczekiwane zdarzenia routingu będą niedostępne (stan na październik 2026). Dokumentacja sieci opisuje obserwowanie odpowiedzi, routing żądań i diagnozowanie problemów z service workerami. Zanim zmienisz środowisko wykonawcze aplikacji, zbadaj jej zachowanie.
Wybierz jedno źródło prawdy dla każdego pola. Odpowiedź może zawierać surowe wartości, a DOM zlokalizowany tekst do wyświetlenia. Łączenie ich bez identyfikatora może dać wiarygodnie wyglądające, ale błędne wiersze. Gdy mają znaczenie, zapisuj jawnie kody walut, jednostki i znaczniki czasu.
Nie rozszerzaj zbierania na niepowiązane pola tylko dlatego, że pojawiają się w ładunku odpowiedzi. Niezależnie od tego, czy rekordy pochodzą z HTML, czy z JSON, obowiązują te same wymagania dotyczące zgody, minimalizacji, walidacji i kompletności.
Jak diagnozować błędy i kontrolować zużycie zasobów?
Klasyfikuj błędy, zanim ponowisz próbę, i mierz zmiany w zużyciu zasobów w odniesieniu do kompletności rekordów. Mniejsza liczba bajtów ma wartość tylko wtedy, gdy wymagane dane przetrwają.
- Przekroczenie czasu: zanim wydłużysz limit, sprawdź warunek gotowości, status odpowiedzi z danymi i bieżący stan strony.
- Brakujące pola: porównaj nieudany wiersz ze schematem i zbadaj zmiany układu strony lub częściowe renderowanie.
- HTTP 401 lub 403: zatrzymaj się i sprawdź autoryzację, zamiast zmieniać tożsamość.
- HTTP 429 lub chwilowa awaria serwera: zmniejsz obciążenie i zastosuj ograniczone w czasie planowanie zgodnie z odpowiedzią.
- CAPTCHA: zatrzymaj automatyzację i zgłoś sprawę właścicielowi strony lub skorzystaj z zatwierdzonej drogi dostępu.
Parametr max_retries w APIRequestContext Playwright nie ponawia żądań po kodach statusu HTTP (stan na październik 2026). Dokumentacja kontekstu żądań opisuje ponowienia po błędach sieciowych, więc nawigacja w przeglądarce również wymaga własnej, jawnej obsługi statusów.
Dla autoryzowanej polityki ponowień wybierz maksymalną liczbę prób i łączne okno ponawiania. Parsuj nagłówek Retry-After jako liczbę sekund albo datę HTTP, tak jak opisuje dokumentacja MDN o Retry-After. Jeśli żądane opóźnienie przekracza pozostałe okno, odłóż zadanie zamiast ponawiać je zbyt wcześnie. Zapisz ostateczną przyczynę niepowodzenia.
Do diagnozy wizualnej uruchom przykład z opcją –headed w sesji graficznej. Przyjrzyj się stronie, zanim zmienisz selektory. Oficjalny przewodnik po bibliotece Pythona opisuje tryb headed oraz API synchroniczne i asynchroniczne. W obrębie jednego workera trzymaj się jednego stylu API.
Przy współbieżnym zbieraniu danych użyj wykonania asynchronicznego z semaforem, ograniczoną kolejką zadań i regułą tempa dla każdego źródła (origin). Zacznij od jednej aktywnej strony i zwiększaj liczbę ostrożnie, mierząc pamięć, czas trwania i błędy. Sam limit współbieżności nie jest limitem częstotliwości żądań. Zamykaj każdy kontekst w bloku finally, także po błędach walidacji. Szersze kompromisy dotyczące zasobów omawia nasz poradnik o przeglądarkach headless.
Nasz test z 15 października 2026: o 16:25 UTC porównaliśmy standardowe ładowanie z blokowaniem żądań o obrazy na naszym środowisku testowym na localhoście. Środowisko to Python 3.12.3, Playwright 1.58.0, headless Chromium i Linux z 6 vCPU. Pojemność RAM, model procesora i dokładna wersja Chromium nie zostały zapisane w podsumowaniu pomiaru.
Strona renderowała 100 rekordów przez fetch() po opóźnieniu 800 ms i zawierała dziesięć obrazów po 200 KB. Każdy wariant miał jedno uruchomienie rozgrzewkowe, a po nim dziesięć zmierzonych uruchomień, wykonywanych na przemian, za każdym razem w nowym kontekście. Oba używały body[data-ready=’1′] oraz locator.evaluate_all; wariant z blokowaniem przerywał żądania obrazów, zachowując skrypty i CSS.
Mierzyliśmy czas od nawigacji do zwalidowanego eksportu, bajty treści odpowiedzi serwowane według logów serwera, liczbę zakończonych żądań, unikalne rekordy i błędy. To migawka jednego środowiska testowego, a nie benchmark.
| Wariant | Mediana czasu trwania | Mediana serwowanych bajtów | Mediana żądań | Unikalne rekordy | Błędy |
|---|---|---|---|---|---|
| Bazowy | 917,0 ms | 2 005 642 | 12 | 100/100 w każdym uruchomieniu | 0/10 |
| Obrazy zablokowane | 925,2 ms | 5 642 | 2 | 100/100 w każdym uruchomieniu | 0/10 |
Blokowanie zmniejszyło liczbę serwowanych bajtów o 99,7%, ale mediana czasu trwania wzrosła o 8,2 ms. W tym lokalnym obciążeniu dominowało deterministyczne opóźnienie danych. Wynik nie dowodzi przewagi szybkościowej, wydajności w internecie, rozliczeń za proxy ani odsetka odblokowań. Mniejszy płatny ruch może obniżyć opłaty za transfer, ale bajty treści odpowiedzi serwera nie są pomiarem rozliczeniowym.
Oryginalne pliki CSV z poszczególnych uruchomień i liczby brakujących pól nie są dostępne do wglądu, więc nie podajemy oszacowania zmienności ani wyniku dotyczącego brakujących pól. Środowisko do odtworzenia testu generuje nowe logi żądań. Zachowaj je razem z wynikami poszczególnych uruchomień, zamiast traktować tę zbiorczą tabelę jako surowe obserwacje.
Jak Playwright wypada na tle Selenium i Puppeteer?
Wybieraj, kierując się istniejącym kodem w Twoim zespole i interakcją, którą musisz utrzymać. Ten lokalny eksperyment nie pozwala uszeregować frameworków do automatyzacji przeglądarki.
Zakres obsługiwanych przeglądarek w Puppeteer nie ogranicza się do samego Chrome (stan na październik 2026): jego oficjalna tabela zgodności przeglądarek obejmuje Chrome i Firefox. Selenium dokumentuje sterowanie przeglądarką przez WebDriver oraz automatyczne zarządzanie sterownikami przez Selenium Manager, więc nie zakładaj, że ręczne pobieranie sterowników jest zawsze konieczne.
- Wybierz Playwright dla przepływu pracy w Pythonie z tego poradnika i jawnego kontraktu gotowości.
- Zostań przy Selenium, gdy istniejąca implementacja WebDriver już spełnia kontrakt zbierania danych.
- Rozważ Puppeteer, gdy Twój zespół już utrzymuje w nim wymagany proces obsługi przeglądarki.
Dla zwięzłego odpowiednika w JavaScript zapisz poniższy kod jako scrape.mjs i zostaw uruchomione środowisko testowe na localhoście. Pokazuje on gotowość i walidację, a nie powtarza całego potoku eksportu. Instalacja przebiega zgodnie z oficjalną dokumentacją biblioteki JavaScript.
npm install [email protected]
npx playwright install --with-deps chromium
node scrape.mjs
import { chromium } from 'playwright';
const browser = await chromium.launch();
try {
const page = await browser.newPage();
page.setDefaultTimeout(10000);
const response = await page.goto('http://127.0.0.1:8000/', {
waitUntil: 'domcontentloaded',
timeout: 10000
});
if (!response || response.status() !== 200) {
throw new Error('Document request failed');
}
await page.locator("body[data-ready='1']").waitFor({ state: 'attached' });
const rows = await page.locator('#records article').evaluateAll(nodes =>
nodes.map(node => ({
id: node.dataset.id,
name: node.querySelector('.name')?.textContent?.trim()
}))
);
if (rows.some(row => !row.id || !row.name)) {
throw new Error('Missing required field');
}
const unique = new Map();
for (const row of rows) {
if (unique.has(row.id) && unique.get(row.id).name !== row.name) {
throw new Error('Conflicting duplicate');
}
unique.set(row.id, row);
}
const expected = Array.from({ length: 100 }, (_, i) => String(i + 1));
if (unique.size !== 100 || expected.some(id => !unique.has(id))) {
throw new Error('Unexpected identifier set');
}
console.log(JSON.stringify([...unique.values()], null, 2));
} finally {
await browser.close();
}Jeśli potrzebujesz większej implementacji w Node.js, przejdź do naszego poradnika o web scraping w JavaScript. Zmieniając język, zachowaj te same reguły walidacji pól i zakończenia pracy.
Kiedy proxy pomagają i jakie obowiązują granice?
Proxy pasują do autoryzowanego zbierania danych, które wymaga routingu regionalnego lub ciągłości sesji sieciowej. Nie naprawiają niepełnej ekstrakcji i nie zmieniają zgody powiązanej z zasobem.
Gdy liczy się ciągłość sesji, utrzymuj spójny routing przez cały wieloetapowy proces zbierania. Zmiana trasy między stronami może wprowadzić kolejną zmienną do i tak stanowego procesu. Różnicę wyjaśnia nasz poradnik o statycznym i dynamicznym IP.
Do wdrożenia skorzystaj z dedykowanego poradnika konfiguracji proxy w Playwright. Kryteria wyboru znajdziesz w zestawieniu najlepszych proxy dla Playwright. DataImpulse to infrastruktura proxy, a nie scraping API, zarządzane narzędzie do odblokowywania ani VPN.
Przestrzegaj reguł robots, ale nie traktuj ich jako zgody: RFC 9309 wyraźnie oddziela Robots Exclusion Protocol od autoryzacji dostępu. Sama publiczna widoczność nie rozstrzyga kwestii regulaminów, prywatności, praw autorskich ani wymogów właściwych dla danej jurysdykcji.
Gdy napotkasz ograniczenia dostępu lub wyzwania, zatrzymaj się i poszukaj zatwierdzonej drogi zbierania danych. Nie trzymaj poświadczeń w kodzie źródłowym ani w logach. Udany web scraping z Playwright powinien dać wyjaśnialny zbiór danych w autoryzowanym zakresie, z zapisaną przyczyną zatrzymania.
Najczęściej zadawane pytania
Czy Playwright nadaje się do web scraping?
Playwright to rozsądny wybór, gdy zbieranie danych wymaga treści renderowanej w przeglądarce lub dozwolonej interakcji. Jego przydatność zależy od procesu pracy, a nie od ogólnego rankingu szybkości. Jeśli prostszy autoryzowany eksport lub żądanie HTML już spełnia wymaganie, wybierz je.
Jak zescrapować stronę za pomocą Playwright w Pythonie?
Skonfiguruj pakiet i przeglądarkę, zdefiniuj dozwolony zakres zbierania i ustal warunek gotowości, zanim zaczniesz wyodrębniać rekordy. Przed eksportem zwaliduj wymagane pola i stabilne identyfikatory. Przykład na localhoście pokazuje tę kolejność, ale inna strona potrzebuje własnych selektorów i kontraktu kompletności.
Jak Playwright powinien czekać na dynamiczną treść?
Daj Playwright warunek powiązany z rekordami, które chcesz zebrać, na przykład znacznik ukończonej partii. Ogranicz czas oczekiwania i potem sprawdź uzyskany zbiór identyfikatorów. Widoczny pierwszy wiersz albo cicha sieć to za mało, by uznać, że pokrycie jest pełne.
Jak scrapować infinite scroll bez pomijania i dublowania rekordów?
W procesie z Playwright scalaj każdą zaobserwowaną partię w mapie indeksowanej stabilnym identyfikatorem źródła, zanim przewiniesz stronę ponownie. Wymagaj potwierdzonego postępu i zachowaj jawną przyczynę zatrzymania. Jeśli nie masz oczekiwanej sumy ani wiarygodnego sygnału końca, raportuj zaobserwowane pokrycie, zamiast twierdzić, że dane są kompletne.
Czy web scraping z Playwright jest legalny?
Wybór Playwright nie przesądza o tym, czy konkretne zbieranie danych jest zgodne z prawem. Oceń autoryzację, obowiązujące regulaminy, dane osobowe, prawa autorskie i jurysdykcję dla danego projektu. Jeśli zamierzone zbieranie lub ponowne wykorzystanie danych nadal budzi wątpliwości, skorzystaj z porady wykwalifikowanej osoby.
Czy blokowanie obrazów przyspiesza scraper?
Nasza migawka z localhosta wykazała mniejszą liczbę przesłanych bajtów treści odpowiedzi, ale nie krótszą medianę czasu trwania. Oba warianty czekały na ten sam opóźniony zbiór danych. Zmierz własne, dozwolone obciążenie i sprawdź kompletność, zanim uznasz blokowanie zasobów za optymalizację.
Czy scraper powinien ponawiać każdy błąd?
Nie. Odróżniaj tymczasowe problemy transportu lub serwera od błędów autoryzacji, wyzwań i błędów schematu. Stosuj ograniczoną politykę ponowień tylko tam, gdzie to właściwe, respektuj żądane opóźnienia i zachowuj nierozwiązane błędy do analizy.
Dodaj routing, gdy Twoje zbieranie danych tego wymaga
Najpierw zadbaj o niezawodną ekstrakcję, walidację i warunki zatrzymania. Jeśli Twój autoryzowany proces wymaga także routingu regionalnego lub zarządzania sesją, oceń DataImpulse residential proxy pod kątem tego wymagania i zmierz ruch, którego faktycznie używa Twój scraper.
Ostatnia aktualizacja: 15 października 2026.