
In this Article
ウェブスクレイピングは合法ですか?Web scrapingの合法性は、4つの要素に集約されます。何をスクレイピングするのか(公開されている製品価格か、個人プロフィールか)、どのようにスクレイピングするのか(公開ページか、ログイン後の領域か)、どこで事業を行うのか(米国のCFAAの考え方か、欧州のGDPRか)、そしてそのデータをどう使うのか(価格監視か、AIトレーニングか)です。したがって、「ウェブサイトからデータをスクレイピングすることは合法か」と問われた場合、率直な答えは、公開されている非個人データのスクレイピングは多くの法域で概ね合法である、というものです。ただし、これらの各要素によって、正当化可能なビジネス慣行と規制当局による措置との間を行き来することになります。本ガイドでは、画期的な判例、2025–2026年のAI時代の訴訟、主要な規制当局の見解、そして実務的なコンプライアンスの枠組みを解説します。
まず、重要な点として、これは一般的な情報であり、法的助言ではありません。商用スクレイピングの仕組みを拡大する前に、自社の法域および対象サイトの法域における法的助言を求めてください。
要点
- 公開されている非個人データのスクレイピングは、一般に合法とされています。ただし、詳細(何を、どのように、どこで、なぜ)がすべてを左右します。
- 個人データにおいて「公開されていることは、自由に取得してよいことを意味しません。EU規制当局はこれに対して制裁金を科しています(Clearview: €30.5M Netherlands, €20M Italy, £7.5M UK)。
- ログアウト状態とログイン状態の差が、判例上も重要な境界線になっています。ログアウト状態で公開データをスクレイピングする行為は、法的に正当化しやすいものです(hiQ, Meta v. Bright Data)。一方、同意した利用規約に反してログイン後の領域で行う場合は、そうではありません。
- AI時代により、契約、ライセンス、著作権に関する請求が加わりました。収集の合法性とトレーニングの合法性は、現在では別個の問題です。
- プロキシそのものは合法です。合法性を決めるのはツールではなく、その活動です。
質問別の簡潔な回答
| 質問 | 短い答え |
|---|---|
| 公開されている製品/価格データのスクレイピングは合法ですか? | 一般的には合法です。法的に最も正当化しやすい類型の一つです |
| 個人データ(氏名、プロフィール、連絡先)のスクレイピングは合法ですか? | リスクが高い行為です。データが公開されている場合でも、GDPR規制当局は制裁金を科しています |
| ログイン後の領域をスクレイピングすることは合法ですか? | リスクがあります。利用規約に同意しているため、CFAAが成立しない場合でも契約上の請求は残ります |
| robots.txtに違反することは違法ですか? | それ自体が法律ではありませんが、裁判所や規制当局は悪意の証拠として扱います |
| プロキシの使用は合法ですか? | 合法です。合法性を決めるのはツールではなく、その行為です |
| AIトレーニング目的のスクレイピングは合法ですか? | 結論はまだ定まっていません。適法に取得されたデータについてはフェアユースの勝訴例がありますが、契約/ライセンス関連の訴訟が増えています |
ウェブスクレイピングの合法性に関するよくある誤解
ウェブスクレイピングの合法性に関する混乱の多くは、技術的に可能なことと法的に許されることを混同することから生じます。詳細に入る前に、3つの誤解を解消しておきましょう。
誤解1:ウェブスクレイピングはハッキングである
公開ページのスクレイピングは、それ自体が不正アクセスに当たるわけではありません。ボットは通常のブラウザと同じページをリクエストしているだけです。米国第9巡回区控訴裁判所のhiQ v. LinkedIn(2022年)では、認証ゲートを回避していない場合、公開ページのスクレイピングはCFAAに違反しない可能性が高いと判断されました。「画面スクレイピングは合法ですか?」という質問もありますが、答えは同じです。通常のブラウザと同じ方法で公開ページを読み取ることは「ハッキング」ではありません。
誤解2:「公開データ」は自由に取得してよいという意味である
公開されているからといって、無制限に利用できるわけではありません。個人データは、誰でも見られる状態で公開されていても保護対象のままです。欧州の規制当局は、公開されている個人データのスクレイピングに対して制裁金を科しています。著作権は公開記事や画像にも引き続き適用されます。また、ログインなしでも利用規約に拘束される場合があります。つまり、本当に問うべきなのは「データスクレイピングは合法か?」は、データの性質によって大きく左右されます。
誤解3:利用規約違反は犯罪である
利用規約への違反は民事上の問題であり、刑事上の問題ではありません。利用規約違反が自動的に違法行為になるわけではありません。ただし、ブロックされる理由、民事訴訟の根拠、そして裁判における悪意の証拠にはなり得ます。ウェブスクレイピングに関する利用規約については、以下で詳しく説明します。
米国:CFAA、hiQ、そして契約上の論点
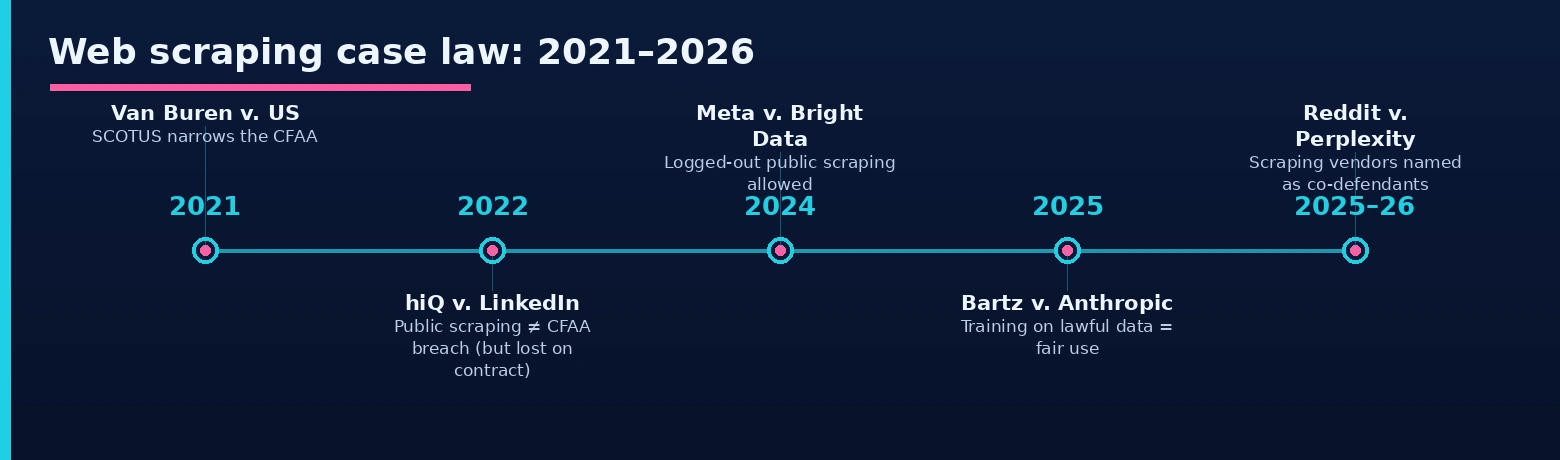
根本的な問い、すなわち米国でウェブサイトをスクレイピングすることは合法かという点は、、公開ページのスクレイピングが、ハッキングを対象とするComputer Fraud and Abuse Actにおける「無権限アクセス」に当たるかどうかに帰着しました。第9巡回区控訴裁判所は、hiQ Labs v. LinkedIn(2022年、最高裁のVan Burenの論理を適用)で、当たらないと判断しました。ページが認証情報なしで誰にでも開かれている場合、突破すべき認可ゲートは存在しないため、公開データのスクレイピングはCFAA違反ではありません。
しかし、hiQの全体像こそが本当の教訓です。CFAAをめぐる争点では勝ったものの、hiQは最終的に敗れました。2022年11月、裁判所はhiQがLinkedInの利用規約に違反した(アカウント作成により同意していた)と判断し、この件は同意判決で終結しました。CFAAは公開ページに関するハッキング主張からあなたを守りますが、あなたが同意した契約からは守ってくれません。
Meta v. Bright Data(2024年1月)は、その線引きをより明確にしました。裁判所は、Bright Dataが公開され、ログアウト状態で閲覧可能なFacebookおよびInstagramページをスクレイピングしたことについて、契約違反とは認めませんでした。なぜなら、プラットフォームの規約はアカウント保有者を対象とするものであり、ログアウト状態の訪問者を対象とするものではないからです。この判決から読み取れる原則は、ログアウト状態の公開スクレイピングは抗弁可能であり、同意済み規約に反するログイン状態でのスクレイピングはそうではないというものです。従来の動産不法侵害に関する事例(eBay v. Bidder’s Edge、2000年)は、極端なアクセス量の場合にはなお影響を持ち、州のプライバシー法(CaliforniaのCCPA/CPRA、VirginiaのVCDPA)は、その上に個人データに関する義務を追加します。
利用規約:Browsewrap、Clickwrap、そしてルールが法的リスクになる場合
利用規約は法律そのものではありませんが、裁判所はそれを重視します。そして重要な論点は、ユーザーが実際にそれを受諾したかどうかです。
BrowsewrapとClickwrap:どちらの利用規約が実際に拘束力を持つのか
browsewrap 契約とは、ページ上のどこかにリンクが置かれているだけで、能動的な同意を伴わないものです。裁判所が、クリックしていない相手に対してこれを強制することはほとんどありません。clickwrap 契約では、チェックボックスや「同意する」ボタンなどの明示的な操作が必要であり、裁判所はほぼ常にこれを執行します。実務上の境界線は、能動的に受諾した条件(通常はアカウント作成時)はユーザーを拘束し、単に見られた可能性があるだけの条件は拘束しないことが多い、という点です。
ToS 違反が法的証拠になるとき
ウェブスクレイピングに関する利用規約に違反すること自体は刑事犯罪ではありませんが、実務上は3つの影響があります。プラットフォームは直ちにあなたをブロックできること、民事上の契約違反訴訟の根拠になり得ること(最終的に hiQ を破綻させた主張)、そして CFAA または関連する請求が裁判に至った場合に、悪意ある行為として受け取られることです。
AI時代:状況を一変させた2025-2026年の訴訟
AIトレーニングをめぐり、スクレイピング関連訴訟の第二波が起きています。それは「アクセスは許可されていたのか」という問題よりも、契約、ライセンス、著作権に関するものです(AIトレーニングデータ収集向けプロキシを形作るのと同じ論点です):
- Bartz v. Anthropic(2025年6月、Alsup判事):合法的に入手した書籍でLLMをトレーニングすることは「きわめて変容的」なフェアユースであるとされました。ただし、この判決は海賊版のソースコピーを明示的に除外しました。データをどのように入手したかは、それを使って何をしたかと同じくらい重要です。
- Kadrey v. Meta(2025年6月、Chhabria判事):原告は提出した記録に基づいて敗訴しましたが、意見書はこれがAIトレーニングに対する広範な許可ではないと警告しました。これは限定的な勝訴であり、一般的な法理を確立したものではありません。
- Reddit v. Anthropic(2025年6月提訴):Redditは著作権ではなく、利用規約および不当利得の理論に基づいて訴えました。2026年3月下旬、連邦判事は請求が著作権法によって専占されないとして、訴訟をCalifornia州裁判所へ差し戻しました。これにより、契約ベースのスクレイピング請求には独立した有効性があることが確認されました。
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy(2025年10月、S.D.N.Y.):AI企業と並んでスクレイピングインフラベンダーを共同被告として名指しした初めての訴訟です。プロキシを利用する側にとっての要点は、サプライチェーンにあります。誰が、どのようにデータを収集するのかが、いまや法的リスクの一部になっています。
- NYT v. OpenAI(併合審理、S.D.N.Y.):2026年1月、裁判所は証拠開示において20-million-conversationのログサンプルを提出するようOpenAIに命じました。この訴訟は、モデルの「丸暗記出力」がフェアユースを損なうかどうかを検証するものです。
- ライセンス経済はこれと対をなす動きです:RedditはGoogle(約$60M/yr)およびOpenAIにデータをライセンス供与しています。CloudflareとStack Overflowは従量課金型のクロールを開始しました。「スクレイピング自由」と「トレーニング向けにライセンス済み」は、別の方向へ分かれつつあります。
欧州:GDPRと厳格な規制当局
EU(および英国)では、問題となるのは「アクセスが許可されていたか」ではなく、ほとんどの場合、「適法な根拠なく個人データを処理したか?」です。GDPRの下では、個人を識別するあらゆるデータ(氏名、写真、プロフィール、連絡先情報)をスクレイピングすることは「処理」に該当し、「公開されていた」こと自体は適法な根拠にはなりません。執行事例は明確です:
- オランダ(AP)。欧州で特に厳しい姿勢。2024年5月のガイダンスでは、個人データのスクレイピングを「ほぼ常にGDPR違反」とし、Clearview AIに€30.5 millionの制裁金を科し、取締役には個人責任の可能性が警告されました。
- イタリア(Garante)。Clearviewに€20 millionの制裁金を科しました。同機関が示した原則は、「公開されているなら取得してよい」という考えは誤りである、というものです。
- フランス(CNIL)。連絡先データブローカーKASPRに€240,000の制裁金を科しました(2024年12月)。2025年6月のガイダンスでは、公開されている個人データのスクレイピングを正当な利益に基づいて認めていますが、除外リスト、最小化、透明性などの保護措置がある場合に限られます。
- 英国(ICO)。Clearviewに£7.5 millionの制裁金を科しました。英国GDPRとData (Use and Access) Act 2025により、枠組みはEUの枠組みとの整合性が保たれています。
- EU全域:Database Directiveは、保護対象データベースの実質的部分を抽出する行為に対し、別個のsui generis権を追加しています。これは欧州にはある一方、米国にはない請求権です。
重要なニュアンスは、これらはいずれも非個人データを対象としていないという点です。価格、商品リスティング、在庫状況、ランキングはGDPRの適用範囲外であり、欧州の価格インテリジェンスやSEOのパイプラインは日常的に適法に運用されています。以下のリスクの整理は、個人データのスクレイピングリスクが法域によってどのように異なるかを示しています。
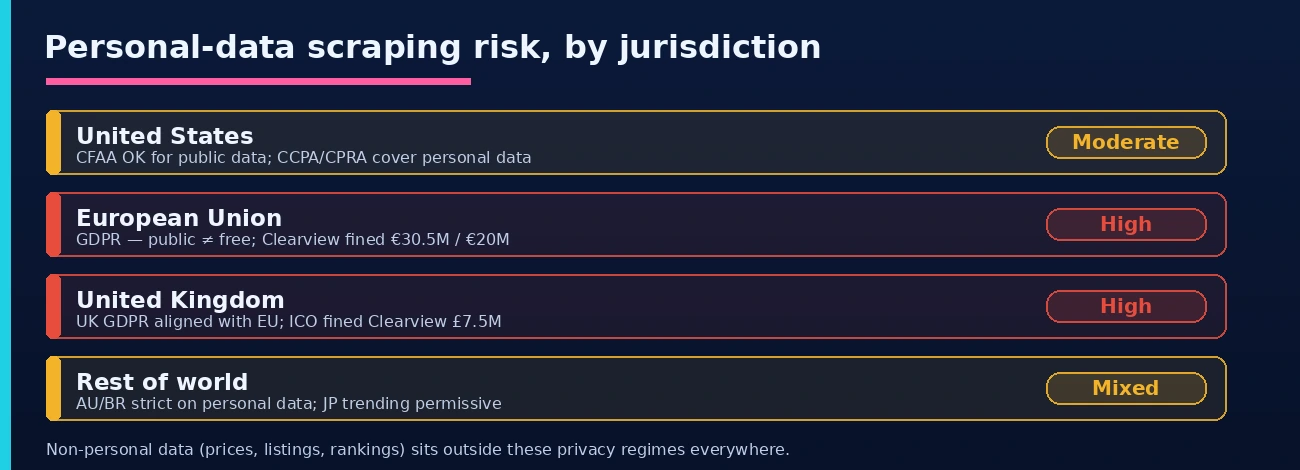
欧州と米国以外では、個人データのスクレイピングをめぐる状況は、厳格なものから比較的緩やかなものまで幅があります。
| 管轄区域 | フレームワーク | スクレイピングに対する立場 |
|---|---|---|
| Australia | Privacy Act 1988 + 2024 reform | 公開されている商品データは正当化可能ですが、個人データはそうではありません。 |
| Japan | APPI | 好意的な傾向です。2026年の改正により、公開データのAI利用が容易になる見込みです。 |
| Brazil | LGPD (ANPD) | Clearviewを含め、個人データに対する執行が活発です。 |
| India | DPDP Act 2023 | 個人データ規則は厳格化しており、AIトレーニング関連の訴訟が進行中です。 |
| China | PIPL + DSL + CSL | 個人データと越境移転に厳格であり、ローカライゼーションの確認が必要です。 |
特定市場について詳しく知りたい場合は、blog libraryにある各国ガイド(GermanyからJapanまで)に、事実確認済みの現地法務セクションが掲載されています。
著作権法:スクレイピングできるものと、できないもの
著作権は、スクレイピングにおける法的トラブルの最も一般的な原因の1つです。ただし、事実情報と創作的なコンテンツを切り分ければ、ほとんどのビジネス用途は比較的安全な範囲に収まります。
保護されるもの、保護されないもの
事実は著作権の対象になりません。価格、評価、在庫状況、仕様は自由に収集できるため、商品データのスクレイピングは比較的安全な範囲にあります。一方で、保護されるものは、記事、写真、動画、オリジナルの文章、データベースにおける創作的な選択や配列です。これらを丸ごと再公開すると、著作権侵害の主張が発生します。米国のDigital Millennium Copyright Act (DMCA) は別の形で関係します。単なる再公開とは別に、アクセス制御を回避したり、著作権管理情報を削除したりする場合です。
フェアユース(米国)とDSM Directive(EU):著作権保護コンテンツのスクレイピングが認められる場合
米国では、フェアユースは4つの要素で判断されます。利用の目的(変容的か、単に商業的か)、著作物の性質、利用した量、市場への影響です。Authors Guild v. Google(Google Books)は、変容的利用に関する代表的な判例です。EUでは、DSM Directiveにより、合法的なアクセス権があり、権利者がオプトアウトの意思表示をしていない場合(多くの場合 robots.txt で示されます)、テキストおよびデータマイニングが認められます。どちらも分析目的で著作権保護コンテンツをスクレイピングする余地を残していますが、丸ごとの再公開を許諾するものではありません。
正当化しやすい行為とリスクが高い行為
すべてのスクレイピングに同じリスクがあるわけではありません。それはデータの種類、アクセス方法、そして取得結果の利用方法によって異なります。以下の2つのリストで、自社のプロジェクトの位置づけをすばやく確認できます。
一般に正当化しやすい行為
- 非個人データの公開情報を読み取り専用で収集すること:価格、製品仕様、在庫、ランキング、検索結果、航空運賃、不動産リスティング
- ログアウト状態でのアクセスのみ。認証の背後にあるものは対象にしない
- 対象サイトのインフラに負担をかけない、人間の操作ペースに近いリクエスト頻度
- robots.txtおよび公開されているクロールポリシーの遵守
- 競合インテリジェンス、市場調査、SEOモニタリング、広告検証、集計データに基づく学術研究
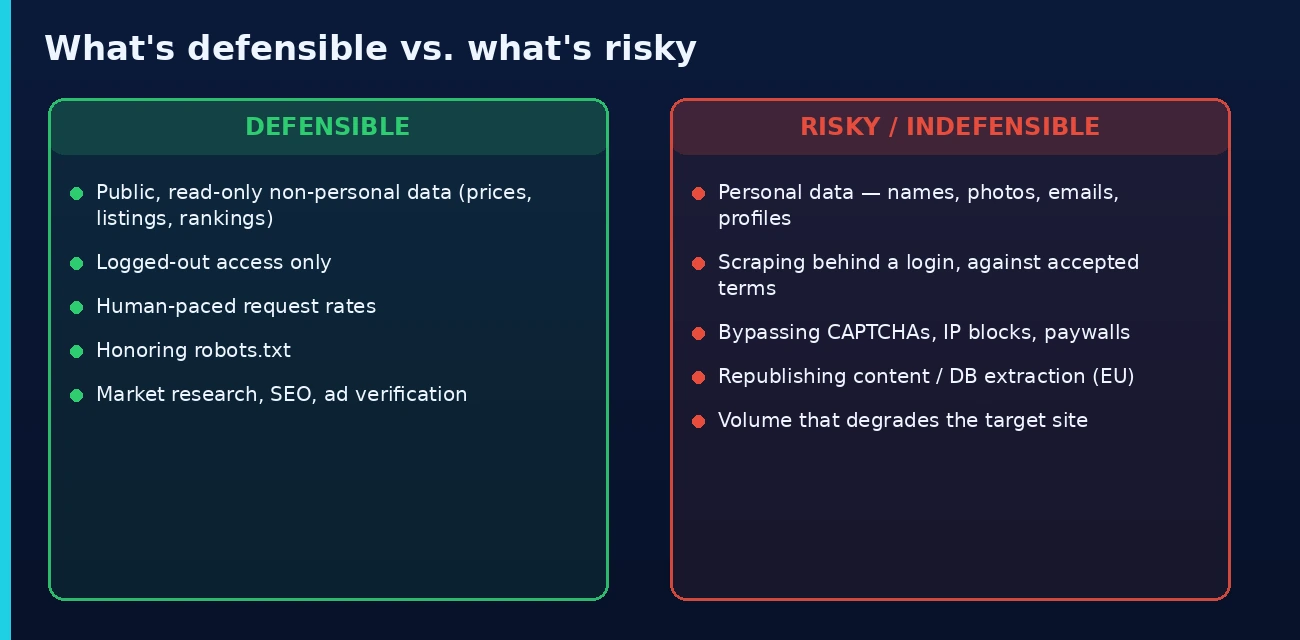
リスクが高く、正当化が困難なケース
- 個人データのスクレイピング:氏名、写真、メールアドレス、電話番号、プロフィール。特に大規模に行う場合、特に欧州では
- ログイン後の領域を、同意済みの規約に反してスクレイピングすること(hiQ契約からの教訓)
- 技術的障壁の回避:アクセス制御として提示されるCAPTCHA、あなたを特に対象としたIPブロック、ペイウォール
- スクレイピングしたコンテンツを丸ごと再公開すること(著作権)、または保護されたデータベースの実質的な部分を抽出すること(EUデータベース権)
- 対象サイトのパフォーマンスを低下させるほどの量(動産不法侵害のリスク)
- 海賊版または規約違反のソースから取得したコンテンツでAIをトレーニングすること(Bartzの例外)
スクレイピングチームのためのコンプライアンスチェックリスト
1. データの範囲を定義する。 あるフィールドが個人を特定し得る場合は、規制対象として扱います。削除するか、文書化された保護措置とともにGDPR上の適法根拠を確立してください(CNILの2025年版「正当な利益」シートが最適なテンプレートです)。
2. ログアウト状態を維持する。 公開ページのみに限定します。認証してログインした時点で、契約に同意したことになります。そして、勝ちやすいのは契約上の請求です。
3. サイトが示す方針を尊重する。 robots.txt、レート制限、crawl-delay。常に法的拘束力があるとは限りませんが、裁判所や規制当局が最初に確認するものです。
4. 節度ある運用を前提に設計する。 人間の閲覧に近いペース、再取得を避けるためのキャッシュ、過剰なアクセスをしないこと。スクレイピングをめぐる紛争を不法侵入の主張へと発展させるのはアクセス量です。
5. サプライチェーンに注意する。 Reddit v. Perplexityでは、AI購入者だけでなくスクレイピングベンダーも名指しされました。データプロバイダーがどのように収集しているかを把握してください。
6. 収集と利用は分けて考える。 適法な収集は、あらゆる利用を許可するものではありません。再公開、データベース抽出、AIトレーニングは、それぞれ個別の分析が必要です。
7. 規模を拡大する前に弁護士に相談する。 1日1,000リクエストでは問題ないパイプラインでも、1,000万リクエストではレビューが必要になる場合があります。
8. 倫理的に調達されたプロキシ基盤を選ぶ。 重要なのはツールそのものではなく、その調達方法です。プロキシは合法ですが、倫理的なウェブスクレイピングはIPがどのように取得されているかにも及びます。同意に基づく倫理的に調達されたレジデンシャルプロキシを使えば、サプライチェーンについて問われた場合でも、収集レイヤーの正当性を説明しやすくなります。
FAQ
ウェブスクレイピングは合法ですか?
公開されている非個人データのスクレイピングは、ほとんどの法域で一般に合法とされています。第9巡回区控訴裁判所のhiQ v. LinkedIn(2022)は、公開ページのスクレイピングが米国CFAA上の「不正アクセス」には当たらないことを確認しました。リスクは細部にあります。個人データ(Clearview関連事案ではGDPR制裁金が最大€30.5M)、同意済みの利用規約に反してログイン後の領域をスクレイピングすること(hiQが最終的に敗訴した理由)、技術的障壁の回避、著作権で保護されたコンテンツの再公開です。公開されている商品、価格、SERPデータを節度ある方法で収集することが、抗弁しやすい範囲です。
米国でウェブスクレイピングは合法ですか?
公開データについては一般的に合法です。hiQ v. LinkedInは、公開ページのスクレイピングがCFAAに違反しないことを確立し、Meta v. Bright Data(2024)は、ログアウト状態での公開Facebook/Instagramページのスクレイピング差し止めを認めませんでした。ただし契約上の請求は残ります。hiQは、同意していたLinkedInの規約違反で敗訴しました。また、極端な量のアクセスは不法侵入に関する請求のリスクがあります。州のプライバシー法(CCPA/CPRA)は、これに加えて個人データを規制します。
欧州のGDPR上、ウェブスクレイピングは合法ですか?
非個人データ(価格、リスティング、ランキング)はGDPRの適用範囲外です。欧州が厳格なのは個人データです。オランダAPは個人データのスクレイピングを「ほぼ常に違反」とし、Clearviewに€30.5Mの制裁金を科しました。イタリアのGaranteは€20M、フランスのCNILはKASPRに€240Kの制裁金を科しました。いずれも公開個人データのスクレイピングが対象です。CNILの2025年ガイダンスでは、文書化された保護措置がある場合に限り、正当な利益に基づく公開個人データのスクレイピングを認めています。
Amazon、Google、その他の大手プラットフォームを合法的にスクレイピングできますか?
ログアウト状態で、節度あるレートで公開の商品データや検索データを収集することは、他の場合と同じく抗弁しやすいカテゴリです。価格インテリジェンス業界やSEO業界はこのように運用されています。リスクはプラットフォームごとに異なります。ログインしないこと(規約)、個人データを取得しないこと(投稿者IDを含むレビューなど)、エンドポイントに過負荷をかけないこと、各プラットフォームの執行姿勢を把握することが重要です。プラットフォーム別ガイド(Amazon、Google Maps、LinkedIn、Reddit)では、具体的なケースとルールを解説しています。
AIトレーニング用のデータスクレイピングは合法ですか?
未確定であり、2つの論点に分かれています。収集については、すべてのスクレイピングと同じルールが適用されます。トレーニングについては、Bartz v. Anthropic(2025)が、合法的に取得された書籍でのトレーニングを変容的フェアユースと認定しましたが、海賊版ソースは除外しました。NYT v. OpenAIでは、出力の「丸写し」がフェアユースを否定するかが争われています。RedditによるAnthropicおよびPerplexity(ならびにそのスクレイピングベンダー)に対する契約ベースの訴訟は、初期の手続段階を通過しました。ライセンス済みデータとクリーンなサプライチェーンが、安全地帯になりつつあります。
プロキシの利用は合法ですか?
はい。プロキシは標準的なネットワークインフラであり、ほぼすべての場所で合法です。規制対象となるのは、プロキシ経由で行われる活動です。合法なスクレイピングはプロキシ経由でも合法であり、違法な収集はプロキシ経由でも違法です。倫理的に調達され、同意に基づくレジデンシャルプールを持つプロバイダーを選んでください。Reddit v. Perplexityでスクレイピングベンダーが被告として名指しされた後、収集インフラの由来はコンプライアンス上の説明責任の一部になっています。
robots.txtに違反するとスクレイピングは違法になりますか?
robots.txtは法律ではなく、無視したからといって自動的に違法になるわけではありません。ただし、裁判所や規制当局はこれを善意または悪意を示す要素として扱います。複数の判決が、不法侵入や契約上の請求を検討する際にrobots.txtに言及しており、CNILの保護措置でもオプトアウトの尊重が求められています。実務上、robots.txtを尊重するコストは小さく、法的に正当化しやすくなります。
hiQ v. LinkedInでは何が起きたのですか? 1段落で教えてください。
hiQはHR分析のために公開LinkedInプロフィールをスクレイピングしました。LinkedInは停止通告書を送り、hiQは提訴し、注目された争点では勝訴しました。第9巡回区控訴裁判所は(2022)、公開ページのスクレイピングはCFAA違反ではないと判断しました。その後、LinkedInが実質的に勝利しました。裁判所は、hiQが同意していたUser Agreementに違反したと認定し、事件は同意判決で終了しました。ここから得られる二つの教訓は、公開スクレイピングはハッキングではない一方で、同意した契約は執行可能だということです。
結論
では、ウェブスクレイピングは合法なのでしょうか?公開されている非個人データのスクレイピングは、一般に合法で、法的にも正当化しやすいものです。ただし、最大のリスクは 個人データ(GDPRおよび世界各国の同等規制)、同意した利用規約に反するアクセス(hiQで認められた契約上の請求であり、現在の AI 時代の訴訟を牽引しているもの)、そして創作コンテンツに関する 著作権 の3つです。ログアウトした状態を維持し、非個人データを収集し、robots.txtを尊重し、収集と利用を分離してください。2026年以降は、サプライチェーンもコンプライアンスの一部です。データ、そしてプロキシがどこから来ているかも、今では法的な全体像の一部になっています。インフラ側については、ウェブスクレイピングに最適なプロキシをご覧ください。これはあくまで一般的な情報であり、法的助言ではありません。具体的なケースについては法的助言を求めてください。
最終更新日:2026年6月24日。