
In this Article
¿Es legal el web scraping? La legalidad de web scraping se reduce a cuatro cosas:quéraspas (precios públicos de productos versus perfiles personales),cómolo raspas (páginas públicas versus detrás de un inicio de sesión),dóndeusted opera (la lógica CFAA de EE. UU. frente a la RGPD de Europa), yQue hacescon los datos (seguimiento de precios versus entrenamiento de IA). Entonces, cuando la gente pregunta “¿es legal extraer datos de sitios web?”, la respuesta honesta es que extraer datos no personales disponibles públicamente es ampliamente legal en la mayoría de las jurisdicciones, pero cada uno de esos factores lo mueve entre una práctica comercial defendible y una acción regulatoria. Esta guía recorre los casos históricos, las demandas de la era de la IA de 2025-2026, la posición de cada regulador importante y un marco de cumplimiento práctico.
Una cosa por adelantado:Esta es información general, no asesoramiento legal.Antes de escalar un oleoducto de scraping comercial, busque asesoramiento legal en su jurisdicción y en la de sus objetivos.
Hechos clave
- La web scraping públicos y no personales es ampliamente legal– los detalles (qué, cómo, dónde, por qué) lo deciden todo.
- “Público” no significa “libre acceso” para datos personales– Los reguladores de la UE multan por ello (Clearview: €30.5M en Países Bajos, €20M en Italia, £7.5M en Reino Unido).
- Cerrar sesión versus iniciar sesión es la línea que sigue ganando– el scraping público desconectado es defendible (hiQ, Meta v. Bright Data); detrás de un inicio de sesión según los términos aceptados no lo es.
- La era de la IA añadió reclamaciones de contratos, licencias y derechos de autor– la legalidad derecopilacióny decapacitaciónAhora son preguntas separadas.
- Los proxies en sí son legales– la actividad, no la herramienta, determina la legalidad.
La respuesta corta, por pregunta
| Pregunta | respuesta corta |
|---|---|
| ¿Es legal extraer datos públicos de productos/precios? | Generalmente si– la categoría más defendible en todas partes |
| ¿Es legal extraer datos personales (nombres, perfiles, contactos)? | Alto riesgo– Los reguladores RGPD lo multan incluso cuando los datos son públicos |
| ¿Es legal raspar detrás de un inicio de sesión? | Arriesgado– has aceptado los términos; Los reclamos contractuales sobreviven incluso donde falla CFAA |
| ¿Es ilegal violar robots.txt? | No es una ley en sí misma, pero los tribunales y los reguladores la tratan como prueba de mala fe. |
| ¿Es legal el uso de poderes? | Sí– la actividad, no la herramienta, determina la legalidad |
| ¿Es legal el scraping para el entrenamiento de IA? | Inestable– el uso legítimo gana para los datos obtenidos legalmente, pero las demandas por contratos/licencias se están multiplicando |
Mitos comunes sobre la legalidad del web scraping
La mayor confusión sobre la legalidad de web scraping proviene de mezclar la capacidad técnica con el permiso legal. Vale la pena aclarar tres mitos antes de entrar en detalles.
Mito 1: el web scraping es piratería
Raspar una página pública no es un acceso no autorizado: un bot solicita la misma página que un navegador normal. El Noveno Circuito de EE.UU.hiQ v. LinkedIn(2022) sostuvieron que el web scraping de páginas públicas probablemente no viola el CFAA donde no se omite ninguna puerta de autenticación. La gente también pregunta “¿es legal el screen scraping?” – misma respuesta: leer una página pública como lo hace un navegador no es “piratear”.
Mito 2: “Datos públicos” significa acceso gratuito
Público no significa sin restricciones. Los datos personales permanecen protegidos incluso cuando son abiertamente visibles: los reguladores europeos multan por extraer datos personales públicos. Los derechos de autor aún cubren artículos e imágenes públicos. Y los términos de servicio pueden obligarlo incluso sin iniciar sesión. Entonces, la verdadera pregunta: ¿es legal la web scraping? – depende en gran medida de cuáles sean realmente los datos.
Mito 3: Violar los Términos de Servicio es un delito
El incumplimiento de los términos de servicio es un asunto civil, no penal. Violar los ToS no es automáticamente ilegal, pero es motivo de bloqueo, base para una demanda civil y evidencia de mala fe en los tribunales. Más información sobre los términos de servicio de web scraping a continuación.
Estados Unidos: CFAA, hiQ y la capa de contrato
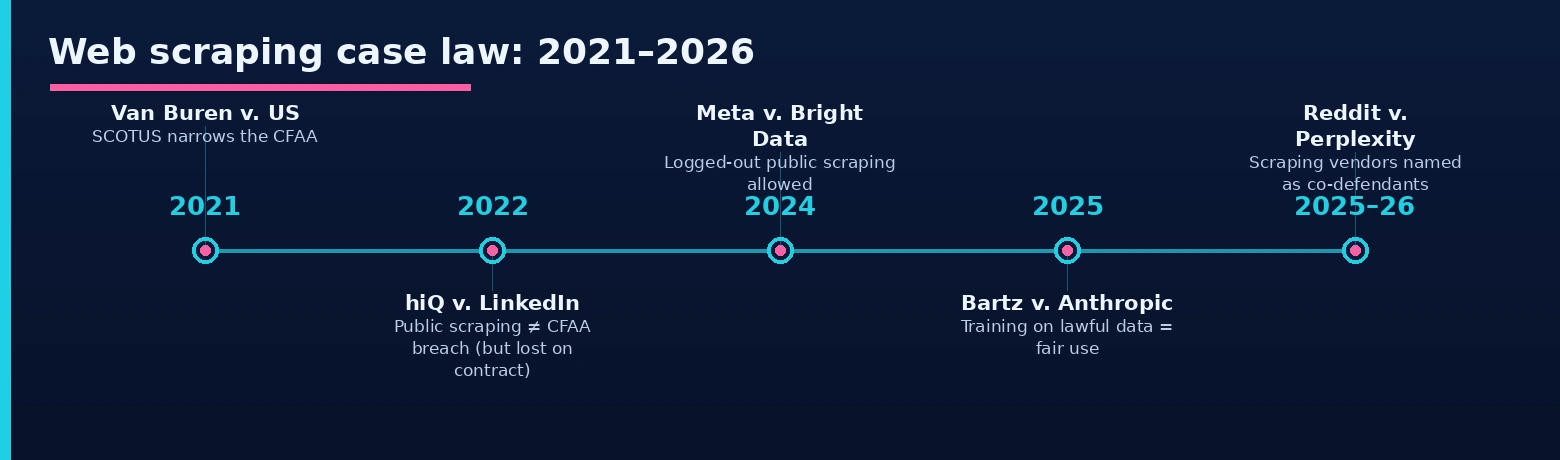
La pregunta fundamental: ¿es legal el scraping de sitios web en Estados Unidos? – se redujo a si el web scraping de páginas públicas es “acceso no autorizado” según laComputer Fraud and Abuse Act– el estatuto contra la piratería informática. El Noveno Circuito respondió enhiQ Labs v. LinkedIn(2022, aplicando la decisión de la Corte SupremaVan Burenlógica):No. Cuando una página está abierta a cualquier persona sin credenciales, no hay puerta de autorización que violar, por lo que la web scraping públicos no es una violación de CFAA.
Pero la historia completa de hiQ es la verdadera lección. Después de ganar la batalla CFAA, hiQ perdió la guerra: en noviembre de 2022, el tribunal determinó que habíavioló el Acuerdo de usuario de LinkedIn(que había aceptado creando cuentas), y el caso terminó en una sentencia de consentimiento. El CFAA lo protege de reclamos de piratería en páginas públicas; no te protege decontratos que has aceptado.
Meta v. Bright Data(enero de 2024) agudizó la línea: un tribunal se negó a declarar que Bright Data había incumplido por web scrapingpúblico, desconectadoPáginas Facebook y Instagram, ya que los términos de las plataformas rigen a los titulares de cuentas, no a los visitantes desconectados. La regla que surgió…el scraping público desconectado es defendible; El web scraping iniciado sesión contra los términos aceptados no es. Casos más antiguos de traspaso de bienes muebles (eBay v. Bidder’s Edge, 2000) todavía afecta a volúmenes extremos, y las leyes estatales de privacidad (CCPA/CPRA de California, VCDPA de Virginia) añaden obligaciones de datos personales.
Términos de servicio: Browsewrap, Clickwrap y cuándo las reglas se convierten en riesgos legales
Los términos de servicio no son ley, pero los tribunales los pesan mucho y la pregunta clave es si el usuario realmente los aceptó.
Browsewrap versus Clickwrap: qué términos de servicio realmente te vinculan
Aenvoltura de navegaciónEl acuerdo es simplemente un enlace que se encuentra en algún lugar de la página sin aceptación activa; los tribunales rara vez lo aplican a alguien que nunca hizo clic. Aenvoltura de clicEl acuerdo requiere una acción explícita (una casilla de verificación o un botón “Acepto”) y los tribunales lo hacen cumplir casi siempre. La línea práctica: los términos que usted aceptó activamente (generalmente al crear una cuenta) lo vinculan; Los términos que simplemente podrías haber visto a menudo no lo hacen.
Cuando las violaciones de los ToS se convierten en prueba legal
Violar los términos de servicio de web scraping no es un delito penal, pero tiene tres consecuencias prácticas: la plataforma puede bloquearlo inmediatamente, es la base para una demanda civil por incumplimiento de contrato (el reclamo que finalmente hundió a hiQ), y se lee como mala fe si un CFAA o un reclamo relacionado llega a los tribunales.
La era de la IA: demandas de 2025-2026 que cambiaron el mapa
El entrenamiento en IA creó una segunda ola de litigios por scraping: menos sobre “se autorizó el acceso” y más sobrecontratos, licencias y derechos de autor(las mismas preguntas que dan formaservidores proxy para la recopilación de datos de entrenamiento de IA):
- Bartz v. Anthropic(Junio de 2025, juez Alsup):entrenar a un LLM en libros obtenidos legalmente es un uso legítimo “extremadamente transformador”, pero el fallo excluyó explícitamente las copias fuente pirateadas. como tuobtenidolos datos importan tanto como lo que hiciste con ellos.
- Kadrey v. Meta(Junio de 2025, juez Chhabria):Los demandantes perdieron en el expediente que presentaron, pero la opinión advirtió que esto no era un permiso amplio para el entrenamiento de IA: una victoria estrecha, no una doctrina.
- Reddit v. Anthropic(presentado en junio de 2025):Reddit demandado porCondiciones de servicio y enriquecimiento injusto.teorías, no derechos de autor. A finales de marzo de 2026 un juez federaldevolvió el caso al tribunal estatal de California, afirmar que los reclamos no están prevalecidos por la Ley de Derechos de Autor, lo que confirma que los reclamos de scraping basados en contratos tienen vida independiente.
- Reddit contra Perplexity, SerpApi, Oxylabs y AWMProxy(octubre de 2025, SDNY):el primer caso en nombrarweb scraping de proveedores de infraestructuracomo coacusados junto con la empresa AI. Para los compradores proxy, la conclusión tiene que ver con las cadenas de suministro: quién recopila sus datos y cómo ahora forma parte de su exposición legal.
- NYT v. OpenAI(consolidado, SDNY):en enero de 2026, el tribunal ordenó a OpenAI que presentara una muestra de registro de 20-million-conversation en el momento del descubrimiento; El caso pone a prueba si la “regurgitación” del modelo socava el uso legítimo.
- La economía de las licencias es la otra cara de la moneda:Reddit otorga licencias de datos a Google (~$60M/yr) y OpenAI; Cloudflare y Stack Overflow lanzaron el pago por rastreo. “Libre para raspar” y “con licencia para entrenar” son caminos divergentes.
Europa: RGPD y los reguladores más estrictos
En la UE (y el Reino Unido), la pregunta rara vez es “¿se autorizó el acceso?”;“¿Procesaste datos personales sin una base legal?”Según RGPD, extraer cualquier dato que identifique a una persona (nombres, fotos, perfiles, detalles de contacto) es “procesamiento” y “era público” no es una base legal en sí misma. El historial de ejecución es inequívoco:
- Países Bajos (AP)– la línea más dura de Europa. Su guía de mayo de 2024 considera que la web scraping personales es “casi siempre una violación del RGPD” y multaClearview AI €30.5M, y se advirtió a los directores sobre responsabilidad personal.
- Italia (Garante)– multado Clearview€20M; su principio declarado: “si es público, puedo aceptarlo” esFALSO.
- Francia (CNIL)– corredor de datos de contacto multadoKASPR €240,000(diciembre de 2024). Su guía de junio de 2025 permite extraer datos personales públicos bajointerés legítimo– pero sólo con salvaguardias (listas de exclusión, minimización, transparencia).
- Reino Unido (ICO)– multado Clearview£7.5M; el RGPD del Reino Unido más el Data (Use and Access) Act 2025 mantienen el marco alineado con el de la UE.
- En toda la UE:el Database Directive agrega un separadosui generisderecho contra la extracción de partes sustanciales de bases de datos protegidas, un reclamo que existe en Europa pero no en Estados Unidos.
El matiz crucial:Nada de esto se dirige a datos no personales.Los precios, los listados de productos, la disponibilidad y las clasificaciones están fuera del alcance de RGPD: los canales europeos de inteligencia de precios y SEO se ejecutan legalmente todos los días. El siguiente mapa de riesgos muestra cómo el riesgo de web scraping personales varía según la jurisdicción.
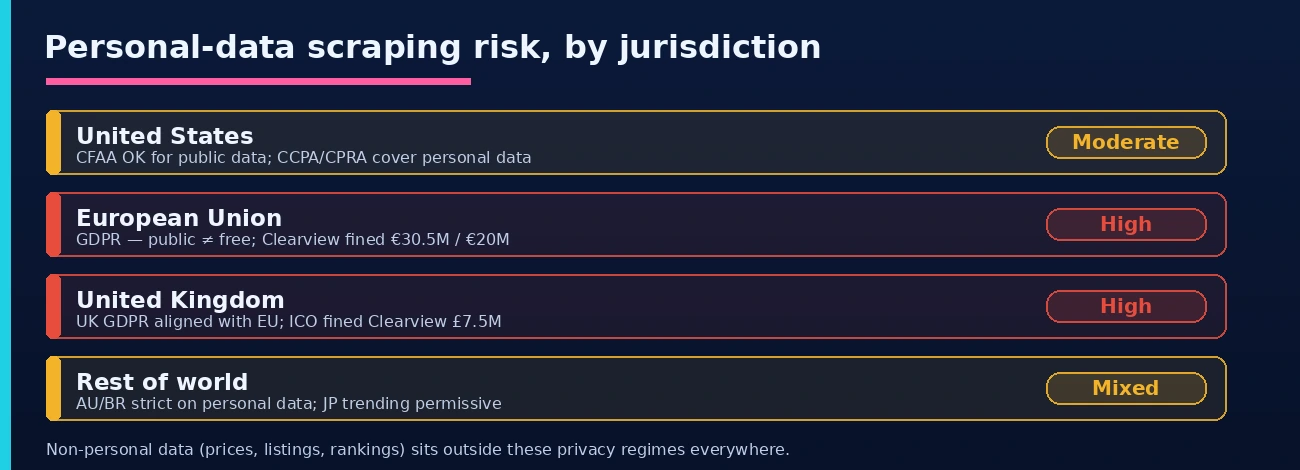
Más allá de Europa y Estados Unidos, el panorama de la web scraping personales varía de estricto a suavizado:
| Jurisdicción | Estructura | postura de web scraping |
|---|---|---|
| Australia | Privacy Act 1988 + reforma 2024 | Los datos públicos de productos son defendibles; los datos personales no lo son. |
| Japón | APPI | Tendencia favorable: una enmienda de 2026 facilitaría el uso de datos públicos por parte de la IA. |
| Brasil | LGPD (ANPD) | Aplicación activa de datos personales, incluido Clearview. |
| India | DPDP Act 2023 | Se endurecen las normas sobre datos personales; Casos de entrenamiento de IA en marcha. |
| Porcelana | PIPL + DSL + CSL | Estricto en materia de datos personales y transferencia transfronteriza; Necesita revisión de localización. |
Cada guía de países en nuestrobiblioteca de blogs– deAlemaniaaJapón– incluye una sección legal local verificada si necesita profundidad en un mercado específico.
Ley de derechos de autor: lo que se puede y lo que no se puede eliminar
Los derechos de autor son una de las fuentes más comunes de problemas legales en el scraping, pero la mayoría de los casos de uso empresarial se encuentran en una zona segura una vez que se separan los hechos del contenido creativo.
Qué está protegido y qué no
Los datos no están protegidos por derechos de autor: los precios, las calificaciones, la disponibilidad y las especificaciones se pueden recopilar de forma gratuita, por lo que extraer datos de productos es una zona segura. Quéesprotegidos: artículos, fotografías, videos, texto original y la selección o disposición creativa en una base de datos. Volver a publicarlos al por mayor es donde surgen demandas por infracción de derechos de autor; el Digital Millennium Copyright Act de EE. UU. (DMCA) se incluye por separado, cuando se omiten los controles de acceso o se elimina la información de gestión de derechos de autor, no solo de la republicación.
Uso legítimo (EE. UU.) y DSM Directive (UE): cuándo se permite extraer contenido protegido por derechos de autor
En los EE.UU.,uso justosopesa cuatro factores: el propósito del uso (¿transformador o meramente comercial?), la naturaleza del trabajo, cuánto se toma y el efecto en el mercado, conAuthors Guild v. Google(Libros Google) el precedente clásico del uso transformador. En la UE, elDSM Directivepermite la extracción de textos y datos donde usted tiene acceso legal y el titular de los derechos no ha optado por no participar (a menudo señalado a través de robots.txt). Ambos dejan espacio para extraer contenido protegido por derechos de autor para su análisis; ninguno otorga licencias para la republicación al por mayor.
Lo que es defendible versus lo que es riesgoso
No todos los scrapes conllevan el mismo riesgo: depende del tipo de datos, de cómo se accede a ellos y de lo que se hace con el resultado. Las dos listas a continuación ubican su proyecto rápidamente.
Generalmente defendible
- Colección pública de sólo lectura deno personaldatos: precios, especificaciones de productos, existencias, clasificaciones, resultados de búsqueda, tarifas de vuelos, listados de bienes raíces
- Acceso únicamente cuando se ha cerrado sesión: nada detrás de la autenticación
- Tasas de solicitudes adaptadas al ritmo humano que no sobrecargan la infraestructura del objetivo
- Respetar robots.txt y las políticas de rastreo publicadas
- Inteligencia competitiva, investigación de mercados, monitoreo SEO, ad verification, investigación académica sobre agregados
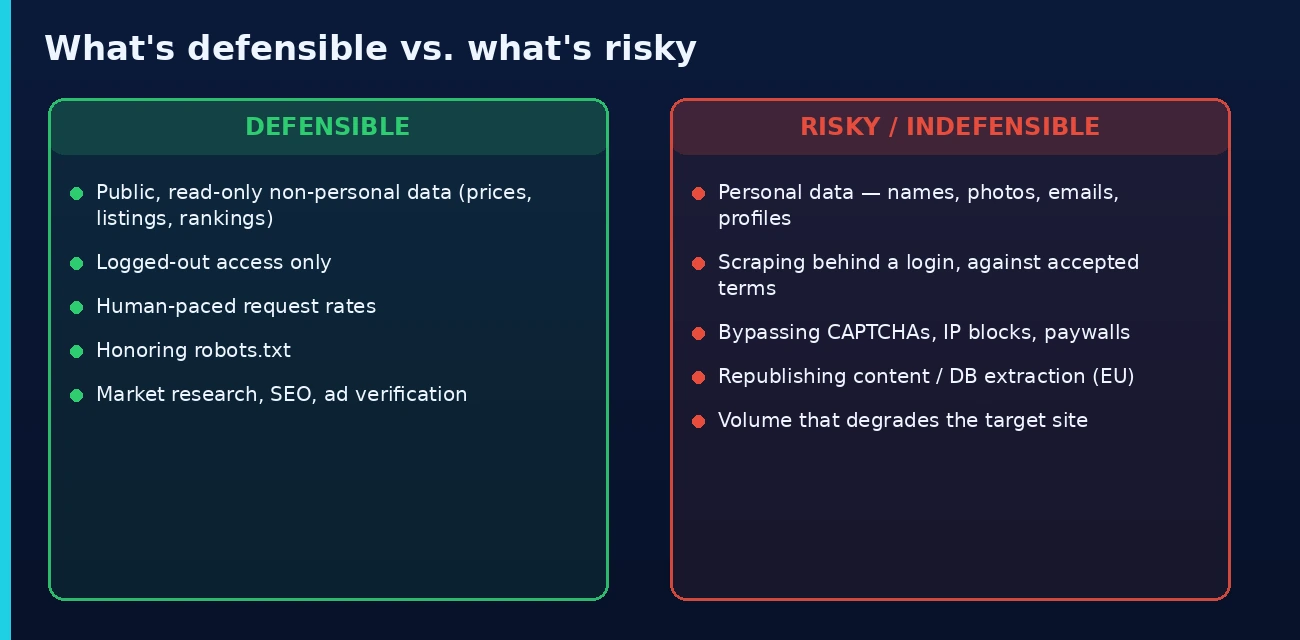
De arriesgado a indefendible
- Web scrapingdatos personales– nombres, fotografías, correos electrónicos, números de teléfono, perfiles, especialmente a escala, especialmente en Europa.
- Web scraping detrás de un inicio de sesión, contra los términos que aceptó (la lección del contrato hiQ)
- Superando barreras técnicas: CAPTCHA presentados como controles de acceso, bloques IP dirigidos específicamente a usted, muros de pago
- Volver a publicar contenido extraído al por mayor (derechos de autor) o extraer partes sustanciales de bases de datos protegidas (derecho de base de datos de la UE)
- Volumen que degrada el sitio objetivo (exposición a la invasión de bienes muebles)
- Entrenamiento de IA sobre contenido obtenido de fuentes pirateadas o que infringen términos (bartzesculpido)
Una lista de verificación de cumplimiento para equipos de scraping
1. Alcance los datos.Si un campo puede identificar a una persona, trátelo como regulado: elimínelo o establezca una base legal RGPD con salvaguardias documentadas (la hoja de interés legítimo de 2025 de CNIL es el mejor modelo).
2. Manténgase desconectado.Sólo páginas públicas. En el momento en que se autentica, acepta un contrato, y las reclamaciones del contrato son las que ganan.
3. Respetar las señales del sitio.robots.txt, límites de velocidad, retraso de rastreo. No siempre es jurídicamente vinculante, pero es lo primero que examina un tribunal o un regulador.
4. Ingeniero de moderación.Cadencia a ritmo humano, almacenamiento en caché para evitar volver a buscar, sin martilleo. El volumen es lo que convierte una disputa por web scraping en un reclamo por invasión de propiedad ilegal.
5. Cuide la cadena de suministro. Reddit contra Perplexitynombró a los proveedores de scraping, no solo al comprador de IA. Sepa cómo recopilan sus proveedores de datos.
6. Recogida separada del uso.La recopilación legal no otorga licencias para todos los usos: la republicación, la extracción de bases de datos y el entrenamiento de IA llevan cada uno su propio análisis.
7. Busque asesoramiento antes de escalar.Una canalización que funciona bien con 1,000 requests/day puede necesitar una revisión con 10 millones.
8. Elija una infraestructura de proxy de origen ético.Lo importante no es la herramienta sino su origen: los proxy son legales, pero el web scraping ético se extiende a cómo se obtienen los IP. Basado en el consentimiento,representantes residenciales de origen éticomantenga su capa de recolección defendible si alguien pregunta sobre su cadena de suministro.
Preguntas frecuentes
¿Es legal el web scraping?
La web scraping no personales disponibles públicamente es ampliamente legal en la mayoría de las jurisdicciones: el Noveno CircuitohiQ v. LinkedIn(2022) confirmaron que el scraping de páginas públicas no es un “acceso no autorizado” según la ley CFAA de EE. UU. El riesgo está en los detalles: datos personales (multas de RGPD de hasta €30.5M en los casos de Clearview), búsqueda de inicios de sesión contra términos aceptados (cómo finalmente perdió hiQ), eludir barreras técnicas y volver a publicar contenido protegido por derechos de autor. Los datos públicos sobre productos, precios y SERP recopilados respetuosamente son el camino defendible.
¿El web scraping es legal en los EE. UU.?
Generalmente sí para datos públicos:hiQ v. LinkedInestableció que el scraping de páginas públicas no viola el CFAA, yMeta v. Bright Data(2024) se negó a bloquear el web scraping de páginas públicas Facebook/Instagram cuando se desconectó la sesión. Pero los reclamos contractuales sobreviven (hiQ perdió por incumplimiento de los términos de LinkedIn que había aceptado) y volúmenes extremos corren el riesgo de reclamos por violación. Las leyes estatales de privacidad (CCPA/CPRA) regulan los datos personales en la parte superior.
¿Es legal web scraping según RGPD en Europa?
Los datos no personales (precios, listados, clasificaciones) están completamente fuera del RGPD. Los datos personales es donde Europa es estricta: la AP holandesa califica la web scraping personales como “casi siempre una violación” y multa a Clearview con €30.5M; La italiana Garante le impuso una multa de €20M; La francesa CNIL multada con €240K a KASPR, todo por web scrapingpúblicodatos personales. La guía 2025 de CNIL permite la web scraping personales públicos por interés legítimo solo con salvaguardias documentadas.
¿Puedo eliminar legalmente Amazon, Google u otras plataformas grandes?
Recopilar datos públicos de productos y búsquedas desconectados, a tarifas respetuosas, es la misma categoría defendible que en cualquier otro lugar: así es como operan las industrias de inteligencia de precios y SEO. Los riesgos son específicos de la plataforma: no iniciar sesión (términos), no tomar datos personales (reseñas con identidades de autor), no sobrecargar los puntos finales y conocer la postura de cumplimiento de cada plataforma. Nuestras guías por plataforma (Amazon, Google Maps, LinkedIn, Reddit) cubren los casos y reglas específicos.
¿Es legal extraer datos para el entrenamiento de IA?
Inquieto y dividido en dos preguntas. Colección: mismas reglas que todo scraping. Capacitación:Bartz v. Anthropic(2025) encontraron que la capacitación sobre libros obtenidos legalmente tenía un uso legítimo transformador, pero eliminaron las fuentes pirateadas;NYT v. OpenAIestá probando si la “regurgitación” de la producción frustra el uso legítimo; Las demandas basadas en contratos de Reddit contra Anthropic y Perplexity (con sus proveedores de scraping) sobrevivieron a las primeras rondas procesales. Los datos autorizados y las cadenas de suministro limpias se están convirtiendo en el puerto seguro.
¿Es legal el uso de proxies?
Sí, los proxies son una infraestructura de red estándar, legales esencialmente en todas partes. La actividad realizada a través del proxy es lo que está regulado: el scraping legal sigue siendo legal a través de un proxy, la recopilación ilegal sigue siendo ilegal. Elija proveedores con piscinas residenciales basadas en el consentimiento y de origen ético; despuésReddit contra Perplexitynombró a los proveedores de scraping como demandados, la procedencia de su infraestructura de cobranza es parte de su historia de cumplimiento.
¿La violación de robots.txt hace que el scraping sea ilegal?
robots.txt no es un estatuto e ignorarlo no es automáticamente ilegal. Pero los tribunales y los reguladores lo tratan como una señal de buena o mala fe, varios fallos lo citan al sopesar reclamaciones por intrusión y contratos, y las salvaguardas del CNIL esperan que usted respete las opciones de exclusión voluntaria. En la práctica: respetar robots.txt cuesta poco y fortalece materialmente su defensa.
¿Qué pasó en hiQ v. LinkedIn, en un párrafo?
hiQ extrajo perfiles públicos de LinkedIn para análisis de recursos humanos; LinkedIn envió un cese y desistimiento; hiQ demandó y ganó el asunto principal: el Noveno Circuito sostuvo (2022) que el web scraping de páginas públicas no es una violación de CFAA. Luego, LinkedIn ganó la guerra: el tribunal determinó que hiQ incumplió el Acuerdo de usuario que había aceptado y el caso terminó en una sentencia de consentimiento. La doble lección: el scraping público no es piratería, pero los contratos que aceptas son ejecutables.
Resumen
Entonces, ¿es legal el web scraping? La web scraping no personales disponibles públicamente es ampliamente legal y defendible: los tres mayores riesgos sondatos personales(RGPD y sus equivalentes globales),acceso contra términos aceptados(el contrato afirma que venció a hiQ y ahora conduce los trajes de la era de la IA), yderechos de autorsobre contenido creativo. Manténgase desconectado, recopile datos no personales, respete robots.txt y separe la recopilación del uso. Después de 2026, la cadena de suministro también forma parte del cumplimiento: el origen de sus datos (y sus representantes) ahora forma parte del panorama legal. Para el lado de la infraestructura, vermejores servidores proxy para web scraping. Esto sigue siendo información general, no asesoramiento legal; busque asesoramiento legal para su caso específico.
Última actualización: 24 de junio de 2026.