
In this Article
Web scraping yasal mı? Web scraping’in yasallığı dört şeye bağlıdır: neyi kazıdığınız (herkese açık ürün fiyatları mı, kişisel profiller mi), nasıl kazıdığınız (herkese açık sayfalar mı, giriş arkasındaki sayfalar mı), nerede faaliyet gösterdiğiniz (ABD’nin CFAA yaklaşımı mı, Avrupa’nın GDPR’ı mı) ve verilerle ne yaptığınız (fiyat takibi mi, yapay zeka eğitimi mi). Bu nedenle insanlar “web sitelerinden veri kazımak yasal mı” diye sorduğunda, dürüst yanıt şudur: herkese açık, kişisel olmayan verilerin kazınması çoğu yargı alanında genel olarak yasaldır, ancak bu faktörlerin her biri sizi savunulabilir bir iş uygulaması ile düzenleyici işlem arasındaki konuma taşır. Bu rehber, dönüm noktası niteliğindeki davaları, 2025-2026 yapay zeka çağındaki davaları, tüm önemli düzenleyicilerin tutumunu ve pratik bir uyumluluk çerçevesini ele alır.
Başta bir noktayı belirtelim: bu metin genel bilgilendirmedir, hukuki tavsiye değildir. Ticari bir scraping hattını büyütmeden önce, kendi yargı alanınızda ve hedeflerinizin bulunduğu yargı alanlarında hukuki tavsiye alın.
Temel Bilgiler
- Herkese açık, kişisel olmayan verileri kazımak genel olarak yasaldır, ayrıntılar (ne, nasıl, nerede, neden) her şeyi belirler.
- “Herkese açık”, kişisel verilerin “serbestçe alınabileceği” anlamına gelmez, AB düzenleyicileri bunun için para cezası keser (Clearview: Hollanda’da €30,5M, İtalya’da €20M, Birleşik Krallık’ta £7,5M).
- Oturum açmamış ve oturum açmış kullanıcı ayrımı sürekli galip gelen çizgidir, oturum açılmadan yapılan herkese açık scraping savunulabilir durumdadır (hiQ, Meta v. Bright Data); kabul edilmiş şartlara aykırı şekilde giriş arkasından scraping yapmak ise değildir.
- Yapay zeka çağı sözleşme, lisanslama ve telif hakkı iddialarını ekledi, artık toplamanın ve eğitimin yasallığı ayrı sorulardır.
- Proxy’lerin kendisi yasaldır, yasallığı belirleyen araç değil faaliyettir.
Soru Bazında Kısa Yanıt
| Soru | Kısa yanıt |
|---|---|
| Herkese açık ürün/fiyat verilerini kazımak yasal mı? | Genellikle evet, her yerde en savunulabilir kategori |
| Kişisel verileri (adlar, profiller, iletişim bilgileri) kazımak yasal mı? | Yüksek riskli, GDPR düzenleyicileri veriler herkese açık olsa bile para cezası keser |
| Giriş arkasından scraping yapmak yasal mı? | Riskli, şartları kabul etmiş olursunuz; CFAA uygulanmasa bile sözleşme iddiaları geçerliliğini korur |
| robots.txt’i ihlal etmek yasa dışı mı? | Tek başına bir yasa değildir, ancak mahkemeler ve düzenleyiciler bunu kötü niyet kanıtı olarak değerlendirir |
| Proxy kullanmak yasal mı? | Evet, yasallığı belirleyen araç değil faaliyettir |
| Yapay zeka eğitimi için scraping yapmak yasal mı? | Belirsiz, hukuka uygun elde edilmiş verilerde adil kullanım kazanımları var, ancak sözleşme/lisanslama davaları artıyor |
Web Scraping Yasallığı Hakkındaki Yaygın Mitler
Web scraping’in yasallığı hakkındaki karmaşanın çoğu, teknik yeterliliği hukuki izinle karıştırmaktan kaynaklanır. Ayrıntılara geçmeden önce üç miti açıklığa kavuşturmak gerekir.
Mit 1: Web Scraping Hackleme Demektir
Herkese açık bir sayfayı kazımak yetkisiz erişim değildir, bir bot normal bir tarayıcının istediği sayfanın aynısını ister. ABD Dokuzuncu Daire Mahkemesi’nin hiQ v. LinkedIn (2022) kararı, kimlik doğrulama engeli aşılmadığında herkese açık sayfa scraping’inin büyük olasılıkla CFAA’yı ihlal etmediğine hükmetti. İnsanlar ayrıca “screen scraping yasal mı” diye sorar, yanıt aynıdır: bir tarayıcının yaptığı gibi herkese açık bir sayfayı okumak “hackleme” değildir.
Mit 2: “Herkese Açık Veri”, Serbestçe Alınabilir Demektir
Herkese açık olması sınırsız olduğu anlamına gelmez. Kişisel veriler açıkça görünür olsa bile korunmaya devam eder, Avrupa’nın düzenleyicileri herkese açık kişisel verilerin kazınması nedeniyle para cezası keser. Telif hakkı herkese açık makaleleri ve görselleri de korur. Hizmet şartları, giriş yapmasanız bile sizi bağlayabilir. Dolayısıyla asıl soru, veri kazımak yasal mı sorusu, büyük ölçüde verinin gerçekte ne olduğuna bağlıdır.
Mit 3: ToS’yi İhlal Etmek Suçtur
Hizmet şartlarını ihlal etmek cezai değil hukuki bir konudur. ToS’yi ihlal etmek otomatik olarak yasa dışı değildir, ancak engellenme gerekçesi, hukuk davası açılması için dayanak ve mahkemede kötü niyet kanıtıdır. Web scraping hizmet şartları hakkında daha fazlası aşağıda.
Amerika Birleşik Devletleri: CFAA, hiQ ve Sözleşme Katmanı
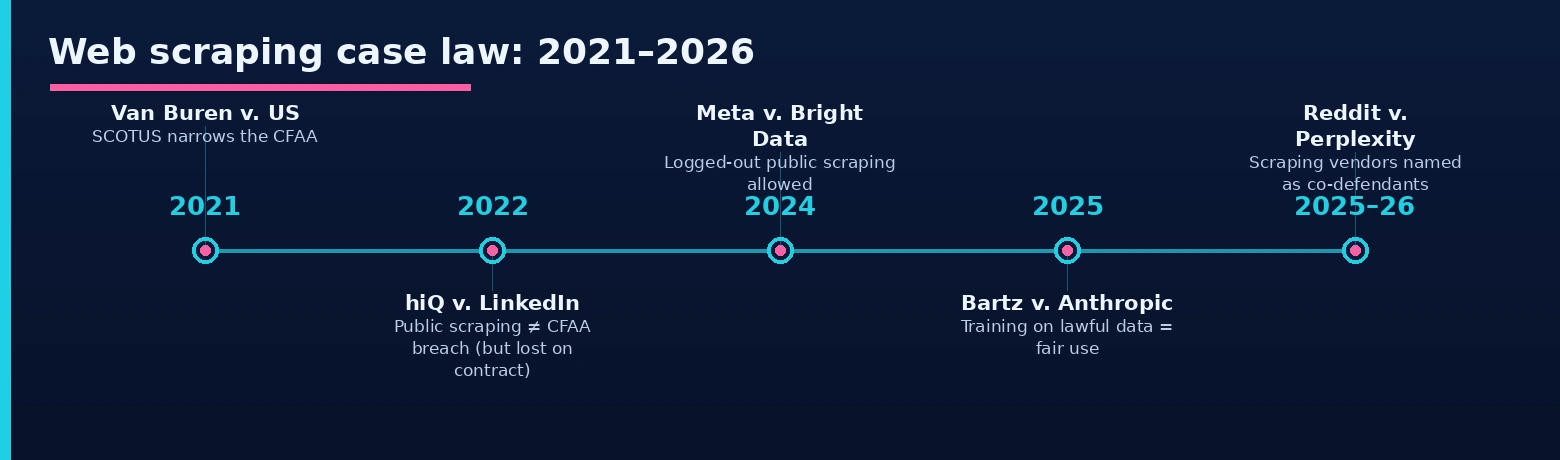
Temel soru, ABD’de web sitesi scraping’i yasal mı sorusu, herkese açık sayfaların kazınmasının hacklemeyi önleme yasası olan Computer Fraud and Abuse Act kapsamında “yetkisiz erişim” sayılıp sayılmadığına dayanıyordu. Dokuzuncu Daire Mahkemesi, hiQ Labs v. LinkedIn (2022, Yüksek Mahkeme’nin Van Buren mantığını uygulayarak) davasında yanıtı hayır olarak verdi. Bir sayfa kimlik bilgileri olmadan herkese açıksa, aşılacak bir yetkilendirme engeli yoktur; dolayısıyla herkese açık verilerin kazınması CFAA ihlali değildir.
Ancak hiQ’nun tüm hikayesi asıl derstir. CFAA mücadelesini kazandıktan sonra hiQ savaşı kaybetti: mahkeme Kasım 2022’de LinkedIn Kullanıcı Sözleşmesi’ni ihlal ettiğine karar verdi (hesap oluşturarak bu sözleşmeyi kabul etmişti) ve dava rıza hükmüyle sonuçlandı. CFAA, herkese açık sayfalardaki hackleme iddialarına karşı sizi korur; kabul ettiğiniz sözleşmelere karşı korumaz.
Meta v. Bright Data (Ocak 2024) çizgiyi netleştirdi: bir mahkeme, platformların şartları oturum açmış hesap sahiplerini kapsadığından, oturum açmamış ziyaretçileri kapsamadığından, Bright Data’nın herkese açık, oturum açılmamış Facebook ve Instagram sayfalarını kazıyarak ihlalde bulunduğu sonucuna varmayı reddetti. Ortaya çıkan kural şuydu: oturum açılmadan yapılan herkese açık scraping savunulabilir, kabul edilmiş şartlara aykırı girişli scraping ise değildir. Eski taşınır mallara izinsiz müdahale davaları (eBay v. Bidder’s Edge, 2000) aşırı hacimlerde hâlâ etkili olabilir; eyalet gizlilik yasaları (California’nın CCPA/CPRA’sı, Virginia’nın VCDPA’sı) buna ek olarak kişisel veri yükümlülükleri getirir.
Hizmet Şartları: Browsewrap, Clickwrap ve Kuralların Hukuki Riske Dönüştüğü An
Hizmet şartları yasa değildir, ancak mahkemeler onlara büyük önem verir ve temel soru, kullanıcının onları gerçekten kabul edip etmediğidir.
Browsewrap ve Clickwrap: Hangi ToS Sizi Gerçekten Bağlar?
browsewrap sözleşmesi, sayfanın bir yerinde bulunan ve etkin kabul gerektirmeyen bir bağlantıdır; mahkemeler bunu hiç tıklamamış bir kişiye karşı nadiren uygular. clickwrap sözleşmesi, onay kutusu veya “Kabul ediyorum” düğmesi gibi açık bir işlem gerektirir ve mahkemeler bunu neredeyse her zaman uygular. Pratik ayrım şudur: etkin biçimde kabul ettiğiniz şartlar (genellikle hesap oluşturarak) sizi bağlar; yalnızca görebileceğiniz şartlar çoğu zaman bağlamaz.
ToS İhlalleri Ne Zaman Hukuki Kanıta Dönüşür?
Web scraping hizmet şartlarını ihlal etmek cezai bir suç değildir, ancak üç pratik sonucu vardır: platform sizi hemen engelleyebilir, sözleşme ihlali nedeniyle hukuk davası için dayanak oluşturur (hiQ’yu nihayetinde batıran iddia buydu) ve bir CFAA veya bağlantılı iddia mahkemeye ulaşırsa kötü niyet olarak değerlendirilir.
Yapay Zeka Çağı: Haritayı Değiştiren 2025-2026 Davaları
Yapay zeka eğitimi, scraping davalarında ikinci bir dalga yarattı; konu artık “erişim yetkili miydi” sorusundan çok sözleşmeler, lisanslama ve telif hakkı ile ilgilidir (yapay zeka eğitimi veri toplama için proxy’ler konusunu şekillendiren soruların aynısı):
- Bartz v. Anthropic (Haziran 2025, Yargıç Alsup): hukuka uygun elde edilmiş kitaplarla bir LLM eğitmek “son derece dönüştürücü” bir adil kullanımdır; ancak karar açıkça korsan kaynak kopyalarını kapsam dışı bıraktı. Verileri nasıl elde ettiğiniz, onlarla ne yaptığınız kadar önemlidir.
- Kadrey v. Meta (Haziran 2025, Yargıç Chhabria): davacılar sundukları kayıtlar üzerinden kaybetti, ancak görüş bunun yapay zeka eğitimi için geniş bir izin olmadığını vurguladı; bir doktrin değil, dar kapsamlı bir zaferdi.
- Reddit v. Anthropic (Haziran 2025’te açıldı): Reddit telif hakkına değil, hizmet şartları ve sebepsiz zenginleşme teorilerine dayanarak dava açtı. Mart 2026’nın sonlarında bir federal yargıç, iddiaların Telif Hakkı Yasası tarafından öncelenmediğine hükmederek davayı California eyalet mahkemesine geri gönderdi; bu karar, sözleşmeye dayalı scraping iddialarının bağımsız olarak geçerli olduğunu doğruladı.
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (Ekim 2025, S.D.N.Y.): yapay zeka şirketinin yanı sıra scraping altyapısı sağlayıcılarını da ortak davalı olarak adlandıran ilk davadır. Proxy alıcıları için çıkarım tedarik zinciriyle ilgilidir: verilerinizi kim ve nasıl topluyor, artık hukuki riskinizin bir parçasıdır.
- NYT v. OpenAI (birleştirilmiş, S.D.N.Y.): mahkeme Ocak 2026’da, delil toplama sürecinde OpenAI’a 20 milyon konuşmalık günlük örneği sunmasını emretti; dava, modelin “tekrarlamasının” adil kullanımı zayıflatıp zayıflatmadığını test ediyor.
- Lisanslama ekonomisi diğer yüzüdür: Reddit verileri Google’a (yılda yaklaşık $60M) ve OpenAI’a lisanslıyor; Cloudflare ve Stack Overflow tarama başına ödeme sistemlerini başlattı. “Kazımak ücretsiz” ve “eğitim için lisanslı” giderek ayrışan yollardır.
Avrupa: GDPR ve En Katı Düzenleyiciler
AB’de (ve Birleşik Krallık’ta) soru nadiren “erişim yetkili miydi” olur; soru “kişisel verileri hukuka uygun bir dayanak olmadan işlediniz mi” sorusudur. GDPR kapsamında bir kişiyi tanımlayan her türlü verinin (adlar, fotoğraflar, profiller, iletişim bilgileri) kazınması “işleme” sayılır ve “herkese açıktı” ifadesi tek başına hukuka uygun bir dayanak değildir. Uygulama geçmişi nettir:
- Hollanda (AP), Avrupa’daki en katı yaklaşım. Mayıs 2024 rehberi kişisel verilerin kazınmasını “neredeyse her zaman GDPR ihlali” olarak nitelendirir ve Clearview AI’a €30,5 milyon para cezası verdi; yöneticiler kişisel sorumluluk konusunda uyarıldı.
- İtalya (Garante), Clearview’a €20 milyon para cezası verdi; belirtilen ilkesi şudur: “herkese açıksa alabilirim” düşüncesi yanlıştır.
- Fransa (CNIL), iletişim verisi aracısı KASPR’a €240.000 para cezası verdi (Aralık 2024). Haziran 2025 rehberi, herkese açık kişisel verilerin meşru menfaat kapsamında kazınmasına yalnızca güvencelerle (hariç tutma listeleri, veri minimizasyonu, şeffaflık) izin verir.
- Birleşik Krallık (ICO), Clearview’a £7,5 milyon para cezası verdi; Birleşik Krallık GDPR’ı ile Data (Use and Access) Act 2025, çerçeveyi AB’ninkiyle uyumlu tutar.
- AB genelinde: Database Directive, korunan veri tabanlarının önemli bölümlerinin çıkarılmasına karşı ayrı bir sui generis hak ekler; bu iddia Avrupa’da vardır, ABD’de yoktur.
Önemli nüans şudur: bunların hiçbiri kişisel olmayan verileri hedeflemez. Fiyatlar, ürün listeleri, stok durumu ve sıralamalar GDPR kapsamı dışındadır; Avrupa’daki fiyat istihbaratı ve SEO hatları her gün yasal olarak çalışır. Aşağıdaki risk haritası, kişisel veri scraping riskinin yargı alanına göre nasıl değiştiğini gösterir.
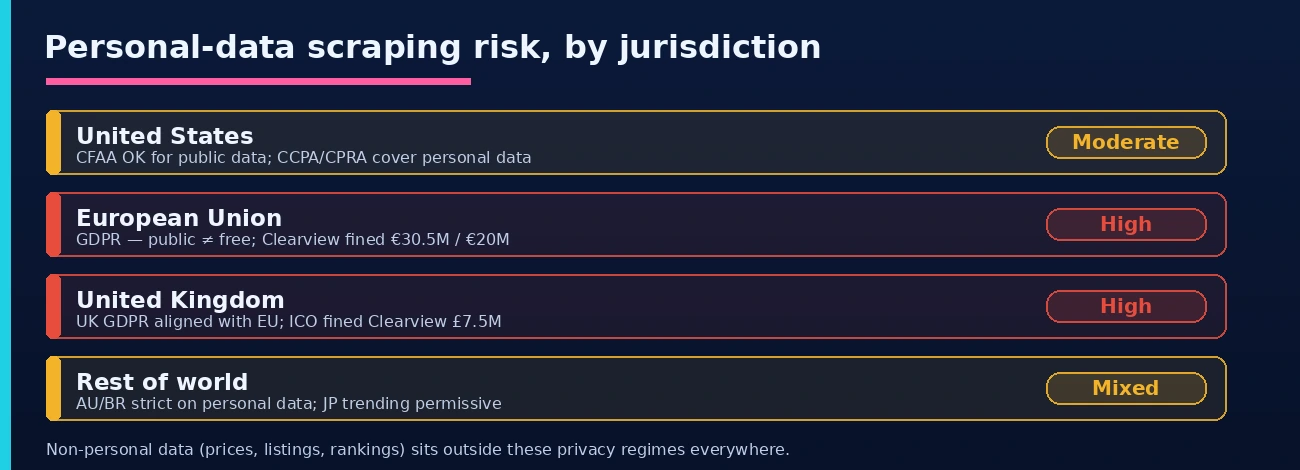
Avrupa ve ABD’nin ötesinde, kişisel veri scraping’i için tablo katı yaklaşımdan yumuşayan yaklaşıma kadar uzanır:
| Yargı alanı | Çerçeve | Scraping yaklaşımı |
|---|---|---|
| Avustralya | Privacy Act 1988 + 2024 reformu | Herkese açık ürün verileri savunulabilir; kişisel veriler değildir. |
| Japonya | APPI | Olumlu eğilimde; 2026 değişikliği, herkese açık verilerin yapay zekada kullanımını kolaylaştırabilir. |
| Brezilya | LGPD (ANPD) | Clearview dahil olmak üzere kişisel verilerde etkin uygulama. |
| Hindistan | DPDP Act 2023 | Kişisel veri kuralları sıkılaşıyor; yapay zeka eğitimi davaları sürüyor. |
| Çin | PIPL + DSL + CSL | Kişisel veriler ve sınır ötesi aktarım konusunda katı; yerelleştirme incelemesi gerekir. |
blog kütüphanemizdeki her ülke rehberi, Almanya‘dan Japonya‘ya kadar, belirli bir pazar hakkında derinlemesine bilgiye ihtiyacınız varsa doğruluğu kontrol edilmiş yerel bir hukuk bölümü içerir.
Telif Hakkı Hukuku: Neleri Kazıyabilirsiniz, Neleri Kazıyamazsınız?
Telif hakkı, scraping’de hukuki sorunların en yaygın kaynaklarından biridir; ancak olguları yaratıcı içerikten ayırdığınızda çoğu iş kullanım senaryosu güvenli bir alanda kalır.
Neler Korunur, Neler Korunmaz?
Olgular telif hakkıyla korunmaz; fiyatlar, puanlar, stok durumu ve özellikler serbestçe toplanabilir, bu nedenle ürün verilerini kazımak güvenli bir alandır. Korunan şeyler şunlardır: makaleler, fotoğraflar, videolar, özgün metinler ve bir veri tabanındaki yaratıcı seçki veya düzenleme. Bunları topluca yeniden yayımlamak telif hakkı ihlali iddialarının doğduğu yerdir; ABD Digital Millennium Copyright Act (DMCA) ise ayrı olarak devreye girer, yalnızca yeniden yayımlamadan değil, erişim kontrollerini aştığınızda veya telif hakkı yönetim bilgilerini kaldırdığınızda.
Adil Kullanım (ABD) ve DSM Directive (AB): Telifli İçeriğin Kazınmasına Ne Zaman İzin Verilir?
ABD’de adil kullanım dört faktörü değerlendirir: kullanımın amacı (dönüştürücü mü, yalnızca ticari mi), eserin niteliği, ne kadarını aldığınız ve pazar üzerindeki etkisi. Authors Guild v. Google (Google Books) dönüştürücü kullanım için klasik emsaldir. AB’de DSM Directive, hukuka uygun erişiminiz varsa ve hak sahibi kapsam dışı bırakmayı seçmemişse (çoğu zaman robots.txt ile bildirilir) metin ve veri madenciliğine izin verir. Her ikisi de analiz için telifli içerik kazımaya alan bırakır; hiçbiri toplu yeniden yayımlamaya lisans vermez.
Savunulabilir Olanlar ve Riskli Olanlar
Her scraping işlemi aynı riski taşımaz; bu, veri türüne, ona nasıl eriştiğinize ve sonuçla ne yaptığınıza bağlıdır. Aşağıdaki iki liste projenizin yerini hızla belirlemenizi sağlar.
Genellikle savunulabilir
- Kişisel olmayan verilerin herkese açık, salt okunur olarak toplanması: fiyatlar, ürün özellikleri, stok, sıralamalar, arama sonuçları, uçuş ücretleri, emlak ilanları
- Yalnızca oturum açılmadan erişim, kimlik doğrulama arkasında hiçbir şey yok
- Hedefin altyapısına yük bindirmeyen, insan hızındaki istek oranları
- robots.txt’e ve yayımlanmış tarama politikalarına uyma
- Rekabetçi istihbarat, pazar araştırması, SEO takibi, reklam doğrulama, toplulaştırılmış veriler üzerinde akademik araştırma
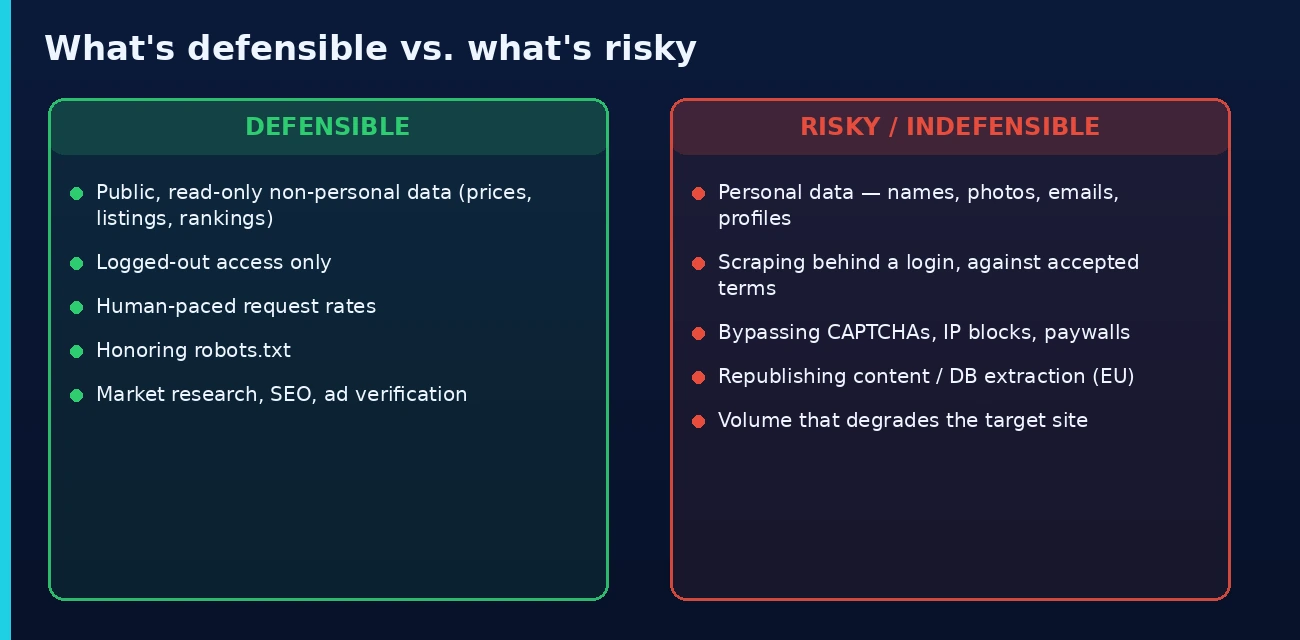
Riskliden savunulamaz olana
- Kişisel verilerin kazınması: adlar, fotoğraflar, e-postalar, telefon numaraları, profiller; özellikle büyük ölçekte ve özellikle Avrupa’da
- Kabul ettiğiniz şartlara aykırı olarak giriş arkasından scraping yapmak (hiQ sözleşme dersi)
- Teknik engelleri aşmak: erişim kontrolü olarak sunulan CAPTCHA’lar, özellikle sizi hedefleyen IP engelleri, ödeme duvarları
- Kazınmış içeriği topluca yeniden yayımlamak (telif hakkı) veya korunan veri tabanlarının önemli bölümlerini çıkarmak (AB veri tabanı hakkı)
- Hedef siteyi yavaşlatan hacim (taşınır mallara izinsiz müdahale riski)
- Korsan veya şartları ihlal eden kaynaklardan elde ettiğiniz içerikle yapay zeka eğitmek (Bartz‘ın istisnası)
Scraping Ekipleri İçin Uyumluluk Kontrol Listesi
1. Verinin kapsamını belirleyin. Bir alan kişiyi tanımlayabiliyorsa onu düzenlemeye tabi kabul edin: ya kaldırın ya da belgelenmiş güvencelerle bir GDPR hukuka uygun dayanağı oluşturun (CNIL’in 2025 meşru menfaat sayfası en iyi şablondur).
2. Oturum açmadan kalın. Yalnızca herkese açık sayfalar. Kimlik doğruladığınız anda bir sözleşmeyi kabul etmiş olursunuz ve kazanan iddialar sözleşme iddialarıdır.
3. Sitenin sinyallerine saygı gösterin. robots.txt, hız sınırları, crawl-delay. Her zaman hukuken bağlayıcı olmayabilir, ancak bir mahkeme veya düzenleyicinin baktığı ilk şeydir.
4. Ölçülülük için tasarlayın. İnsan hızındaki tempo, yeniden getirmeyi önlemek için önbellekleme, aşırı istek göndermeme. Scraping uyuşmazlığını taşınır mallara izinsiz müdahale iddiasına dönüştüren şey hacimdir.
5. Tedarik zincirini göz önünde bulundurun. Reddit v. Perplexity, yalnızca yapay zeka alıcısını değil scraping sağlayıcılarını da adlandırdı. Veri sağlayıcılarınızın nasıl topladığını bilin.
6. Toplamayı kullanımdan ayırın. Hukuka uygun toplama her kullanıma lisans vermez: yeniden yayımlama, veri tabanı çıkarma ve yapay zeka eğitiminin her biri kendi analizini gerektirir.
7. Ölçek büyütmeden önce hukuk danışmanına başvurun. Günde 1.000 istekte sorun olmayan bir hat, 10 milyonda inceleme gerektirebilir.
8. Etik şekilde tedarik edilmiş proxy altyapısını seçin. Önemli olan araç değil kaynağıdır: proxy’ler yasaldır, ancak etik web scraping IP’lerin nasıl elde edildiğini de kapsar. Rızaya dayalı, etik şekilde tedarik edilmiş residential proxy’ler, biri tedarik zinciriniz hakkında soru sorarsa toplama katmanınızın savunulabilir kalmasını sağlar.
SSS
Web scraping yasal mı?
Herkese açık, kişisel olmayan verilerin kazınması çoğu yargı alanında genel olarak yasaldır; Dokuzuncu Daire Mahkemesi’nin hiQ v. LinkedIn (2022) kararı, herkese açık sayfaların kazınmasının ABD CFAA kapsamında “yetkisiz erişim” olmadığını doğruladı. Risk ayrıntılardadır: kişisel veriler (Clearview davalarında €30,5M’ye kadar GDPR para cezaları), kabul edilmiş şartlara aykırı olarak giriş arkasından scraping yapmak (hiQ’nun nihayetinde kaybetme nedeni), teknik engelleri aşmak ve telifli içeriği yeniden yayımlamak. Saygılı biçimde toplanan herkese açık ürün, fiyat ve SERP verileri savunulabilir alandır.
ABD’de web scraping yasal mı?
Herkese açık veriler için genellikle evet: hiQ v. LinkedIn, herkese açık sayfa scraping’inin CFAA’yı ihlal etmediğini ortaya koydu; Meta v. Bright Data (2024) da herkese açık Facebook/Instagram sayfalarının oturum açılmadan kazınmasını engellemeyi reddetti. Ancak sözleşme iddiaları geçerliliğini korur; hiQ, kabul ettiği LinkedIn şartlarını ihlal ettiği için kaybetti ve aşırı hacimler taşınır mallara izinsiz müdahale iddiaları riski taşır. Eyalet gizlilik yasaları (CCPA/CPRA) ayrıca kişisel verileri düzenler.
Avrupa’da GDPR kapsamında web scraping yasal mı?
Kişisel olmayan veriler (fiyatlar, listeler, sıralamalar) tamamen GDPR kapsamı dışındadır. Avrupa’nın katı olduğu alan kişisel verilerdir: Hollanda AP, kişisel verilerin kazınmasını “neredeyse her zaman ihlal” olarak niteler ve Clearview’a €30,5M para cezası verdi; İtalya’nın Garante’si €20M; Fransa’nın CNIL’i KASPR’a €240K para cezası verdi, hepsi herkese açık kişisel verilerin kazınması nedeniyle. CNIL’in 2025 rehberi, herkese açık kişisel verilerin meşru menfaate dayalı olarak kazınmasına yalnızca belgelenmiş güvencelerle izin verir.
Amazon, Google veya diğer büyük platformları yasal olarak kazıyabilir miyim?
Herkese açık ürün ve arama verilerini oturum açmadan, makul oranlarda toplamak, başka yerlerdekiyle aynı savunulabilir kategoridir; fiyat istihbaratı ve SEO sektörleri böyle çalışır. Riskler platforma özeldir: oturum açmayın (şartlar), kişisel verileri (yazar kimliği içeren yorumlar) almayın, uç noktaları aşırı yüklemeyin ve her platformun uygulama yaklaşımını bilin. Platform başına rehberlerimiz (Amazon, Google Maps, LinkedIn, Reddit) belirli davaları ve kuralları kapsar.
Yapay zeka eğitimi için veri kazımak yasal mı?
Belirsizdir ve iki soruya ayrılır. Toplama: tüm scraping işlemlerindeki kuralların aynısı. Eğitim: Bartz v. Anthropic (2025), hukuka uygun elde edilmiş kitaplarla eğitimi dönüştürücü adil kullanım saydı, ancak korsan kaynakları kapsam dışı bıraktı; NYT v. OpenAI, çıktının “tekrarlamasının” adil kullanımı bozup bozmadığını test ediyor; Reddit’in Anthropic ve Perplexity’ye (scraping sağlayıcılarıyla birlikte) karşı sözleşmeye dayalı davaları ilk usul aşamalarını geçti. Lisanslı veriler ve temiz tedarik zincirleri güvenli liman haline geliyor.
Proxy kullanmak yasal mı?
Evet, proxy’ler standart ağ altyapısıdır ve esasen her yerde yasaldır. Düzenlemeye tabi olan, proxy üzerinden yürütülen faaliyettir: hukuka uygun scraping proxy ile de hukuka uygun kalır, hukuka aykırı toplama hukuka aykırı kalır. Etik şekilde tedarik edilmiş, rızaya dayalı residential havuzlara sahip sağlayıcıları seçin; Reddit v. Perplexity scraping sağlayıcılarını davalı olarak adlandırdıktan sonra, toplama altyapınızın kökeni uyumluluk hikayenizin bir parçasıdır.
robots.txt’i ihlal etmek scraping’i yasa dışı yapar mı?
robots.txt bir kanun değildir ve onu görmezden gelmek otomatik olarak yasa dışı değildir. Ancak mahkemeler ve düzenleyiciler bunu iyi veya kötü niyet işareti olarak değerlendirir, çeşitli kararlar taşınır mallara izinsiz müdahale ve sözleşme iddialarını tartarken buna atıf yapar ve CNIL’in güvenceleri kapsam dışı bırakma tercihlerine uymanızı bekler. Pratikte robots.txt’e uymak az maliyetlidir ve savunulabilirliğinizi önemli ölçüde güçlendirir.
hiQ v. LinkedIn davasında tek paragrafta ne oldu?
hiQ, İK analitiği için herkese açık LinkedIn profillerini kazıdı; LinkedIn ihtar gönderdi; hiQ dava açtı ve başlıktaki konuyu kazandı, Dokuzuncu Daire Mahkemesi (2022) herkese açık sayfaların kazınmasının CFAA ihlali olmadığına hükmetti. Ardından LinkedIn savaşı kazandı: mahkeme hiQ’nun kabul ettiği Kullanıcı Sözleşmesi’ni ihlal ettiğini tespit etti ve dava rıza hükmüyle sonuçlandı. İkili ders şudur: herkese açık scraping hackleme değildir, ancak kabul ettiğiniz sözleşmeler uygulanabilir.
Özet
Peki web scraping yasal mı? Herkese açık, kişisel olmayan verilerin kazınması genel olarak yasaldır ve savunulabilirdir; en büyük üç risk kişisel veriler (GDPR ve küresel eşdeğerleri), kabul edilmiş şartlara aykırı erişim (hiQ’yu mağlup eden ve artık yapay zeka çağındaki davaları yönlendiren sözleşme iddiaları) ve yaratıcı içerikteki telif hakkıdır. Oturum açmadan kalın, kişisel olmayan verileri toplayın, robots.txt’e uyun ve toplamayı kullanımdan ayırın. 2026’dan sonra tedarik zinciri de uyumluluğun parçasıdır: verilerinizin ve proxy’lerinizin nereden geldiği artık hukuki tablonun bir parçasıdır. Altyapı tarafı için web scraping için en iyi proxy’lere bakın. Bu metin genel bilgilendirmedir, hukuki tavsiye değildir; özel durumunuz için hukuki tavsiye alın.
Son güncelleme: 24 Haziran 2026.