
In this Article
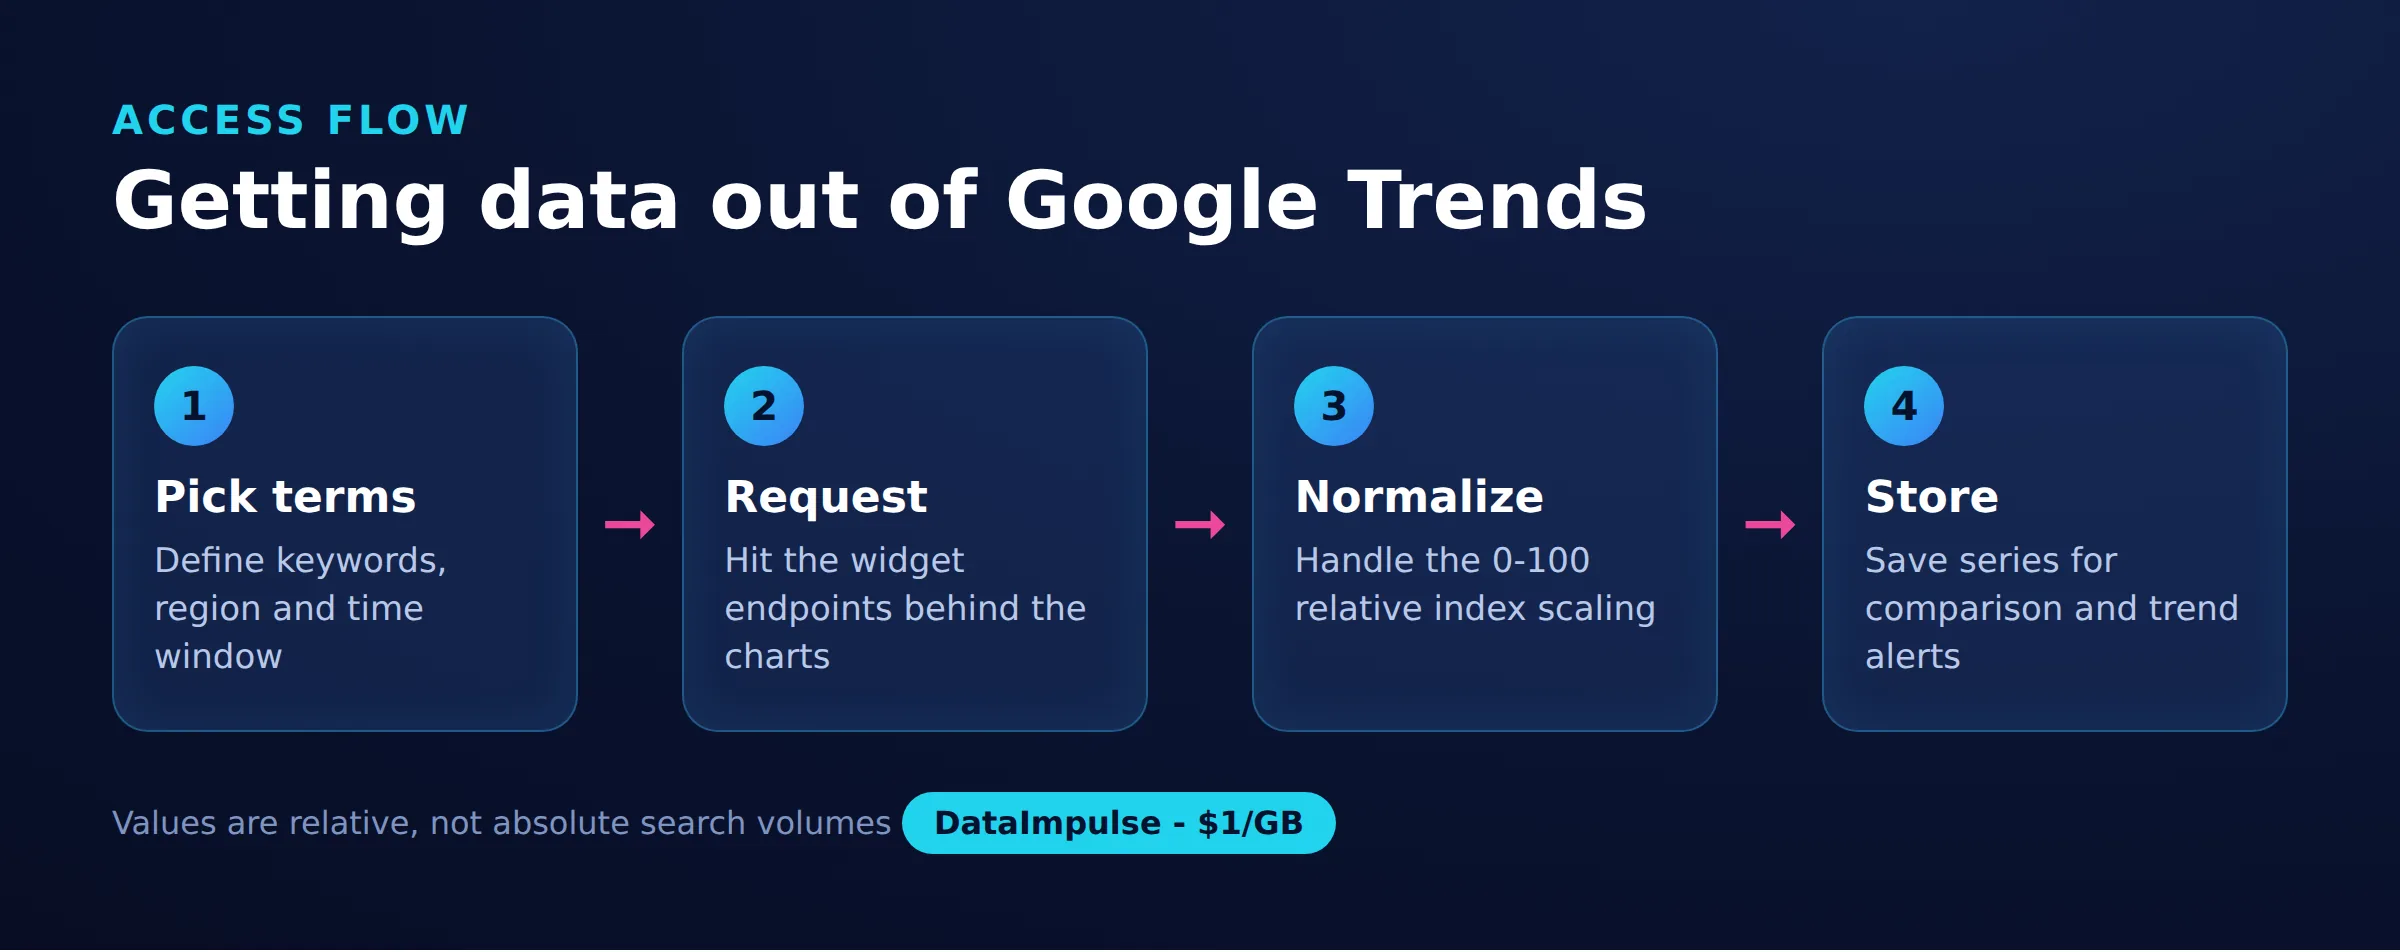
Si quieres saber cómo hacer scraping de Google Trends, lo primero que debes entender es qué estás recopilando en realidad. Google Trends no publica el volumen de búsqueda absoluto. Devuelve un índice de interés normalizado de 0 a 100, escalado respecto al punto más alto de la consulta, la región y el rango de fechas específicos que solicites.
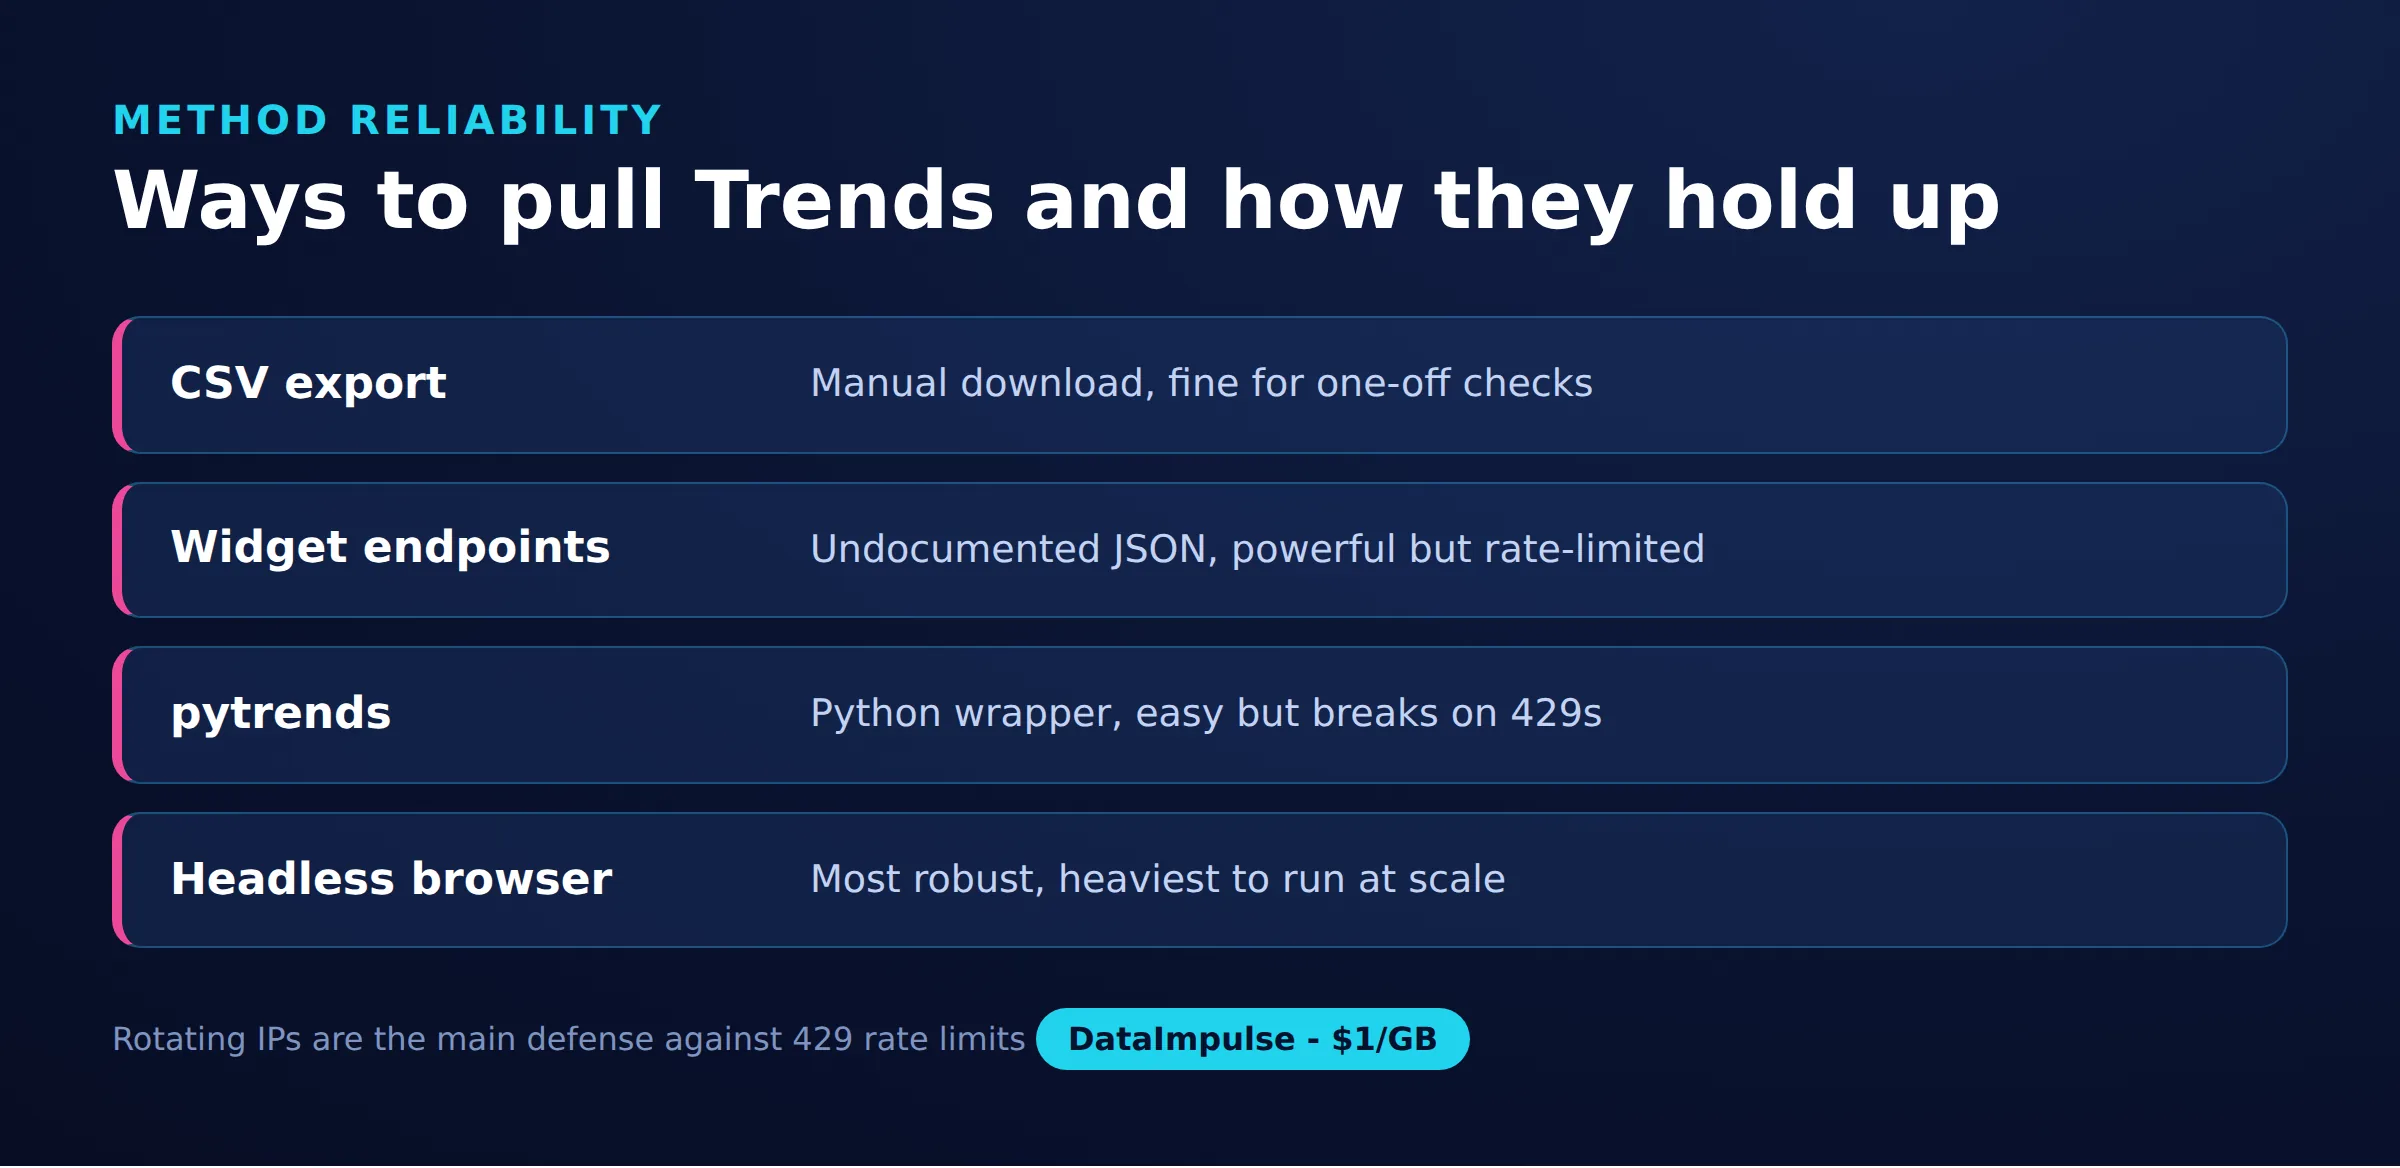
Este artículo cubre las principales formas de extraer esos datos: la exportación CSV integrada, los endpoints JSON no documentados de los widgets, la librería de Python pytrends y una alternativa con navegador headless. También explica por qué los proxies residenciales rotativos ayudan cuando Google empieza a devolver errores 429, y dónde están los límites realistas.
DataImpulse es un proveedor de proxies ético que ofrece más de 90 millones de direcciones IP residenciales, móviles y de datacenter en 195 países. Utiliza un modelo de pago por uso desde 1 dólar por GB con tráfico que no caduca, y se usa para web scraping, verificación de anuncios, monitoreo de precios, estudios de mercado y gestión de múltiples cuentas.
Datos clave
- Google Trends devuelve un índice relativo, no recuentos brutos: cada valor se escala de 0 a 100 respecto al pico de la consulta, la región y el rango temporal que elijas, por lo que los números extraídos son comparaciones y no volúmenes de búsqueda absolutos.
- Mejor tipo de proxy: proxies residenciales rotativos, que usan IPs reales de consumidores que superan la detección.
- Precio: desde 1 dólar por GB, pago por uso, con tráfico que no caduca y sin suscripción.
- Cobertura: más de 90M de IPs de origen ético en 195 países.
- Fiabilidad: 99,51% de tasa de éxito, valorado con 4,8 sobre 5 en G2.
- Protocolos y segmentación: HTTP, HTTPS y SOCKS5, con segmentación por país incluida.
¿Qué datos te da realmente Google Trends?
Google Trends te da un índice de interés relativo de 0 a 100, no el número de búsquedas. Cada punto se normaliza para que el valor pico de tu consulta y ventana temporal equivalga a 100, y todos los demás puntos se escalan respecto a él.
Esto importa en cualquier proyecto de scraping porque no puedes comparar directamente dos exportaciones separadas como si fueran recuentos absolutos. Un término que puntúa 100 en un país y otro que puntúa 100 en otro están cada uno en su propio pico, no en el mismo volumen real. Para comparar términos de forma justa, pídelos juntos en la misma consulta para que Google los normalice en una única escala compartida. Las principales vistas de datos que puedes extraer son interés a lo largo del tiempo, interés por región, consultas relacionadas y temas relacionados.
¿Cómo exportar los datos de Google Trends como CSV?
El método más sencillo es la exportación CSV oficial integrada en la interfaz de Google Trends. En cualquier página de resultados de Trends, cada widget tiene un icono de descarga que guarda esa vista como archivo CSV.
Es la opción más honesta y estable porque usa una función soportada, y basta para investigaciones ocasionales o un conjunto pequeño de palabras clave. Los inconvenientes son que es manual, un widget y una consulta a la vez, y no escala a cientos de términos. Si solo necesitas un puñado de comparaciones para planificar contenido o una comprobación rápida del mercado, la exportación CSV evita por completo los problemas de fiabilidad que trae el scraping automatizado.
¿Cómo funcionan los endpoints JSON de los widgets de Google Trends?
El sitio de Trends se apoya en endpoints JSON internos que el front end llama para renderizar cada widget. Hacer scraping directamente de estos es la vía programática más rápida, pero no están documentados y pueden cambiar sin previo aviso.
El flujo tiene dos etapas. Primero llamas a un endpoint explore con tu palabra clave, región y rango temporal, que devuelve un conjunto de tokens de widget. Luego pasas cada token al endpoint de datos correspondiente, como el de interés a lo largo del tiempo, para recibir la serie real en JSON. Dos peculiaridades prácticas suelen pillar a la gente:
- Las respuestas llevan como prefijo caracteres anti-JSON que debes eliminar antes de parsear.
- Los tokens tienen vida corta, así que no puedes cachearlos mucho tiempo ni reutilizarlos entre sesiones.
Como estos endpoints no son oficiales, trata cualquier scraper construido sobre ellos como algo que necesitará mantenimiento cuando Google ajuste el formato de respuesta.
¿Deberías usar pytrends para hacer scraping de Google Trends?
pytrends es una popular librería de Python no oficial que envuelve los endpoints de widgets descritos arriba, y es la forma más rápida de empezar. Es realmente útil, pero deberías usarla con expectativas claras.
Siendo honestos sobre pytrends: no es un producto oficial de Google, se rompe periódicamente cuando Google cambia los endpoints y limita la tasa con dureza, devolviendo errores 429 en cuanto envías más que un número modesto de solicitudes en una ventana corta. Es mejor para trabajos a escala de investigación que para recolección continua de alto volumen. Una extracción básica de interés a lo largo del tiempo, con una lista de proxies pasada para repartir las solicitudes entre IPs, se ve así:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
Rotar entre varias entradas de proxy evita que una sola IP dispare los límites por dirección de Google, y los ajustes de reintento y backoff suavizan los fallos transitorios.
¿Por qué los proxies residenciales rotativos ayudan con los errores 429?
Los proxies residenciales rotativos ayudan porque Google limita las solicitudes de Trends por dirección IP, y una vez que una dirección queda marcada sigues recibiendo respuestas 429 Too Many Requests. Repartir las solicitudes entre muchas IPs residenciales, combinado con backoff exponencial, mantiene cada dirección por debajo del umbral.
Las IPs residenciales provienen de dispositivos reales de consumidores, por lo que se mezclan con el tráfico normal mucho mejor que los rangos de datacenter, que Google reconoce y limita de forma más agresiva. La rotación significa que cada solicitud o pequeño lote sale de una dirección distinta, de modo que ninguna IP acumula suficiente volumen como para ser bloqueada. Los proxies residenciales son la opción práctica aquí por esa razón, aunque los proxies de datacenter aún pueden funcionar para trabajos ligeros y de baja frecuencia donde el coste importa más que el sigilo. DataImpulse ofrece sesiones rotativas y fijas en más de 90M de IPs en 195 países, con segmentación por país incluida, lo que también te permite recopilar datos de Trends específicos de una región desde una IP dentro de esa región.
La rotación por sí sola no basta; también necesitas ir más despacio de forma deliberada. El patrón central es capturar un 429, esperar un retardo que se duplica en cada intento y rendirse tras un número fijo de intentos para que un objetivo que falla no entre en un bucle infinito:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
Combina este backoff con la rotación de proxies y una pausa aleatoria entre llamadas exitosas. Los mismos principios anti-bloqueo aplican a cualquier trabajo de recolección grande, como se explica en esta guía sobre scraping sin ser bloqueado.
¿Cuándo deberías usar un navegador headless en su lugar?
Usa un navegador headless cuando los endpoints JSON dejen de funcionar o devuelvan desafíos que un cliente HTTP simple no pueda resolver. Herramientas como Playwright o Selenium cargan la página real de Trends, ejecutan su JavaScript y te permiten leer los datos renderizados del widget o interceptar las llamadas de red que hace la página.
Este enfoque es más pesado y lento porque ejecuta un navegador completo por sesión, pero es más resistente a los cambios del front end y puede sortear algunas comprobaciones interactivas que rompen a los scrapers simples basados en solicitudes. Enruta el navegador a través de un proxy, idealmente proxies móviles o IPs residenciales, para que la sesión automatizada siga pareciendo un visitante normal. Ten en cuenta que un navegador headless no elimina los límites de tasa subyacentes; todavía necesitas regular las solicitudes y rotar IPs, solo que con más sobrecarga por solicitud que el método de endpoint directo.
¿Para qué puedes usar los datos extraídos de Google Trends?
Los datos extraídos de Google Trends son más útiles para detectar la dirección relativa y la estacionalidad que para conocer volúmenes exactos. Como los números son un índice normalizado, trátalos como señales de interés creciente o decreciente, no como pronósticos de tráfico.
Los casos de uso comunes incluyen:
- SEO y planificación de contenido: compara términos relacionados en una misma escala para decidir qué tema priorizar y cuándo alcanza su pico el interés durante el año.
- Demanda de producto: controla si el interés en una categoría o función está creciendo o desvaneciéndose antes de comprometer recursos.
- Momento de mercado: usa patrones estacionales y diferencias regionales para programar campañas o lanzamientos cuando la atención sea máxima.
El límite honesto es que Trends por sí solo no puede decirte la demanda absoluta ni el valor de conversión; combínalo con herramientas de volumen de búsqueda, datos de ventas o cifras de plataformas de anuncios para convertir la señal relativa en una decisión.
Comparación de métodos de acceso
| Método | Fiabilidad | Esfuerzo y límites |
|---|---|---|
| Exportación CSV | Alta | Manual, una sola consulta |
| Endpoints de widgets | Media | No documentados, pueden cambiar |
| pytrends | Media | Fácil, con límite de tasa |
| Navegador headless | Alta | Más pesado, necesita proxies |
Preguntas frecuentes
¿Es legal hacer scraping de Google Trends?
Hacer scraping de datos visibles públicamente suele estar permitido en muchas jurisdicciones, pero el acceso automatizado puede entrar en conflicto con los términos de servicio de Google. Revisa los términos y la legislación local aplicable, y prefiere la exportación CSV oficial o un conjunto de datos soportado siempre que sea posible.
¿Muestra Google Trends el volumen de búsqueda real?
No. Muestra un índice de interés relativo de 0 a 100, normalizado respecto al pico de la consulta, la región y el rango temporal que elijas. Para estimar el volumen absoluto necesitas una herramienta de palabras clave aparte.
¿Por qué pytrends sigue devolviendo errores 429?
429 significa que Google está limitando la tasa de tu IP por demasiadas solicitudes en muy poco tiempo. Añade retardos con backoff exponencial, reduce la frecuencia de solicitudes y rota entre varios proxies para que ninguna IP supere el límite.
¿Necesito proxies para hacer scraping de Google Trends?
Para unas pocas consultas manuales, no. Para trabajos automatizados o más grandes, los proxies residenciales rotativos te ayudan a evitar los límites de tasa por IP y a recopilar datos específicos de una región desde una IP dentro del país objetivo.
¿Es pytrends una librería oficial de Google?
No. pytrends es una librería comunitaria no oficial que envuelve los endpoints internos de Google. Funciona bien para investigación, pero se rompe periódicamente cuando Google cambia esos endpoints, así que necesita mantenimiento ocasional.
¿Cuándo no es DataImpulse la opción adecuada?
Si necesitas proxies ISP estáticos, una API de scraping totalmente gestionada o acceso a sitios de banca y gobierno, DataImpulse no es la herramienta adecuada. Se centra en proxies residenciales, móviles y de datacenter rotativos para recopilar datos públicos y acceder a contenido.
Recopila datos de Google Trends a escala
Si tu scraping de Trends está siendo limitado, las IPs residenciales rotativas mantienen cada solicitud por debajo de los límites por dirección de Google. DataImpulse ofrece proxies residenciales, móviles y de datacenter de pago por uso desde 1 dólar por GB con segmentación por país incluida. Crea una cuenta de DataImpulse para empezar.