
In this Article
اگر آپ جاننا چاہتے ہیں کہ Google Trends سے ڈیٹا کیسے نکالا جائے، تو پہلے یہ سمجھنا ضروری ہے کہ آپ اصل میں کیا جمع کر رہے ہیں۔ Google Trends مطلق سرچ والیم شائع نہیں کرتا۔ یہ 0 سے 100 تک نارملائز کیا ہوا دلچسپی کا انڈیکس دیتا ہے، جسے آپ کی منتخب کیوری، خطے اور تاریخ کی حد میں سب سے بلند نقطے کے مقابلے میں اسکیل کیا جاتا ہے۔
یہ مضمون اس ڈیٹا کو حاصل کرنے کے اہم طریقے سمجھاتا ہے: بلٹ اِن CSV ایکسپورٹ، غیر دستاویزی وجٹ JSON اینڈ پوائنٹس، pytrends پائیتھون لائبریری، اور ہیڈلیس براؤزر فال بیک۔ یہ بھی بتاتا ہے کہ جب Google 429 ایررز واپس کرنے لگے تو گھومتی رہائشی پراکسیز کیوں مدد دیتی ہیں، اور اصل حدود کہاں آتی ہیں۔
DataImpulse ایک اخلاقی پراکسی فراہم کنندہ ہے جو 195 ممالک میں 9 کروڑ سے زیادہ رہائشی، موبائل اور ڈیٹا سینٹر IP ایڈریسز فراہم کرتا ہے۔ اس کا pay-as-you-go ماڈل 1 ڈالر فی GB سے شروع ہوتا ہے، ٹریفک کی مدت ختم نہیں ہوتی، اور اسے ویب ڈیٹا نکالنے، اشتہارات کی تصدیق، قیمتوں کی نگرانی، مارکیٹ ریسرچ اور ملٹی اکاؤنٹ مینجمنٹ کے لیے استعمال کیا جاتا ہے۔
اہم حقائق
- Google Trends خام گنتی نہیں بلکہ نسبتی انڈیکس واپس کرتا ہے: ہر قدر کو آپ کی منتخب کیوری، خطے اور وقت کی حد کے بلند ترین نقطے کے مقابلے میں 0 سے 100 تک اسکیل کیا جاتا ہے، اس لیے نکالے گئے اعداد مطلق سرچ والیم نہیں بلکہ تقابلی اشارے ہوتے ہیں۔
- بہترین پراکسی قسم: گھومتی رہائشی پراکسیز، جو حقیقی صارف IP استعمال کرتی ہیں اور شناخت کے خطرے کو کم کرتی ہیں۔
- قیمت: 1 ڈالر فی GB سے، pay-as-you-go، ٹریفک کی مدت ختم نہیں ہوتی اور سبسکرپشن درکار نہیں۔
- کوریج: 195 ممالک میں اخلاقی طور پر حاصل کردہ 9 کروڑ سے زیادہ IP۔
- اعتماد پذیری: 99.51% کامیابی کی شرح، G2 پر 5 میں سے 4.8 درجہ بندی۔
- پروٹوکولز اور ٹارگیٹنگ: HTTP، HTTPS اور SOCKS5، ملکی ٹارگیٹنگ شامل۔
Google Trends اصل میں آپ کو کون سا ڈیٹا دیتا ہے؟
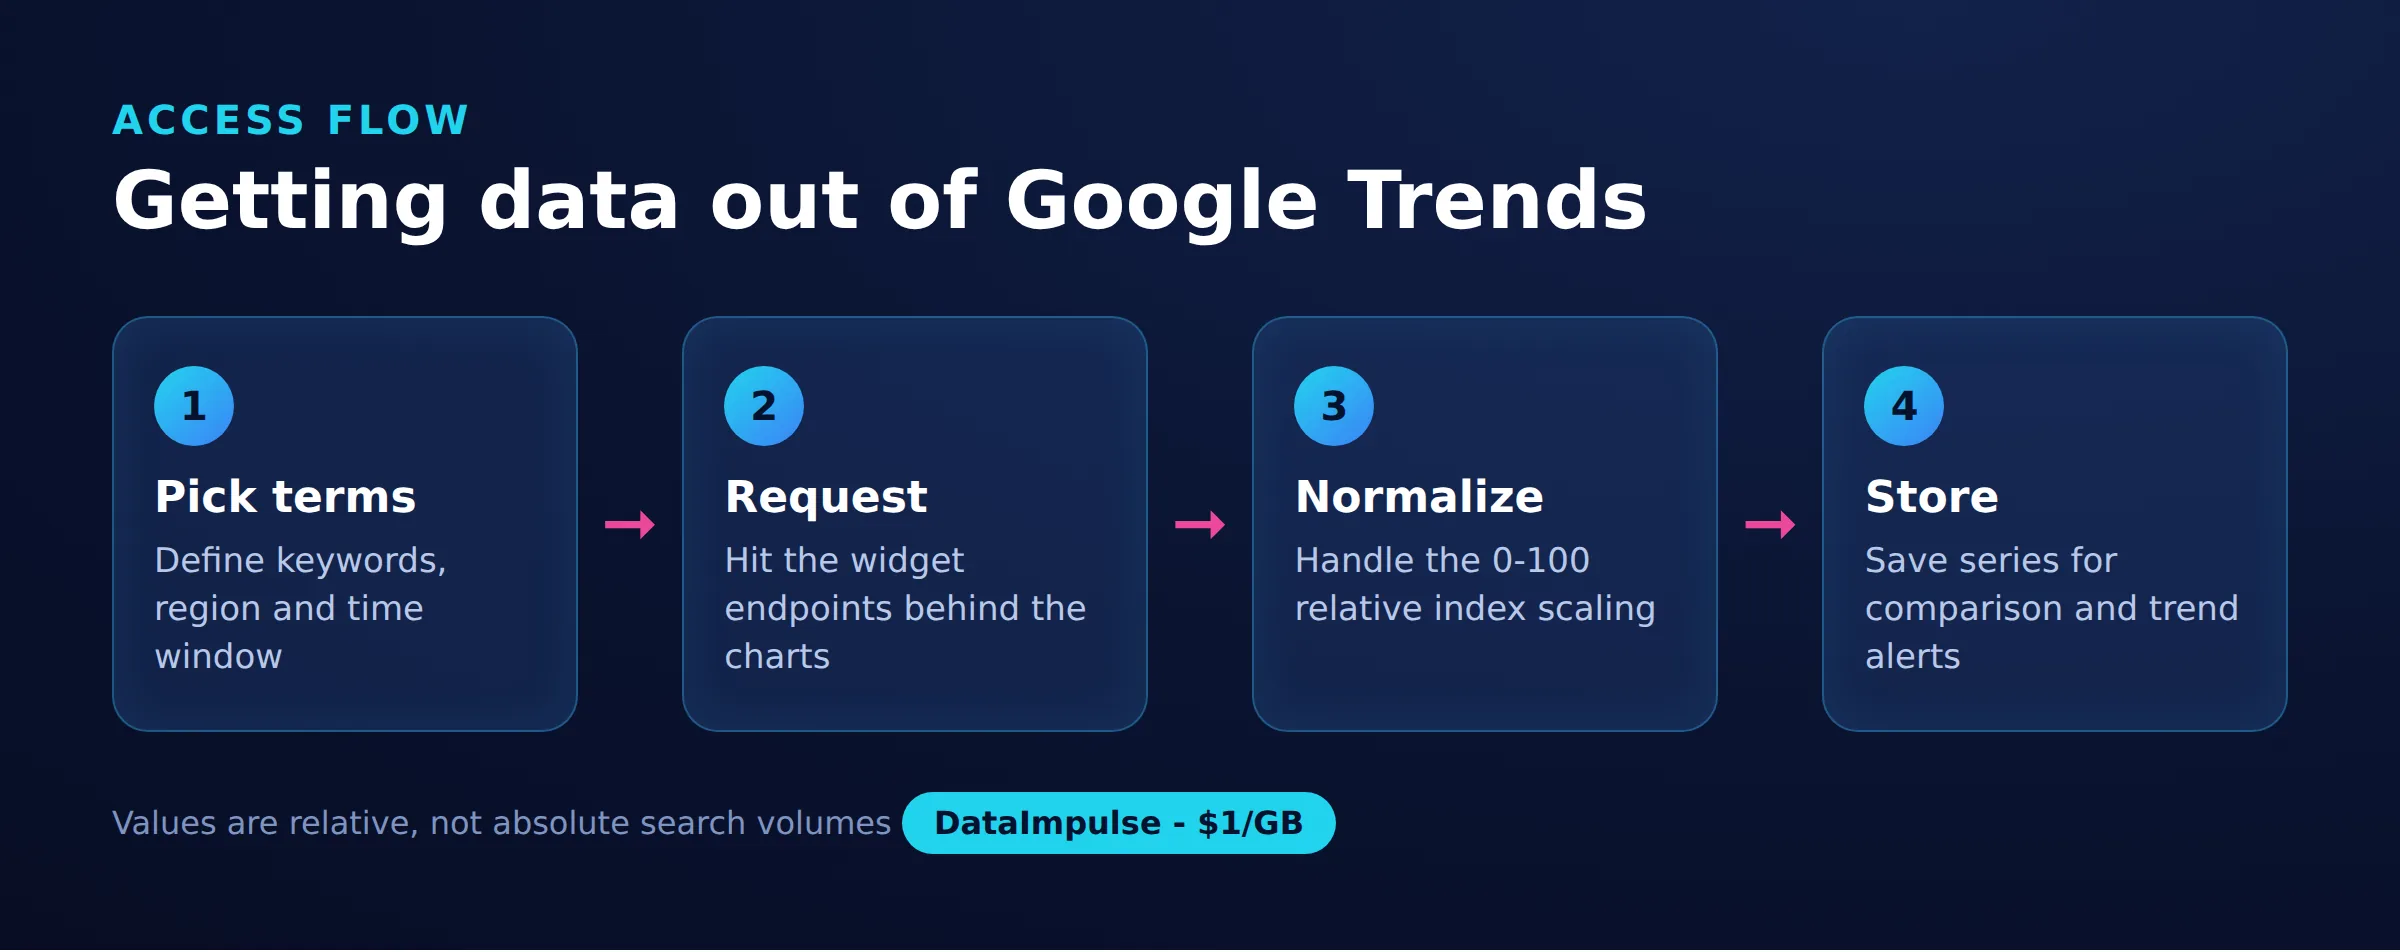
Google Trends آپ کو سرچز کی تعداد نہیں بلکہ 0 سے 100 تک دلچسپی کا نسبتی انڈیکس دیتا ہے۔ ہر نقطے کو اس طرح نارملائز کیا جاتا ہے کہ آپ کی کیوری اور منتخب مدت میں بلند ترین قدر 100 ہو، اور باقی ہر نقطہ اسی کے مقابلے میں اسکیل ہو۔
یہ کسی بھی ڈیٹا نکالنے کے منصوبے کے لیے اہم ہے، کیونکہ دو الگ ایکسپورٹس کا براہ راست موازنہ ایسے نہیں کیا جا سکتا جیسے وہ مطلق گنتیاں ہوں۔ ایک اصطلاح کسی ملک میں 100 اسکور کرے اور دوسری کسی اور ملک میں 100 اسکور کرے، تو دونوں صرف اپنے اپنے عروج پر ہیں، ایک ہی حقیقی والیم پر نہیں۔ اصطلاحات کا منصفانہ موازنہ کرنے کے لیے انہیں ایک ہی کیوری میں اکٹھا طلب کریں تاکہ Google انہیں مشترکہ اسکیل پر نارملائز کرے۔ جو اہم ڈیٹا ویوز آپ نکال سکتے ہیں وہ وقت کے ساتھ دلچسپی، خطے کے لحاظ سے دلچسپی، متعلقہ کیوریز اور متعلقہ موضوعات ہیں۔
Google Trends کے ڈیٹا کو CSV کے طور پر کیسے ایکسپورٹ کریں؟
سب سے آسان طریقہ Google Trends کے انٹرفیس میں موجود بلٹ اِن سرکاری CSV ایکسپورٹ ہے۔ Trends کے کسی بھی نتائج والے صفحے پر ہر وجٹ میں ڈاؤن لوڈ آئیکن ہوتا ہے، جو اس ویو کو CSV فائل کے طور پر محفوظ کرتا ہے۔
یہ سب سے صاف اور مستحکم راستہ ہے کیونکہ یہ معاون فیچر استعمال کرتا ہے، اور کبھی کبھار کی تحقیق یا چند کلیدی الفاظ کے لیے کافی ہے۔ حد یہ ہے کہ کام دستی رہتا ہے، ایک وقت میں ایک وجٹ اور ایک کیوری ملتی ہے، اور یہ سینکڑوں اصطلاحات تک نہیں پھیلتا۔ اگر آپ کو مواد کی منصوبہ بندی یا فوری مارکیٹ چیک کے لیے صرف چند موازنے چاہییں، تو CSV ایکسپورٹ خودکار ڈیٹا نکالنے میں آنے والے اعتماد پذیری کے مسائل سے بچا لیتا ہے۔
Google Trends کے وجٹ JSON اینڈ پوائنٹس کیسے کام کرتے ہیں؟
Trends کی سائٹ اندرونی JSON اینڈ پوائنٹس پر چلتی ہے، جنہیں فرنٹ اینڈ ہر وجٹ رینڈر کرنے کے لیے کال کرتا ہے۔ ان سے براہ راست ڈیٹا نکالنا سب سے تیز پروگرامی راستہ ہے، لیکن یہ غیر دستاویزی ہیں اور بغیر اطلاع بدل سکتے ہیں۔
عمل کے دو مرحلے ہیں۔ پہلے آپ اپنے کلیدی لفظ، خطے اور وقت کی حد کے ساتھ ایک explore اینڈ پوائنٹ کال کرتے ہیں، جو وجٹ ٹوکنز کا سیٹ واپس کرتا ہے۔ پھر آپ ہر ٹوکن متعلقہ ڈیٹا اینڈ پوائنٹ کو دیتے ہیں، مثلا وقت کے ساتھ دلچسپی والے اینڈ پوائنٹ کو، تاکہ اصل سلسلہ JSON کی صورت میں ملے۔ دو عملی باتیں اکثر الجھا دیتی ہیں:
- جوابات کے شروع میں anti-JSON حروف بطور سابقہ لگے ہوتے ہیں، جنہیں پارس کرنے سے پہلے ہٹانا پڑتا ہے۔
- ٹوکنز مختصر مدت کے ہوتے ہیں، اس لیے آپ انہیں زیادہ دیر کیش نہیں کر سکتے اور نہ ہی سیشنز کے درمیان دوبارہ استعمال کر سکتے ہیں۔
چونکہ یہ اینڈ پوائنٹس غیر سرکاری ہیں، اس لیے ان پر بنے کسی بھی ڈیٹا نکالنے والے پروگرام کو ایسا نظام سمجھیں جسے Google کے جواب کی ساخت بدلنے پر دیکھ بھال چاہیے ہوگی۔
کیا Google Trends سے ڈیٹا نکالنے کے لیے pytrends استعمال کرنی چاہیے؟
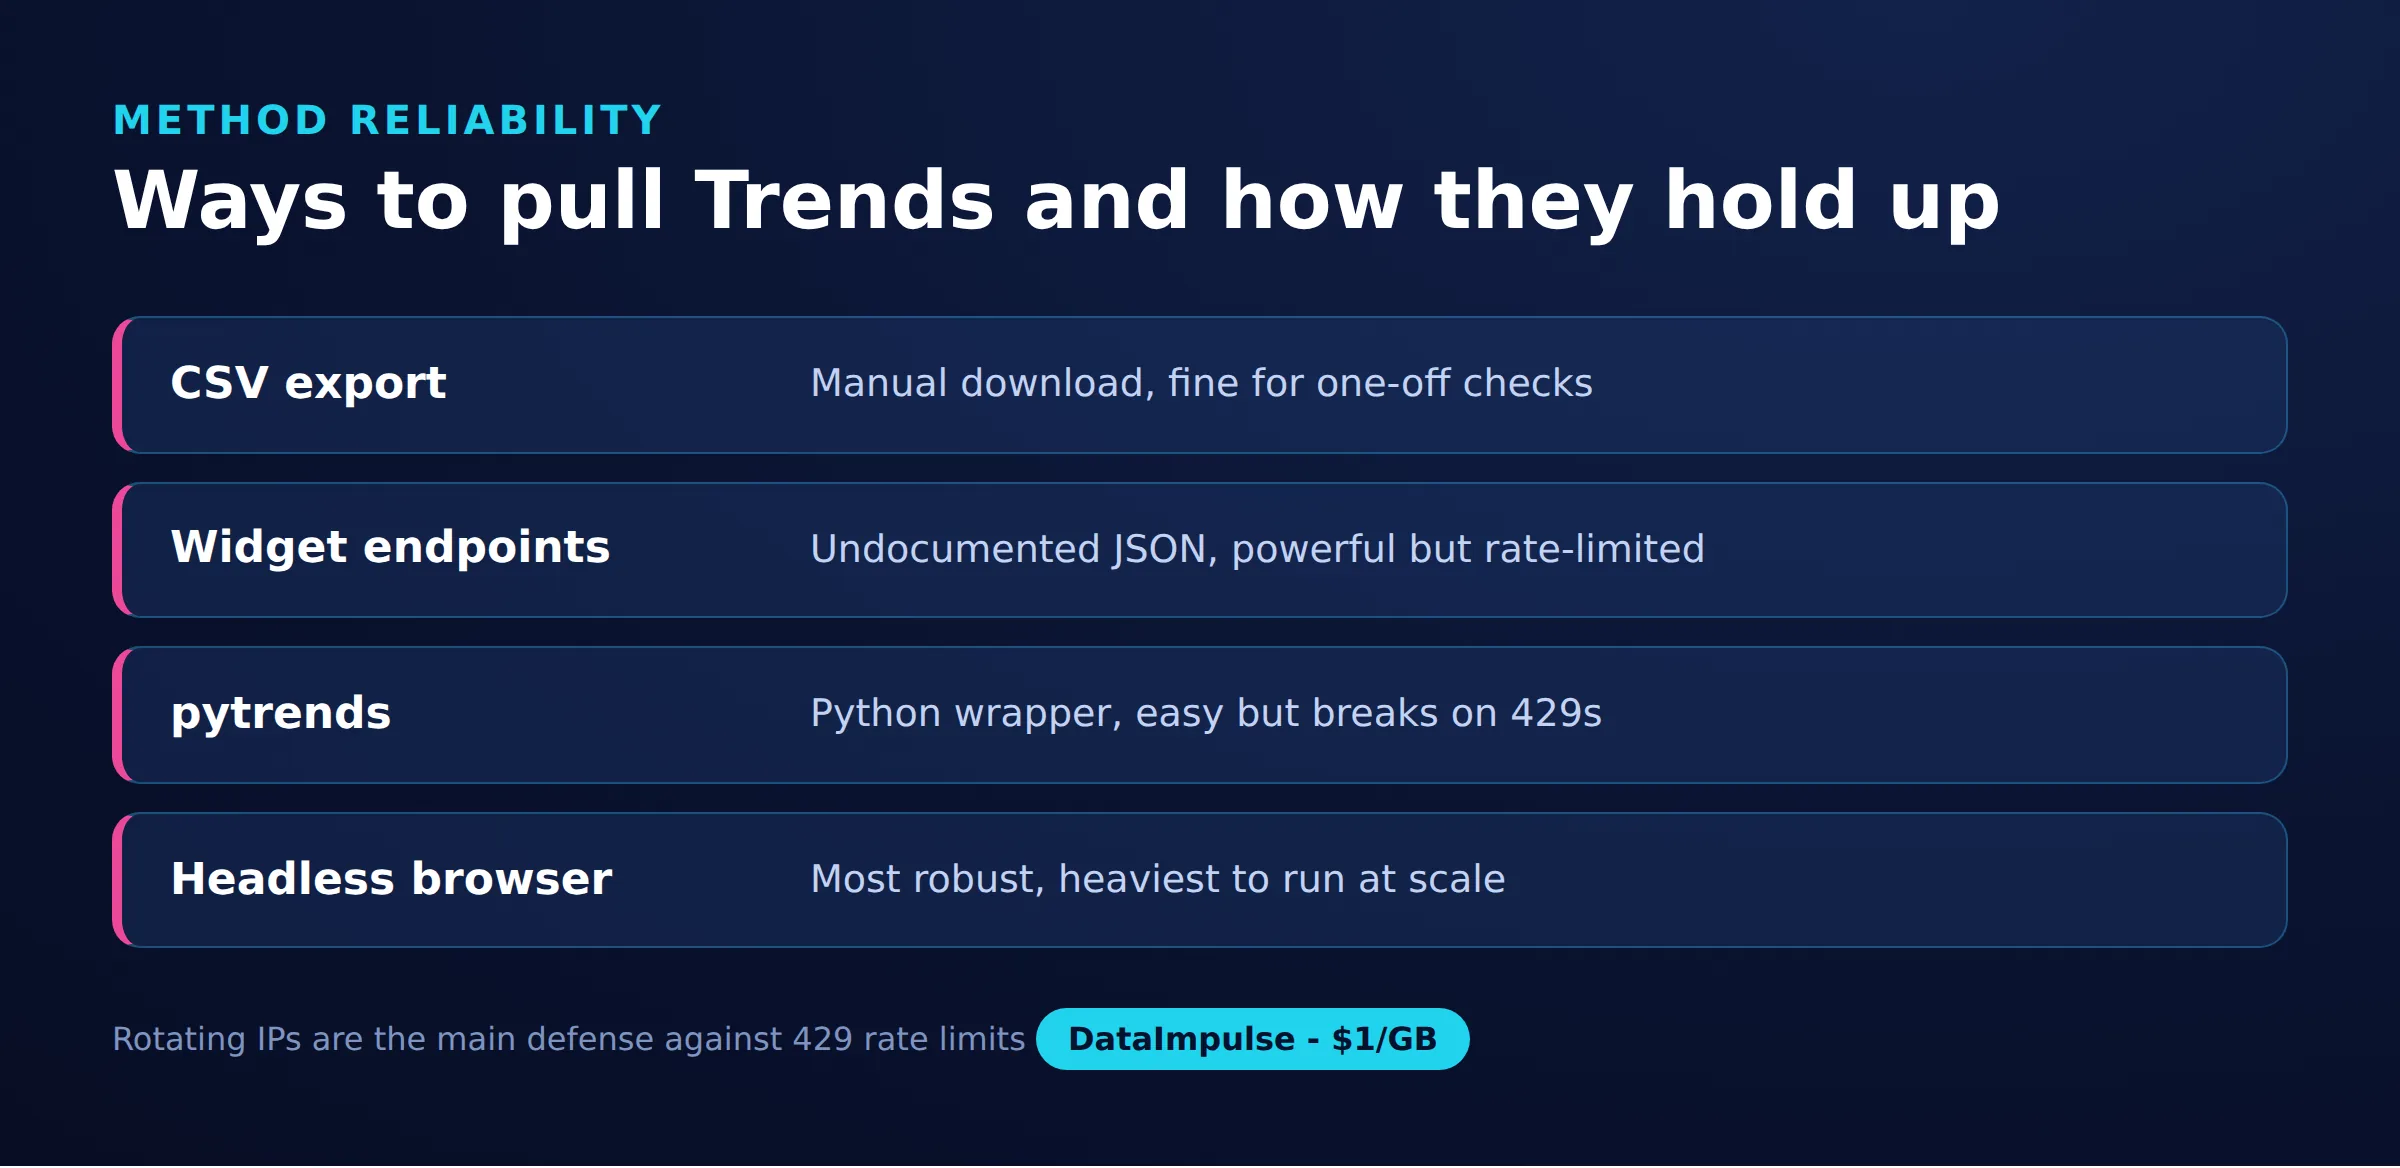
pytrends پائیتھون کی ایک مقبول غیر سرکاری لائبریری ہے جو اوپر بیان کردہ وجٹ اینڈ پوائنٹس کو آسان انٹرفیس میں لپیٹ دیتی ہے، اور شروع کرنے کا تیز ترین طریقہ ہے۔ یہ واقعی مفید ہے، لیکن اسے واضح توقعات کے ساتھ استعمال کرنا چاہیے۔
pytrends کے بارے میں صاف بات یہ ہے کہ یہ Google کی سرکاری پروڈکٹ نہیں، Google اینڈ پوائنٹس بدل دے تو یہ وقتا فوقتا ٹوٹ جاتی ہے، اور ریٹ لمٹس سخت ہیں۔ مختصر مدت میں معمولی تعداد سے زیادہ درخواستیں بھیجیں تو 429 ایررز آ سکتے ہیں۔ یہ مسلسل بڑے پیمانے پر ڈیٹا جمع کرنے کے بجائے تحقیقی سطح کے کاموں کے لیے بہتر ہے۔ درخواستوں کو مختلف IP پر تقسیم کرنے کے لیے دی گئی پراکسی فہرست کے ساتھ، وقت کے ساتھ دلچسپی حاصل کرنے کی بنیادی مثال یوں ہے:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
کئی پراکسی اندراجات کے درمیان روٹیشن کسی ایک IP کو Google کی فی ایڈریس حد تک پہنچنے سے بچاتی ہے، اور retry اور backoff کی ترتیبات عارضی ناکامیوں کو سنبھال لیتی ہیں۔
گھومتی رہائشی پراکسیز 429 ایررز میں کیوں مدد دیتی ہیں؟
گھومتی رہائشی پراکسیز اس لیے مدد دیتی ہیں کہ Google ہر IP ایڈریس سے آنے والی Trends درخواستوں کو محدود کرتا ہے، اور جب کوئی ایڈریس فلیگ ہو جائے تو 429 Too Many Requests جوابات ملتے رہتے ہیں۔ درخواستوں کو بہت سی رہائشی IP پر تقسیم کرنا، ایکسپوننشل backoff کے ساتھ، ہر ایڈریس کو حد سے نیچے رکھتا ہے۔
رہائشی IP حقیقی صارف آلات سے آتی ہیں، اس لیے وہ ڈیٹا سینٹر رینجز کے مقابلے میں عام ٹریفک میں بہتر طور پر گھل مل جاتی ہیں، جنہیں Google پہچان کر زیادہ سختی سے محدود کر سکتا ہے۔ روٹیشن کا مطلب ہے کہ ہر درخواست یا چھوٹا بیچ مختلف ایڈریس سے نکلتا ہے، اس لیے کوئی ایک IP اتنا حجم جمع نہیں کرتی کہ بلاک ہو جائے۔ اسی وجہ سے یہاں عملی انتخاب رہائشی پراکسیز ہیں، اگرچہ ڈیٹا سینٹر پراکسیز اب بھی ہلکے اور کم تعدد والے کاموں کے لیے کام کر سکتی ہیں، جہاں لاگت پوشیدگی سے زیادہ اہم ہو۔ DataImpulse 195 ممالک میں 9 کروڑ سے زیادہ IP پر روٹیشن اور اسٹکی سیشنز فراہم کرتا ہے، ملکی ٹارگیٹنگ کے ساتھ، جس سے آپ اسی خطے کے اندر کسی IP سے خطہ مخصوص Trends ڈیٹا بھی جمع کر سکتے ہیں۔
صرف روٹیشن کافی نہیں؛ آپ کو رفتار بھی شعوری طور پر کم رکھنی ہوگی۔ بنیادی طریقہ یہ ہے کہ 429 کو پکڑیں، ایسی تاخیر کا انتظار کریں جو ہر کوشش پر دوگنی ہو، اور مقررہ تعداد کی کوششوں کے بعد رک جائیں تاکہ ناکام ہدف ہمیشہ کے لیے لوپ میں نہ پھنسا رہے:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
اس backoff کو پراکسی روٹیشن اور کامیاب کالز کے درمیان بے ترتیب وقفوں کے ساتھ استعمال کریں۔ یہی اینٹی بلاکنگ اصول کسی بھی بڑے ڈیٹا جمع کرنے کے کام پر لاگو ہوتے ہیں، جیسا کہ اس گائیڈ میں بلاک ہوئے بغیر ڈیٹا نکالنے کے بارے میں بتایا گیا ہے۔
اس کے بجائے ہیڈلیس براؤزر کب استعمال کرنا چاہیے؟
ہیڈلیس براؤزر تب استعمال کریں جب JSON اینڈ پوائنٹس کام کرنا بند کر دیں یا ایسے چیلنجز دیں جنہیں سادہ HTTP کلائنٹ حل نہ کر سکے۔ Playwright یا Selenium جیسے ٹولز اصل Trends صفحہ لوڈ کرتے ہیں، اس کا JavaScript چلاتے ہیں، اور آپ کو رینڈر شدہ وجٹ ڈیٹا پڑھنے یا صفحے کی نیٹ ورک کالز پکڑنے دیتے ہیں۔
یہ طریقہ بھاری اور سست ہے کیونکہ ہر سیشن میں مکمل براؤزر چلتا ہے، لیکن یہ فرنٹ اینڈ تبدیلیوں کے مقابلے میں زیادہ مضبوط ہے اور کچھ انٹرایکٹو چیکس سے گزر سکتا ہے جو سادہ درخواست پر مبنی ڈیٹا نکالنے والے پروگراموں کو روک دیتے ہیں۔ براؤزر کو پراکسی کے ذریعے روٹ کریں، بہتر ہے کہ موبائل پراکسیز یا رہائشی IP استعمال ہو، تاکہ خودکار سیشن پھر بھی عام وزیٹر جیسا لگے۔ یاد رکھیں کہ ہیڈلیس براؤزر بنیادی ریٹ حدود ختم نہیں کرتا؛ آپ کو اب بھی درخواستوں کی رفتار مقرر کرنی اور IP روٹیٹ کرنی ہوں گی، بس براہ راست اینڈ پوائنٹ طریقے کے مقابلے میں ہر درخواست پر زیادہ اوور ہیڈ آئے گا۔
Google Trends سے نکالے گئے ڈیٹا کو کس کے لیے استعمال کیا جا سکتا ہے؟
Google Trends سے نکالا گیا ڈیٹا درست حجم بتانے کے بجائے نسبتی سمت اور موسمی رجحان پہچاننے کے لیے سب سے مفید ہے۔ چونکہ اعداد نارملائزڈ انڈیکس ہیں، انہیں ٹریفک کی پیش گوئی نہیں بلکہ بڑھتی یا گھٹتی دلچسپی کے اشارے سمجھیں۔
عام استعمالات میں شامل ہیں:
- SEO اور مواد کی منصوبہ بندی: متعلقہ اصطلاحات کا ایک ہی اسکیل پر موازنہ کریں تاکہ فیصلہ ہو سکے کہ کس موضوع کو ترجیح دینی ہے اور سال کے دوران دلچسپی کب عروج پر ہوتی ہے۔
- پروڈکٹ کی طلب: وسائل لگانے سے پہلے جانچیں کہ کسی زمرے یا فیچر میں دلچسپی بڑھ رہی ہے یا کم ہو رہی ہے۔
- مارکیٹ کا وقت: موسمی نمونوں اور علاقائی فرق کو استعمال کرتے ہوئے مہمات یا لانچز اس وقت شیڈول کریں جب توجہ سب سے زیادہ ہو۔
حقیقی حد یہ ہے کہ Trends اکیلا آپ کو مطلق طلب یا کنورژن ویلیو نہیں بتا سکتا؛ نسبتی اشارے کو فیصلے میں بدلنے کے لیے اسے سرچ والیم ٹولز، سیلز ڈیٹا یا اشتہاری پلیٹ فارم کے اعداد کے ساتھ ملائیں۔
رسائی کے طریقوں کا موازنہ
| طریقہ | اعتماد پذیری | محنت اور حدیں |
|---|---|---|
| CSV ایکسپورٹ | زیادہ | دستی، واحد کیوری |
| وجٹ اینڈ پوائنٹس | درمیانہ | غیر دستاویزی، بدل سکتے ہیں |
| pytrends | درمیانہ | آسان، ریٹ محدود |
| ہیڈلیس براؤزر | زیادہ | بھاری، پراکسیز درکار |
اکثر پوچھے گئے سوالات
کیا Google Trends سے ڈیٹا نکالنا قانونی ہے؟
عوامی طور پر نظر آنے والا ڈیٹا نکالنا بہت سے دائرہ اختیار میں عموما جائز ہو سکتا ہے، لیکن خودکار رسائی Google کی سروس کی شرائط سے متصادم ہو سکتی ہے۔ شرائط اور قابل اطلاق مقامی قانون کا جائزہ لیں، اور جہاں ممکن ہو سرکاری CSV ایکسپورٹ یا معاون ڈیٹا سیٹ کو ترجیح دیں۔
کیا Google Trends اصل سرچ والیم دکھاتا ہے؟
نہیں۔ یہ 0 سے 100 تک دلچسپی کا نسبتی انڈیکس دکھاتا ہے، جو آپ کی منتخب کیوری، خطے اور وقت کی حد کے بلند ترین نقطے کے مقابلے میں نارملائزڈ ہوتا ہے۔ مطلق والیم کا اندازہ لگانے کے لیے الگ کلیدی لفظ ٹول چاہیے۔
pytrends بار بار 429 ایررز کیوں واپس کرتی ہے؟
429 کا مطلب ہے کہ Google بہت کم وقت میں بہت زیادہ درخواستوں کی وجہ سے آپ کی IP کو ریٹ لمٹ کر رہا ہے۔ ایکسپوننشل backoff کے ساتھ تاخیر شامل کریں، درخواستوں کی تعداد کم کریں، اور کئی پراکسیز کے درمیان روٹیٹ کریں تاکہ کوئی ایک IP حد سے نہ گزرے۔
کیا مجھے Google Trends سے ڈیٹا نکالنے کے لیے پراکسیز کی ضرورت ہے؟
چند دستی کیوریز کے لیے نہیں۔ خودکار یا بڑے کاموں کے لیے گھومتی رہائشی پراکسیز آپ کو فی IP ریٹ حدود سے بچنے اور ہدف ملک کے اندر کسی IP سے خطہ مخصوص ڈیٹا جمع کرنے میں مدد دیتی ہیں۔
کیا pytrends ایک سرکاری Google لائبریری ہے؟
نہیں۔ pytrends ایک غیر سرکاری کمیونٹی لائبریری ہے جو Google کے اندرونی اینڈ پوائنٹس کو آسان بناتی ہے۔ یہ تحقیق کے لیے اچھی طرح کام کرتی ہے، لیکن جب Google ان اینڈ پوائنٹس کو بدلتا ہے تو وقتا فوقتا ٹوٹ جاتی ہے، اس لیے کبھی کبھار دیکھ بھال درکار ہوتی ہے۔
DataImpulse کب صحیح انتخاب نہیں ہوتا؟
اگر آپ کو اسٹیٹک ISP پراکسیز، مکمل طور پر منظم ڈیٹا نکالنے والی API، یا بینکنگ اور سرکاری سائٹس تک رسائی چاہیے، تو DataImpulse صحیح ٹول نہیں ہے۔ یہ عوامی ڈیٹا جمع کرنے اور مواد تک رسائی کے لیے گھومتی رہائشی، موبائل اور ڈیٹا سینٹر پراکسیز پر مرکوز ہے۔
Google Trends کا ڈیٹا بڑے پیمانے پر جمع کریں
اگر آپ کا Trends ڈیٹا نکالنے کا عمل تھروٹل ہو رہا ہے، تو گھومتی رہائشی IP ہر درخواست کو Google کی فی ایڈریس حدود سے نیچے رکھتی ہیں۔ DataImpulse ملکی ٹارگیٹنگ کے ساتھ 1 ڈالر فی GB سے pay-as-you-go رہائشی، موبائل اور ڈیٹا سینٹر پراکسیز پیش کرتا ہے۔ شروع کرنے کے لیے DataImpulse اکاؤنٹ بنائیں۔