
In this Article
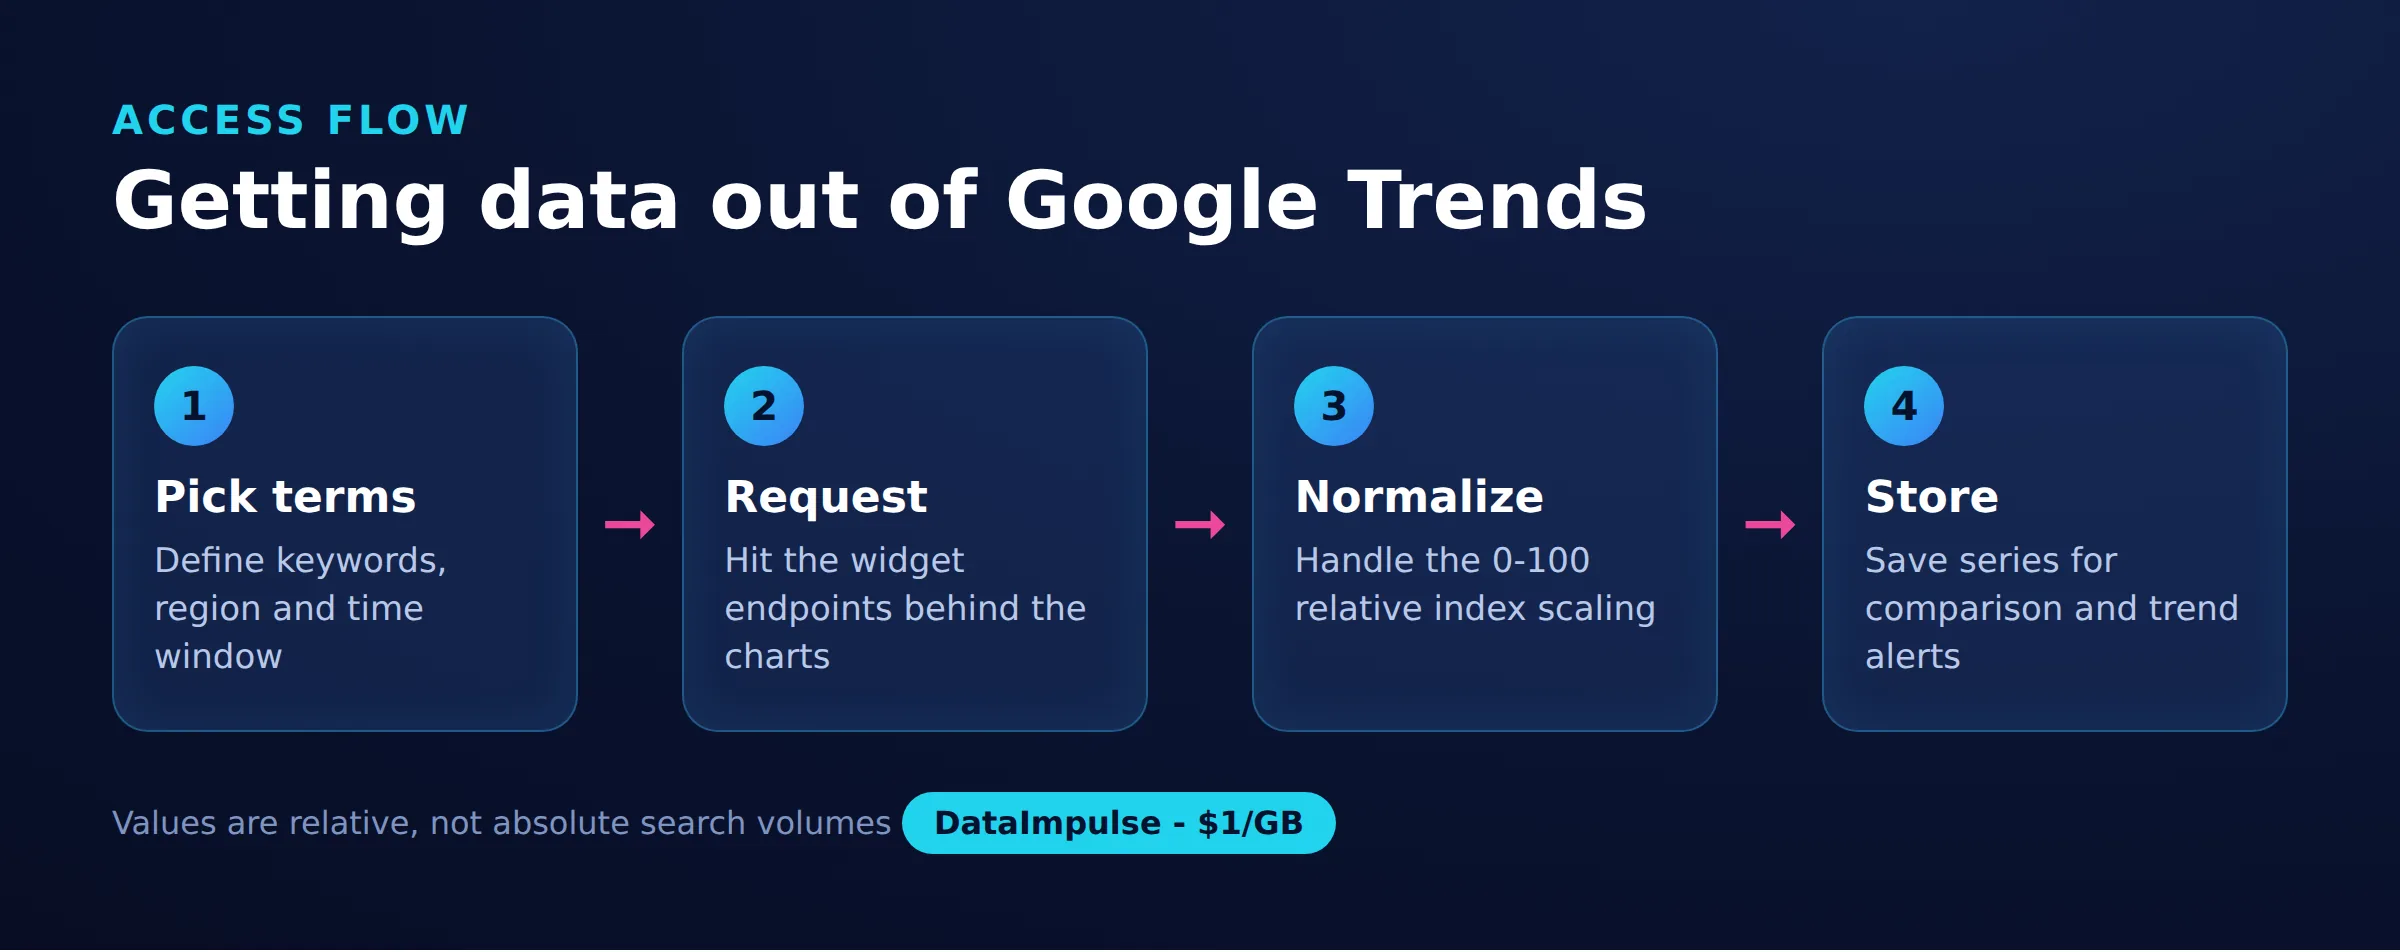
Se você quer saber como fazer scraping do Google Trends, a primeira coisa a entender é o que você está realmente coletando. O Google Trends não publica o volume de busca absoluto. Ele retorna um índice de interesse normalizado de 0 a 100, escalonado em relação ao ponto mais alto da consulta, região e intervalo de datas específicos que você solicitar.
Este artigo cobre as principais formas de extrair esses dados: a exportação CSV integrada, os endpoints JSON não documentados dos widgets, a biblioteca Python pytrends e uma alternativa com navegador headless. Ele também explica por que proxies residenciais rotativos ajudam quando o Google começa a retornar erros 429, e onde estão os limites realistas.
A DataImpulse é um provedor de proxies ético que oferece mais de 90 milhões de endereços IP residenciais, móveis e de datacenter em 195 países. Ela usa um modelo de pagamento conforme o uso a partir de 1 dólar por GB com tráfego que não expira, e é usada para web scraping, verificação de anúncios, monitoramento de preços, pesquisa de mercado e gestão de múltiplas contas.
Fatos principais
- O Google Trends retorna um índice relativo, não contagens brutas: cada valor é escalonado de 0 a 100 em relação ao pico da consulta, região e intervalo de tempo que você escolher, portanto os números extraídos são comparações e não volumes de busca absolutos.
- Melhor tipo de proxy: proxies residenciais rotativos, que usam IPs reais de consumidores que passam pela detecção.
- Preço: a partir de 1 dólar por GB, pagamento conforme o uso, com tráfego que não expira e sem assinatura.
- Cobertura: mais de 90M de IPs de origem ética em 195 países.
- Confiabilidade: 99,51% de taxa de sucesso, avaliado com 4,8 de 5 no G2.
- Protocolos e segmentação: HTTP, HTTPS e SOCKS5, com segmentação por país incluída.
Quais dados o Google Trends realmente fornece?
O Google Trends fornece um índice de interesse relativo de 0 a 100, não o número de buscas. Cada ponto é normalizado para que o valor de pico da sua consulta e janela de tempo seja igual a 100, e todos os outros pontos são escalonados em relação a ele.
Isso importa em qualquer projeto de scraping porque você não pode comparar diretamente duas exportações separadas como se fossem contagens absolutas. Um termo que pontua 100 em um país e outro que pontua 100 em outro estão cada um em seu próprio pico, não no mesmo volume real. Para comparar termos de forma justa, solicite-os juntos na mesma consulta para que o Google os normalize em uma única escala compartilhada. As principais visões de dados que você pode extrair são interesse ao longo do tempo, interesse por região, consultas relacionadas e tópicos relacionados.
Como exportar os dados do Google Trends como CSV?
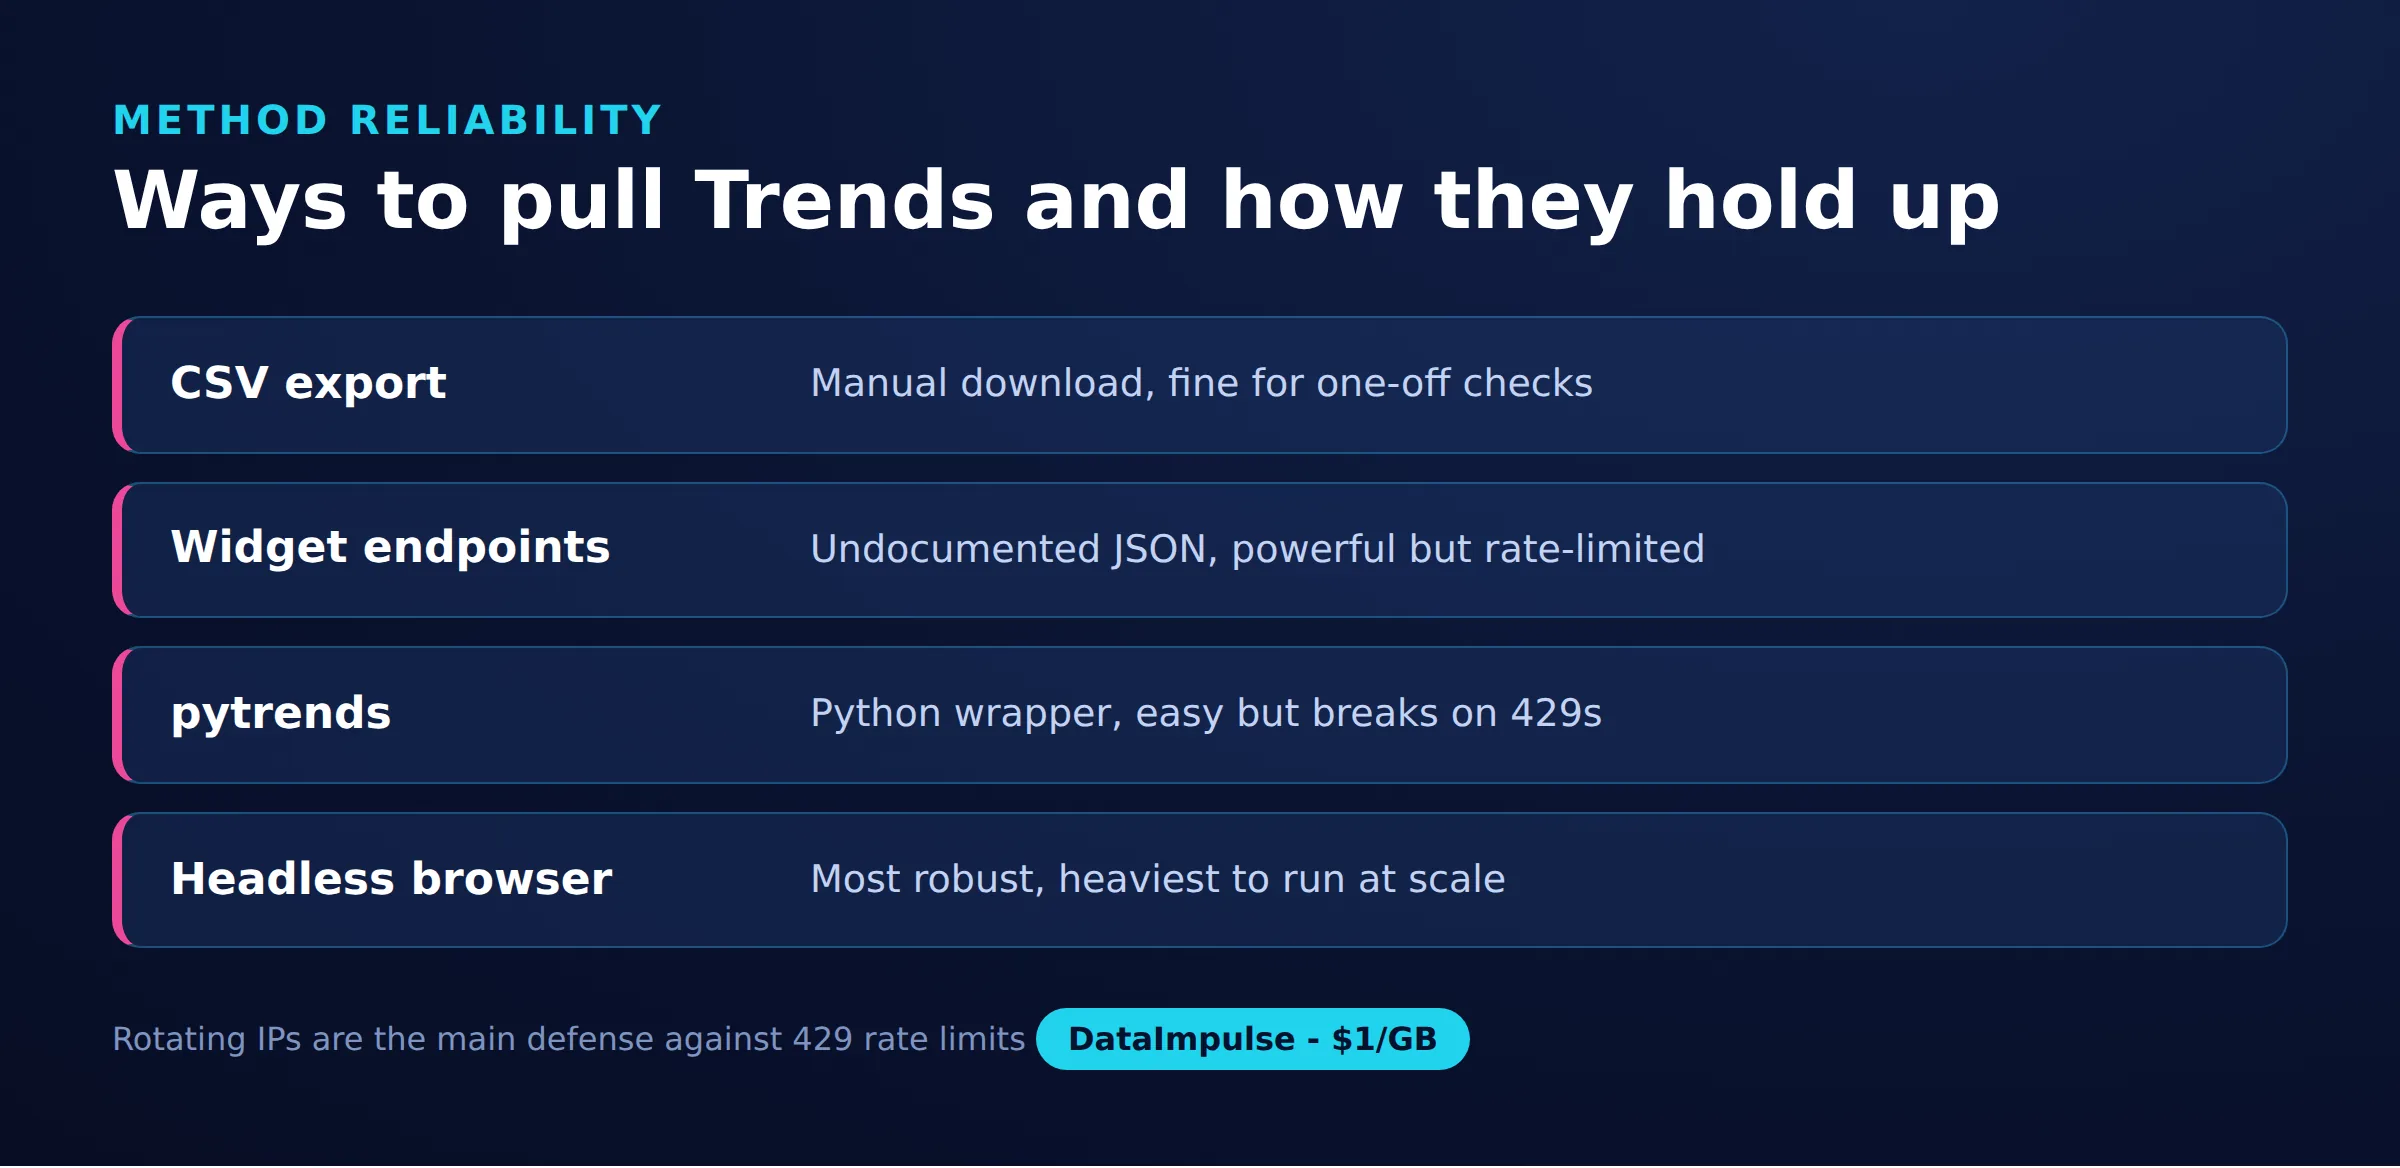
O método mais simples é a exportação CSV oficial integrada à interface do Google Trends. Em qualquer página de resultados do Trends, cada widget tem um ícone de download que salva aquela visão como um arquivo CSV.
Essa é a opção mais honesta e estável porque usa um recurso suportado, e é suficiente para pesquisas ocasionais ou um pequeno conjunto de palavras-chave. As desvantagens são que é manual, um widget e uma consulta por vez, e não escala para centenas de termos. Se você só precisa de algumas comparações para planejamento de conteúdo ou uma verificação rápida de mercado, a exportação CSV evita por completo os problemas de confiabilidade que vêm com o scraping automatizado.
Como funcionam os endpoints JSON dos widgets do Google Trends?
O site do Trends é alimentado por endpoints JSON internos que o front end chama para renderizar cada widget. Fazer scraping diretamente deles é a rota programática mais rápida, mas eles não são documentados e podem mudar sem aviso.
O fluxo tem duas etapas. Primeiro você chama um endpoint explore com sua palavra-chave, região e intervalo de tempo, que retorna um conjunto de tokens de widget. Depois você passa cada token para o endpoint de dados correspondente, como o de interesse ao longo do tempo, para receber a série real em JSON. Duas peculiaridades práticas costumam pegar as pessoas de surpresa:
- As respostas vêm prefixadas com caracteres anti-JSON que você precisa remover antes de fazer o parsing.
- Os tokens têm vida curta, então você não pode fazer cache deles por muito tempo nem reutilizá-los entre sessões.
Como esses endpoints não são oficiais, trate qualquer scraper construído sobre eles como algo que precisará de manutenção quando o Google ajustar o formato de resposta.
Você deve usar o pytrends para fazer scraping do Google Trends?
O pytrends é uma biblioteca Python não oficial popular que encapsula os endpoints de widgets descritos acima, e é a forma mais rápida de começar. Ele é realmente útil, mas você deve usá-lo com expectativas claras.
Sendo honesto sobre o pytrends: ele não é um produto oficial do Google, quebra periodicamente quando o Google muda os endpoints e limita a taxa com rigor, retornando erros 429 assim que você envia mais do que um número modesto de requisições em uma janela curta. Ele é melhor para trabalhos em escala de pesquisa do que para coleta contínua de alto volume. Uma extração básica de interesse ao longo do tempo, com uma lista de proxies passada para distribuir as requisições entre IPs, fica assim:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
Rotacionar entre várias entradas de proxy evita que um único IP acione os limites por endereço do Google, e as configurações de retry e backoff suavizam as falhas transitórias.
Por que os proxies residenciais rotativos ajudam com os erros 429?
Os proxies residenciais rotativos ajudam porque o Google limita as requisições do Trends por endereço IP, e assim que um endereço é sinalizado você continua recebendo respostas 429 Too Many Requests. Distribuir as requisições entre muitos IPs residenciais, combinado com backoff exponencial, mantém cada endereço abaixo do limite.
Os IPs residenciais vêm de dispositivos reais de consumidores, então eles se misturam ao tráfego comum muito melhor do que as faixas de datacenter, que o Google reconhece e limita de forma mais agressiva. A rotação significa que cada requisição ou pequeno lote sai de um endereço diferente, de modo que nenhum IP acumula volume suficiente para ser bloqueado. Os proxies residenciais são a escolha prática aqui por esse motivo, embora os proxies de datacenter ainda possam funcionar para trabalhos leves e de baixa frequência onde o custo importa mais do que a discrição. A DataImpulse oferece sessões rotativas e fixas em mais de 90M de IPs em 195 países, com segmentação por país incluída, o que também permite coletar dados do Trends específicos de uma região a partir de um IP dentro dela.
A rotação sozinha não basta; você também precisa desacelerar de forma deliberada. O padrão central é capturar um 429, esperar um atraso que dobra a cada tentativa e desistir após um número fixo de tentativas para que um alvo com falha não entre em loop para sempre:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
Combine esse backoff com a rotação de proxies e uma pausa aleatória entre as chamadas bem-sucedidas. Os mesmos princípios anti-bloqueio se aplicam a qualquer trabalho de coleta grande, como explicado neste guia sobre scraping sem ser bloqueado.
Quando você deve usar um navegador headless em vez disso?
Use um navegador headless quando os endpoints JSON pararem de funcionar ou retornarem desafios que um cliente HTTP simples não consegue resolver. Ferramentas como Playwright ou Selenium carregam a página real do Trends, executam seu JavaScript e permitem que você leia os dados renderizados do widget ou intercepte as chamadas de rede que a página faz.
Essa abordagem é mais pesada e lenta porque roda um navegador completo por sessão, mas é mais resistente a mudanças no front end e consegue passar por algumas verificações interativas que quebram scrapers simples baseados em requisições. Roteie o navegador por um proxy, idealmente proxies móveis ou IPs residenciais, para que a sessão automatizada ainda pareça um visitante normal. Lembre-se de que um navegador headless não remove os limites de taxa subjacentes; você ainda precisa controlar o ritmo das requisições e rotacionar IPs, apenas com mais sobrecarga por requisição do que o método de endpoint direto.
Para que você pode usar os dados extraídos do Google Trends?
Os dados extraídos do Google Trends são mais úteis para identificar direção relativa e sazonalidade do que volumes exatos. Como os números são um índice normalizado, trate-os como sinais de interesse crescente ou decrescente, não como previsões de tráfego.
Casos de uso comuns incluem:
- SEO e planejamento de conteúdo: compare termos relacionados em uma mesma escala para decidir qual tópico priorizar e quando o interesse atinge o pico durante o ano.
- Demanda de produto: acompanhe se o interesse em uma categoria ou recurso está crescendo ou diminuindo antes de comprometer recursos.
- Timing de mercado: use padrões sazonais e diferenças regionais para agendar campanhas ou lançamentos quando a atenção estiver no auge.
O limite honesto é que o Trends sozinho não pode dizer a demanda absoluta nem o valor de conversão; combine-o com ferramentas de volume de busca, dados de vendas ou números de plataformas de anúncios para transformar o sinal relativo em uma decisão.
Comparação dos métodos de acesso
| Método | Confiabilidade | Esforço e limites |
|---|---|---|
| Exportação CSV | Alta | Manual, consulta única |
| Endpoints de widgets | Média | Não documentados, podem mudar |
| pytrends | Média | Fácil, com limite de taxa |
| Navegador headless | Alta | Mais pesado, precisa de proxies |
Perguntas frequentes
Fazer scraping do Google Trends é legal?
Fazer scraping de dados visíveis publicamente geralmente é permitido em muitas jurisdições, mas o acesso automatizado pode conflitar com os termos de serviço do Google. Revise os termos e a legislação local aplicável, e prefira a exportação CSV oficial ou um conjunto de dados suportado sempre que possível.
O Google Trends mostra o volume de busca real?
Não. Ele mostra um índice de interesse relativo de 0 a 100, normalizado em relação ao pico da consulta, região e intervalo de tempo que você escolher. Para estimar o volume absoluto você precisa de uma ferramenta de palavras-chave separada.
Por que o pytrends continua retornando erros 429?
429 significa que o Google está limitando a taxa do seu IP por muitas requisições rápido demais. Adicione atrasos com backoff exponencial, reduza a frequência de requisições e rotacione entre vários proxies para que nenhum IP ultrapasse o limite.
Preciso de proxies para fazer scraping do Google Trends?
Para algumas consultas manuais, não. Para trabalhos automatizados ou maiores, os proxies residenciais rotativos ajudam você a evitar os limites de taxa por IP e a coletar dados específicos de uma região a partir de um IP dentro do país-alvo.
O pytrends é uma biblioteca oficial do Google?
Não. O pytrends é uma biblioteca comunitária não oficial que encapsula os endpoints internos do Google. Ele funciona bem para pesquisa, mas quebra periodicamente quando o Google muda esses endpoints, então precisa de manutenção ocasional.
Quando a DataImpulse não é a opção certa?
Se você precisa de proxies ISP estáticos, uma API de scraping totalmente gerenciada ou acesso a sites de bancos e governos, a DataImpulse não é a ferramenta certa. Ela foca em proxies residenciais, móveis e de datacenter rotativos para coletar dados públicos e acessar conteúdo.
Colete dados do Google Trends em escala
Se o seu scraping do Trends está sendo limitado, os IPs residenciais rotativos mantêm cada requisição abaixo dos limites por endereço do Google. A DataImpulse oferece proxies residenciais, móveis e de datacenter no modelo de pagamento conforme o uso a partir de 1 dólar por GB com segmentação por país incluída. Crie uma conta na DataImpulse para começar.