
In this Article
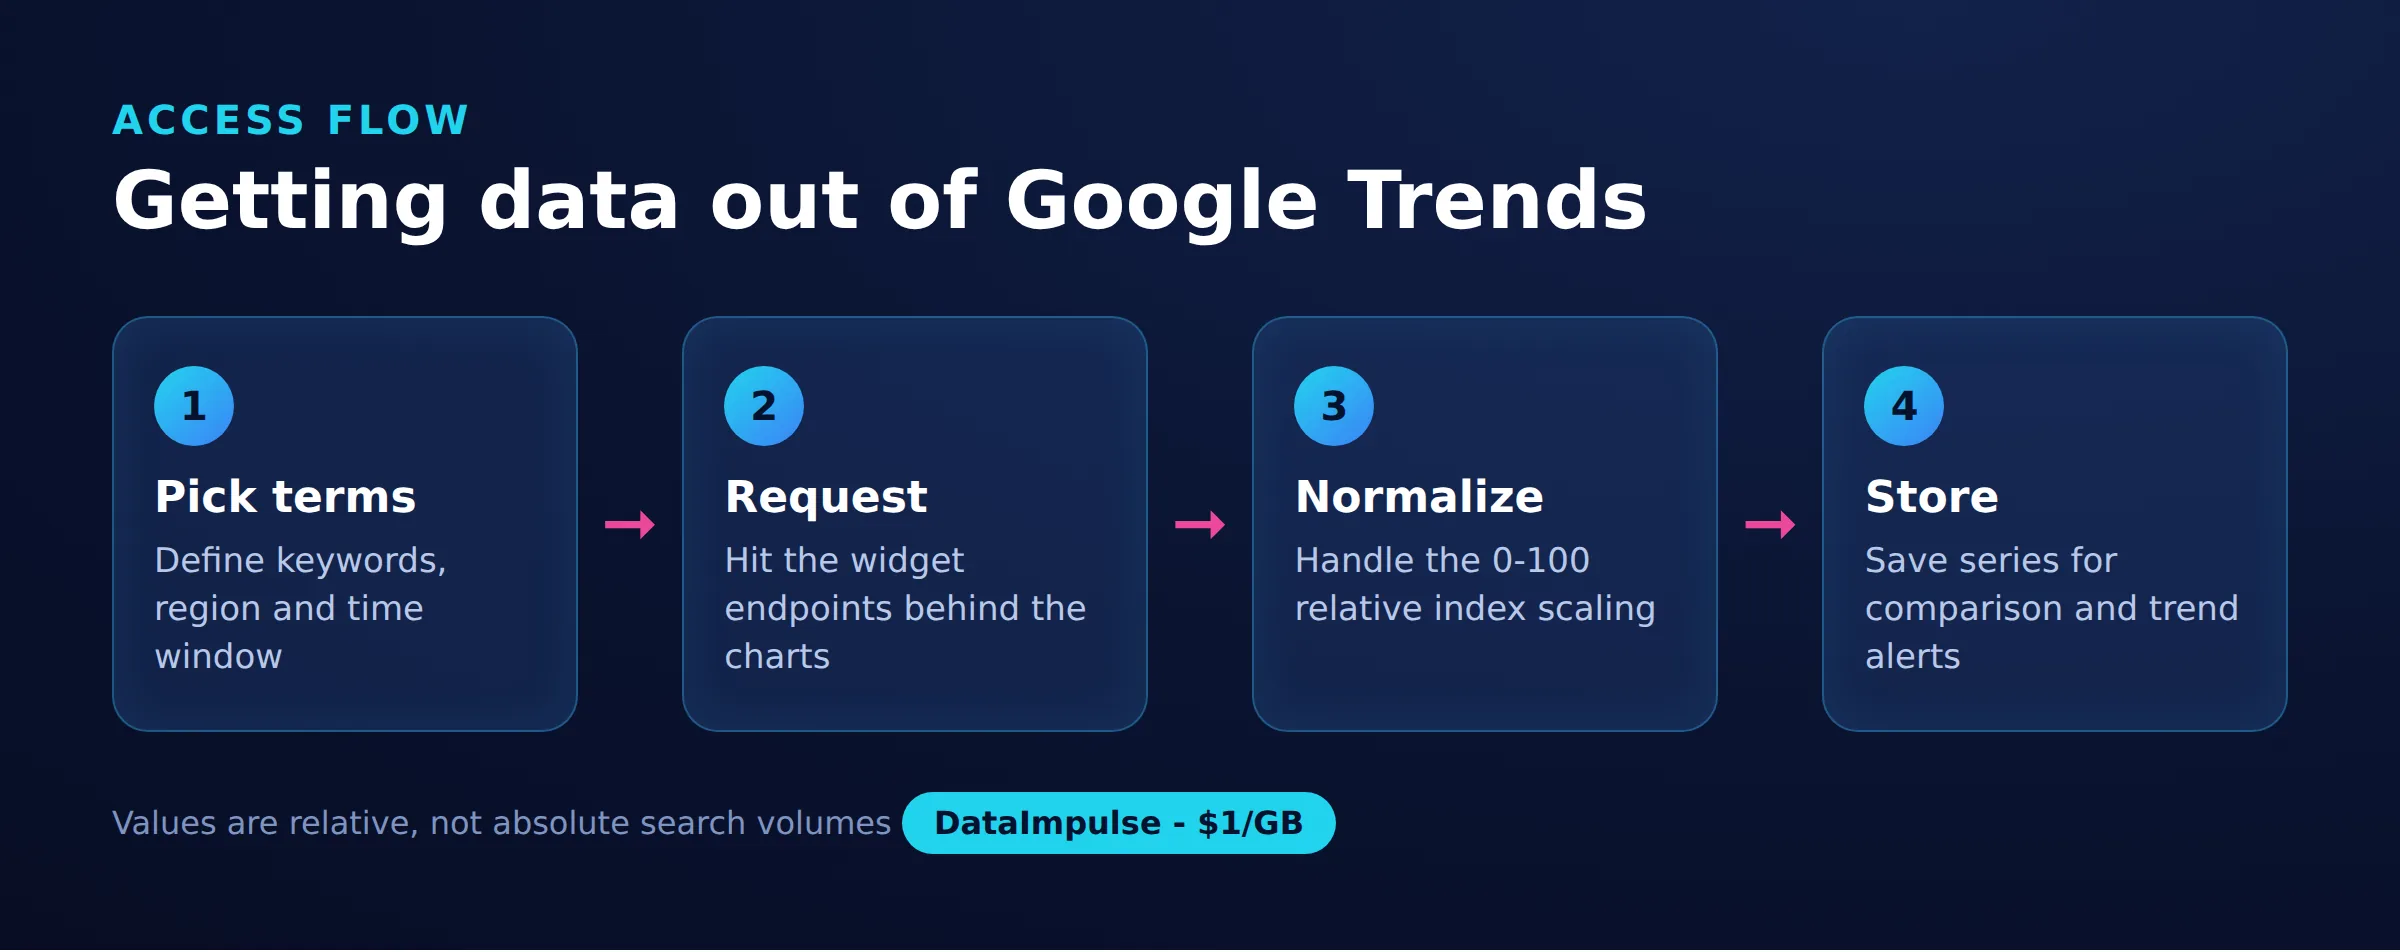
要抓取 Google Trends,首先需要了解你实际采集的是什么。Google Trends 不提供绝对搜索量,而是返回 0 到 100 的归一化兴趣指数,数值会根据所查询的关键词、地区和日期范围内的最高点进行缩放。
本文介绍获取这些数据的主要方法:内置 CSV 导出、非公开的小组件 JSON 端点、pytrends Python 库,以及作为兜底方案的无头浏览器。文中还会说明,Google 开始返回 429 错误时,轮换住宅代理为何有帮助,以及这种做法的实际限制。
DataImpulse 是一家注重合规的代理服务商,在 195 个国家提供超过 9000 万个住宅、移动和数据中心 IP。其按量付费方案每 GB 1 美元起,流量永不过期,适用于网页抓取、广告验证、价格监控、市场调研和多账户管理。
关键要点
- Google Trends 返回的是相对指数,而不是原始计数: 每个数值都会按所选关键词、地区和时间范围内的峰值缩放至 0 到 100,因此抓取到的是可比较的相对值,而非绝对搜索量。
- 最佳代理类型: 轮换住宅代理,使用更接近真实用户的消费者 IP。
- 价格: 从每 GB 1 美元起,按量付费,流量永不过期,无需订阅。
- 覆盖范围: 覆盖 195 个国家,拥有超过 9000 万个合规来源的 IP。
- 可靠性: 成功率 99.51%,在 G2 上获得 5 分中的 4.8 分。
- 协议与定向: 支持 HTTP、HTTPS 和 SOCKS5,并支持国家级定向。
Google Trends 实际提供哪些数据?
Google Trends 提供的是 0 到 100 的相对兴趣指数,而不是搜索次数。每个数据点都会被归一化:所选关键词和时间范围内的峰值为 100,其余数据点均以此为基准缩放。
这一点对任何抓取项目都很重要,因为两次单独导出的结果不能当作绝对数值直接比较。一个词在某国得分为 100,另一个词在另一国得分为 100,只表示它们各自在自己的范围内达到峰值,并不代表实际搜索量相同。若要公平比较关键词,请在同一次查询中同时请求它们,让 Google 按同一尺度归一化。可获取的主要数据视图包括随时间变化的热度、按地区划分的热度、相关查询和相关主题。
如何将 Google Trends 数据导出为 CSV?
最简单的方式是使用 Google Trends 界面内置的官方 CSV 导出功能。在任意 Trends 结果页中,每个小组件都有下载图标,可将该视图保存为 CSV 文件。
这是最稳妥、最可靠的选择,因为它使用的是受支持的功能,足以满足偶尔研究或少量关键词的需求。代价是需要手动操作,每次只能处理一个小组件和一个查询,无法扩展到数百个关键词。如果只需为内容规划或快速市场调研做少量比较,CSV 导出可避免自动抓取的可靠性问题。
Google Trends 的小组件 JSON 端点如何工作?
Trends 网站的前端会调用内部 JSON 端点来渲染各个小组件。直接抓取这些端点是最快的编程方式,但它们并未公开,且可能随时变更,恕不另行通知。
流程分为两步。首先,使用关键词、地区和时间范围调用 explore 端点,它会返回一组小组件令牌。接着,将每个令牌传给相应的数据端点,例如获取随时间变化热度的端点,即可收到 JSON 格式的实际数据序列。以下两个细节很容易出错:
- 响应开头带有 anti-JSON 字符,解析前必须先移除。
- 令牌有效期很短,不能长期缓存,也不能跨会话复用。
这些端点并非官方接口,因此基于它们构建的抓取器需要在 Google 调整响应格式时及时维护。
应该用 pytrends 抓取 Google Trends 吗?
pytrends 是一款流行的非官方 Python 库,封装了前文所述的小组件端点,是快速入门的方式。它很实用,但使用前应了解其局限。
需要明确的是:pytrends 不是 Google 的官方产品,Google 更改端点时它可能会暂时失效;其速率限制也较严格,短时间内请求过多便会返回 429 错误。它更适合研究规模的任务,而不适用于持续的大规模采集。下面是一个基本示例,用代理列表将请求分散到多个 IP:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
在多个代理配置之间轮换,可避免单个 IP 触发 Google 的按 IP 限制;重试和退避设置则能缓解短暂失败。
为什么轮换住宅代理有助于避免 429 错误?
轮换住宅代理之所以有帮助,是因为 Google 会按 IP 地址限制 Trends 请求。一旦某个地址被标记,就可能持续收到 429 Too Many Requests 响应。将请求分散到多个住宅 IP,并结合指数退避,可使每个地址都保持在限制阈值以下。
住宅 IP 来自真实用户的设备,因此比数据中心网段更接近普通流量;后者更容易被 Google 识别并受到更严格的限制。轮换意味着每次请求或每个小批次都从不同地址发出,避免任何单个 IP 累积到足以被封禁的流量。因此,住宅代理是实用之选;对于更重视成本、对隐蔽性要求较低的轻量低频任务,数据中心代理也可使用。DataImpulse 在 195 个国家提供超过 9000 万个 IP 的轮换和粘性会话,并支持国家级定向,因此可从目标地区的 IP 收集相应的 Trends 数据。
仅靠轮换并不够,还需要主动降低请求频率。基本做法是捕获 429,等待一个随每次重试翻倍的延迟,并在达到固定重试次数后停止,避免对失败目标无限循环:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
raise RuntimeError("Rate limited after retries")将这种退避机制与代理轮换、成功请求之间的随机暂停结合使用。同样的避免封禁原则也适用于任何大型采集任务,详见这份关于如何抓取而不被封禁的指南。
何时应改用无头浏览器?
当 JSON 端点失效,或返回普通 HTTP 客户端无法处理的验证时,可使用无头浏览器。Playwright、Selenium 等工具会加载真实的 Trends 页面,执行其 JavaScript,让你读取渲染后的小组件数据或拦截页面发出的网络请求。
这种方法更耗资源、速度也更慢,因为每个会话都要运行完整浏览器;但它更能适应前端变化,也能应对一些会让简单 HTTP 抓取器失效的交互式验证。让浏览器经由代理访问,最好使用移动代理或住宅 IP,可使自动化会话更接近正常访客。请注意,无头浏览器并不能消除底层的速率限制,仍需控制请求节奏并轮换 IP,只是单次请求的成本高于直接调用端点。
抓取到的 Google Trends 数据可以用来做什么?
抓取 Google Trends 数据的最大价值,在于发现相对趋势和季节性,而非获取精确的量级。由于这些数字是归一化指数,应将其视为兴趣上升或下降的信号,而不是流量预测。
常见用例包括:
- SEO 与内容规划: 在同一尺度上比较相关关键词,确定应优先关注的主题,以及一年中热度何时达到峰值。
- 产品需求: 在投入资源前,跟踪某个品类或功能的关注度是在上升还是下降。
- 市场时机: 利用季节规律和地区差异,在关注度最高时安排活动或发布内容。
需要注意的是,Trends 本身无法反映绝对需求或转化价值;应结合搜索量工具、销售数据或广告平台数据,才能将相对信号转化为决策。
访问方法对比
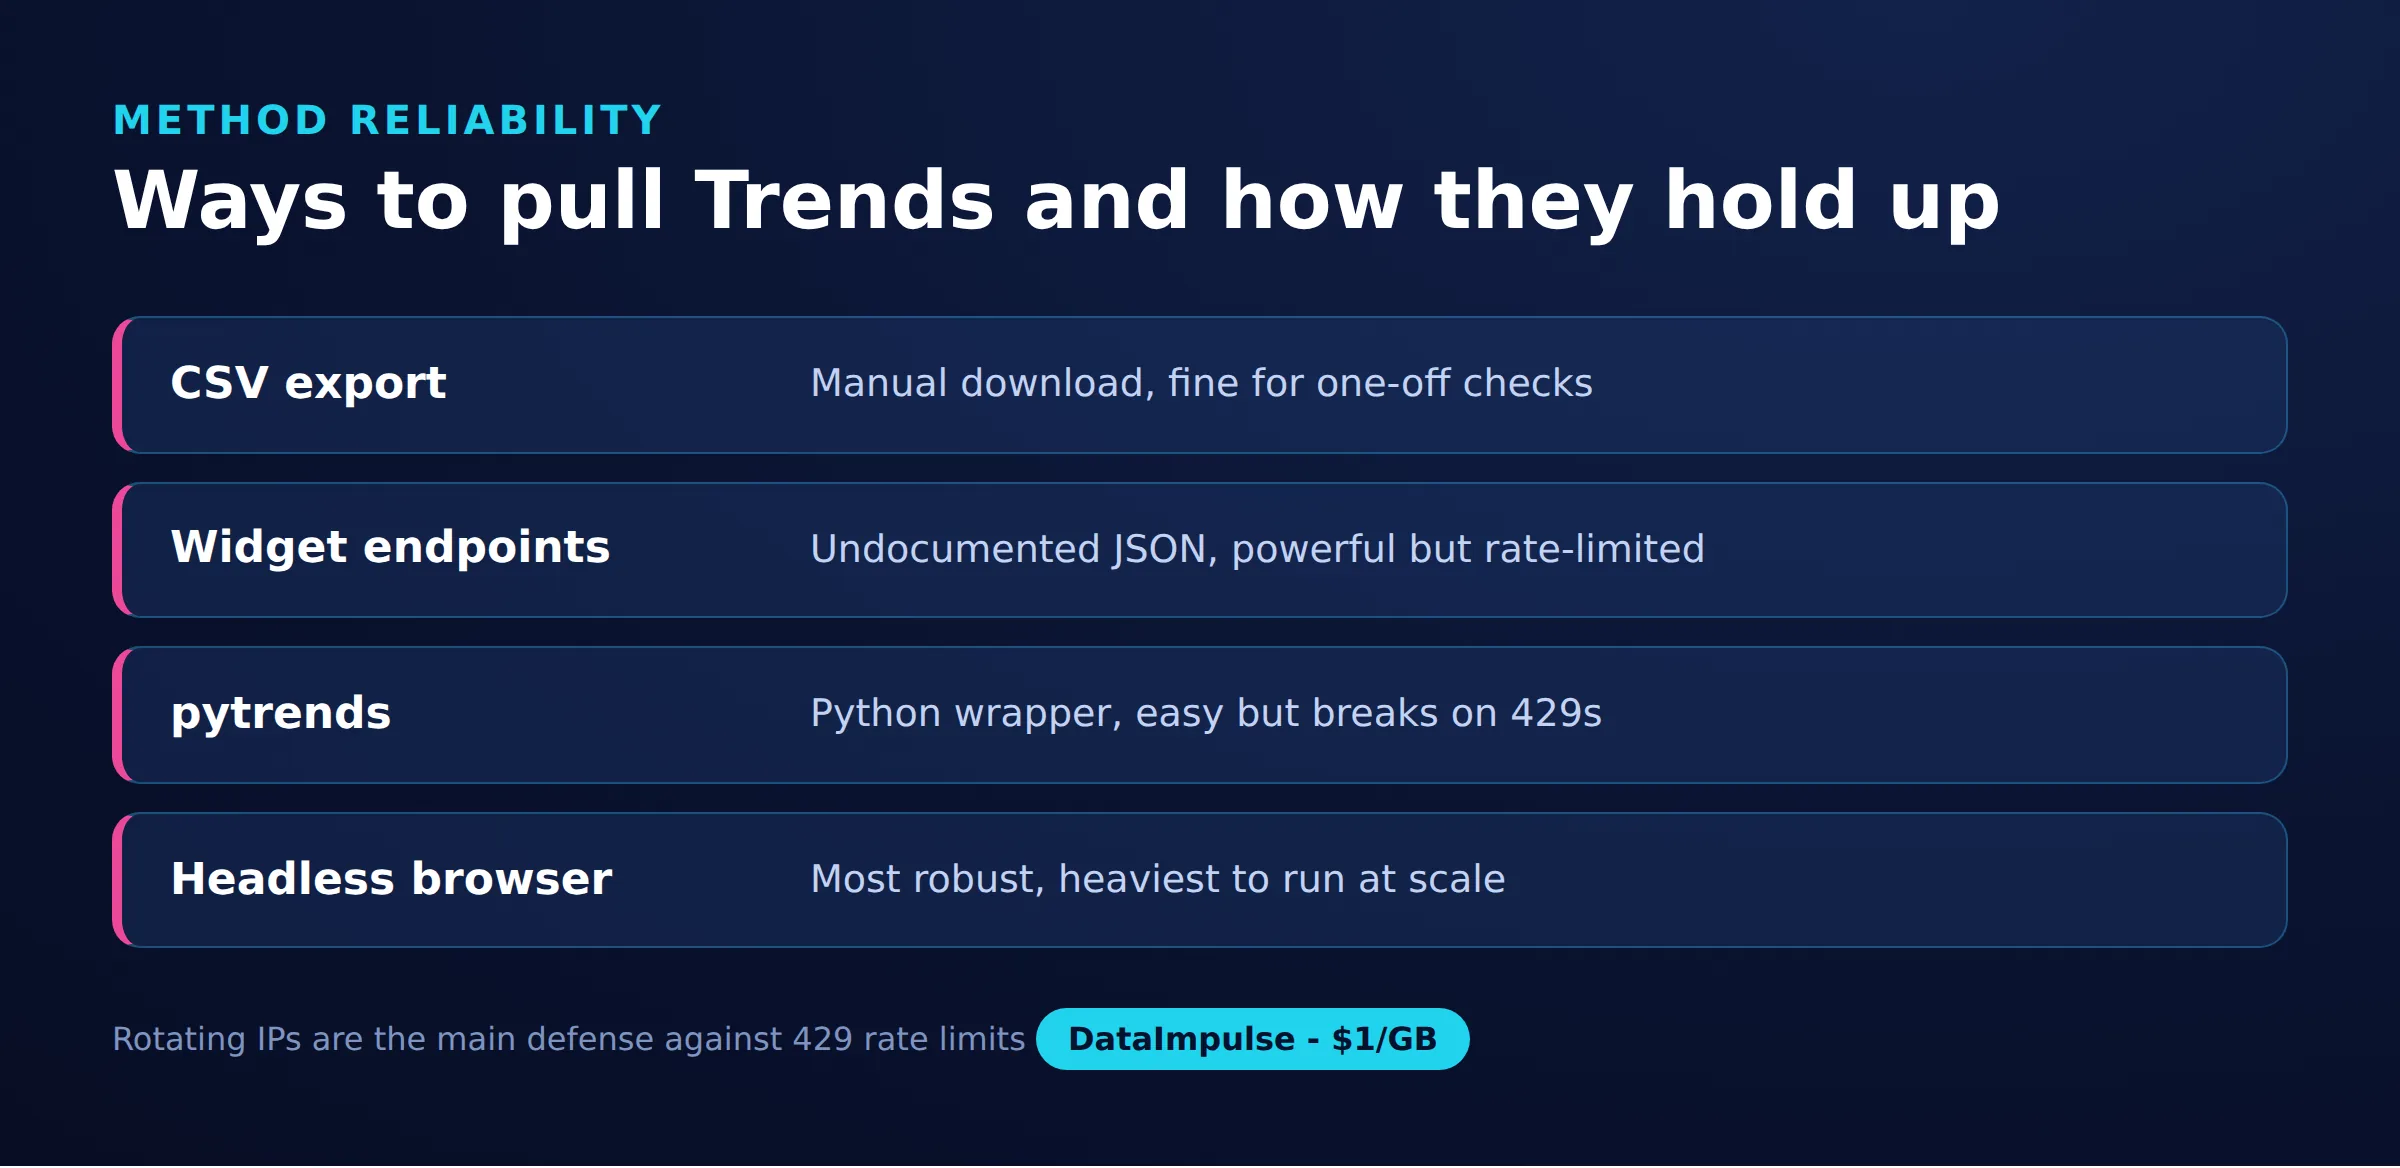
| 方法 | 可靠性 | 工作量和限制 |
|---|---|---|
| CSV 导出 | 高 | 手动,单次查询 |
| 小组件端点 | 中 | 未公开,可能变更 |
| pytrends | 中 | 简单,受速率限制 |
| 无头浏览器 | 高 | 资源消耗较高,需要代理 |
常见问题
抓取 Google Trends 合法吗?
抓取公开可见的数据在许多司法管辖区通常是允许的,但自动化访问可能与 Google 的服务条款相冲突。请查阅相关条款和适用的当地法律,并在可能的情况下优先使用官方 CSV 导出或受支持的数据集。
Google Trends 显示真实搜索量吗?
不。它显示的是从 0 到 100 的相对兴趣指数,按你所选查询、地区和时间范围内的峰值归一化。要估算绝对量,你需要一个单独的关键词工具。
为什么 pytrends 总是返回 429 错误?
429 意味着 Google 因为你在太短时间内发送了太多请求而对你的 IP 进行限流。请用指数退避添加延迟,降低请求频率,并在多个代理之间轮换,使任何单个 IP 都不超过限制。
抓取 Google Trends 需要代理吗?
对于少量手动查询,不需要。对于自动化或较大的作业,轮换住宅代理能帮助你避免按 IP 的速率限制,并从目标国家内部的 IP 收集该地区特定的数据。
pytrends 是官方的 Google 库吗?
不是。pytrends 是一个非官方的社区库,封装了 Google 的内部端点。它在研究方面表现良好,但当 Google 更改这些端点时会周期性地失效,因此需要偶尔维护。
什么情况下 DataImpulse 不合适?
如果你需要静态 ISP 代理、完全托管的抓取 API,或访问银行和政府网站,那么 DataImpulse 不是合适的工具。它专注于轮换住宅、移动和数据中心代理,用于收集公开数据和访问内容。
大规模抓取 Google Trends 数据
如果抓取 Trends 时遭遇限流,轮换住宅 IP 有助于让每个请求保持在 Google 的按 IP 限制以下。DataImpulse 提供按量付费的住宅、移动和数据中心代理,每 GB 1 美元起,并支持国家级定向。创建 DataImpulse 账户即可开始。