
この記事の内容
curl impersonate とは、curl-impersonate を使って、HTTP リクエスト送信時にブラウザの TLS と HTTP/2 の挙動を模倣することを指します。オリジナルプロジェクトのドキュメントには、このアプローチの根拠となる通信層の変更点が記載されています。User-Agent を変えるだけでは、これらを再現することはできません。
まずフィンガープリントを確認し、そのうえで実際のレスポンスボディを調べましょう。2026年10月16日に実施した簡易テストでは、通常のクライアントと偽装したリクエストとの間に有用な違いが見られました。一方で、チャレンジが返され続けた商品ページもありました。これは小規模なスナップショットであり、ベンチマークでも、アクセスを保証するものでもありません。
主なポイント
- 今回のテストでは、Python requests とシステムの curl は同じ OpenSSL の JA3 フィンガープリントを示しました。
- curl_cffi の impersonate=”chrome” と curl_chrome136 は、実際の Chromium 145 の JA4 および HTTP/2 フィンガープリントと完全に一致しました。
- 同じレジデンシャルプロキシと User-Agent を使っても、通常の curl は Walmart のブロックページにリダイレクトされ、curl_chrome136 はページ全体を取得できました。
- Chrome は TLS 拡張の順序をランダム化するため、JA3 はビルドごとに変わります。より安定したシグナルは JA4 です。
- 偽装で修正されるのは TLS と HTTP/2 のフィンガープリントであり、JavaScript や行動ベースのチャレンジには効果がありません。
- curl-impersonate v2.2.3 には、curl_chrome136 や curl_firefox147 などのビルド済みバイナリが含まれています。
curl impersonate とは何で、実際に何を模倣するのか
curl-impersonate は、ブラウザに近い接続挙動を再現するように改変された curl のビルドです。対象は TLS ハンドシェイクと HTTP/2 の設定であり、ブラウザの実行環境全体ではありません。
オリジナルのプロジェクトは lwthiker の配下にあり、今回テストしたバイナリは lexiforest のフォークのものです。フォークのプロジェクトドキュメントには、パッチ適用済みの BoringSSL が基盤であることが記されています。リポジトリ、リリース、選択したプロファイルをあわせて記録してください。見慣れた実行ファイル名だけでは、出所の確認として不十分です。
偽装とは、接続が自分自身をどのように名乗るかを選ぶことだと考えてください。ヘッダーは HTTP リクエストを説明し、通信層の設定はクライアントの別の側面を説明します。どちらも、人間がリクエストを開始したことを証明するものではありません。一部のフィンガープリントが一致しても、ブラウザと完全に同等であるとは言えません。
curl impersonate を使うワークフローでは、まず必要なデータがすでに HTTP レスポンスに含まれているかを確認します。今回成功した検索レスポンスには商品の JSON が埋め込まれていましたが、他のテスト対象ページではチャレンジが表示されました。より広い視点についてはTLS フィンガープリントのガイドが参考になりますが、実装の判断はレスポンスの検査結果に基づいて行ってください。
curl impersonate をインストールして最初のリクエストを実行するには
リリースとプラットフォーム向けのアーティファクトを明示的に選び、ブラウザ用ラッパーをフィンガープリント確認用のエンドポイントに対して実行します。今回テストした Linux 環境では、lexiforest の v2.2.3 と curl_chrome136 ラッパーを使用しました。
ステップ1:公式の v2.2.3 リリースを開き、お使いのアーキテクチャに合った Linux 用アーティファクトを選んで展開します。ランタイムと CA 証明書の要件については、インストールドキュメントを参照してください。
ステップ2:ラッパーと関連するアーティファクトは同じ場所にまとめて保管します。今回の環境は Ubuntu の OpenSSL 3.0.13 を搭載した Linux で、偽装用バイナリは自身を BoringSSL を使った curl 8.22.0-IMPERSONATE と表示しました。システムの curl と比較する際には、この違いが重要になります。
ステップ3:展開したディレクトリから、今回のスナップショットで使用したフィンガープリント確認コマンドをそのまま実行します。
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
アプリケーションのエンドポイントをテストする前に、返された JA4、HTTP バージョン、HTTP/2 フィンガープリントを保存しておきましょう。これにより、小売サイトのレスポンスをフィンガープリントのテストとして扱うことなく、通信層のベースラインを作成できます。
Windows や macOS では、フォークが案内しているプラットフォーム別のアーティファクトとインストール手順を使用してください。バインディングのページから、Python、JavaScript/TypeScript、PHP、Rust の各連携にたどり着けます。Nixpkgs のパッケージや Node のラッパーを使う場合は、実際の上流とリリースを確認してください。今回のインストールの検証は Linux のみを対象としています。
curl_cffi で Python から Chrome を偽装するには
curl_cffi の impersonate パラメータを使い、再現性のためにパッケージのバージョンを固定します。今回の Python 実装では、curl_cffi 0.15 と impersonate=”chrome” を使用しました。
公式のクイックスタートには、pip でのインストール、ブラウザプロファイル、requests に似たインターフェースが記載されています。今回のパッケージ構成を再現するには、分離した環境にバージョン 0.15 をインストールしてください。汎用の chrome エイリアスはライブラリが現在対象としている Chrome を指すため、アップグレードによって意味が変わることがあります。
テスト済みの以下のコードを実行する前に、url を公開されている検索 URL の https://www.walmart.com/search?q=air+fryer に、PROXY をご自身のプロキシ URL に設定してください。後者は環境変数から非公開で読み込みます。このコードはこの2つの変数に依存します。
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
レコードを抽出する前に、レスポンスのステータスと HTML を確認してください。今回成功した CLI の検索レスポンスでは、抽出元は埋め込みの __NEXT_DATA__ 商品 JSON でした。HTML パーサーでそのスクリプト要素を見つけて JSON をデコードし、想定するフィールドを検証してから、そのページを利用可能なコンテンツとして受け入れます。
クイックスタートでは、Cookie の保持と接続の再利用のために Session を使うことが紹介されています。複数のリクエストにまたがるワークフローでは、セッション、プロファイル、想定する出口の所在地を一貫させてください。無関係なマシンからコピーした任意のブラウザバージョンのヘッダーを、プロファイルと組み合わせるのは避けましょう。
プロキシの認証と接続先の認証は別の問題です。認証情報は、ご自身が正式に利用を許可されたサービス向けに発行されたものだけを使用してください。この公開ページの例では、接続先のログインは不要です。リクエスト構造の変換については、curl から Python への変換ガイドで解説しています。
JA3 と JA4 のフィンガープリントはどう違うのか
JA3 は ClientHello の一部のフィールドの順序を保持するのに対し、JA4 はハッシュ化の前に一部のリストを正規化します。そのため、拡張の順序が変わる場合でも JA4 は有用ですが、クライアントの完全な識別情報になるわけではありません。
Salesforce の JA3 仕様では、TLS バージョン、暗号スイート、拡張、サポートグループ、ポイントフォーマットから作られるフィンガープリントとして説明されています。FoxIO の JA4 仕様では、暗号スイートと拡張はソートされますが、署名アルゴリズムの順序は保持されます。JA4 があらゆる順序の違いを無視するかのように説明しないでください。
今回のスナップショットでは、curl_cffi の chrome と Playwright の Chromium 145.0.7632.6 は、JA4 の t13d1516h2_8daaf6152771_d8a2da3f94cd と HTTP/2 フィンガープリントの 52d84b11737d980aef856699f885ca86 が共通していました。JA3 の値は異なっていました。curl_chrome136 ラッパーも、これらと同じ JA4 および HTTP/2 の値に一致しました。
これらは計測用エンドポイントでサーバー側から観測された一致であり、ハンドシェイクの全バイトやアプリケーションの挙動がすべて一致したことの証明ではありません。実際に使う予定のネットワーク経路でテストし、両方の通信層を比較してください。ご自身が運用するシステムでは、サーバー側の記録を確認しましょう。トラフィック分析やルールでのこれらのシグナルの使い方は、Cloudflare のフィンガープリントに関するドキュメントで解説されています。
HTTP、HTTPS、SOCKS プロキシを設定するには
プロキシは、ブラウザプロファイルとは独立して設定します。接続先のスキームとプロキシのスキームはそれぞれ別の接続を表すため、HTTPS の接続先でも HTTP プロキシを使用できます。
上の Python のコードでは、辞書のキー https が HTTPS の接続先を指定し、その値がプロキシのエンドポイントを示します。curl_cffi のクイックスタートには、HTTP および SOCKS プロキシの例が記載されています。今回計測した経路では、認証付きの HTTP プロキシを使用しました。
curl の HTTP プロキシに関するドキュメントでは、HTTPS の接続先に対する CONNECT トンネリングが説明されています。TLS インターセプトがない場合、トンネルはクライアントの暗号化された通信をそのまま運ぶため、接続先に向けたヘッダーと TLS ハンドシェイクが保たれます。HTTPS プロキシは、さらにクライアントとプロキシ間の接続も暗号化します。対応するスキームと認証設定については、公式のプロキシオプションのリファレンスを参照してください。
プロキシの認証情報は、共有するスクリプトや診断の出力に含めないでください。まずエンドポイント、プロトコル、ポート、認証を単独で確認し、そのあとでアプリケーションのレスポンスを比較します。プロキシへの接続失敗と、チャレンジページを正常に取得できたことは、異なる種類の証拠です。
ステートフルな一連のリクエストでは、診断中は出口を固定することをおすすめします。ローテーションは、動作するベースラインを確立したあとで、独立した正式に許可されたリクエストに限って検討してください。IP と通信層のプロファイルを同時に変えると、結果の原因を説明しにくくなります。
curl のプロキシ設定ガイドでは設定方法を、curl に適したプロキシの選び方では経路の要件の評価方法を紹介しています。経路の選択も偽装も、受け入れられることを保証するものではありません。
ブラウザでは動くのに curl がブロックされるのはなぜか
ブラウザと HTTP クライアントは、同じ URL をリクエストしても、複数の層で違いが生じることがあります。ツールを変える前に、4層のリクエスト診断モデルを使って違いを切り分けましょう。
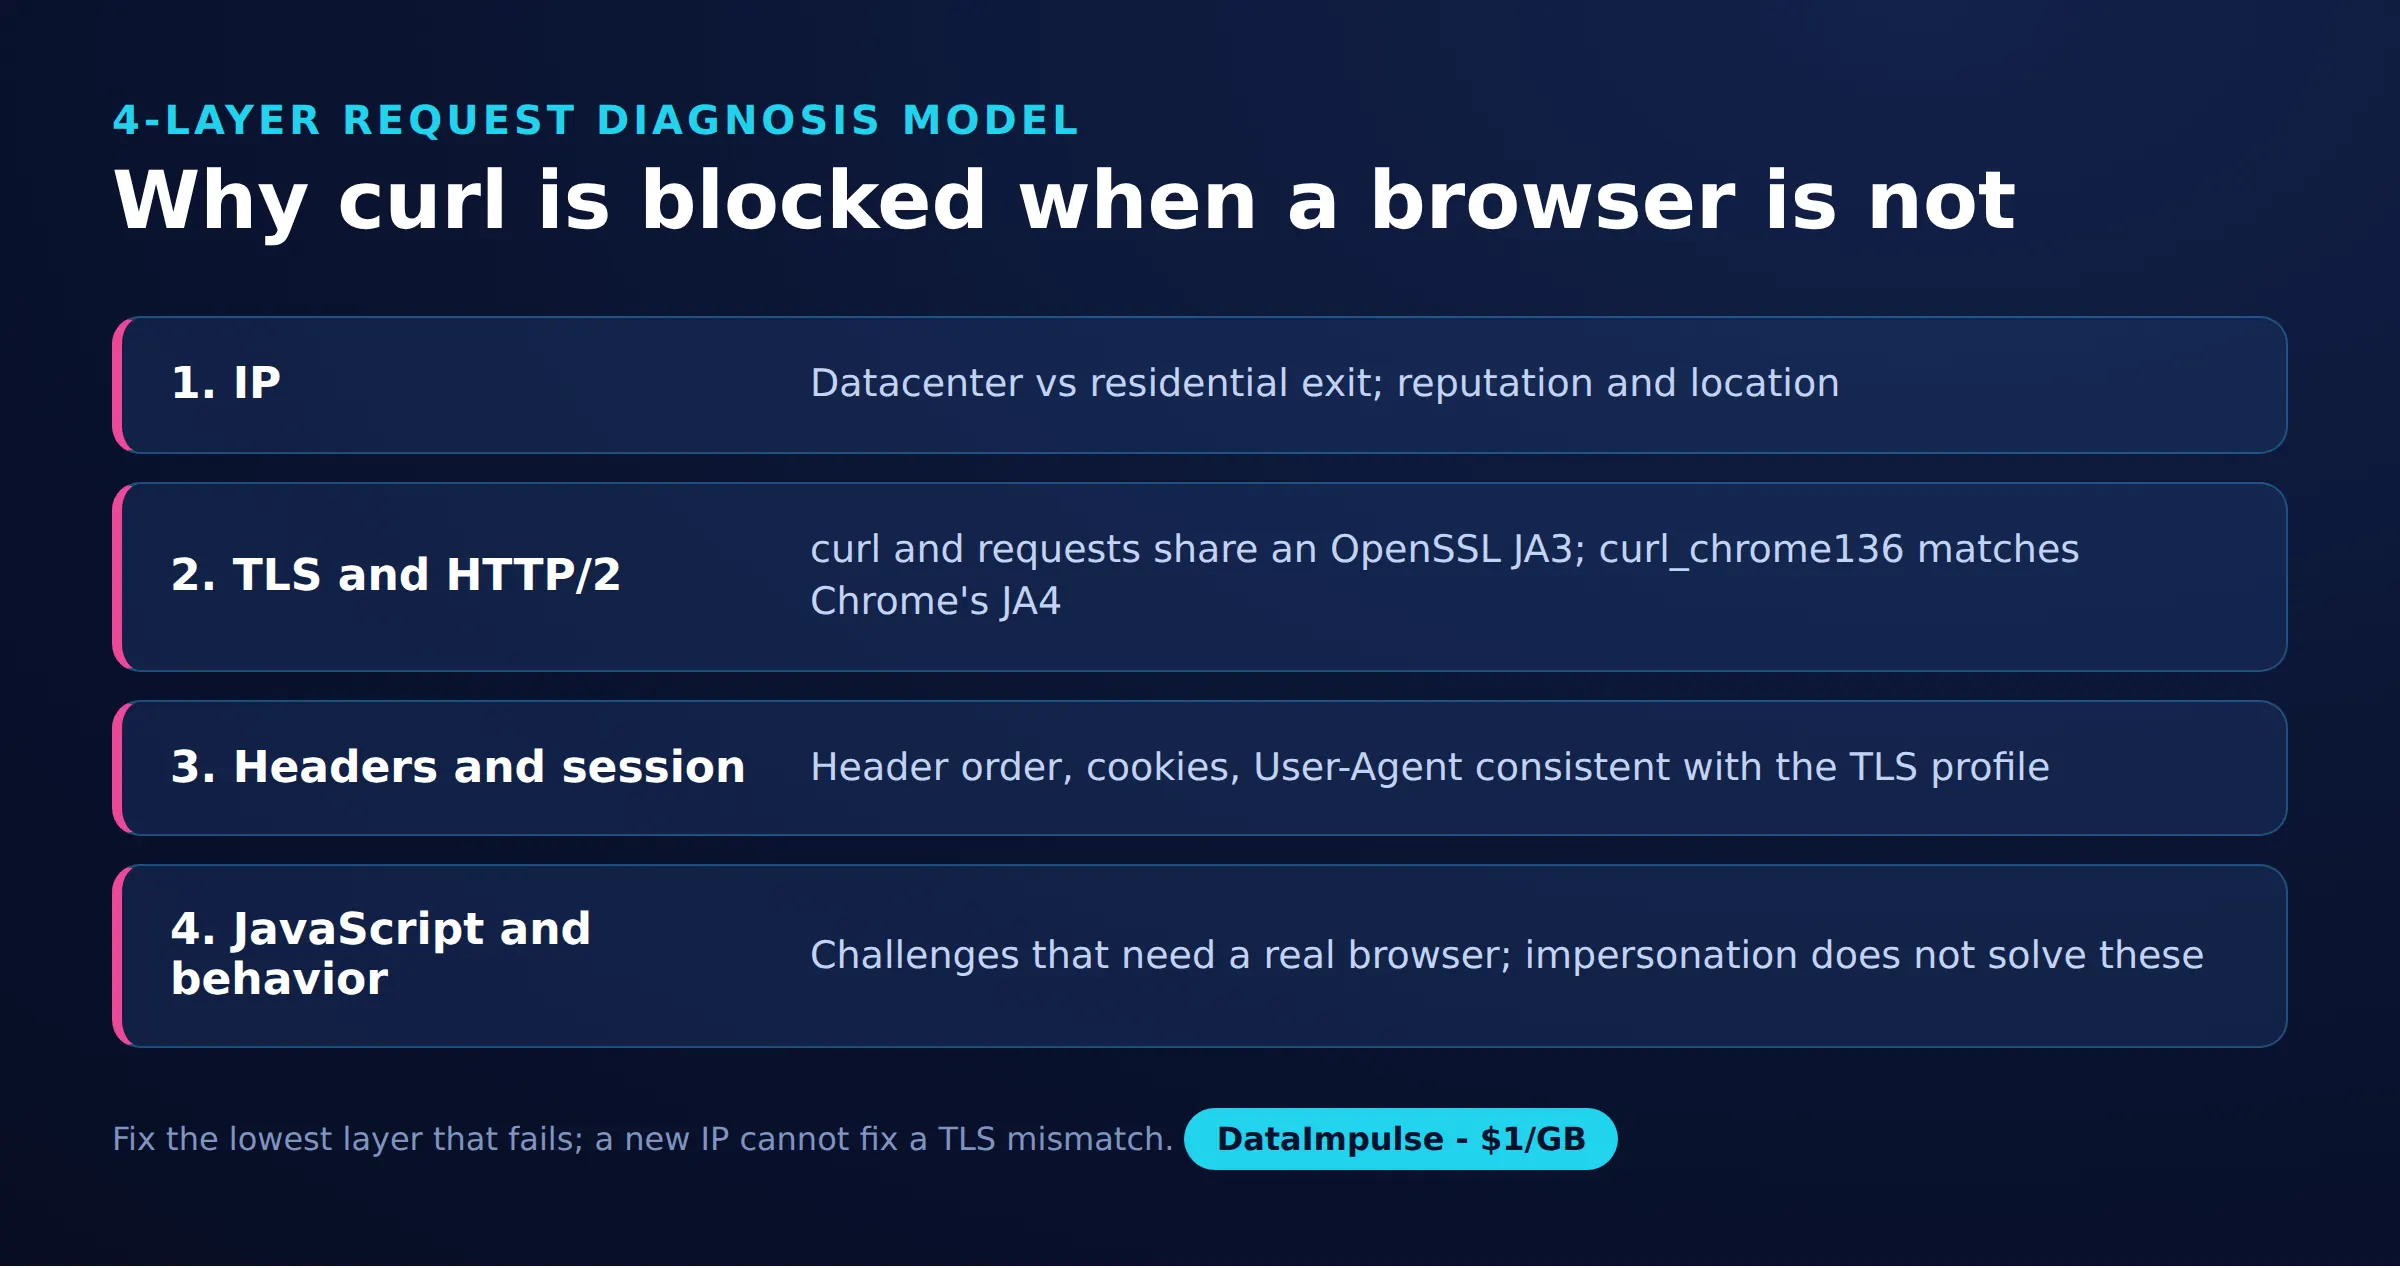
- レイヤー1:IP と経路。クライアントを固定したまま、直接接続とプロキシ経由のアクセスを比較します。国、出口の安定性、HTTP レスポンスが届く前に失敗していないかを記録してください。
- レイヤー2:TLS と HTTP/2。経路を固定したまま、通常のリクエストと偽装したリクエストを比較します。User-Agent の文字列を信用せず、エンドポイントが観測したフィンガープリントを確認してください。
- レイヤー3:ヘッダーとセッション。リダイレクト、Cookie、リクエストした URL、期待するレスポンス形式を比較します。ボディも確認しましょう。HTTP ステータスが成功でも、アプリケーションとしては失敗のレスポンスであることがあります。
- レイヤー4:JavaScript と行動。データがページの実行や操作のあとにだけ表示されるかを判断します。今回の商品ページのチャレンジは、通信層の偽装を行っても解決しませんでした。
比較のたびに、ステータス、リダイレクト先、コンテンツタイプ、レスポンスのサイズ、コンテンツを判別するマーカーを記録してください。レスポンスの検査、リダイレクト、Cookie、詳細な診断出力については、curl の HTTP スクリプティングに関するドキュメントで解説されています。ログを保管する前に、機密情報は削除してください。
すべての拒否をフィンガープリントの問題として扱うのは避けましょう。誤った URL、セッション状態の欠落、アプリケーションのルールは、通信層を変えても残ることがあります。ご自身のサービスでは、クライアント側の観測結果とサーバーログを突き合わせてください。外部のサービスでは、チャレンジに対する再試行の繰り返しをやめ、許可されているアクセス方法をあらためて確認しましょう。
Playwright や Selenium ではなく curl-impersonate を選ぶのはどんなときか
HTTP レスポンスにタスクに必要なものがすべて含まれている場合は、通信層の偽装を選びます。レンダリングや操作が不可欠な場合はブラウザ自動化を選び、その運用コストはご自身のワークロードで計測してください。
| クライアント | 使うのに向いている場合 | 避けたほうがよい場合 |
|---|---|---|
| 標準の curl | 通常の HTTP で足りる場合は、標準の curl を使います。 | フィンガープリントの不一致が検証済みで問題になる場合は、標準の curl を避けます。 |
| curl-impersonate | ブラウザに近い通信層がタスクに合う場合は、curl-impersonate を使います。 | JavaScript の実行が必要な場合は、curl-impersonate を避けます。 |
| Playwright/Selenium | レンダリングや操作が不可欠な場合は、Playwright/Selenium を使います。 | 単純な HTTP で要件を満たせる場合は、Playwright/Selenium を避けます。 |
ブラウザのリクエストの観察については Playwright のネットワークに関するドキュメントが、ブラウザ自動化については Selenium の概要が参考になります。ブラウザでは、ページのライフサイクルやリソースの読み込みに関わる処理が加わります。今回のテストでは CPU もレイテンシも計測していないため、速度やスケーラビリティ面での優位性は確認できていません。
Playwright の APIRequestContext は API リクエストを送信でき、ブラウザコンテキストと Cookie を共有できます。ただし、ブラウザのページを遷移させることと同等ではありません。Cookie を共有しているからといって、通信層の挙動が同一になるとは考えないでください。
ブラウザ自動化にも限界があります。Cloudflare のサポート対象環境に関するドキュメントでは、本番環境のチャレンジを解く際のサポート対象から、自動化されたブラウザが除外されています(2026年10月時点)。ツールを切り替えれば、どのチャレンジでも解決できるわけではありません。
公開ページの小規模テストで何が分かったか
2026年10月16日に行った簡易テストでは、偽装したリクエストでは検索コンテンツを取得でき、通常のリクエストではチャレンジが返されました。商品ページでは失敗しており、この成功を一般化できる範囲には限りがあることが分かります。
方法とサンプル:Andrii は、TLS 検査用エンドポイントで8種類のクライアントとプロファイルの構成を比較しました。内訳は、requests 2.x、システムの curl、4つの curl_cffi プロファイル、Playwright の Chromium、curl_chrome136 です。アプリケーションのサンプルは、Python のクライアントと経路の4つの組み合わせと、CLI での検索結果2件に加え、探索的な商品ページの確認で構成されています。これらは記録された観測結果であり、繰り返し試行した成功率ではありません。
フィンガープリントのエンドポイントは https://tls.peet.ws/api/all でした。Python のプロファイルは chrome、chrome131、safari、firefox です。通常の requests とシステムの curl は JA3 の 0149f47eabf9a20d0893e2a44e5a6323 が共通でしたが、requests は HTTP/1.1、システムの curl は h2 を使っていました。このことだけでも、1つの TLS ハッシュでは接続全体を要約できない理由が分かります。
| Python クライアント | 経路 | ステータス | 記録したサイズ | ボディの分類 |
|---|---|---|---|---|
| requests | 直接接続 | 200 | 15 KB | PerimeterX のチャレンジ |
| requests | レジデンシャル | 200 | 15 KB | PerimeterX のチャレンジ |
| curl_cffi chrome | 直接接続 | 200 | 1321 KB | コンテンツ |
| curl_cffi chrome | レジデンシャル | 200 | 1392 KB | コンテンツ |
CLI での比較では、同じ DataImpulse の米国レジデンシャルプロキシと Chrome の User-Agent を使用しました。通常の curl は、「Robot or human?」と表示されるブロックページへの 307 リダイレクトを受け取りました。curl_chrome136 のリクエストは 200 を返し、圧縮された状態で約 176 KB が転送され、__NEXT_DATA__ 商品 JSON を含む HTML が取得できました。
Walmart の商品ページでは、引き続き curl_cffi にチャレンジが表示されました。Sephora の商品ページでは、レジデンシャル経由のアクセスで Akamai の JavaScript/行動ベースのチャレンジが返されました。これらの失敗があるため、検索ページでの結果をどちらのサイトにも当てはまる一般的な主張に広げることはできません。
トラフィックの試算:公表されているレジデンシャルプロキシの開始価格 1 GB あたり $1 で、10進単位を使うと、176 KB は約 $0.000176 に相当します。これはレスポンスのトラフィックを例示したものであり、請求額の見積もりではありません。リクエストのバイト数、再試行、課金ルール、その他の転送によって、合計は変わることがあります。Python のサイズについては、ここでは圧縮転送時のサイズとの対応関係が確認できていないため、CLI の数値と直接比較しないでください。
このスナップショットには、所要時間の分布、リクエストの繰り返し回数、すべてのヘッダーの違いを個別に切り分けた制御実験は含まれていません。通信層を調べる根拠にはなりますが、レスポンスの違いをすべて TLS のみに帰することはできません。
このスナップショットを再現する場合は、パッケージの正確なバージョン、選択したラッパー、経路、レスポンスの分類、計測単位をあわせて記録してください。転送バイト数とデコード後のボディサイズは、別々のフィールドとして保存します。キャパシティプランニングに使う前に、制御された条件で比較を繰り返してください。ページのテンプレートやチャレンジのレスポンスが変わった場合は、パーサーを再検証する理由になります。
どのような許可と代替手段を確認すべきか
診断用のリクエストを継続的な自動化に発展させる前に、意図している収集が許可されていることを確認してください。公開されていることだけでは、あらゆる用途について許可があるという十分な根拠にはなりません。
サイトの利用規約、robots の指示、公開されているアクセスポリシー、適用される義務を確認しましょう。収集の範囲は絞り込み、明示された制限を守り、チャレンジに対する再試行の繰り返しは避けてください。第三者のログイン認証情報を流用したり、CAPTCHA の回避を試みたりしてはいけません。
壊れやすいページ連携を維持する前に、公式の API、エクスポート、フィード、ライセンス提供されるデータセットがないか確認してください。フィールドの網羅性、鮮度、認証の要件、許可される再利用の範囲を比較しましょう。アクセスの可否が不明な場合は、レスポンスが正常に返ったことで問題が解決したと考えず、承認された方法を求めてください。
よくある質問
curl-impersonate とは何ですか?
ブラウザに近いネットワークハンドシェイクを目的として改変された curl のビルドです。通信層の違いを調べるために使い、実際に返されたコンテンツの検証は別に行ってください。
ブラウザでは成功するのに curl が失敗することがあるのはなぜですか?
2つのリクエストの間で、経路、通信層、セッション状態、ページの実行に違いがある可能性があります。今回のテストでは、HTTP 200 でもチャレンジが含まれていることがあったため、ステータスだけでは成功の判定として誤解を招くものでした。
curl_cffi はどのように Chrome を偽装しますか?
impersonate パラメータでブラウザの通信プロファイルを選択します。今回テストした Python の呼び出しでは chrome を選択しました。再現手順を記録する際は、このエイリアスとあわせてパッケージのバージョンも残してください。
curl-impersonate はプロキシでも動作しますか?
今回の curl_chrome136 のリクエストは、認証付きの HTTP レジデンシャルプロキシ経由で動作しました。動作する経路でもチャレンジが返されることがあるため、プロキシへの接続性とアプリケーション側での受け入れは別々に確認してください。
代わりに Playwright を使うのはどんなときですか?
必要な結果がページの実行や操作に依存する場合は、ブラウザを使ったワークフローを選びます。まず、目的のデータが最初のレスポンスに含まれていないことを確認し、ブラウザ自動化をアクセスが保証される手段として扱わないでください。
JA4 が一致すれば、そのリクエストがブラウザである証明になりますか?
いいえ。今回偽装したクライアントは Chromium と一部のフィンガープリントが共通していましたが、その観測結果からは、ブラウザの挙動の全体や許可の有無については何も言えません。
明確なベースラインでネットワーク層をテストする
診断の結果が出口の経路にあると示された場合は、同じクライアント、プロファイル、コンテンツ確認の方法で DataImpulse のレジデンシャルプロキシを評価してみてください。DataImpulse が提供するのはプロキシであり、スクレイピング API、マネージド型のアンブロッカー、VPN、データではありません。まずは小規模に始め、許可と利用可能なレスポンスの両方を確認できてから拡大してください。
最終更新日:2026年10月16日。