
In questo articolo
Con curl impersonate si intende l’uso di curl-impersonate per imitare il comportamento TLS e HTTP/2 di un browser quando si inviano richieste HTTP. La documentazione del progetto originale descrive le modifiche al livello di trasporto alla base di questo approccio; cambiare solo lo User-Agent non le riproduce.
Parti da un controllo dell’impronta (fingerprint), poi ispeziona il corpo effettivo della risposta. Il nostro test rapido del 16 ottobre 2026 ha rilevato differenze utili tra i client ordinari e le richieste con impersonificazione, oltre a pagine prodotto che continuavano a restituire challenge. Si tratta di un piccolo campione, non di un benchmark né di una promessa di accesso.
Punti chiave
- Python requests e curl di sistema hanno presentato la stessa impronta JA3 di OpenSSL nel nostro test.
- curl_cffi con impersonate=”chrome” e curl_chrome136 hanno corrisposto esattamente alle impronte JA4 e HTTP/2 di Chromium 145 reale.
- Con lo stesso residential proxy e lo stesso User-Agent, curl semplice è stato reindirizzato alla pagina di blocco di Walmart; curl_chrome136 ha ottenuto la pagina completa.
- JA3 cambia tra le versioni di Chrome perché Chrome randomizza l’ordine delle estensioni TLS; JA4 è il segnale più stabile.
- L’impersonificazione corregge le impronte TLS e HTTP/2, non le challenge JavaScript o comportamentali.
- curl-impersonate v2.2.3 include binari pronti come curl_chrome136 e curl_firefox147.
Che cos’è curl impersonate e cosa imita davvero?
curl-impersonate è una build modificata di curl che punta a un comportamento di connessione simile a quello di un browser. Il suo ambito comprende gli handshake TLS e le impostazioni HTTP/2, non l’intero ambiente di esecuzione di un browser.
Il progetto originale si trova sotto lwthiker; il binario che abbiamo testato proviene dal fork di lexiforest. La documentazione del fork indica come base una versione modificata di BoringSSL. Annota insieme repository, release e profilo scelto: il nome familiare di un eseguibile da solo non basta a garantirne la provenienza.
Considera l’impersonificazione come la scelta di come la connessione si presenta. Gli header descrivono la richiesta HTTP, mentre le impostazioni di trasporto descrivono un’altra parte del client. Nessuno dei due dimostra che la richiesta sia partita da una persona. Far corrispondere alcune impronte selezionate non può dimostrare un’equivalenza completa con il browser.
Per un flusso di lavoro con curl impersonate, verifica prima se i dati che ti servono sono già presenti nella risposta HTTP. La nostra risposta di ricerca riuscita conteneva JSON dei prodotti incorporato; altre pagine testate presentavano ancora delle challenge. La guida al TLS fingerprinting offre più contesto, ma le decisioni di implementazione dovrebbero basarsi sull’ispezione della risposta.
Come installare curl impersonate ed eseguire la prima richiesta?
Scegli in modo esplicito la release e l’artefatto per la tua piattaforma, poi esegui il wrapper del browser su un endpoint di verifica dell’impronta. La nostra configurazione Linux di test usava lexiforest v2.2.3 e il wrapper curl_chrome136.
Passaggio 1: apri la release v2.2.3 ufficiale, seleziona l’artefatto Linux adatto alla tua architettura ed estrailo. Segui la documentazione di installazione per i requisiti di runtime e dei certificati CA.
Passaggio 2: tieni insieme il wrapper e i relativi artefatti di supporto. Il nostro ambiente era Linux con OpenSSL 3.0.13 di Ubuntu; il binario di impersonificazione si identificava come curl 8.22.0-IMPERSONATE con BoringSSL. Questa differenza conta quando lo confronti con il curl di sistema.
Passaggio 3: dalla directory estratta, esegui lo stesso identico comando di verifica usato nel nostro test:
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
Salva JA4, versione HTTP e impronta HTTP/2 restituiti prima di testare un endpoint applicativo. In questo modo ottieni una base di riferimento del trasporto, senza trattare la risposta di un negozio online come test dell’impronta.
Per Windows o macOS, usa gli artefatti per la piattaforma e i metodi di installazione documentati dal fork. La sua pagina dei binding rimanda alle integrazioni per Python, JavaScript/TypeScript, PHP e Rust. Verifica qualsiasi pacchetto Nixpkgs o wrapper Node rispetto al suo upstream e alla sua release effettivi; le nostre prove di installazione riguardano solo Linux.
Come impersonare Chrome in Python con curl_cffi?
Usa curl_cffi con il parametro impersonate e fissa la versione del pacchetto per garantire la riproducibilità. La nostra implementazione Python usava curl_cffi 0.15 con impersonate=”chrome”.
La guida rapida ufficiale documenta l’installazione tramite pip, i profili dei browser e un’interfaccia simile a requests. Installa la versione 0.15 in un ambiente isolato per riprodurre la nostra selezione dei pacchetti. L’alias generico chrome segue l’attuale target Chrome della libreria, quindi un aggiornamento può cambiarne il significato.
Prima di eseguire questa istruzione testata così com’è, definisci url come URL di ricerca pubblico https://www.walmart.com/search?q=air+fryer e PROXY come URL del tuo proxy, caricato in modo riservato dal tuo ambiente. L’istruzione dipende da queste due variabili:
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
Controlla lo stato della risposta e l’HTML prima di estrarre i record. Nella nostra risposta di ricerca riuscita via CLI, la fonte di estrazione era il JSON dei prodotti incorporato in __NEXT_DATA__. Individua quell’elemento script con un parser HTML, decodifica il JSON e convalida i campi attesi prima di considerare la pagina un contenuto utilizzabile.
La guida rapida documenta Session per la persistenza dei cookie e il riutilizzo delle connessioni. Per un flusso con più richieste, mantieni coerenti sessione, profilo e posizione di uscita prevista. Evita di combinare un profilo con header di versione del browser arbitrari copiati da una macchina non correlata.
L’autenticazione al proxy e quella alla destinazione sono questioni distinte. Usa solo credenziali emesse per il tuo servizio autorizzato; questo esempio su una pagina pubblica non richiede alcun login alla destinazione. La nostra guida da curl a Python spiega come tradurre la struttura di una richiesta.
In cosa differiscono le impronte JA3 e JA4?
JA3 conserva l’ordine di alcuni campi del ClientHello, mentre JA4 normalizza alcuni elenchi prima dell’hashing. Per questo JA4 è utile quando l’ordine delle estensioni varia, ma non diventa per questo un’identità completa del client.
La specifica JA3 di Salesforce descrive un’impronta costruita a partire da versione TLS, cifrari, estensioni, gruppi supportati e formati dei punti. La specifica JA4 di FoxIO ordina cifrari ed estensioni, ma conserva l’ordine degli algoritmi di firma. Non descrivere JA4 come se ignorasse ogni differenza di ordine.
Nel nostro test, curl_cffi chrome e Playwright Chromium 145.0.7632.6 condividevano il JA4 t13d1516h2_8daaf6152771_d8a2da3f94cd e l’impronta HTTP/2 52d84b11737d980aef856699f885ca86. I loro valori JA3 erano diversi. Il wrapper curl_chrome136 ha corrisposto agli stessi valori JA4 e HTTP/2.
Sono corrispondenze osservate dal server all’endpoint di misura, non una prova che ogni byte dell’handshake o ogni comportamento applicativo coincidesse. Testa attraverso il percorso di rete previsto e confronta entrambi i livelli di trasporto. Per i sistemi che gestisci, esamina le prove lato server; la documentazione di Cloudflare sulle impronte spiega come usare questi segnali nell’analisi del traffico e nelle regole.
Come configurare i proxy HTTP, HTTPS e SOCKS?
Imposta il proxy in modo indipendente dal profilo del browser. Lo schema della destinazione e quello del proxy descrivono connessioni diverse, quindi una destinazione HTTPS può usare un proxy HTTP.
Nell’istruzione Python, la chiave https del dizionario seleziona le destinazioni HTTPS; il valore identifica l’endpoint del proxy. La guida rapida di curl_cffi documenta esempi di proxy HTTP e SOCKS. Il nostro percorso misurato usava un proxy HTTP con autenticazione.
La documentazione di curl sui proxy HTTP spiega il tunneling CONNECT per le destinazioni HTTPS. Senza intercettazione TLS, il tunnel trasporta lo scambio cifrato del client, preservandone gli header rivolti alla destinazione e l’handshake TLS. Un proxy HTTPS cifra inoltre la connessione tra client e proxy; consulta il riferimento ufficiale dell’opzione proxy per gli schemi supportati e le impostazioni di autenticazione.
Tieni i segreti del proxy fuori dagli script condivisi e dall’output diagnostico. Verifica prima, in modo indipendente, endpoint, protocollo, porta e autenticazione; poi confronta le risposte applicative. Un errore di connessione al proxy è un indizio diverso rispetto a una pagina di challenge recuperata con successo.
Per le sequenze con stato, durante la diagnosi preferisci un’uscita stabile. Valuta la rotazione solo per richieste indipendenti e autorizzate, dopo aver stabilito una base di riferimento funzionante. Cambiare insieme IP e profilo di trasporto rende il risultato più difficile da spiegare.
La nostra guida alla configurazione di curl con un proxy spiega la configurazione, mentre la scelta dei proxy per curl ti aiuta a valutare i requisiti del percorso. Né la scelta del percorso né l’impersonificazione garantiscono l’accettazione.
Perché curl viene ancora bloccato quando un browser funziona?
Un browser e un client HTTP possono differire su più livelli anche quando richiedono lo stesso URL. Usa il modello di diagnosi della richiesta a 4 livelli per isolare la differenza prima di cambiare strumento.
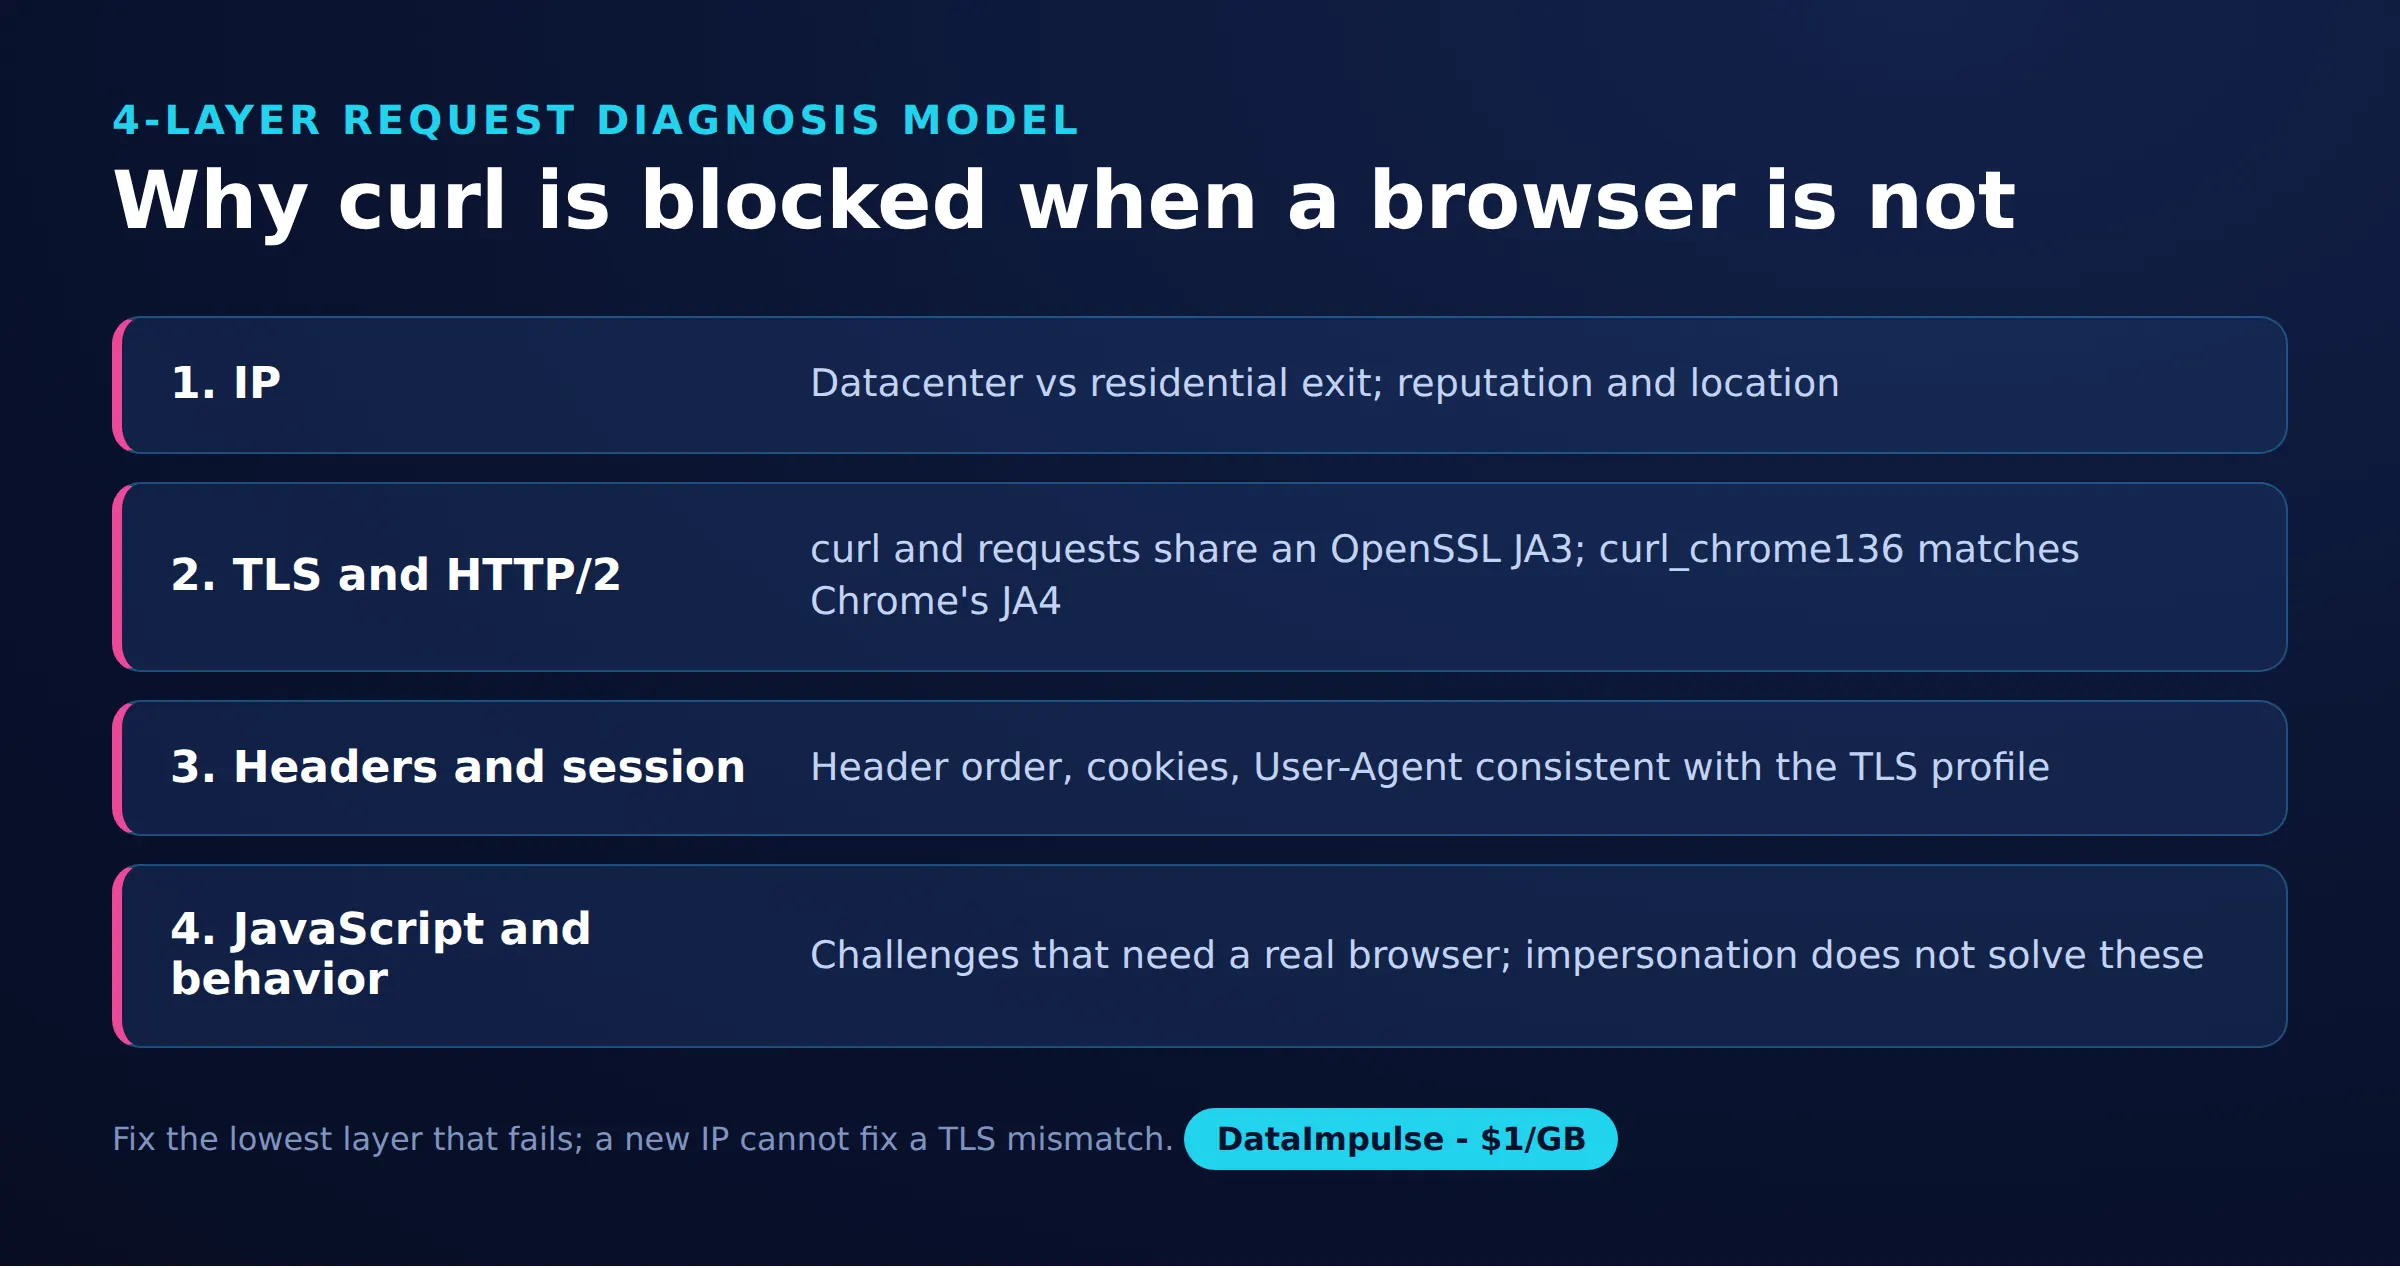
- Livello 1: IP e percorso. Mantieni costante il client mentre confronti l’accesso diretto e quello tramite proxy. Registra il paese, la stabilità dell’uscita e se l’errore avviene prima che arrivi una risposta HTTP.
- Livello 2: TLS e HTTP/2. Mantieni costante il percorso mentre confronti richieste ordinarie e impersonate. Controlla le impronte osservate dall’endpoint invece di fidarti della stringa User-Agent.
- Livello 3: header e sessione. Confronta redirect, cookie, URL richiesto e formato di risposta atteso. Ispeziona il corpo: uno stato HTTP di successo può accompagnare una risposta applicativa non riuscita.
- Livello 4: JavaScript e comportamento. Stabilisci se i dati compaiono solo dopo l’esecuzione della pagina o un’interazione. Le challenge sulle nostre pagine prodotto sono rimaste irrisolte anche dopo l’impersonificazione del trasporto.
Per ogni confronto registra stato, destinazione del redirect, tipo di contenuto, dimensione della risposta e un indicatore del contenuto. La documentazione di curl sullo scripting HTTP spiega l’ispezione delle risposte, i redirect, i cookie e la diagnostica verbosa. Rimuovi i segreti prima di conservare i log.
Non considerare ogni rifiuto un problema di impronta. Un URL sbagliato, uno stato di sessione mancante o una regola applicativa possono sopravvivere a un cambio di trasporto. Sul tuo servizio, correla le osservazioni del client con i log del server. Per i servizi esterni, interrompi i tentativi ripetuti contro le challenge e rivaluta il percorso di accesso consentito.
Quando scegliere curl-impersonate al posto di Playwright o Selenium?
Scegli l’impersonificazione del trasporto quando una risposta HTTP contiene tutto ciò che serve all’attività. Scegli l’automazione del browser quando il rendering o l’interazione sono essenziali, e misura il suo costo operativo sul tuo carico di lavoro.
| Client | Usa X quando… | Evita X quando… |
|---|---|---|
| curl standard | Usa curl standard quando basta il normale HTTP. | Evita curl standard quando conta una discrepanza di impronta verificata. |
| curl-impersonate | Usa curl-impersonate quando un trasporto simile a quello di un browser è adatto all’attività. | Evita curl-impersonate quando è necessaria l’esecuzione di JavaScript. |
| Playwright/Selenium | Usa Playwright/Selenium quando il rendering o l’interazione sono essenziali. | Evita Playwright/Selenium quando il semplice HTTP soddisfa i requisiti. |
La documentazione di rete di Playwright spiega come osservare le richieste del browser; la panoramica di Selenium descrive l’automazione del browser. Un browser comporta il ciclo di vita della pagina e il caricamento delle risorse. Il nostro test non ha misurato né CPU né latenza, quindi non stabilisce alcun vantaggio in termini di velocità o scalabilità.
L’APIRequestContext di Playwright invia richieste API e può condividere i cookie con un contesto del browser. Non equivale a navigare una pagina con un browser; non dare per scontato che la condivisione dei cookie stabilisca un comportamento di trasporto identico.
Anche l’automazione del browser ha dei limiti. La documentazione di Cloudflare sugli ambienti supportati esclude i browser automatizzati dal supporto per la risoluzione delle challenge in produzione (a ottobre 2026). Cambiare strumento non è una soluzione universale alle challenge.
Cosa ha mostrato il nostro piccolo test su pagine pubbliche?
Il nostro test rapido del 16 ottobre 2026 ha recuperato contenuti di ricerca con l’impersonificazione, mentre le richieste ordinarie hanno ricevuto delle challenge. I fallimenti sulle pagine prodotto hanno mostrato il limite di generalizzare a partire da quel successo.
Metodo e campione: Andrii ha confrontato otto configurazioni client/profilo all’endpoint di ispezione TLS: requests 2.x, curl di sistema, quattro profili curl_cffi, Playwright Chromium e curl_chrome136. Il campione applicativo comprendeva quattro combinazioni client Python/percorso e due esiti di ricerca via CLI, oltre a controlli esplorativi sulle pagine prodotto. Sono osservazioni registrate, non percentuali di successo su prove ripetute.
L’endpoint delle impronte era https://tls.peet.ws/api/all. I profili Python erano chrome, chrome131, safari e firefox. Le richieste ordinarie e il curl di sistema condividevano il JA3 0149f47eabf9a20d0893e2a44e5a6323, mentre requests usava HTTP/1.1 e il curl di sistema usava h2. Già questo mostra perché un solo hash TLS non può riassumere l’intera connessione.
| Client Python | Percorso | Stato | Dimensione registrata | Classificazione del corpo |
|---|---|---|---|---|
| requests | Diretto | 200 | 15 KB | Challenge PerimeterX |
| requests | Residential | 200 | 15 KB | Challenge PerimeterX |
| curl_cffi chrome | Diretto | 200 | 1321 KB | Contenuto |
| curl_cffi chrome | Residential | 200 | 1392 KB | Contenuto |
Il confronto via CLI ha usato lo stesso residential proxy US di DataImpulse e lo stesso User-Agent di Chrome. curl semplice ha ricevuto un redirect 307 verso una pagina bloccata intitolata “Robot or human?”. La richiesta con curl_chrome136 ha restituito 200, circa 176 KB trasferiti in forma compressa e HTML contenente il JSON dei prodotti in __NEXT_DATA__.
Le pagine prodotto di Walmart hanno continuato a opporre challenge a curl_cffi. Una pagina prodotto di Sephora ha restituito una challenge JavaScript/comportamentale di Akamai tramite accesso residential. Questi fallimenti impediscono di estendere il risultato della pagina di ricerca a un’affermazione generale su uno dei due siti.
Stima del traffico: al prezzo di partenza dichiarato per i residential di $1 per GB, 176 KB corrispondono a circa $0.000176 usando le unità decimali. È un traffico di risposta a titolo illustrativo, non una stima di fattura: i byte delle richieste, i nuovi tentativi, le regole di fatturazione e altri trasferimenti possono cambiare il totale. Per le dimensioni Python non è stata stabilita alcuna equivalenza con il trasferimento compresso, quindi non confrontarle direttamente con il dato della CLI.
Questo test non include distribuzioni dei tempi, numero di richieste ripetute né un isolamento controllato di ogni differenza di header. Supporta l’indagine sul trasporto, ma non permette di attribuire ogni differenza di risposta al solo TLS.
Per ripetere questo test, registra insieme le versioni esatte dei pacchetti, il wrapper scelto, il percorso, la classificazione della risposta e le unità di misura. Mantieni campi separati per i byte trasferiti e la dimensione del corpo decodificato. Ripeti i confronti in condizioni controllate prima di usarli per la pianificazione della capacità, e considera un template di pagina modificato o una risposta di challenge diversa come un motivo per riconvalidare il parser.
Quali permessi e alternative devi verificare?
Verifica che la raccolta prevista sia autorizzata prima di trasformare una richiesta diagnostica in un’automazione continuativa. L’accessibilità pubblica non è una prova sufficiente di autorizzazione per ogni utilizzo.
Controlla i termini del sito, le istruzioni robots, le policy di accesso pubblicate e gli obblighi applicabili. Mantieni la raccolta circoscritta, rispetta i limiti dichiarati ed evita tentativi ripetuti contro le challenge. Non riutilizzare credenziali di accesso di terzi e non tentare di aggirare i CAPTCHA.
Verifica se esiste un’API ufficiale, un export, un feed o un dataset in licenza prima di mantenere un’integrazione fragile con una pagina. Confronta copertura dei campi, freschezza, requisiti di autenticazione e riutilizzo consentito. Quando l’accesso non è chiaro, cerca un percorso approvato invece di presumere che una risposta riuscita chiuda la questione.
Domande frequenti
Che cos’è curl-impersonate?
È una build modificata di curl pensata per handshake di rete simili a quelli di un browser. Usalo per indagare le differenze di trasporto, convalidando separatamente il contenuto effettivamente restituito.
Perché curl può fallire quando un browser ha successo?
Le due richieste possono differire per percorso, trasporto, stato della sessione o esecuzione della pagina. Nel nostro test, un HTTP 200 conteneva a volte una challenge, quindi lo stato da solo era un controllo di successo fuorviante.
Come fa curl_cffi a impersonare Chrome?
Il suo parametro impersonate seleziona un profilo di trasporto del browser. La nostra chiamata Python testata ha selezionato chrome; conserva la versione del pacchetto insieme a quell’alias quando documenti una riproduzione.
curl-impersonate funziona con i proxy?
La nostra richiesta con curl_chrome136 ha funzionato tramite un residential proxy HTTP autenticato. Tratta la connettività del proxy e l’accettazione da parte dell’applicazione come controlli separati, perché un percorso funzionante può comunque restituire una challenge.
Quando dovrei usare Playwright?
Scegli un flusso con browser quando il risultato richiesto dipende dall’esecuzione della pagina o dall’interazione. Conferma prima che i dati desiderati non siano presenti nella risposta iniziale e non considerare l’automazione del browser un accesso garantito.
La corrispondenza del JA4 dimostra che una richiesta proviene da un browser?
No. I nostri client impersonati condividevano alcune impronte selezionate con Chromium, ma questa osservazione non dice nulla sul comportamento completo di un browser né sull’autorizzazione.
Testa il livello di rete con una base di riferimento chiara
Se la tua diagnosi indica il percorso di uscita, valuta i residential proxy di DataImpulse con lo stesso client, lo stesso profilo e gli stessi controlli sul contenuto. DataImpulse fornisce proxy, non un’API di scraping, uno unblocker gestito, una VPN o dati. Parti in piccolo e amplia solo dopo aver confermato sia il permesso sia la qualità delle risposte.
Ultimo aggiornamento: 16 ottobre 2026.