
En este artículo
Curl impersonate se refiere al uso de curl-impersonate para imitar el comportamiento TLS y HTTP/2 de un navegador al hacer solicitudes HTTP. La documentación del proyecto original describe los cambios de transporte que hay detrás de este enfoque; cambiar solo el User-Agent no los reproduce.
Comience con una comprobación de la huella digital y después inspeccione el cuerpo real de la respuesta. Nuestra prueba rápida del 16 de octubre de 2026 encontró diferencias útiles entre los clientes habituales y las solicitudes con impersonación, junto con páginas de producto que seguían devolviendo desafíos. Es una muestra pequeña, no un benchmark ni una promesa de acceso.
Datos clave
- Python requests y el curl del sistema presentaron la misma huella JA3 de OpenSSL en nuestra prueba.
- curl_cffi con impersonate=”chrome” y curl_chrome136 coincidieron exactamente con la huella JA4 y HTTP/2 de Chromium 145 real.
- Con el mismo proxy residencial y el mismo User-Agent, curl simple fue redirigido a la página de bloqueo de Walmart; curl_chrome136 obtuvo la página completa.
- JA3 cambia entre versiones de Chrome porque Chrome aleatoriza el orden de las extensiones TLS; JA4 es la señal más estable.
- La impersonación corrige las huellas TLS y HTTP/2, no los desafíos de JavaScript ni los de comportamiento.
- curl-impersonate v2.2.3 incluye binarios listos para usar, como curl_chrome136 y curl_firefox147.
¿Qué es curl impersonate y qué imita realmente?
curl-impersonate es una compilación modificada de curl que busca reproducir el comportamiento de conexión de un navegador. Su alcance incluye los handshakes TLS y la configuración de HTTP/2, no el entorno de ejecución completo de un navegador.
El proyecto original está bajo lwthiker; el binario que probamos procede del fork de lexiforest. La documentación del proyecto del fork indica que se basa en un BoringSSL parcheado. Registre juntos el repositorio, la versión y el perfil seleccionado: el nombre de un ejecutable conocido no basta como prueba de procedencia.
Piense en la impersonación como la elección de cómo se presenta la conexión. Las cabeceras describen la solicitud HTTP, mientras que la configuración de transporte describe otra parte del cliente. Ninguna de las dos demuestra que una persona haya iniciado la solicitud. Que coincidan ciertas huellas no basta para establecer una equivalencia completa con un navegador.
Para un flujo de trabajo con curl impersonate, determine primero si los datos necesarios ya existen en la respuesta HTTP. Nuestra respuesta de búsqueda correcta contenía JSON de producto incrustado; otras páginas probadas seguían mostrando desafíos. La guía sobre huellas TLS más amplia aporta contexto, pero la inspección de la respuesta debe guiar las decisiones de implementación.
¿Cómo se instala curl impersonate y se ejecuta la primera solicitud?
Elija de forma explícita la versión y el artefacto de su plataforma, y luego ejecute su wrapper de navegador contra un endpoint de huellas. Nuestra configuración de Linux usó lexiforest v2.2.3 y el wrapper curl_chrome136.
Paso 1: Abra la versión v2.2.3 oficial, seleccione el artefacto de Linux que corresponda a su arquitectura y extráigalo. Siga la documentación de instalación para conocer los requisitos de runtime y de certificados CA.
Paso 2: Mantenga juntos el wrapper y sus artefactos de apoyo. Nuestro entorno era Linux con OpenSSL 3.0.13 de Ubuntu; el binario de impersonación se identificó como curl 8.22.0-IMPERSONATE con BoringSSL. Esa diferencia importa al compararlo con el curl del sistema.
Paso 3: Desde el directorio extraído, ejecute el comando de huella exacto que usamos en nuestra muestra:
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
Guarde el JA4, la versión de HTTP y la huella HTTP/2 devueltos antes de probar un endpoint de aplicación. Así se crea una línea base de transporte sin tratar la respuesta de un minorista como si fuera la prueba de huellas.
Para Windows o macOS, use los artefactos de plataforma y las vías de instalación que documenta el fork. Su página de bindings remite a las integraciones de Python, JavaScript/TypeScript, PHP y Rust. Verifique cualquier paquete de Nixpkgs o wrapper de Node contra su origen y su versión reales; nuestra evidencia de instalación cubre solo Linux.
¿Cómo se impersona Chrome en Python con curl_cffi?
Use curl_cffi con el parámetro impersonate y fije la versión del paquete para poder reproducir el resultado. Nuestra implementación en Python usó curl_cffi 0.15 con impersonate=”chrome”.
La guía de inicio rápido oficial documenta la instalación con pip, los perfiles de navegador y una interfaz similar a requests. Instale la versión 0.15 en un entorno aislado para reproducir nuestra selección de paquetes. El alias genérico chrome sigue el objetivo Chrome actual de la biblioteca, por lo que una actualización puede cambiar su significado.
Antes de ejecutar esta instrucción exacta que probamos, defina url como la URL de búsqueda pública https://www.walmart.com/search?q=air+fryer y PROXY como la URL de su propio proxy, cargada de forma privada desde su entorno. La instrucción depende de esas dos variables:
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
Inspeccione el estado y el HTML de la respuesta antes de extraer registros. En nuestra respuesta de búsqueda correcta por CLI, la fuente de extracción fue el JSON de producto incrustado en __NEXT_DATA__. Localice ese elemento script con un analizador HTML, decodifique su JSON y valide los campos esperados antes de aceptar la página como contenido utilizable.
La guía de inicio rápido documenta Session para la persistencia de cookies y la reutilización de conexiones. En un flujo de varias solicitudes, mantenga coherentes la sesión, el perfil y la ubicación de salida prevista. Evite combinar un perfil con cabeceras de versión de navegador arbitrarias copiadas de una máquina sin relación.
La autenticación del proxy y la del destino son cuestiones distintas. Use solo credenciales emitidas para su propio servicio autorizado; este ejemplo de página pública no necesita inicio de sesión en el destino. Nuestra guía de curl a Python explica cómo traducir la estructura de la solicitud.
¿En qué se diferencian las huellas JA3 y JA4?
JA3 conserva el orden de ciertos campos del ClientHello, mientras que JA4 normaliza ciertas listas antes de calcular el hash. Por eso JA4 resulta útil cuando varía el orden de las extensiones, aunque no llega a ser una identidad completa del cliente.
La especificación JA3 de Salesforce describe una huella construida a partir de la versión de TLS, los cifrados, las extensiones, los grupos admitidos y los formatos de punto. La especificación JA4 de FoxIO ordena los cifrados y las extensiones, pero conserva el orden de los algoritmos de firma. No describa JA4 como si ignorara todas las diferencias de orden.
En nuestra muestra, curl_cffi chrome y Playwright Chromium 145.0.7632.6 compartieron el JA4 t13d1516h2_8daaf6152771_d8a2da3f94cd y la huella HTTP/2 52d84b11737d980aef856699f885ca86. Sus valores JA3 fueron distintos. El wrapper curl_chrome136 coincidió con esos mismos valores de JA4 y HTTP/2.
Se trata de coincidencias observadas por el servidor en el endpoint de medición, no de una prueba de que cada byte del handshake o cada comportamiento de la aplicación coincidiera. Pruebe a través de la ruta de red prevista y compare ambas capas de transporte. En los sistemas que usted opera, inspeccione la evidencia del lado del servidor; la documentación de huellas de Cloudflare explica cómo usar estas señales en el análisis de tráfico y en las reglas.
¿Cómo se configuran los proxies HTTP, HTTPS y SOCKS?
Configure el proxy de forma independiente del perfil de navegador. El esquema del destino y el del proxy describen conexiones distintas, de modo que un destino HTTPS puede usar un proxy HTTP.
En la instrucción de Python, la clave https del diccionario selecciona los destinos HTTPS; el valor identifica el endpoint del proxy. La guía de inicio rápido de curl_cffi documenta ejemplos de proxies HTTP y SOCKS. Nuestra ruta medida usó un proxy HTTP con autenticación.
La documentación de curl sobre proxies HTTP explica el túnel CONNECT para destinos HTTPS. Sin interceptación de TLS, el túnel transporta el intercambio cifrado del cliente y conserva así las cabeceras y el handshake TLS que ve el destino. Un proxy HTTPS cifra además la conexión entre el cliente y el proxy; consulte la referencia oficial de la opción de proxy para conocer los esquemas y los ajustes de autenticación admitidos.
Mantenga los secretos del proxy fuera de los scripts compartidos y de la salida de diagnóstico. Verifique primero por separado el endpoint, el protocolo, el puerto y la autenticación; después compare las respuestas de la aplicación. Un fallo de conexión con el proxy es una evidencia distinta de haber recuperado con éxito una página de desafío.
Para secuencias con estado, durante el diagnóstico conviene una salida estable. Considere la rotación solo para solicitudes independientes y autorizadas, y únicamente después de establecer una línea base que funcione. Cambiar a la vez la IP y el perfil de transporte dificulta explicar el resultado.
Nuestra guía de configuración de proxy con curl cubre la configuración, mientras que la selección de proxies para curl ayuda a evaluar los requisitos de la ruta. Ni la elección de la ruta ni la impersonación garantizan la aceptación.
¿Por qué curl sigue bloqueado cuando un navegador funciona?
Un navegador y un cliente HTTP pueden diferir en varias capas aunque soliciten la misma URL. Use el modelo de diagnóstico de solicitudes en 4 capas para aislar la diferencia antes de cambiar de herramienta.
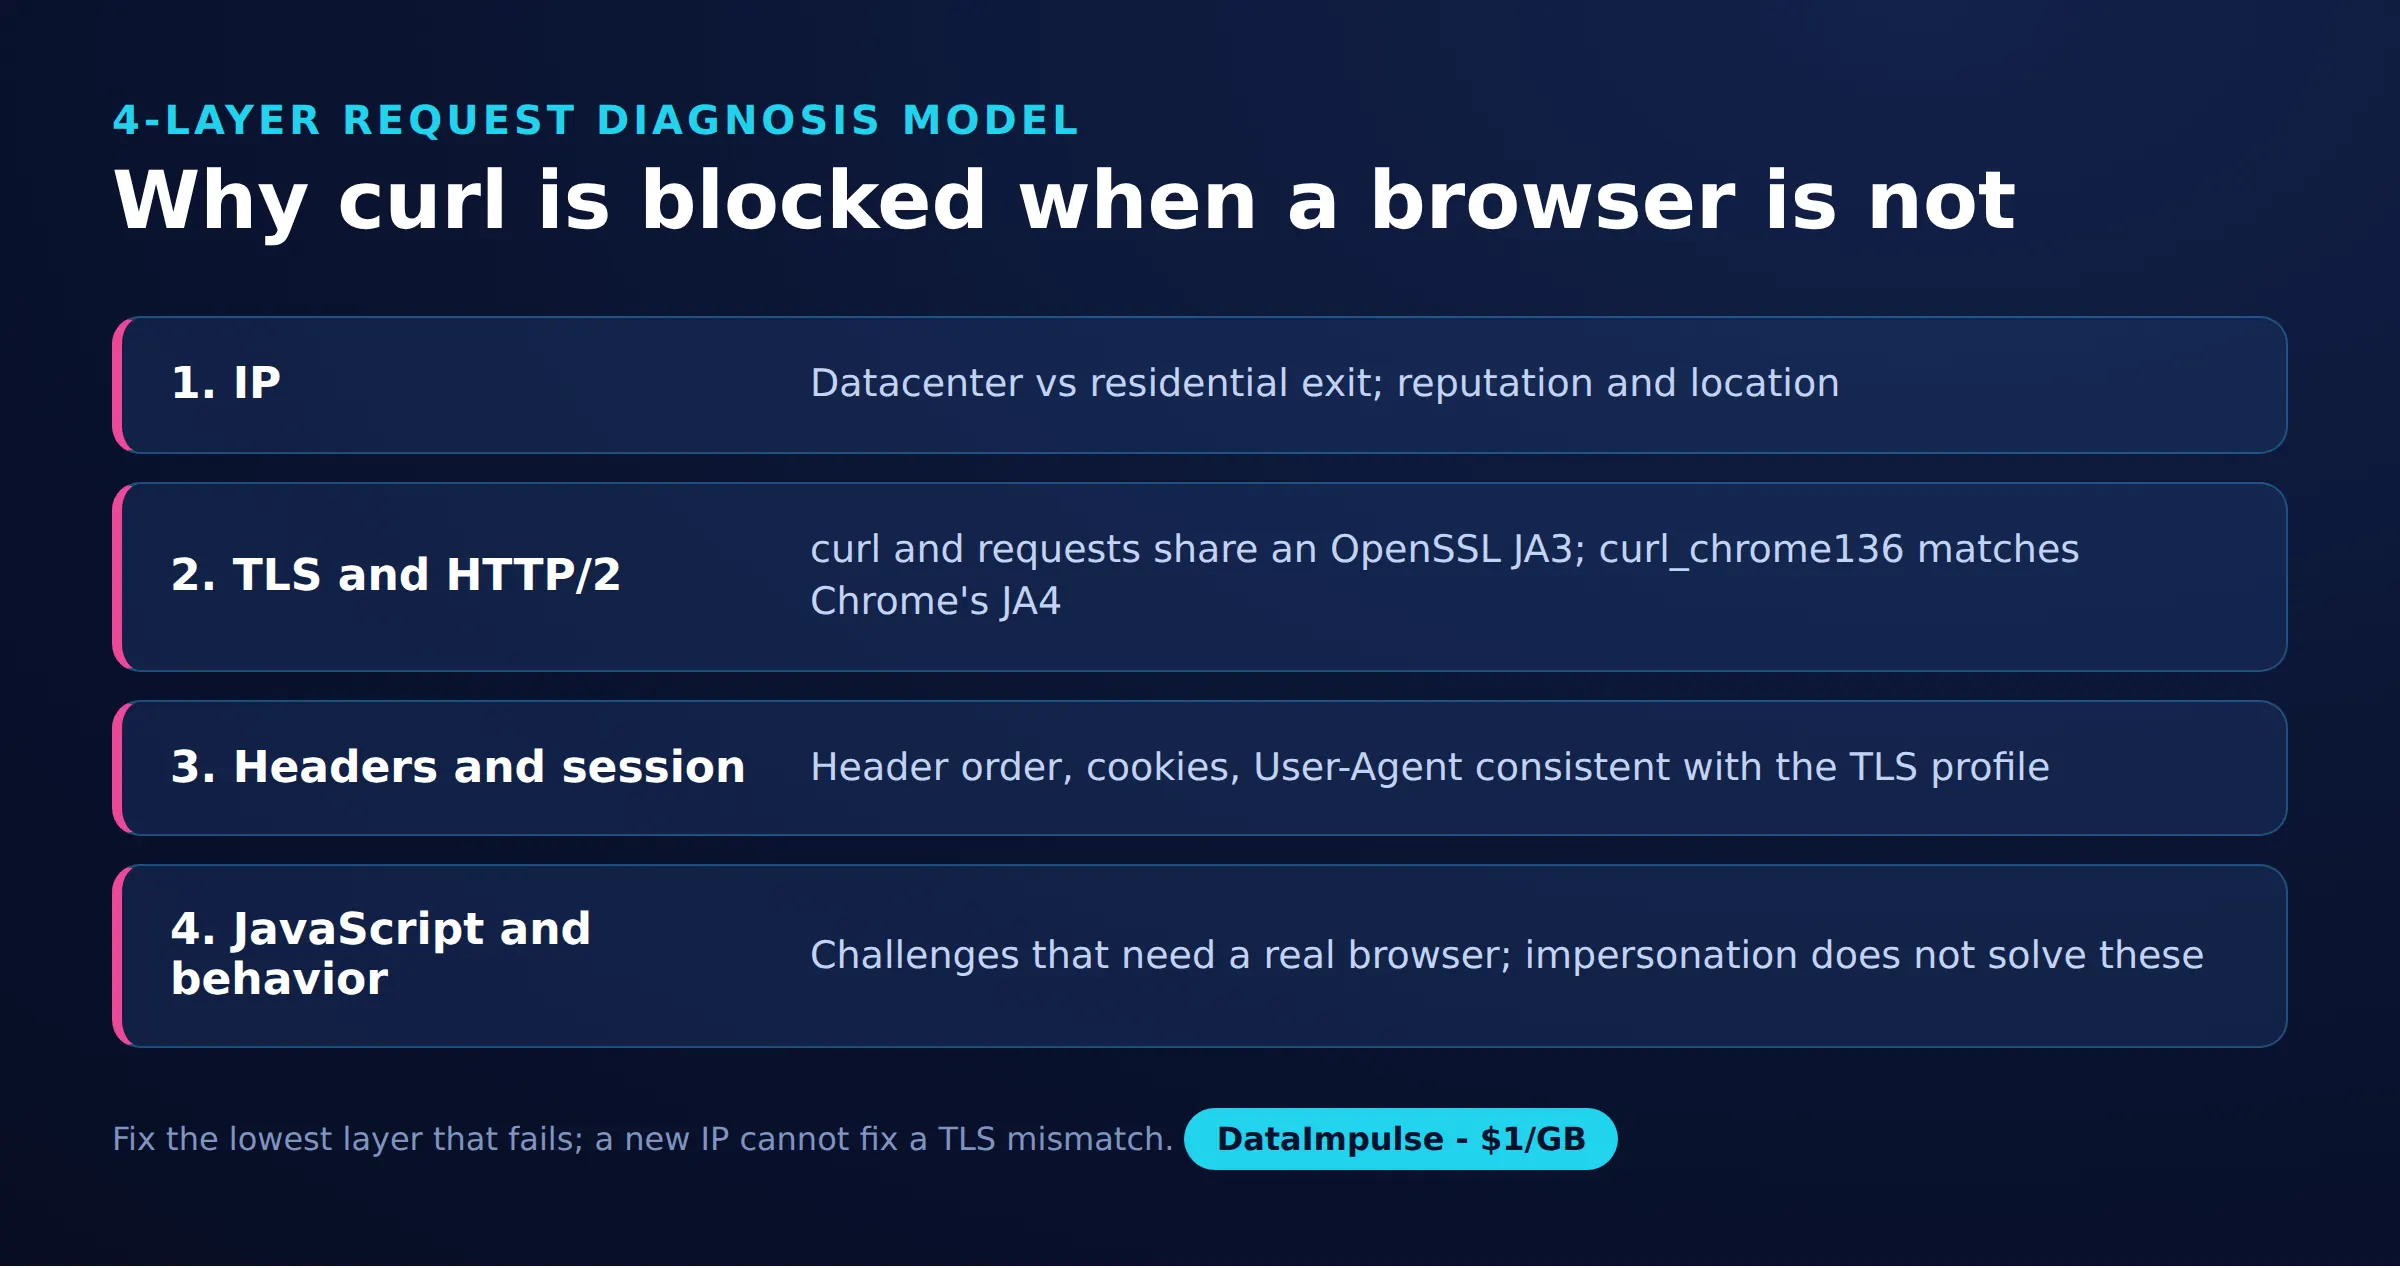
- Capa 1: IP y ruta. Mantenga constante el cliente mientras compara el acceso directo y el acceso con proxy. Registre el país, la estabilidad de la salida y si el fallo ocurre antes de que llegue una respuesta HTTP.
- Capa 2: TLS y HTTP/2. Mantenga constante la ruta mientras compara solicitudes habituales y con impersonación. Compruebe las huellas que observa el endpoint en lugar de fiarse de la cadena del User-Agent.
- Capa 3: cabeceras y sesión. Compare redirecciones, cookies, la URL solicitada y el formato de respuesta esperado. Inspeccione el cuerpo: un estado HTTP correcto puede acompañar a una respuesta de aplicación fallida.
- Capa 4: JavaScript y comportamiento. Determine si los datos aparecen solo tras ejecutar la página o interactuar con ella. Los desafíos de nuestras páginas de producto siguieron sin resolverse tras la impersonación del transporte.
Registre en cada comparación el estado, el destino de la redirección, el tipo de contenido, el tamaño de la respuesta y un marcador de contenido. La documentación de curl sobre scripting HTTP explica la inspección de respuestas, las redirecciones, las cookies y los diagnósticos detallados. Elimine los secretos antes de conservar los registros.
No trate cada denegación como un problema de huella. Una URL incorrecta, un estado de sesión ausente o una regla de la aplicación pueden persistir tras un cambio de transporte. En su propio servicio, correlacione las observaciones del cliente con los registros del servidor. En servicios externos, deje de reintentar contra los desafíos y reevalúe la ruta de acceso permitida.
¿Cuándo elegir curl-impersonate en lugar de Playwright o Selenium?
Elija la impersonación de transporte cuando una respuesta HTTP contenga todo lo que necesita la tarea. Elija la automatización de navegador cuando el renderizado o la interacción sean esenciales, y mida su coste operativo en su propia carga de trabajo.
| Cliente | Use X cuando… | Evite X cuando… |
|---|---|---|
| curl estándar | Use curl estándar cuando baste con HTTP normal. | Evite curl estándar cuando importe una discrepancia de huella verificada. |
| curl-impersonate | Use curl-impersonate cuando un transporte similar al de un navegador se ajuste a la tarea. | Evite curl-impersonate cuando sea necesaria la ejecución de JavaScript. |
| Playwright/Selenium | Use Playwright/Selenium cuando el renderizado o la interacción sean esenciales. | Evite Playwright/Selenium cuando un HTTP sencillo cumpla los requisitos. |
La documentación de red de Playwright explica cómo observar las solicitudes del navegador; la descripción general de Selenium trata la automatización de navegadores. Un navegador añade trabajo de ciclo de vida de la página y de carga de recursos. Nuestra prueba no midió ni la CPU ni la latencia, por lo que no establece ninguna ventaja de velocidad ni de escalado.
APIRequestContext de Playwright envía solicitudes de API y puede compartir cookies con un contexto de navegador. No equivale a navegar con una página de navegador; no dé por hecho que compartir cookies establece un comportamiento de transporte idéntico.
La automatización de navegadores también tiene límites. La documentación de entornos compatibles de Cloudflare excluye a los navegadores automatizados del soporte para resolver desafíos en producción (a octubre de 2026). Cambiar de herramienta no es una solución universal para los desafíos.
¿Qué mostró nuestra pequeña prueba con páginas públicas?
Nuestra prueba rápida del 16 de octubre de 2026 recuperó contenido de búsqueda con impersonación, mientras que las solicitudes habituales recibieron desafíos. Los fallos en las páginas de producto mostraron el límite de generalizar a partir de ese éxito.
Método y muestra: Andrii comparó ocho configuraciones de cliente y perfil en el endpoint de inspección TLS: requests 2.x, el curl del sistema, cuatro perfiles de curl_cffi, Playwright Chromium y curl_chrome136. La muestra de la aplicación comprendió cuatro combinaciones de cliente Python y ruta, y dos resultados de búsqueda por CLI, además de comprobaciones exploratorias en páginas de producto. Son observaciones registradas, no tasas de éxito de pruebas repetidas.
El endpoint de huellas fue https://tls.peet.ws/api/all. Los perfiles de Python fueron chrome, chrome131, safari y firefox. Las solicitudes habituales y el curl del sistema compartieron el JA3 0149f47eabf9a20d0893e2a44e5a6323, aunque requests usó HTTP/1.1 y el curl del sistema usó h2. Solo eso muestra por qué un único hash TLS no puede resumir toda la conexión.
| Cliente Python | Ruta | Estado | Tamaño registrado | Clasificación del cuerpo |
|---|---|---|---|---|
| requests | Directa | 200 | 15 KB | Desafío de PerimeterX |
| requests | Residencial | 200 | 15 KB | Desafío de PerimeterX |
| curl_cffi chrome | Directa | 200 | 1321 KB | Contenido |
| curl_cffi chrome | Residencial | 200 | 1392 KB | Contenido |
La comparación por CLI usó el mismo proxy residencial de DataImpulse de EE. UU. y un User-Agent de Chrome. El curl simple recibió una redirección 307 hacia una página bloqueada con la etiqueta “Robot or human?”. La solicitud de curl_chrome136 devolvió 200, unos 176 KB transferidos comprimidos y HTML con el JSON de producto de __NEXT_DATA__.
Las páginas de producto de Walmart siguieron desafiando a curl_cffi. Una página de producto de Sephora devolvió un desafío de JavaScript y de comportamiento de Akamai a través de acceso residencial. Estos fallos impiden extender el resultado de la página de búsqueda a una afirmación general sobre cualquiera de los dos sitios.
Estimación de tráfico: Con el precio inicial residencial anunciado de $1 por GB, 176 KB corresponden a unos $0,000176 usando unidades decimales. Es un tráfico de respuesta ilustrativo, no una estimación de factura: los bytes de las solicitudes, los reintentos, las reglas de facturación y otras transferencias pueden modificar el total. Para los tamaños de Python no se ha establecido aquí una equivalencia de transferencia comprimida, así que no los compare directamente con la cifra de la CLI.
Esta muestra no incluye distribución de tiempos, número de solicitudes repetidas ni un aislamiento controlado de cada diferencia de cabeceras. Respalda la investigación del transporte, pero no permite atribuir cada diferencia de respuesta únicamente a TLS.
Para repetir esta prueba, registre juntos las versiones exactas de los paquetes, el wrapper seleccionado, la ruta, la clasificación de la respuesta y las unidades de medida. Conserve campos separados para los bytes transferidos y el tamaño del cuerpo decodificado. Repita las comparaciones en condiciones controladas antes de usarlas para planificar la capacidad, y trate un cambio en la plantilla de la página o en la respuesta del desafío como motivo para revalidar el parser.
¿Qué permisos y alternativas debe comprobar?
Confirme que la recopilación prevista está autorizada antes de convertir una solicitud de diagnóstico en una automatización continua. Que una página sea de acceso público no es evidencia suficiente de permiso para cualquier uso.
Revise los términos del sitio, las instrucciones de robots, las políticas de acceso publicadas y las obligaciones aplicables. Mantenga la recopilación acotada, respete los límites indicados y evite los reintentos repetidos contra los desafíos. No reutilice credenciales de inicio de sesión de terceros ni intente eludir los CAPTCHA.
Compruebe si existe una API oficial, una exportación, un feed o un conjunto de datos con licencia antes de mantener una integración frágil con una página. Compare la cobertura de campos, la actualidad, los requisitos de autenticación y la reutilización permitida. Cuando el acceso no esté claro, busque una vía aprobada en lugar de suponer que una respuesta exitosa zanja la cuestión.
Preguntas frecuentes
¿Qué es curl-impersonate?
Es una compilación modificada de curl orientada a handshakes de red similares a los de un navegador. Úselo para investigar diferencias de transporte, y valide por separado el contenido que se devuelve realmente.
¿Por qué puede fallar curl cuando un navegador funciona?
Las dos solicitudes pueden diferir en la ruta, el transporte, el estado de la sesión o la ejecución de la página. En nuestra prueba, un HTTP 200 contenía a veces un desafío, por lo que el estado por sí solo resultó una comprobación de éxito engañosa.
¿Cómo impersona Chrome curl_cffi?
Su parámetro impersonate selecciona un perfil de transporte de navegador. La llamada de Python que probamos seleccionó chrome; conserve la versión del paquete junto a ese alias al documentar una reproducción.
¿Funciona curl-impersonate con proxies?
Nuestra solicitud con curl_chrome136 funcionó a través de un proxy residencial HTTP con autenticación. Trate la conectividad del proxy y la aceptación por parte de la aplicación como comprobaciones separadas, porque una ruta que funciona puede seguir devolviendo un desafío.
¿Cuándo debería usar Playwright en su lugar?
Elija un flujo con navegador cuando el resultado necesario dependa de la ejecución de la página o de la interacción. Confirme primero que los datos deseados no están en la respuesta inicial, y no considere la automatización de navegador como un acceso garantizado.
¿Demuestra la coincidencia de JA4 que una solicitud proviene de un navegador?
No. Nuestros clientes con impersonación compartieron ciertas huellas con Chromium, pero esa observación no dice nada sobre el comportamiento completo de un navegador ni sobre la autorización.
Pruebe la capa de red con una línea base clara
Si su diagnóstico apunta a la ruta de salida, evalúe los proxies residenciales de DataImpulse con el mismo cliente, el mismo perfil y las mismas comprobaciones de contenido. DataImpulse ofrece proxies, no una API de scraping, un unblocker gestionado, una VPN ni datos. Empiece poco a poco y amplíe solo después de confirmar tanto el permiso como la utilidad de las respuestas.
Última actualización: 16 de octubre de 2026.