
Dans cet article
Le terme curl impersonate désigne l’usage de curl-impersonate pour imiter le comportement TLS et HTTP/2 d’un navigateur lors de requêtes HTTP. La documentation du projet d’origine décrit les modifications de transport qui sous-tendent cette approche ; changer uniquement le User-Agent ne les reproduit pas.
Commencez par un contrôle d’empreinte, puis examinez le corps réel de la réponse. Notre test rapide du 16 octobre 2026 a révélé des différences utiles entre les clients ordinaires et les requêtes imitées, tout en laissant apparaître des pages produit qui renvoyaient encore des challenges. Il s’agit d’un petit instantané, pas d’un benchmark ni d’une garantie d’accès.
Points clés
- Python requests et le curl du système ont présenté la même empreinte JA3 OpenSSL lors de notre test.
- curl_cffi avec impersonate=”chrome” et curl_chrome136 ont correspondu exactement à l’empreinte JA4 et HTTP/2 de Chromium 145 réel.
- Avec le même proxy résidentiel et le même User-Agent, le curl standard a été redirigé vers la page de blocage de Walmart ; curl_chrome136 a obtenu la page complète.
- JA3 change d’une version de Chrome à l’autre, car Chrome randomise l’ordre des extensions TLS ; JA4 est le signal le plus stable.
- L’imitation corrige les empreintes TLS et HTTP/2, pas les challenges JavaScript ni comportementaux.
- curl-impersonate v2.2.3 fournit des binaires prêts à l’emploi, comme curl_chrome136 et curl_firefox147.
Qu’est-ce que curl impersonate, et que imite-t-il réellement ?
curl-impersonate est une version modifiée de curl qui vise un comportement de connexion proche de celui d’un navigateur. Son périmètre couvre les handshakes TLS et les paramètres HTTP/2, et non l’environnement d’exécution complet d’un navigateur.
Le projet d’origine est hébergé sous lwthiker ; le binaire que nous avons testé provient du fork lexiforest. La documentation du projet du fork indique qu’il repose sur une version modifiée de BoringSSL. Notez ensemble le dépôt, la version et le profil sélectionné : un nom d’exécutable familier ne suffit pas à établir la provenance.
Voyez l’imitation comme le choix de la manière dont la connexion se présente. Les en-têtes décrivent la requête HTTP, tandis que les paramètres de transport décrivent une autre partie du client. Aucun des deux n’établit qu’un humain a initié la requête. La correspondance de certaines empreintes ne peut pas établir une équivalence complète avec un navigateur.
Pour un workflow curl impersonate, déterminez d’abord si les données nécessaires figurent déjà dans la réponse HTTP. Notre réponse de recherche réussie contenait du JSON produit intégré ; d’autres pages testées présentaient toujours des challenges. Le guide plus large sur le fingerprinting TLS apporte du contexte, mais l’inspection des réponses doit guider les décisions d’implémentation.
Comment installer curl impersonate et exécuter votre première requête ?
Choisissez explicitement la version et l’artefact de la plateforme, puis exécutez son wrapper de navigateur sur un point de terminaison d’empreinte. Notre configuration Linux testée utilisait lexiforest v2.2.3 et le wrapper curl_chrome136.
Étape 1 : ouvrez la version v2.2.3 officielle, sélectionnez l’artefact Linux correspondant à votre architecture et extrayez-le. Suivez la documentation d’installation pour les prérequis d’exécution et de certificats CA.
Étape 2 : conservez le wrapper et ses artefacts associés ensemble. Notre environnement était Linux avec OpenSSL 3.0.13 d’Ubuntu ; le binaire d’imitation s’identifiait comme curl 8.22.0-IMPERSONATE avec BoringSSL. Cette distinction compte lorsque vous le comparez au curl du système.
Étape 3 : depuis le répertoire extrait, exécutez la commande d’empreinte exacte utilisée dans notre instantané :
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
Enregistrez le JA4, la version HTTP et l’empreinte HTTP/2 renvoyés avant de tester un point de terminaison applicatif. Vous obtenez ainsi une base de référence du transport, sans prendre la réponse d’un distributeur pour le test d’empreinte.
Pour Windows ou macOS, utilisez les artefacts de plateforme et les méthodes d’installation documentés par le fork. Sa page des bindings oriente vers les intégrations Python, JavaScript/TypeScript, PHP et Rust. Vérifiez tout paquet Nixpkgs ou wrapper Node par rapport à son amont et à sa version réels ; nos preuves d’installation ne couvrent que Linux.
Comment imiter Chrome en Python avec curl_cffi ?
Utilisez curl_cffi avec le paramètre impersonate et épinglez la version du paquet pour garantir la reproductibilité. Notre implémentation Python utilisait curl_cffi 0.15 avec impersonate=”chrome”.
Le guide de démarrage officiel documente l’installation via pip, les profils de navigateur et une interface proche de requests. Installez la version 0.15 dans un environnement isolé pour reproduire notre sélection de paquets. L’alias générique chrome suit la cible Chrome actuelle de la bibliothèque : une mise à jour peut donc en changer le sens.
Avant d’exécuter cette instruction testée à l’identique, définissez url comme l’URL de recherche publique https://www.walmart.com/search?q=air+fryer et PROXY comme l’URL de votre propre proxy, chargée de façon privée depuis votre environnement. L’instruction dépend de ces deux variables :
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
Inspectez le statut et le HTML de la réponse avant d’extraire des enregistrements. Dans notre réponse de recherche réussie en CLI, la source d’extraction était le JSON produit intégré __NEXT_DATA__. Repérez cet élément script avec un parseur HTML, décodez son JSON et validez les champs attendus avant d’accepter la page comme contenu exploitable.
Le guide de démarrage documente Session pour la persistance des cookies et la réutilisation des connexions. Pour un workflow à requêtes multiples, gardez cohérents la session, le profil et la localisation de sortie visée. Évitez d’associer un profil à des en-têtes de version de navigateur arbitraires copiés depuis une machine sans rapport.
L’authentification auprès du proxy et l’authentification auprès de la destination sont deux sujets distincts. N’utilisez que des identifiants émis pour votre propre service autorisé ; cet exemple de page publique ne nécessite aucune connexion à la destination. Notre guide de conversion de curl vers Python explique comment traduire la structure d’une requête.
En quoi les empreintes JA3 et JA4 diffèrent-elles ?
JA3 conserve l’ordre de certains champs du ClientHello, tandis que JA4 normalise certaines listes avant le hachage. JA4 est donc utile lorsque l’ordre des extensions varie, sans pour autant constituer une identité complète du client.
La spécification JA3 de Salesforce décrit une empreinte construite à partir de la version TLS, des suites de chiffrement, des extensions, des groupes pris en charge et des formats de points. La spécification JA4 de FoxIO trie les suites de chiffrement et les extensions, mais conserve l’ordre des algorithmes de signature. Ne décrivez pas JA4 comme ignorant toutes les différences d’ordre.
Dans notre instantané, curl_cffi chrome et Playwright Chromium 145.0.7632.6 partageaient le JA4 t13d1516h2_8daaf6152771_d8a2da3f94cd et l’empreinte HTTP/2 52d84b11737d980aef856699f885ca86. Leurs valeurs JA3 différaient. Le wrapper curl_chrome136 correspondait à ces mêmes valeurs JA4 et HTTP/2.
Il s’agit de correspondances observées par le serveur au point de mesure, et non d’une preuve que chaque octet du handshake ou chaque comportement applicatif correspondait. Testez via la route réseau prévue et comparez les deux couches de transport. Pour les systèmes que vous exploitez, examinez les preuves côté serveur ; la documentation de Cloudflare sur les empreintes explique comment utiliser ces signaux dans l’analyse du trafic et les règles.
Comment configurer des proxies HTTP, HTTPS et SOCKS ?
Définissez le proxy indépendamment du profil de navigateur. Le schéma de la destination et celui du proxy décrivent des connexions différentes : une destination HTTPS peut donc passer par un proxy HTTP.
Dans l’instruction Python, la clé https du dictionnaire sélectionne les destinations HTTPS ; la valeur identifie le point de terminaison du proxy. Le guide de démarrage de curl_cffi documente des exemples de proxies HTTP et SOCKS. Notre route mesurée utilisait un proxy HTTP avec authentification.
La documentation de curl sur les proxies HTTP explique le tunnel CONNECT pour les destinations HTTPS. Sans interception TLS, le tunnel transporte l’échange chiffré du client et préserve ainsi ses en-têtes côté destination et son handshake TLS. Un proxy HTTPS chiffre en plus la connexion entre le client et le proxy ; consultez la référence officielle de l’option proxy pour connaître les schémas et les paramètres d’authentification pris en charge.
Gardez les secrets du proxy hors des scripts partagés et des sorties de diagnostic. Vérifiez d’abord séparément le point de terminaison, le protocole, le port et l’authentification, puis comparez les réponses applicatives. Un échec de connexion au proxy n’a pas la même valeur de preuve qu’une page de challenge récupérée avec succès.
Pour les séquences avec état, privilégiez une sortie stable pendant le diagnostic. Envisagez la rotation uniquement pour des requêtes indépendantes et autorisées, une fois une base de référence fonctionnelle établie. Changer l’IP et le profil de transport en même temps rend le résultat plus difficile à expliquer.
Notre guide de configuration d’un proxy avec curl couvre la configuration, tandis que le choix de proxies pour curl aide à évaluer les besoins en matière de route. Ni le choix de la route ni l’imitation ne garantissent l’acceptation.
Pourquoi curl est-il encore bloqué alors qu’un navigateur fonctionne ?
Un navigateur et un client HTTP peuvent différer à plusieurs niveaux, même lorsqu’ils demandent la même URL. Utilisez le modèle de diagnostic de requête en 4 couches pour isoler la différence avant de changer d’outil.
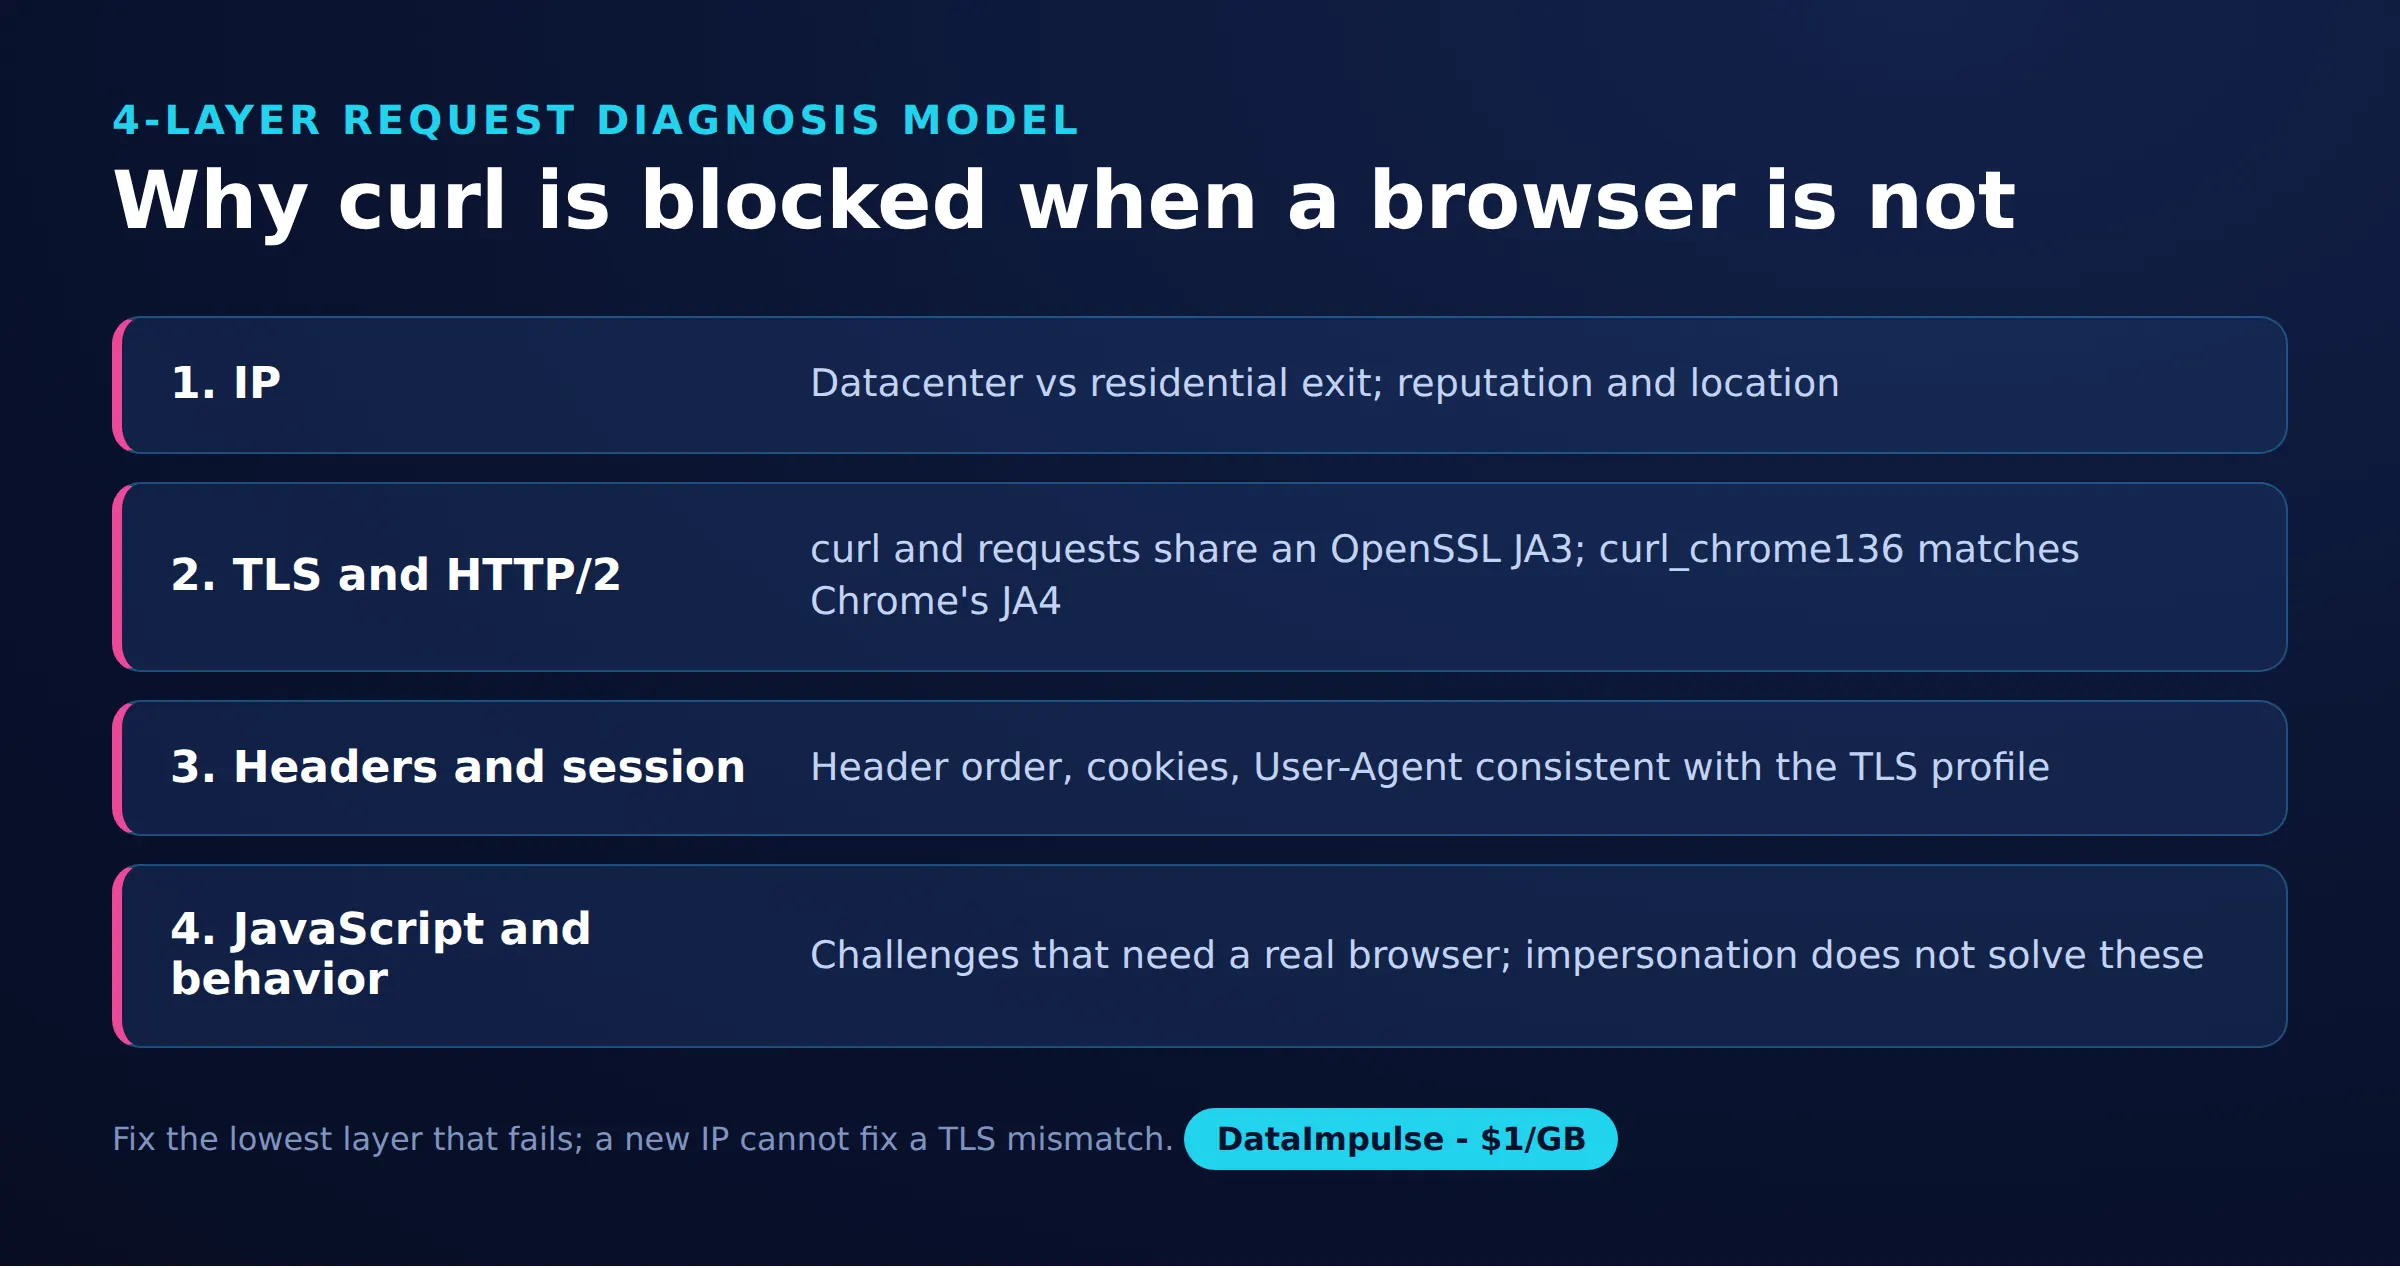
- Couche 1 : IP et route. Gardez le client constant en comparant l’accès direct et l’accès via proxy. Notez le pays, la stabilité de la sortie et si l’échec survient avant l’arrivée d’une réponse HTTP.
- Couche 2 : TLS et HTTP/2. Gardez la route constante en comparant les requêtes ordinaires et imitées. Vérifiez les empreintes observées par le point de terminaison plutôt que de vous fier à la chaîne User-Agent.
- Couche 3 : en-têtes et session. Comparez les redirections, les cookies, l’URL demandée et le format de réponse attendu. Inspectez le corps : un statut HTTP de succès peut accompagner une réponse applicative en échec.
- Couche 4 : JavaScript et comportement. Déterminez si les données n’apparaissent qu’après l’exécution de la page ou une interaction. Les challenges de nos pages produit sont restés non résolus après l’imitation du transport.
Relevez le statut, la destination de redirection, le type de contenu, la taille de la réponse et un marqueur de contenu pour chaque comparaison. La documentation de curl sur le scripting HTTP explique l’inspection des réponses, les redirections, les cookies et les diagnostics détaillés. Supprimez les secrets avant de conserver les journaux.
Ne considérez pas chaque refus comme un problème d’empreinte. Une URL erronée, un état de session manquant ou une règle applicative peuvent survivre à un changement de transport. Sur votre propre service, corrélez les observations du client avec les journaux du serveur. Pour les services externes, cessez de relancer les challenges et réévaluez la route d’accès autorisée.
Quand choisir curl-impersonate plutôt que Playwright ou Selenium ?
Choisissez l’imitation du transport lorsqu’une réponse HTTP contient tout ce dont la tâche a besoin. Choisissez l’automatisation de navigateur lorsque le rendu ou l’interaction est essentiel, et mesurez son coût opérationnel sur votre propre charge de travail.
| Client | Utiliser X quand… | Éviter X quand… |
|---|---|---|
| curl standard | Utilisez curl standard quand du HTTP ordinaire suffit. | Évitez curl standard quand une différence d’empreinte vérifiée est déterminante. |
| curl-impersonate | Utilisez curl-impersonate quand un transport proche de celui d’un navigateur convient à la tâche. | Évitez curl-impersonate quand l’exécution de JavaScript est requise. |
| Playwright/Selenium | Utilisez Playwright/Selenium quand le rendu ou l’interaction est essentiel. | Évitez Playwright/Selenium quand du HTTP simple répond aux besoins. |
La documentation réseau de Playwright explique comment observer les requêtes d’un navigateur ; la présentation de Selenium décrit l’automatisation de navigateur. Un navigateur ajoute le cycle de vie de la page et le chargement des ressources. Notre test n’a mesuré ni le CPU ni la latence : il n’établit donc aucun avantage de vitesse ou de passage à l’échelle.
L’APIRequestContext de Playwright envoie des requêtes API et peut partager des cookies avec un contexte de navigateur. Ce n’est pas équivalent à la navigation d’une page dans un navigateur ; ne supposez pas que le partage de cookies établit un comportement de transport identique.
L’automatisation de navigateur a aussi ses limites. La documentation de Cloudflare sur les environnements pris en charge exclut les navigateurs automatisés de la prise en charge pour la résolution des challenges en production (en date d’octobre 2026). Changer d’outil n’est pas une solution universelle aux challenges.
Que montre notre petit test sur des pages publiques ?
Notre test rapide du 16 octobre 2026 a récupéré du contenu de recherche avec l’imitation, alors que les requêtes ordinaires recevaient des challenges. Les échecs sur les pages produit montrent les limites d’une généralisation à partir de ce succès.
Méthode et échantillon : Andrii a comparé huit configurations client/profil au point de terminaison d’inspection TLS : requests 2.x, curl du système, quatre profils curl_cffi, Playwright Chromium et curl_chrome136. L’échantillon applicatif comprenait quatre combinaisons client Python/route et deux résultats de recherche en CLI, plus des vérifications exploratoires de pages produit. Ce sont des observations consignées, et non des taux de réussite issus d’essais répétés.
Le point de terminaison d’empreinte était https://tls.peet.ws/api/all. Les profils Python étaient chrome, chrome131, safari et firefox. Les requêtes ordinaires et le curl du système partageaient le JA3 0149f47eabf9a20d0893e2a44e5a6323, alors que requests utilisait HTTP/1.1 et le curl du système h2. Cela suffit à montrer pourquoi un seul hachage TLS ne peut pas résumer l’ensemble de la connexion.
| Client Python | Route | Statut | Taille enregistrée | Classification du corps |
|---|---|---|---|---|
| requests | Directe | 200 | 15 KB | Challenge PerimeterX |
| requests | Résidentielle | 200 | 15 KB | Challenge PerimeterX |
| curl_cffi chrome | Directe | 200 | 1321 KB | Contenu |
| curl_cffi chrome | Résidentielle | 200 | 1392 KB | Contenu |
La comparaison en CLI utilisait le même proxy résidentiel américain DataImpulse et le même User-Agent Chrome. Le curl standard a reçu une redirection 307 vers une page de blocage intitulée « Robot or human? ». La requête curl_chrome136 a renvoyé un code 200, environ 176 KB transférés en compressé, et du HTML contenant le JSON produit __NEXT_DATA__.
Les pages produit de Walmart ont continué de bloquer curl_cffi. Une page produit de Sephora a renvoyé un challenge JavaScript/comportemental d’Akamai via un accès résidentiel. Ces échecs empêchent d’étendre le résultat de la page de recherche à une affirmation générale sur l’un ou l’autre site.
Estimation du trafic : au tarif résidentiel de départ affiché de 1 $ par GB, 176 KB correspondent à environ 0,000176 $ en unités décimales. Il s’agit d’un trafic de réponse à titre d’illustration, et non d’une estimation de facture : les octets des requêtes, les nouvelles tentatives, les règles de facturation et d’autres transferts peuvent modifier le total. Les tailles Python n’ont ici aucune équivalence établie avec un transfert compressé ; ne les comparez donc pas directement au chiffre du CLI.
Cet instantané ne comporte ni distribution des temps de réponse, ni nombre de requêtes répétées, ni isolation contrôlée de chaque différence d’en-tête. Il justifie d’enquêter sur le transport, pas d’attribuer chaque différence de réponse au seul TLS.
Pour reproduire cet instantané, consignez ensemble les versions exactes des paquets, le wrapper sélectionné, la route, la classification des réponses et les unités de mesure. Conservez des champs distincts pour les octets transférés et la taille du corps décodé. Répétez les comparaisons dans des conditions contrôlées avant de les utiliser pour la planification de capacité, et considérez un changement de modèle de page ou de réponse de challenge comme une raison de revalider le parseur.
Quelles autorisations et quelles alternatives devez-vous vérifier ?
Confirmez que la collecte envisagée est autorisée avant de transformer une requête de diagnostic en automatisation continue. L’accessibilité publique ne suffit pas à prouver qu’une autorisation existe pour tous les usages.
Examinez les conditions d’utilisation du site, les instructions robots, les politiques d’accès publiées et les obligations applicables. Limitez la collecte, respectez les limites indiquées et évitez de relancer sans cesse des requêtes face aux challenges. Ne réutilisez pas d’identifiants de connexion appartenant à des tiers et ne tentez pas de contourner les CAPTCHA.
Cherchez une API officielle, un export, un flux ou un jeu de données sous licence avant de maintenir une intégration de page fragile. Comparez la couverture des champs, la fraîcheur, les exigences d’authentification et la réutilisation autorisée. Lorsque l’accès n’est pas clair, privilégiez une voie approuvée plutôt que de supposer qu’une réponse réussie règle la question.
Questions fréquentes
Qu’est-ce que curl-impersonate ?
C’est une version modifiée de curl qui vise des handshakes réseau proches de ceux d’un navigateur. Utilisez-le pour étudier les différences de transport, tout en validant séparément le contenu réellement renvoyé.
Pourquoi curl peut-il échouer alors qu’un navigateur réussit ?
Les deux requêtes peuvent différer par la route, le transport, l’état de session ou l’exécution de la page. Lors de notre test, un code HTTP 200 contenait parfois un challenge : le statut seul était donc un indicateur de succès trompeur.
Comment curl_cffi imite-t-il Chrome ?
Son paramètre impersonate sélectionne un profil de transport de navigateur. Notre appel Python testé sélectionnait chrome ; conservez la version du paquet avec cet alias lorsque vous documentez une reproduction.
curl-impersonate fonctionne-t-il avec des proxies ?
Notre requête curl_chrome136 a fonctionné via un proxy résidentiel HTTP authentifié. Traitez la connectivité du proxy et l’acceptation par l’application comme deux vérifications distinctes, car une route fonctionnelle peut tout de même renvoyer un challenge.
Quand utiliser Playwright à la place ?
Choisissez un workflow de navigateur lorsque le résultat attendu dépend de l’exécution de la page ou d’une interaction. Confirmez d’abord que les données souhaitées sont absentes de la réponse initiale, et ne considérez pas l’automatisation de navigateur comme un accès garanti.
Une correspondance JA4 prouve-t-elle qu’une requête vient d’un navigateur ?
Non. Nos clients imités partageaient certaines empreintes avec Chromium, mais cette observation ne dit rien du comportement complet d’un navigateur ni de l’autorisation.
Testez la couche réseau avec une base de référence claire
Si votre diagnostic pointe vers la route de sortie, évaluez les proxies résidentiels DataImpulse avec le même client, le même profil et les mêmes contrôles de contenu. DataImpulse fournit des proxies, pas une API de scraping, un unblocker géré, un VPN ni des données. Commencez modestement et ne passez à l’échelle qu’après avoir confirmé à la fois l’autorisation et l’obtention de réponses exploitables.
Dernière mise à jour : 16 octobre 2026.