
ในบทความนี้
curl impersonate หมายถึงการใช้ curl-impersonate เพื่อเลียนแบบพฤติกรรม TLS และ HTTP/2 ของเบราว์เซอร์เมื่อส่งคำขอ HTTP เอกสารของโปรเจกต์ต้นฉบับ อธิบายการเปลี่ยนแปลงในชั้น transport ที่อยู่เบื้องหลังแนวทางนี้ ซึ่งการเปลี่ยน User-Agent เพียงอย่างเดียวไม่สามารถทำซ้ำได้
ควรเริ่มจากการตรวจสอบ fingerprint แล้วจึงตรวจเนื้อหาของ response จริง การทดสอบอย่างรวดเร็วของเราเมื่อวันที่ 16 ตุลาคม 2026 พบความแตกต่างที่เป็นประโยชน์ระหว่างไคลเอนต์ทั่วไปกับคำขอที่เลียนแบบเบราว์เซอร์ ขณะที่หน้าสินค้าบางหน้ายังคงตอบกลับเป็น challenge นี่เป็นเพียงภาพรวมจากการทดสอบชุดเล็ก ไม่ใช่ benchmark และไม่ใช่คำรับรองว่าจะเข้าถึงได้
ข้อมูลสำคัญ
- Python requests และ curl ของระบบแสดง fingerprint OpenSSL JA3 เดียวกัน ในการทดสอบของเรา
- curl_cffi ที่ใช้ impersonate=”chrome” และ curl_chrome136 ตรงกับ fingerprint JA4 และ HTTP/2 ของ Chromium 145 จริงทุกประการ
- เมื่อผ่าน residential proxy และ User-Agent เดียวกัน curl ธรรมดาถูกเปลี่ยนเส้นทางไปยังหน้าบล็อกของ Walmart ส่วน curl_chrome136 ได้หน้าเว็บครบถ้วน
- JA3 เปลี่ยนไปตามเวอร์ชันของ Chrome เพราะ Chrome สุ่มลำดับ extension ของ TLS ส่วน JA4 เป็นสัญญาณที่เสถียรกว่า
- การเลียนแบบแก้ได้เฉพาะ fingerprint ของ TLS และ HTTP/2 ไม่ครอบคลุม challenge ด้าน JavaScript หรือพฤติกรรม
- curl-impersonate v2.2.3 มาพร้อมไบนารีที่พร้อมใช้งาน เช่น curl_chrome136 และ curl_firefox147
curl impersonate คืออะไร และเลียนแบบอะไรได้จริง
curl-impersonate คือ curl ที่ถูกดัดแปลงให้มีพฤติกรรมการเชื่อมต่อคล้ายเบราว์เซอร์ ขอบเขตของมันครอบคลุมการทำ TLS handshake และการตั้งค่า HTTP/2 ไม่ใช่สภาพแวดล้อมการทำงานทั้งหมดของเบราว์เซอร์
โปรเจกต์ต้นฉบับอยู่ภายใต้ lwthiker ส่วนไบนารีที่เราทดสอบมาจาก fork ของ lexiforest เอกสารโปรเจกต์ของ fork ระบุว่าใช้ BoringSSL ที่ผ่านการแพตช์เป็นพื้นฐาน ควรบันทึกที่เก็บโค้ด รุ่นที่ปล่อย และโปรไฟล์ที่เลือกไว้ด้วยกัน เพราะชื่อไฟล์ที่คุ้นเคยเพียงอย่างเดียวไม่เพียงพอต่อการยืนยันที่มา
อาจมองการเลียนแบบเป็นการเลือกวิธีที่การเชื่อมต่อแนะนำตัวเอง header อธิบายคำขอ HTTP ส่วนการตั้งค่า transport อธิบายอีกด้านหนึ่งของไคลเอนต์ ทั้งสองอย่างไม่ได้พิสูจน์ว่ามนุษย์เป็นผู้ส่งคำขอ และการที่ fingerprint บางส่วนตรงกันก็ไม่อาจยืนยันว่าเทียบเท่าเบราว์เซอร์อย่างสมบูรณ์
สำหรับขั้นตอนการทำงานด้วย curl impersonate ให้ตรวจก่อนว่าข้อมูลที่ต้องการมีอยู่ใน HTTP response อยู่แล้วหรือไม่ response การค้นหาที่สำเร็จของเรามี JSON ของสินค้าฝังอยู่ ส่วนหน้าอื่นที่ทดสอบยังคงเจอ challenge คู่มือ TLS fingerprinting ที่กว้างกว่านี้ช่วยให้เห็นบริบทเพิ่มเติม แต่การตรวจ response ควรเป็นตัวตัดสินการตัดสินใจในการพัฒนา
ติดตั้ง curl impersonate และรันคำขอแรกอย่างไร
เลือกรุ่นที่ปล่อยและไฟล์สำหรับแพลตฟอร์มให้ชัดเจน จากนั้นรัน wrapper ของเบราว์เซอร์กับ endpoint ตรวจ fingerprint สภาพแวดล้อม Linux ที่เราทดสอบใช้ lexiforest v2.2.3 และ wrapper curl_chrome136
ขั้นตอนที่ 1: เปิด รุ่น v2.2.3 อย่างเป็นทางการ เลือกไฟล์ Linux ที่ตรงกับสถาปัตยกรรมของเครื่อง แล้วแตกไฟล์ จากนั้นทำตาม เอกสารการติดตั้ง เกี่ยวกับข้อกำหนดของ runtime และใบรับรอง CA
ขั้นตอนที่ 2: เก็บ wrapper และไฟล์ประกอบไว้ด้วยกัน สภาพแวดล้อมของเราคือ Linux พร้อม Ubuntu OpenSSL 3.0.13 ส่วนไบนารีที่ใช้เลียนแบบระบุตัวเองว่าเป็น curl 8.22.0-IMPERSONATE พร้อม BoringSSL ความต่างนี้สำคัญเมื่อเปรียบเทียบกับ curl ของระบบ
ขั้นตอนที่ 3: จากไดเรกทอรีที่แตกไฟล์ไว้ ให้รันคำสั่งตรวจ fingerprint ตามที่ใช้ในการทดสอบของเรา:
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
ให้บันทึกค่า JA4 เวอร์ชัน HTTP และ fingerprint ของ HTTP/2 ที่ได้กลับมาก่อนทดสอบ endpoint ของแอปพลิเคชัน วิธีนี้ช่วยสร้างค่าอ้างอิงของ transport โดยไม่ต้องใช้ response ของร้านค้าปลีกเป็นตัวทดสอบ fingerprint
สำหรับ Windows หรือ macOS ให้ใช้ไฟล์ของแพลตฟอร์มนั้นและวิธีติดตั้งตามที่ fork ระบุไว้ หน้า bindings รวบรวมการเชื่อมต่อสำหรับ Python, JavaScript/TypeScript, PHP และ Rust ควรตรวจสอบแพ็กเกจ Nixpkgs หรือ Node wrapper ใด ๆ กับต้นทางและรุ่นที่ปล่อยจริงก่อนใช้งาน หลักฐานการติดตั้งของเราครอบคลุมเฉพาะ Linux เท่านั้น
เลียนแบบ Chrome ใน Python ด้วย curl_cffi อย่างไร
ใช้ curl_cffi พร้อมพารามิเตอร์ impersonate และล็อกเวอร์ชันของแพ็กเกจไว้เพื่อให้ทำซ้ำได้ การทดสอบฝั่ง Python ของเราใช้ curl_cffi 0.15 กับ impersonate=”chrome”
คู่มือเริ่มต้นฉบับทางการ อธิบายการติดตั้งผ่าน pip โปรไฟล์เบราว์เซอร์ และอินเทอร์เฟซที่คล้าย requests ให้ติดตั้งเวอร์ชัน 0.15 ในสภาพแวดล้อมแยกเฉพาะ เพื่อทำซ้ำการเลือกแพ็กเกจแบบเดียวกับเรา alias chrome แบบทั่วไปจะอ้างอิง Chrome เวอร์ชันปัจจุบันของไลบรารี ดังนั้นการอัปเกรดอาจเปลี่ยนความหมายของมันได้
ก่อนรันโค้ดที่ทดสอบแล้วนี้ ให้กำหนด url เป็น URL ค้นหาสาธารณะ https://www.walmart.com/search?q=air+fryer และกำหนด PROXY เป็น URL ของ proxy ของคุณเอง โดยโหลดจาก environment อย่างเป็นส่วนตัว โค้ดนี้ขึ้นอยู่กับตัวแปรทั้งสองตัวดังกล่าว:
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
ควรตรวจสถานะและ HTML ของ response ก่อนดึงข้อมูล ใน response การค้นหาผ่าน CLI ที่สำเร็จของเรา แหล่งข้อมูลที่ดึงมาคือ JSON ของสินค้าที่ฝังอยู่ใน __NEXT_DATA__ ให้ระบุตำแหน่ง script element นั้นด้วย HTML parser ถอดรหัส JSON และตรวจสอบฟิลด์ที่คาดหวังก่อนยอมรับว่าหน้านั้นเป็นเนื้อหาที่ใช้งานได้
คู่มือเริ่มต้นระบุว่า Session ใช้เก็บ cookie และนำการเชื่อมต่อกลับมาใช้ซ้ำ สำหรับขั้นตอนที่มีหลายคำขอ ควรคงความสอดคล้องของ session โปรไฟล์ และตำแหน่งทางออกที่ตั้งใจไว้ และหลีกเลี่ยงการนำโปรไฟล์ไปผสมกับ header ของเบราว์เซอร์เวอร์ชันใดก็ได้ที่คัดลอกมาจากเครื่องอื่นที่ไม่เกี่ยวข้องกัน
การยืนยันตัวตนกับ proxy และการยืนยันตัวตนกับปลายทางเป็นคนละเรื่องกัน ใช้เฉพาะข้อมูลรับรองที่ออกให้สำหรับบริการที่คุณได้รับอนุญาตเท่านั้น ตัวอย่างหน้าสาธารณะนี้ไม่ต้องล็อกอินที่ปลายทาง คู่มือแปลง curl เป็น Python ของเราอธิบายการแปลงโครงสร้างของคำขอ
fingerprint JA3 และ JA4 แตกต่างกันอย่างไร
JA3 คงลำดับของฟิลด์ที่เลือกใน ClientHello ไว้ ส่วน JA4 จัดรูปแบบรายการที่เลือกให้เป็นมาตรฐานก่อนทำแฮช ทำให้ JA4 มีประโยชน์เมื่อลำดับของ extension เปลี่ยนไป แต่ก็ไม่ได้เป็นตัวตนที่สมบูรณ์ของไคลเอนต์
สเปก JA3 ของ Salesforce อธิบาย fingerprint ที่สร้างจากเวอร์ชัน TLS, ciphers, extensions, supported groups และ point formats ส่วน สเปก JA4 ของ FoxIO เรียงลำดับ ciphers และ extensions แต่คงลำดับของ signature algorithm ไว้ จึงไม่ควรอธิบายว่า JA4 ไม่สนใจความต่างของลำดับทุกกรณี
ในการทดสอบของเรา curl_cffi chrome และ Playwright Chromium 145.0.7632.6 ใช้ JA4 เดียวกันคือ t13d1516h2_8daaf6152771_d8a2da3f94cd และ fingerprint HTTP/2 เดียวกันคือ 52d84b11737d980aef856699f885ca86 แต่ค่า JA3 ต่างกัน ส่วน wrapper curl_chrome136 ให้ค่า JA4 และ HTTP/2 ตรงกับชุดเดียวกันนี้
ผลที่ตรงกันนี้เป็นสิ่งที่เซิร์ฟเวอร์สังเกตเห็นที่ endpoint วัดผลเท่านั้น ไม่ได้พิสูจน์ว่าทุกไบต์ของ handshake หรือพฤติกรรมของแอปพลิเคชันตรงกัน ควรทดสอบผ่านเส้นทางเครือข่ายที่ตั้งใจจะใช้ และเปรียบเทียบทั้งสองชั้นของ transport สำหรับระบบที่คุณดูแลเอง ให้ตรวจหลักฐานฝั่งเซิร์ฟเวอร์ เอกสาร fingerprint ของ Cloudflare อธิบายการใช้สัญญาณเหล่านี้ในการวิเคราะห์ทราฟฟิกและการเขียนกฎ
ตั้งค่า proxy แบบ HTTP, HTTPS และ SOCKS อย่างไร
ให้ตั้งค่า proxy แยกจากโปรไฟล์เบราว์เซอร์ scheme ของปลายทางและ scheme ของ proxy อธิบายการเชื่อมต่อคนละเส้น ดังนั้นปลายทาง HTTPS จึงใช้ proxy แบบ HTTP ได้
ในโค้ด Python คีย์ https ของ dictionary ใช้เลือกปลายทางแบบ HTTPS ส่วนค่าของคีย์ระบุ endpoint ของ proxy คู่มือเริ่มต้นของ curl_cffi มีตัวอย่าง proxy แบบ HTTP และ SOCKS เส้นทางที่เราวัดผลใช้ proxy แบบ HTTP ที่มีการยืนยันตัวตน
เอกสาร HTTP proxy ของ curl อธิบายการทำ CONNECT tunneling สำหรับปลายทาง HTTPS หากไม่มีการดักจับ TLS อุโมงค์นี้จะส่งผ่านการแลกเปลี่ยนข้อมูลที่เข้ารหัสของไคลเอนต์ ทำให้ header ที่ส่งไปยังปลายทางและ TLS handshake คงอยู่ตามเดิม ส่วน proxy แบบ HTTPS จะเข้ารหัสการเชื่อมต่อระหว่างไคลเอนต์กับ proxy เพิ่มอีกชั้น โปรดดู เอกสารอ้างอิงตัวเลือก proxy อย่างเป็นทางการ สำหรับ scheme ที่รองรับและการตั้งค่าการยืนยันตัวตน
ควรเก็บข้อมูลลับของ proxy ไว้นอกสคริปต์ที่แชร์และนอกเอาต์พุตสำหรับวิเคราะห์ปัญหา เริ่มจากตรวจสอบ endpoint โปรโตคอล พอร์ต และการยืนยันตัวตนแยกกันก่อน แล้วจึงเปรียบเทียบ response ของแอปพลิเคชัน การเชื่อมต่อ proxy ล้มเหลวเป็นหลักฐานคนละอย่างกับการดึงหน้า challenge กลับมาได้สำเร็จ
สำหรับลำดับคำขอที่ต้องมีสถานะต่อเนื่อง ควรใช้ทางออกที่คงที่ระหว่างการวิเคราะห์ปัญหา และพิจารณาการหมุนเวียน IP สำหรับคำขอที่เป็นอิสระต่อกันและได้รับอนุญาตเท่านั้น หลังจากได้ค่าอ้างอิงที่ใช้งานได้แล้ว การเปลี่ยน IP และโปรไฟล์ transport พร้อมกันจะทำให้อธิบายผลลัพธ์ได้ยากขึ้น
คู่มือตั้งค่า proxy สำหรับ curl ของเราครอบคลุมเรื่องการตั้งค่า ส่วน การเลือก proxy สำหรับ curl ช่วยประเมินข้อกำหนดของเส้นทาง ทั้งการเลือกเส้นทางและการเลียนแบบไม่ได้รับประกันว่าจะถูกยอมรับ
ทำไม curl ยังถูกบล็อกทั้งที่เบราว์เซอร์ใช้ได้
เบราว์เซอร์กับ HTTP client อาจต่างกันได้หลายชั้น แม้จะขอ URL เดียวกัน ใช้ โมเดลวิเคราะห์คำขอ 4 ชั้น เพื่อแยกให้เห็นความต่างก่อนเปลี่ยนเครื่องมือ
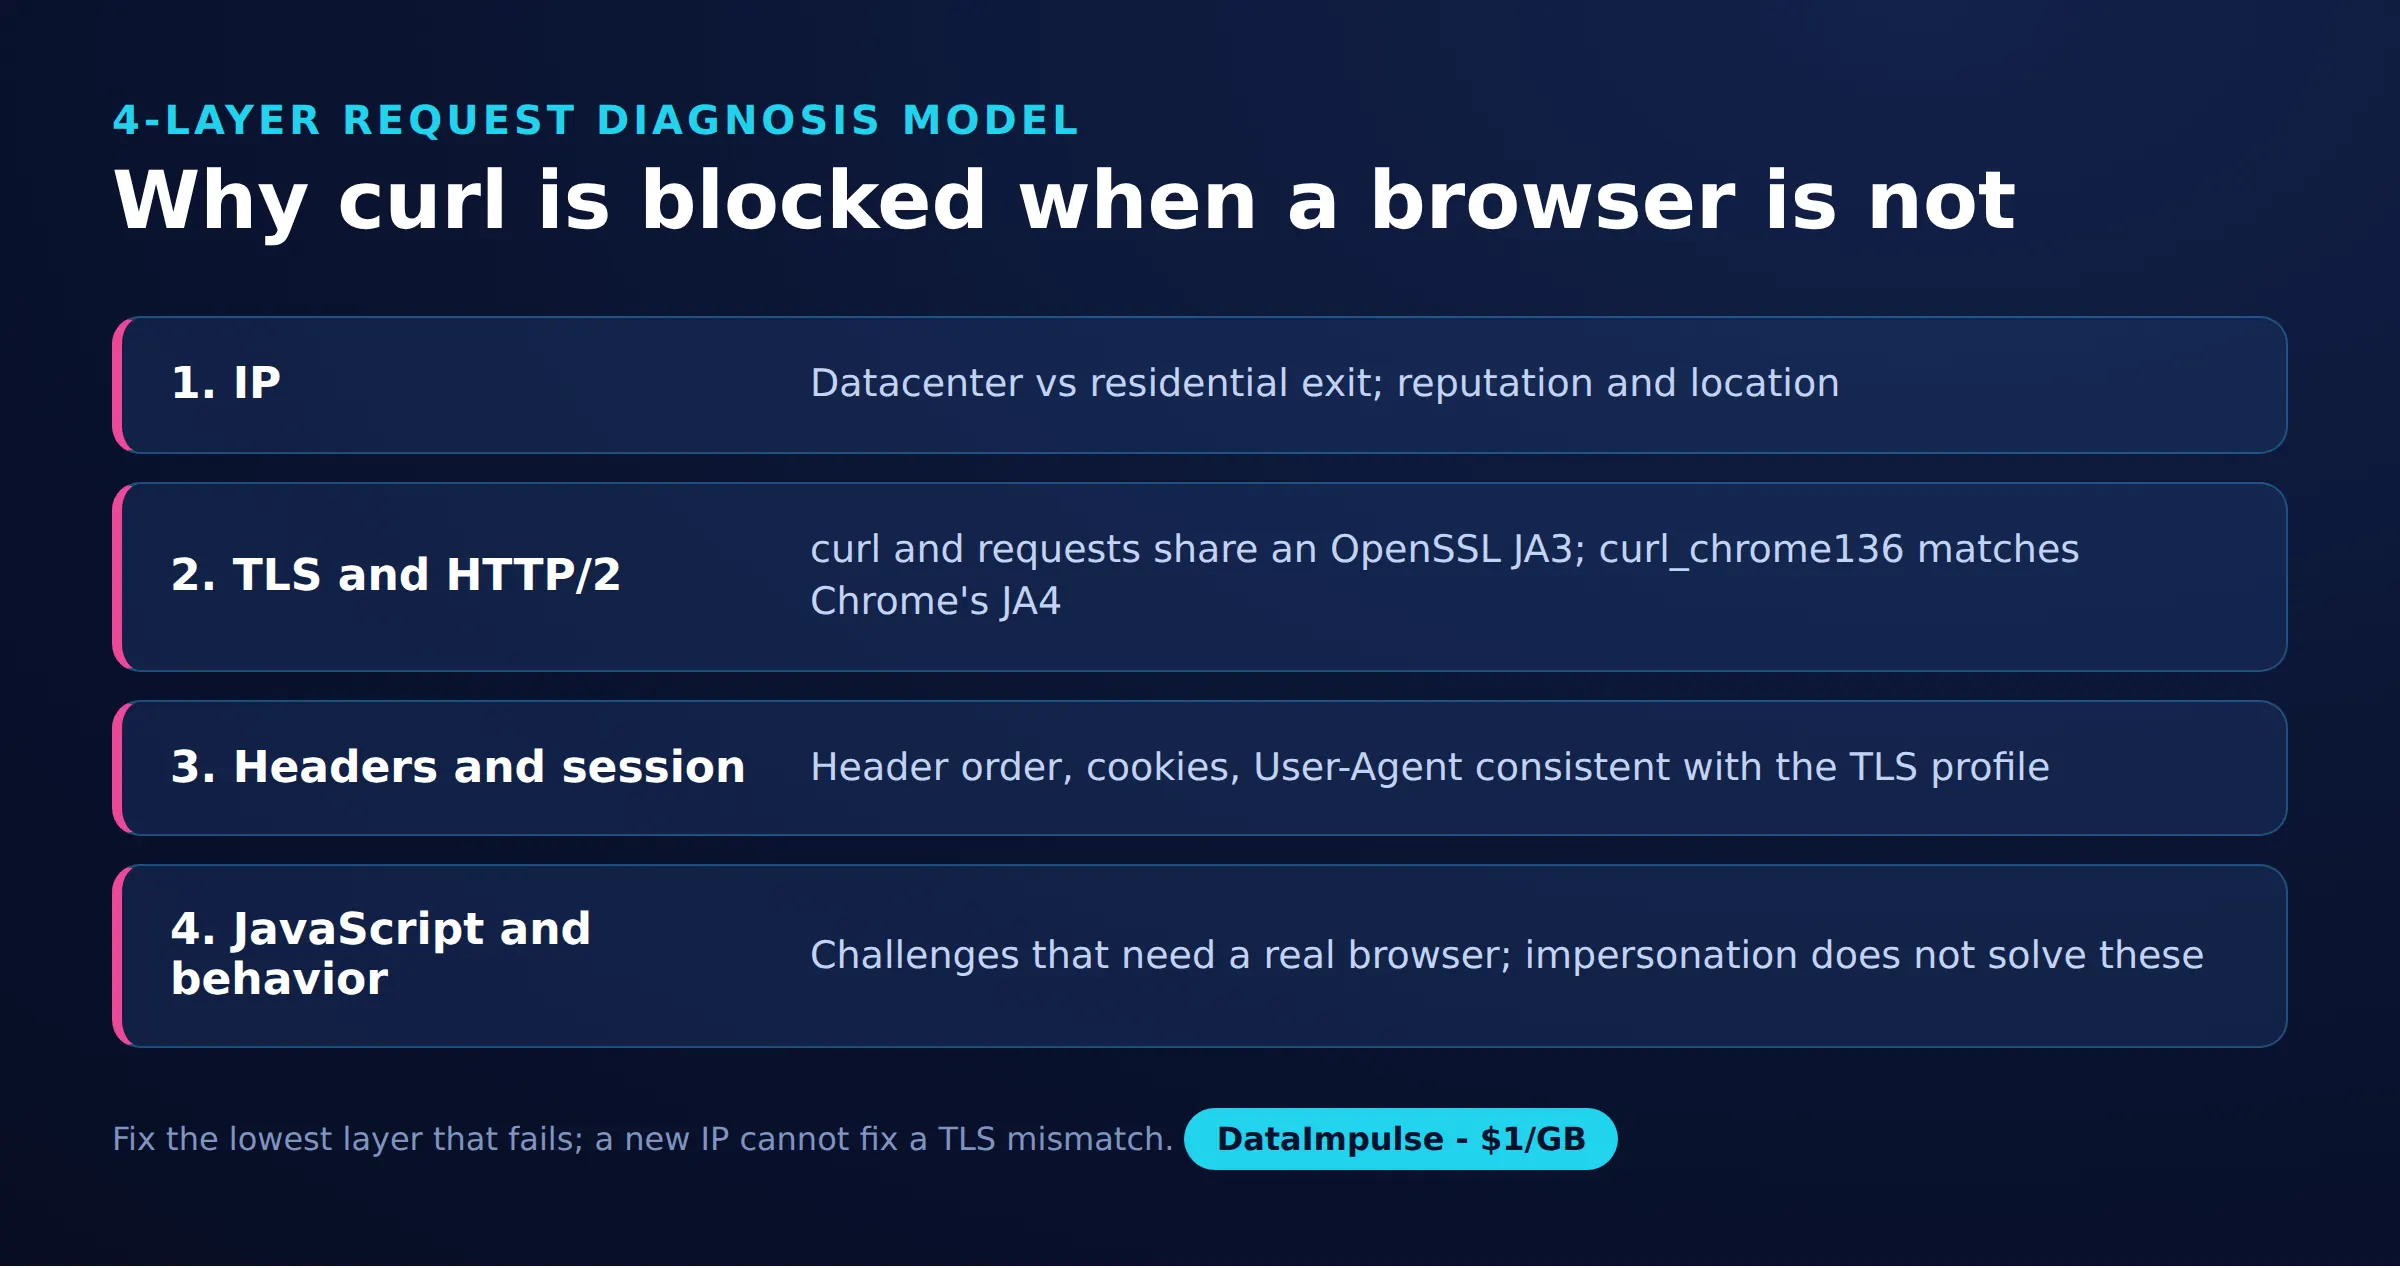
- ชั้นที่ 1: IP และเส้นทาง คงไคลเอนต์ไว้เหมือนเดิมขณะเปรียบเทียบการเข้าถึงโดยตรงกับผ่าน proxy บันทึกประเทศ ความเสถียรของทางออก และดูว่าความล้มเหลวเกิดขึ้นก่อนที่ HTTP response จะมาถึงหรือไม่
- ชั้นที่ 2: TLS และ HTTP/2 คงเส้นทางไว้เหมือนเดิมขณะเปรียบเทียบคำขอทั่วไปกับคำขอที่เลียนแบบ ตรวจ fingerprint ที่ endpoint สังเกตได้จริง แทนที่จะเชื่อสตริง User-Agent
- ชั้นที่ 3: header และ session เปรียบเทียบการเปลี่ยนเส้นทาง cookie URL ที่ขอ และรูปแบบ response ที่คาดหวัง ตรวจเนื้อหาด้วย เพราะสถานะ HTTP ที่สำเร็จอาจมาพร้อมกับ response ของแอปพลิเคชันที่ไม่สำเร็จ
- ชั้นที่ 4: JavaScript และพฤติกรรม พิจารณาว่าข้อมูลปรากฏหลังจากมีการรันหน้าเว็บหรือมีการโต้ตอบเท่านั้นหรือไม่ challenge ของหน้าสินค้าที่เราทดสอบยังไม่หายไป แม้เลียนแบบในชั้น transport แล้ว
ควรบันทึกสถานะ ปลายทางของการเปลี่ยนเส้นทาง content type ขนาดของ response และตัวบ่งชี้เนื้อหาสำหรับทุกการเปรียบเทียบ เอกสาร HTTP scripting ของ curl อธิบายการตรวจ response การเปลี่ยนเส้นทาง cookie และการวิเคราะห์แบบ verbose ควรลบข้อมูลลับออกก่อนเก็บ log ไว้
อย่าถือว่าการปฏิเสธทุกครั้งเป็นปัญหาด้าน fingerprint URL ที่ผิด สถานะ session ที่ขาดหาย หรือกฎของแอปพลิเคชัน อาจยังคงอยู่แม้เปลี่ยน transport แล้ว สำหรับบริการของคุณเอง ให้นำสิ่งที่ไคลเอนต์สังเกตเห็นมาเทียบกับ log ของเซิร์ฟเวอร์ สำหรับบริการภายนอก ให้หยุดการลองซ้ำกับ challenge แล้วทบทวนเส้นทางการเข้าถึงที่ได้รับอนุญาตอีกครั้ง
ควรเลือก curl-impersonate แทน Playwright หรือ Selenium เมื่อใด
เลือกการเลียนแบบในชั้น transport เมื่อ HTTP response มีทุกอย่างที่งานต้องการ เลือกระบบอัตโนมัติของเบราว์เซอร์เมื่อการเรนเดอร์หรือการโต้ตอบเป็นสิ่งจำเป็น และควรวัดต้นทุนในการใช้งานจริงกับปริมาณงานของคุณเอง
| ไคลเอนต์ | ควรใช้เมื่อ… | ควรหลีกเลี่ยงเมื่อ… |
|---|---|---|
| curl มาตรฐาน | ใช้ curl มาตรฐานเมื่อ HTTP ทั่วไปเพียงพอ | หลีกเลี่ยง curl มาตรฐานเมื่อความไม่ตรงกันของ fingerprint ที่ตรวจสอบแล้วมีผลต่องาน |
| curl-impersonate | ใช้ curl-impersonate เมื่อ transport แบบเบราว์เซอร์เหมาะกับงาน | หลีกเลี่ยง curl-impersonate เมื่อจำเป็นต้องรัน JavaScript |
| Playwright/Selenium | ใช้ Playwright/Selenium เมื่อการเรนเดอร์หรือการโต้ตอบเป็นสิ่งจำเป็น | หลีกเลี่ยง Playwright/Selenium เมื่อ HTTP แบบง่ายตอบโจทย์ได้ |
เอกสารเครือข่ายของ Playwright ครอบคลุมการสังเกตคำขอของเบราว์เซอร์ ส่วน ภาพรวมของ Selenium อธิบายระบบอัตโนมัติของเบราว์เซอร์ เบราว์เซอร์ต้องมีงานเกี่ยวกับวงจรชีวิตของหน้าและการโหลดทรัพยากรเพิ่มเข้ามา การทดสอบของเราไม่ได้วัดทั้ง CPU และ latency จึงไม่ได้ยืนยันข้อได้เปรียบด้านความเร็วหรือการขยายระบบ
APIRequestContext ของ Playwright ส่งคำขอ API และใช้ cookie ร่วมกับ browser context ได้ แต่ไม่เทียบเท่ากับการนำทางหน้าเบราว์เซอร์ จึงไม่ควรสันนิษฐานว่าการใช้ cookie ร่วมกันทำให้พฤติกรรมของ transport เหมือนกัน
ระบบอัตโนมัติของเบราว์เซอร์ก็มีข้อจำกัดเช่นกัน เอกสารสภาพแวดล้อมที่รองรับของ Cloudflare ไม่รวมเบราว์เซอร์อัตโนมัติไว้ในการรองรับการแก้ challenge ในสภาพแวดล้อมจริง (ณ เดือนตุลาคม 2026) การเปลี่ยนเครื่องมือจึงไม่ใช่วิธีแก้ challenge ที่ใช้ได้กับทุกกรณี
การทดสอบหน้าสาธารณะชุดเล็กของเราพบอะไร
การทดสอบอย่างรวดเร็วของเราเมื่อวันที่ 16 ตุลาคม 2026 ดึงเนื้อหาการค้นหาได้เมื่อใช้การเลียนแบบ ขณะที่คำขอทั่วไปได้รับ challenge ส่วนความล้มเหลวของหน้าสินค้าแสดงให้เห็นขีดจำกัดของการสรุปรวมจากความสำเร็จนั้น
วิธีการและกลุ่มตัวอย่าง: Andrii เปรียบเทียบการตั้งค่าไคลเอนต์/โปรไฟล์ 8 แบบที่ endpoint ตรวจ TLS ได้แก่ requests 2.x, curl ของระบบ, โปรไฟล์ curl_cffi 4 แบบ, Playwright Chromium และ curl_chrome136 กลุ่มตัวอย่างของแอปพลิเคชันประกอบด้วยการจับคู่ไคลเอนต์ Python กับเส้นทาง 4 แบบ และผลการค้นหาผ่าน CLI 2 ผลลัพธ์ รวมถึงการตรวจหน้าสินค้าเชิงสำรวจ ทั้งหมดนี้เป็นข้อสังเกตที่บันทึกไว้ ไม่ใช่อัตราความสำเร็จจากการทดลองซ้ำ
endpoint ตรวจ fingerprint คือ https://tls.peet.ws/api/all โปรไฟล์ Python ที่ใช้คือ chrome, chrome131, safari และ firefox requests ทั่วไปกับ curl ของระบบใช้ JA3 เดียวกันคือ 0149f47eabf9a20d0893e2a44e5a6323 แต่ requests ใช้ HTTP/1.1 ส่วน curl ของระบบใช้ h2 เพียงเท่านี้ก็แสดงให้เห็นว่าแฮช TLS ค่าเดียวไม่อาจสรุปการเชื่อมต่อทั้งหมดได้
| ไคลเอนต์ Python | เส้นทาง | สถานะ | ขนาดที่บันทึก | การจัดประเภทเนื้อหา |
|---|---|---|---|---|
| requests | โดยตรง | 200 | 15 KB | challenge ของ PerimeterX |
| requests | Residential | 200 | 15 KB | challenge ของ PerimeterX |
| curl_cffi chrome | โดยตรง | 200 | 1321 KB | เนื้อหา |
| curl_cffi chrome | Residential | 200 | 1392 KB | เนื้อหา |
การเปรียบเทียบผ่าน CLI ใช้ DataImpulse US residential proxy ตัวเดียวกันและ Chrome User-Agent เดียวกัน curl ธรรมดาได้รับการเปลี่ยนเส้นทางแบบ 307 ไปยังหน้าบล็อกที่มีข้อความ “Robot or human?” ส่วนคำขอ curl_chrome136 ได้ 200 โดยมีการโอนถ่ายข้อมูลแบบบีบอัดประมาณ 176 KB และได้ HTML ที่มี JSON ของสินค้าใน __NEXT_DATA__
หน้าสินค้าของ Walmart ยังคงทำให้ curl_cffi เจอ challenge ส่วนหน้าสินค้าของ Sephora ตอบกลับเป็น challenge ด้าน JavaScript/พฤติกรรมของ Akamai ผ่านการเข้าถึงแบบ residential ความล้มเหลวเหล่านี้ทำให้ไม่อาจขยายผลของหน้าค้นหาไปเป็นข้อสรุปทั่วไปเกี่ยวกับเว็บไซต์ใดเว็บไซต์หนึ่งได้
ประมาณการทราฟฟิก: ที่ ราคาเริ่มต้นของ residential ที่ประกาศไว้คือ $1 ต่อ GB ข้อมูล 176 KB คิดเป็นประมาณ $0.000176 เมื่อใช้หน่วยแบบทศนิยม นี่เป็นเพียงตัวอย่างทราฟฟิกของ response ไม่ใช่การประเมินใบแจ้งหนี้ เพราะไบต์ของคำขอ การลองซ้ำ กฎการเรียกเก็บเงิน และการโอนถ่ายข้อมูลอื่น ๆ อาจทำให้ยอดรวมเปลี่ยนไปได้ ขนาดของฝั่ง Python ไม่มีความเทียบเท่ากับการโอนถ่ายแบบบีบอัดที่ยืนยันได้ในที่นี้ จึงไม่ควรนำไปเทียบกับตัวเลขของ CLI โดยตรง
ผลลัพธ์ชุดนี้ไม่มีการกระจายของเวลา จำนวนคำขอซ้ำ หรือการควบคุมแยกความต่างของ header ทุกตัว จึงสนับสนุนการตรวจสอบ transport เท่านั้น ไม่ได้ระบุว่าความต่างของ response ทุกอย่างเกิดจาก TLS เพียงอย่างเดียว
หากต้องการทำซ้ำการทดสอบนี้ ให้บันทึกเวอร์ชันแพ็กเกจที่แน่นอน wrapper ที่เลือก เส้นทาง การจัดประเภท response และหน่วยการวัดไว้ด้วยกัน เก็บฟิลด์สำหรับไบต์ที่โอนถ่ายและขนาดของเนื้อหาที่ถอดรหัสแล้วแยกกัน ควรทำการเปรียบเทียบซ้ำภายใต้เงื่อนไขที่ควบคุมก่อนนำไปใช้วางแผนความจุ และหากเทมเพลตของหน้าหรือ challenge เปลี่ยนไป ให้ถือเป็นเหตุผลในการตรวจสอบ parser ใหม่
ควรตรวจสอบสิทธิ์และทางเลือกอื่นอะไรบ้าง
ก่อนเปลี่ยนคำขอสำหรับวิเคราะห์ปัญหาให้กลายเป็นระบบอัตโนมัติที่ทำงานต่อเนื่อง ให้ยืนยันว่าการเก็บข้อมูลที่ตั้งใจไว้ได้รับอนุญาต การที่หน้าเว็บเข้าถึงได้โดยสาธารณะไม่ใช่หลักฐานที่เพียงพอว่ามีสิทธิ์สำหรับการใช้งานทุกรูปแบบ
ตรวจสอบข้อกำหนดของเว็บไซต์ คำสั่ง robots นโยบายการเข้าถึงที่เผยแพร่ และข้อผูกพันที่เกี่ยวข้อง จำกัดการเก็บข้อมูลให้แคบ เคารพขีดจำกัดที่ระบุไว้ และหลีกเลี่ยงการลองซ้ำกับ challenge อย่าใช้ข้อมูลล็อกอินของบุคคลที่สามซ้ำ และอย่าพยายามหลบเลี่ยง CAPTCHA
ตรวจดูว่ามี API ทางการ การส่งออกข้อมูล ฟีด หรือชุดข้อมูลที่มีใบอนุญาตหรือไม่ ก่อนจะดูแลการเชื่อมต่อกับหน้าเว็บที่เปราะบาง เปรียบเทียบความครอบคลุมของฟิลด์ ความสดใหม่ ข้อกำหนดด้านการยืนยันตัวตน และการนำกลับมาใช้ซ้ำที่ได้รับอนุญาต เมื่อยังไม่ชัดเจนเรื่องการเข้าถึง ให้หาเส้นทางที่ได้รับการอนุมัติ แทนที่จะสันนิษฐานว่า response ที่สำเร็จจะยุติคำถามนี้ได้
คำถามที่พบบ่อย
curl-impersonate คืออะไร
คือ curl ที่ถูกดัดแปลงให้มี handshake ของเครือข่ายคล้ายเบราว์เซอร์ ใช้เพื่อตรวจสอบความแตกต่างของ transport โดยควรตรวจสอบเนื้อหาที่ส่งกลับมาจริงแยกต่างหาก
ทำไม curl อาจล้มเหลวทั้งที่เบราว์เซอร์สำเร็จ
คำขอทั้งสองอาจต่างกันที่เส้นทาง transport สถานะ session หรือการรันหน้าเว็บ ในการทดสอบของเรา HTTP 200 บางครั้งมี challenge อยู่ในเนื้อหา ดังนั้นสถานะเพียงอย่างเดียวจึงเป็นตัวตัดสินความสำเร็จที่ทำให้เข้าใจผิดได้
curl_cffi เลียนแบบ Chrome ได้อย่างไร
พารามิเตอร์ impersonate ใช้เลือกโปรไฟล์ transport ของเบราว์เซอร์ การเรียกใน Python ที่เราทดสอบเลือก chrome ควรเก็บเวอร์ชันของแพ็กเกจไว้คู่กับ alias นั้นเมื่อบันทึกขั้นตอนการทำซ้ำ
curl-impersonate ใช้งานร่วมกับ proxy ได้หรือไม่
คำขอ curl_chrome136 ของเราทำงานได้ผ่าน residential proxy แบบ HTTP ที่มีการยืนยันตัวตน ควรถือว่าการเชื่อมต่อ proxy และการที่แอปพลิเคชันยอมรับคำขอเป็นการตรวจสอบคนละอย่าง เพราะเส้นทางที่ใช้งานได้ก็ยังอาจได้ challenge กลับมา
เมื่อไรควรใช้ Playwright แทน
เลือกขั้นตอนแบบเบราว์เซอร์เมื่อผลลัพธ์ที่ต้องการขึ้นอยู่กับการรันหน้าเว็บหรือการโต้ตอบ ก่อนอื่นให้ยืนยันว่าข้อมูลที่ต้องการไม่มีอยู่ใน response แรก และอย่าถือว่าระบบอัตโนมัติของเบราว์เซอร์รับประกันการเข้าถึง
JA4 ที่ตรงกันพิสูจน์ได้ไหมว่าคำขอมาจากเบราว์เซอร์
ไม่ได้ ไคลเอนต์ที่เลียนแบบของเรามี fingerprint บางส่วนตรงกับ Chromium แต่ข้อสังเกตนี้ไม่ได้บอกอะไรเกี่ยวกับพฤติกรรมของเบราว์เซอร์อย่างสมบูรณ์หรือการได้รับอนุญาต
ทดสอบชั้นเครือข่ายด้วยค่าอ้างอิงที่ชัดเจน
หากผลวิเคราะห์ชี้ไปที่เส้นทางทางออก ให้ลองประเมิน DataImpulse residential proxies ด้วยไคลเอนต์ โปรไฟล์ และการตรวจเนื้อหาแบบเดียวกัน DataImpulse ให้บริการ proxy ไม่ใช่ scraping API, unblocker แบบจัดการให้, VPN หรือข้อมูล เริ่มจากปริมาณน้อย และขยายเมื่อยืนยันแล้วว่าได้รับอนุญาตและได้ response ที่ใช้งานได้เท่านั้น
อัปเดตล่าสุด: 16 ตุลาคม 2026