
Neste artigo
Curl impersonate é o uso do curl-impersonate para imitar o comportamento de TLS e HTTP/2 de um navegador ao fazer requisições HTTP. A documentação do projeto original descreve as mudanças de transporte por trás dessa abordagem; trocar apenas o User-Agent não as reproduz.
Comece com uma verificação de fingerprint e depois inspecione o corpo real da resposta. Nosso teste rápido de 16 de outubro de 2026 encontrou diferenças úteis entre clientes comuns e requisições com impersonation, além de páginas de produto que continuaram retornando desafios. É um pequeno retrato do momento, não um benchmark nem uma promessa de acesso.
Fatos principais
- O Python requests e o curl do sistema apresentaram o mesmo fingerprint JA3 do OpenSSL em nosso teste.
- curl_cffi impersonate=”chrome” e curl_chrome136 coincidiram exatamente com o JA4 e o fingerprint HTTP/2 do Chromium 145 real.
- Pelo mesmo proxy residencial e com o mesmo User-Agent, o curl comum foi redirecionado para a página de bloqueio da Walmart; o curl_chrome136 recebeu a página completa.
- O JA3 muda entre versões do Chrome porque o Chrome randomiza a ordem das extensões TLS; o JA4 é o sinal mais estável.
- O impersonation corrige os fingerprints de TLS e HTTP/2, não desafios de JavaScript nem de comportamento.
- O curl-impersonate v2.2.3 traz binários prontos, como curl_chrome136 e curl_firefox147.
O que é curl impersonate e o que ele realmente imita?
O curl-impersonate é uma versão modificada do curl que busca reproduzir o comportamento de conexão de um navegador. Seu escopo inclui os handshakes TLS e as configurações de HTTP/2, e não o ambiente de execução completo de um navegador.
O projeto original está sob lwthiker; o binário que testamos veio do fork lexiforest. A documentação do projeto do fork indica que ele se baseia em um BoringSSL modificado. Registre juntos o repositório, a versão e o perfil escolhido: o nome familiar de um executável, sozinho, não é prova suficiente de origem.
Pense no impersonation como a escolha de como a conexão se apresenta. Os headers descrevem a requisição HTTP, enquanto as configurações de transporte descrevem outra parte do cliente. Nenhum dos dois comprova que uma pessoa iniciou a requisição. Coincidir alguns fingerprints não basta para estabelecer equivalência completa com um navegador.
Em um fluxo de curl impersonate, primeiro verifique se os dados necessários já existem na resposta HTTP. Nossa resposta de busca bem-sucedida continha JSON de produtos embutido; outras páginas testadas ainda apresentaram desafios. O guia mais amplo sobre TLS fingerprinting traz mais contexto, mas a inspeção da resposta é que deve orientar as decisões de implementação.
Como instalar o curl impersonate e executar sua primeira requisição?
Escolha explicitamente a versão e o artefato da plataforma e depois execute o wrapper de navegador contra um endpoint de fingerprint. Nosso ambiente Linux de teste usou o lexiforest v2.2.3 e o wrapper curl_chrome136.
Passo 1: Abra a versão v2.2.3 oficial, selecione o artefato Linux correspondente à sua arquitetura e extraia-o. Siga a documentação de instalação para os requisitos de runtime e de certificados CA.
Passo 2: Mantenha o wrapper e seus artefatos de apoio juntos. Nosso ambiente era Linux com OpenSSL 3.0.13 do Ubuntu; o binário de impersonation se identificou como curl 8.22.0-IMPERSONATE com BoringSSL. Essa diferença importa ao compará-lo com o curl do sistema.
Passo 3: No diretório extraído, execute o comando de fingerprint exato usado em nosso teste:
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
Salve o JA4, a versão do HTTP e o fingerprint HTTP/2 retornados antes de testar um endpoint de aplicação. Isso cria uma linha de base de transporte sem tratar a resposta de um varejista como teste de fingerprint.
No Windows ou no macOS, use os artefatos de plataforma e os métodos de instalação documentados pelo fork. A página de bindings direciona para as integrações com Python, JavaScript/TypeScript, PHP e Rust. Verifique qualquer pacote do Nixpkgs ou wrapper de Node em relação ao upstream e à versão reais; nossa evidência de instalação cobre apenas Linux.
Como imitar o Chrome em Python com o curl_cffi?
Use o curl_cffi com o parâmetro impersonate e fixe a versão do pacote para garantir reprodutibilidade. Nossa implementação em Python usou o curl_cffi 0.15 com impersonate=”chrome”.
O quick start oficial documenta a instalação via pip, os perfis de navegador e uma interface semelhante à do requests. Instale a versão 0.15 em um ambiente isolado para reproduzir nossa seleção de pacotes. O alias genérico chrome acompanha o alvo Chrome atual da biblioteca, então uma atualização pode mudar seu significado.
Antes de executar este trecho exatamente como testado, defina url como a URL de busca pública https://www.walmart.com/search?q=air+fryer e PROXY como a URL do seu próprio proxy, carregada de forma privada a partir do seu ambiente. O trecho depende dessas duas variáveis:
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
Inspecione o status e o HTML da resposta antes de extrair registros. Em nossa resposta de busca bem-sucedida via CLI, a fonte da extração foi o JSON de produtos embutido em __NEXT_DATA__. Localize esse elemento script com um parser de HTML, decodifique o JSON e valide os campos esperados antes de aceitar a página como conteúdo utilizável.
O quick start documenta o Session para persistência de cookies e reutilização de conexões. Em um fluxo com várias requisições, mantenha consistentes a sessão, o perfil e a localização de saída pretendida. Evite combinar um perfil com headers de versão de navegador arbitrários copiados de uma máquina sem relação.
A autenticação do proxy e a autenticação do destino são questões separadas. Use apenas credenciais emitidas para o seu próprio serviço autorizado; este exemplo com página pública não exige login no destino. Nosso guia de curl para Python mostra como traduzir a estrutura da requisição.
Qual é a diferença entre os fingerprints JA3 e JA4?
O JA3 preserva a ordem de campos selecionados do ClientHello, enquanto o JA4 normaliza listas selecionadas antes de gerar o hash. Isso torna o JA4 útil quando a ordem das extensões varia, sem fazer dele uma identidade completa do cliente.
A especificação JA3 da Salesforce descreve um fingerprint construído a partir da versão do TLS, das cifras, das extensões, dos grupos suportados e dos formatos de ponto. A especificação JA4 da FoxIO ordena cifras e extensões, mas preserva a ordem dos algoritmos de assinatura. Não descreva o JA4 como se ele ignorasse toda diferença de ordem.
Em nosso teste, o curl_cffi chrome e o Chromium 145.0.7632.6 do Playwright compartilharam o JA4 t13d1516h2_8daaf6152771_d8a2da3f94cd e o fingerprint HTTP/2 52d84b11737d980aef856699f885ca86. Seus valores de JA3 foram diferentes. O wrapper curl_chrome136 coincidiu com esses mesmos valores de JA4 e HTTP/2.
São coincidências observadas pelo servidor no endpoint de medição, não prova de que todos os bytes do handshake ou o comportamento da aplicação coincidiram. Teste pela rota de rede pretendida e compare as duas camadas de transporte. Em sistemas que você opera, inspecione as evidências do lado do servidor; a documentação de fingerprint da Cloudflare explica como usar esses sinais na análise de tráfego e em regras.
Como configurar proxies HTTP, HTTPS e SOCKS?
Defina o proxy de forma independente do perfil de navegador. O esquema do destino e o esquema do proxy descrevem conexões diferentes, então um destino HTTPS pode usar um proxy HTTP.
No trecho em Python, a chave https do dicionário seleciona destinos HTTPS; o valor identifica o endpoint do proxy. O quick start do curl_cffi documenta exemplos de proxy HTTP e SOCKS. Nossa rota medida usou um proxy HTTP com autenticação.
A documentação de proxy HTTP do curl explica o tunelamento CONNECT para destinos HTTPS. Sem interceptação de TLS, o túnel carrega a troca criptografada do cliente, preservando seus headers voltados ao destino e o handshake TLS. Um proxy HTTPS também criptografa a conexão entre o cliente e o proxy; consulte a referência oficial da opção de proxy para ver os esquemas e as configurações de autenticação suportados.
Mantenha os segredos do proxy fora de scripts compartilhados e da saída de diagnóstico. Primeiro verifique de forma independente o endpoint, o protocolo, a porta e a autenticação; depois compare as respostas da aplicação. Uma falha de conexão com o proxy é uma evidência diferente de uma página de desafio recuperada com sucesso.
Em sequências com estado, prefira uma saída estável durante o diagnóstico. Considere a rotação apenas para requisições independentes e autorizadas, depois de estabelecer uma linha de base funcional. Mudar o IP e o perfil de transporte ao mesmo tempo torna o resultado mais difícil de explicar.
Nosso guia de configuração de proxy no curl cobre a configuração, enquanto a seleção de proxies para curl ajuda a avaliar os requisitos de rota. Nem a escolha da rota nem o impersonation garantem aceitação.
Por que o curl ainda é bloqueado quando o navegador funciona?
Um navegador e um cliente HTTP podem diferir em várias camadas, mesmo pedindo a mesma URL. Use o modelo de diagnóstico de requisições em 4 camadas para isolar a diferença antes de trocar de ferramenta.
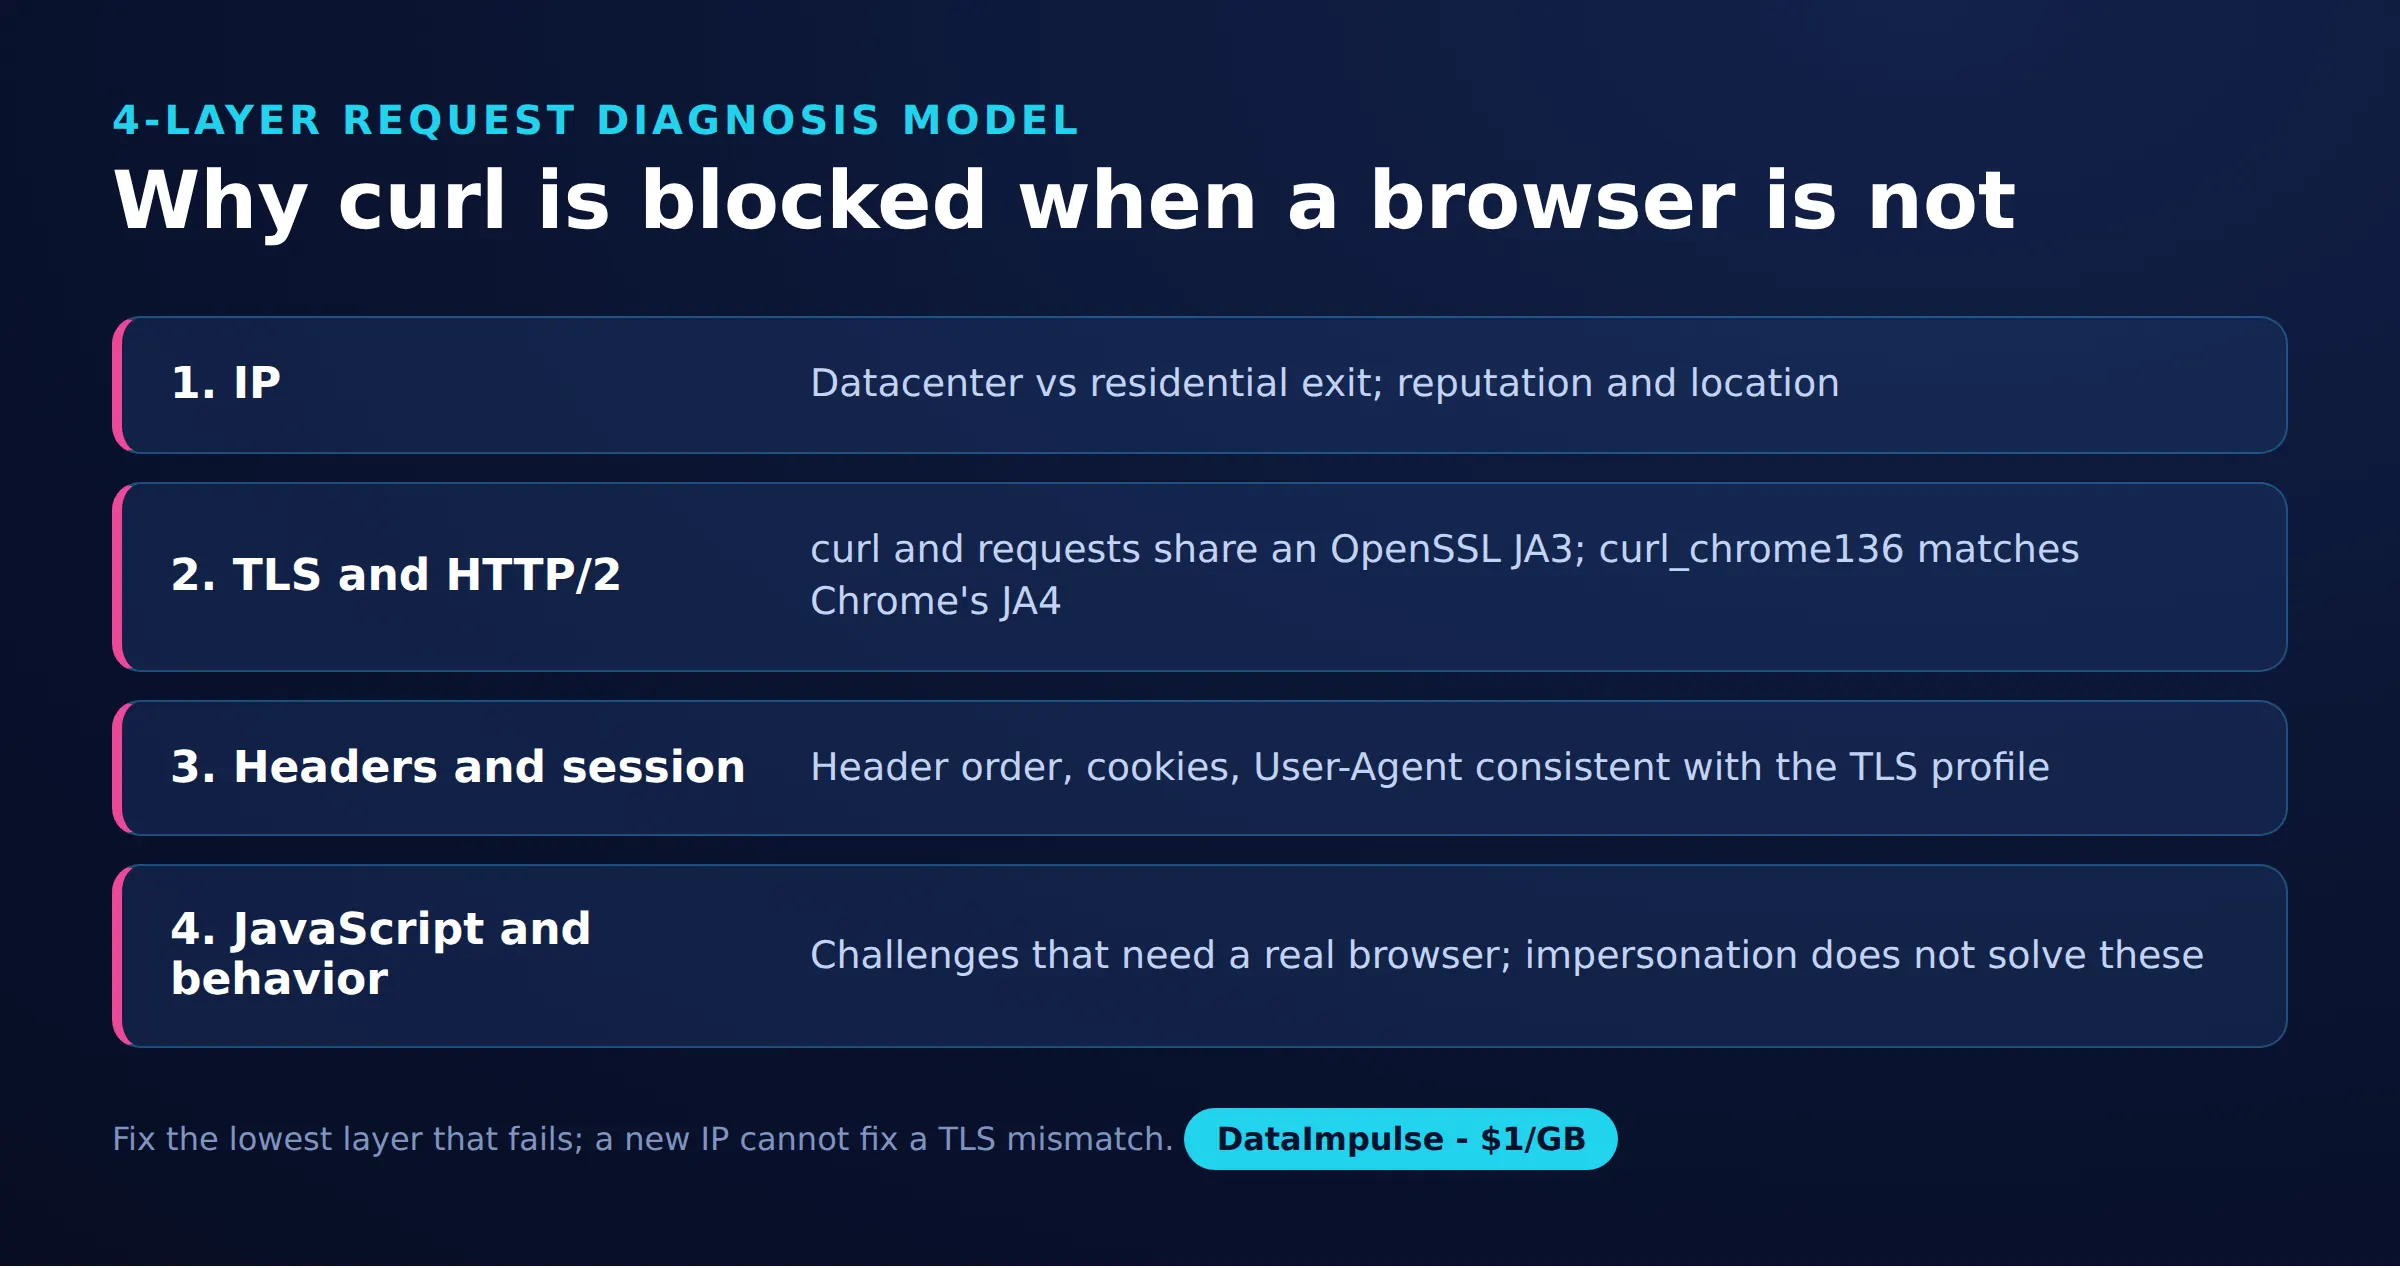
- Camada 1: IP e rota. Mantenha o cliente constante ao comparar o acesso direto e o acesso por proxy. Registre o país, a estabilidade da saída e se a falha ocorre antes de chegar uma resposta HTTP.
- Camada 2: TLS e HTTP/2. Mantenha a rota constante ao comparar requisições comuns e com impersonation. Verifique os fingerprints observados pelo endpoint em vez de confiar na string do User-Agent.
- Camada 3: headers e sessão. Compare redirecionamentos, cookies, a URL solicitada e o formato de resposta esperado. Inspecione o corpo: um status HTTP de sucesso pode acompanhar uma resposta de aplicação malsucedida.
- Camada 4: JavaScript e comportamento. Determine se os dados aparecem somente após a execução da página ou após interação. Os desafios em nossas páginas de produto continuaram sem solução após o impersonation de transporte.
Registre o status, o destino do redirecionamento, o tipo de conteúdo, o tamanho da resposta e um marcador de conteúdo em cada comparação. A documentação de scripts HTTP do curl explica a inspeção de respostas, redirecionamentos, cookies e diagnósticos detalhados. Remova segredos antes de guardar os logs.
Não trate toda negação como um problema de fingerprint. Uma URL errada, a falta de estado de sessão ou uma regra da aplicação podem sobreviver a uma mudança de transporte. No seu próprio serviço, correlacione as observações do cliente com os logs do servidor. Em serviços externos, pare de repetir tentativas contra desafios e reavalie a rota de acesso permitida.
Quando escolher o curl-impersonate em vez de Playwright ou Selenium?
Escolha o impersonation de transporte quando uma resposta HTTP contiver tudo de que a tarefa precisa. Escolha a automação de navegador quando a renderização ou a interação forem essenciais, e meça o custo operacional dela na sua própria carga de trabalho.
| Cliente | Use X quando… | Evite X quando… |
|---|---|---|
| curl padrão | Use o curl padrão quando o HTTP comum bastar. | Evite o curl padrão quando uma divergência de fingerprint verificada for relevante. |
| curl-impersonate | Use o curl-impersonate quando um transporte semelhante ao de um navegador atender à tarefa. | Evite o curl-impersonate quando a execução de JavaScript for necessária. |
| Playwright/Selenium | Use Playwright/Selenium quando a renderização ou a interação forem essenciais. | Evite Playwright/Selenium quando um HTTP simples atender aos requisitos. |
A documentação de rede do Playwright trata da observação de requisições do navegador; a visão geral do Selenium descreve a automação de navegador. Um navegador traz consigo o ciclo de vida da página e o trabalho de carregar recursos. Nosso teste não mediu CPU nem latência, então não estabelece nenhuma vantagem de velocidade ou de escala.
O APIRequestContext do Playwright envia requisições de API e pode compartilhar cookies com um contexto de navegador. Ele não equivale a navegar em uma página com um navegador; não presuma que o compartilhamento de cookies estabeleça um comportamento de transporte idêntico.
A automação de navegador também tem limites. A documentação de ambientes suportados da Cloudflare exclui navegadores automatizados do suporte à resolução de desafios em produção (em outubro de 2026). Trocar de ferramenta não é uma solução universal para desafios.
O que nosso pequeno teste com páginas públicas mostrou?
Nosso teste rápido de 16 de outubro de 2026 recuperou conteúdo de busca com impersonation, enquanto as requisições comuns receberam desafios. As falhas nas páginas de produto mostraram o limite de generalizar a partir desse sucesso.
Método e amostra: Andrii comparou oito configurações de cliente/perfil no endpoint de inspeção de TLS: requests 2.x, curl do sistema, quatro perfis do curl_cffi, Chromium do Playwright e curl_chrome136. A amostra de aplicação compreendeu quatro combinações de cliente Python e rota e dois resultados de busca via CLI, além de verificações exploratórias em páginas de produto. São observações registradas, não taxas de sucesso de testes repetidos.
O endpoint de fingerprint foi https://tls.peet.ws/api/all. Os perfis de Python foram chrome, chrome131, safari e firefox. O requests comum e o curl do sistema compartilharam o JA3 0149f47eabf9a20d0893e2a44e5a6323, enquanto o requests usou HTTP/1.1 e o curl do sistema usou h2. Só isso já mostra por que um único hash de TLS não resume a conexão inteira.
| Cliente Python | Rota | Status | Tamanho registrado | Classificação do corpo |
|---|---|---|---|---|
| requests | Direta | 200 | 15 KB | Desafio PerimeterX |
| requests | Residencial | 200 | 15 KB | Desafio PerimeterX |
| curl_cffi chrome | Direta | 200 | 1321 KB | Conteúdo |
| curl_cffi chrome | Residencial | 200 | 1392 KB | Conteúdo |
A comparação via CLI usou o mesmo proxy residencial dos EUA da DataImpulse e o mesmo User-Agent do Chrome. O curl comum recebeu um redirecionamento 307 para uma página de bloqueio com o título “Robot or human?”. A requisição do curl_chrome136 retornou 200, aproximadamente 176 KB transferidos compactados, e um HTML contendo o JSON de produtos de __NEXT_DATA__.
As páginas de produto da Walmart ainda desafiaram o curl_cffi. Uma página de produto da Sephora retornou um desafio de JavaScript/comportamento da Akamai pelo acesso residencial. Essas falhas impedem estender o resultado da página de busca para uma afirmação geral sobre qualquer um dos dois sites.
Estimativa de tráfego: Ao preço inicial residencial divulgado de $1 por GB, 176 KB correspondem a aproximadamente $0,000176 em unidades decimais. É um tráfego de resposta ilustrativo, não uma estimativa de fatura: bytes de requisição, novas tentativas, regras de cobrança e outras transferências podem alterar o total. Os tamanhos em Python não têm equivalência de transferência compactada estabelecida aqui, então não os compare diretamente com o valor do CLI.
Este teste não tem distribuição de tempos, contagem de requisições repetidas nem isolamento controlado de cada diferença de header. Ele sustenta a investigação do transporte, não a atribuição de todas as diferenças de resposta apenas ao TLS.
Para repetir este teste, registre juntos as versões exatas dos pacotes, o wrapper escolhido, a rota, a classificação da resposta e as unidades de medida. Mantenha campos separados para os bytes transferidos e o tamanho do corpo decodificado. Repita as comparações em condições controladas antes de usá-las no planejamento de capacidade e trate uma mudança no template da página ou na resposta do desafio como motivo para revalidar o parser.
Que permissões e alternativas você deve verificar?
Confirme que a coleta pretendida é autorizada antes de transformar uma requisição de diagnóstico em automação contínua. A acessibilidade pública não é evidência suficiente de permissão para todo uso.
Revise os termos do site, as instruções de robots, as políticas de acesso publicadas e as obrigações aplicáveis. Mantenha a coleta restrita, respeite os limites informados e evite repetir tentativas contra desafios. Não reutilize credenciais de login de terceiros nem tente contornar CAPTCHA.
Verifique se existe uma API oficial, uma exportação, um feed ou um dataset licenciado antes de manter uma integração frágil com páginas. Compare a cobertura de campos, a atualidade, os requisitos de autenticação e a reutilização permitida. Quando o acesso não estiver claro, busque uma rota aprovada em vez de presumir que uma resposta bem-sucedida resolve a questão.
Perguntas frequentes
O que é o curl-impersonate?
É uma versão modificada do curl voltada a handshakes de rede semelhantes aos de um navegador. Use-o para investigar diferenças de transporte, validando separadamente o conteúdo realmente retornado.
Por que o curl pode falhar quando o navegador funciona?
As duas requisições podem diferir em rota, transporte, estado de sessão ou execução da página. Em nosso teste, o HTTP 200 às vezes continha um desafio, então o status sozinho foi uma verificação enganosa de sucesso.
Como o curl_cffi imita o Chrome?
Seu parâmetro impersonate seleciona um perfil de transporte de navegador. Nossa chamada Python testada selecionou chrome; guarde a versão do pacote junto com esse alias ao documentar uma reprodução.
O curl-impersonate funciona com proxies?
Nossa requisição do curl_chrome136 funcionou por um proxy residencial HTTP autenticado. Trate a conectividade do proxy e a aceitação pela aplicação como verificações separadas, porque uma rota funcional ainda pode retornar um desafio.
Quando devo usar o Playwright em vez dele?
Escolha um fluxo com navegador quando o resultado necessário depender da execução da página ou de interação. Primeiro confirme que os dados desejados não estão na resposta inicial e não trate a automação de navegador como acesso garantido.
Coincidir o JA4 prova que uma requisição vem de um navegador?
Não. Nossos clientes com impersonation compartilharam alguns fingerprints com o Chromium, mas essa observação não diz nada sobre o comportamento completo de um navegador nem sobre autorização.
Teste a camada de rede com uma linha de base clara
Se o seu diagnóstico apontar para a rota de saída, avalie os proxies residenciais da DataImpulse com o mesmo cliente, o mesmo perfil e as mesmas verificações de conteúdo. A DataImpulse fornece proxies, não uma API de scraping, um desbloqueador gerenciado, uma VPN nem dados. Comece pequeno e só expanda depois de confirmar tanto a permissão quanto respostas utilizáveis.
Última atualização: 16 de outubro de 2026.