
本文内容
curl impersonate 是指使用 curl-impersonate,在发起 HTTP 请求时模仿浏览器的 TLS 和 HTTP/2 行为。原项目文档介绍了这种做法背后的传输层改动,而仅仅修改 User-Agent 并不能还原这些改动。
建议先做指纹检查,再查看实际的响应正文。我们在 2026 年 10 月 16 日做了一次快速测试,发现普通客户端与伪装请求之间存在有价值的差异,同时部分商品页面仍然返回了验证挑战。这只是一份小规模快照,不是基准测试,也不是对访问成功的承诺。
要点速览
- 在我们的测试中,Python requests 与系统 curl 呈现出相同的 OpenSSL JA3 指纹。
- curl_cffi 的 impersonate=”chrome” 与 curl_chrome136 在 JA4 和 HTTP/2 指纹上与真实的 Chromium 145 完全一致。
- 在同一住宅代理和同一 User-Agent 下,普通 curl 被重定向到 Walmart 的拦截页面,而 curl_chrome136 获取到了完整页面。
- 由于 Chrome 会随机化 TLS 扩展顺序,不同 Chrome 版本之间 JA3 会发生变化,JA4 则是更稳定的信号。
- 伪装只能修正 TLS 和 HTTP/2 指纹,无法应对 JavaScript 或行为类验证挑战。
- curl-impersonate v2.2.3 提供了 curl_chrome136、curl_firefox147 等现成的二进制文件。
什么是 curl impersonate,它究竟模仿了什么?
curl-impersonate 是经过修改的 curl 构建版本,目标是还原类似浏览器的连接行为。它的范围包括 TLS 握手和 HTTP/2 设置,而不是浏览器完整的执行环境。
原项目托管在 lwthiker 名下,而我们测试所用的二进制文件来自 lexiforest 分支。该分支的项目文档说明了其经过修补的 BoringSSL 底层。请把仓库、发行版本和所选配置文件一并记录下来,因为仅凭一个眼熟的可执行文件名,无法确认其来源。
可以把伪装理解为选择连接如何自我介绍。请求头描述的是 HTTP 请求,而传输层设置描述的是客户端的另一个方面。两者都不能证明请求是由真人发起的,匹配部分指纹也无法证明与浏览器完全等同。
在使用 curl impersonate 的工作流中,首先要判断所需数据是否已经存在于 HTTP 响应中。我们成功的搜索响应中包含内嵌的商品 JSON,而其他被测页面仍然出现了验证挑战。更全面的 TLS 指纹指南可以提供更多背景,但实施决策应以对响应的检查结果为准。
如何安装 curl impersonate 并运行第一个请求?
请明确选择发行版本和对应平台的安装包,然后针对指纹检测端点运行其浏览器包装脚本。我们测试的 Linux 环境使用的是 lexiforest v2.2.3 和 curl_chrome136 包装脚本。
第 1 步:打开官方 v2.2.3 发行版页面,选择与您的架构相匹配的 Linux 安装包并解压。运行环境和 CA 证书方面的要求,请参阅安装文档。
第 2 步:请将包装脚本及其配套文件放在一起。我们的环境是 Linux,搭载 Ubuntu OpenSSL 3.0.13,而伪装版二进制文件显示自身为 curl 8.22.0-IMPERSONATE,使用 BoringSSL。与系统 curl 对比时,这一区别很重要。
第 3 步:在解压后的目录中,运行我们快照中使用的指纹检测命令:
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
在测试应用端点之前,请先保存返回的 JA4、HTTP 版本和 HTTP/2 指纹。这样可以建立传输层基线,而不会把零售商网站的响应当作指纹测试本身。
在 Windows 或 macOS 上,请使用该分支文档中列出的对应平台安装包和安装方式。其绑定页面列出了 Python、JavaScript/TypeScript、PHP 和 Rust 的集成方式。对于任何 Nixpkgs 软件包或 Node 封装,请对照其实际的上游和发行版本进行核实。我们的安装验证仅覆盖 Linux。
如何用 curl_cffi 在 Python 中伪装 Chrome?
请使用带有 impersonate 参数的 curl_cffi,并固定软件包版本以便复现。我们的 Python 实现使用的是 curl_cffi 0.15,并设置 impersonate=”chrome”。
官方快速入门介绍了通过 pip 安装、浏览器配置文件以及类似 requests 的接口。请在隔离环境中安装 0.15 版本,以复现我们所选的软件包。通用的 chrome 别名会跟随该库当前的 Chrome 目标版本,因此升级可能改变它的含义。
在运行下面这条经过测试的语句之前,请先将 url 定义为公开搜索网址 https://www.walmart.com/search?q=air+fryer,并将 PROXY 定义为您自己的代理 URL,且从环境变量中私密加载。该语句依赖这两个变量:
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
在提取记录之前,请先检查响应状态和 HTML。在我们成功的 CLI 搜索响应中,数据提取来源是内嵌的 __NEXT_DATA__ 商品 JSON。请用 HTML 解析器定位该 script 元素,解码其中的 JSON,并在确认页面内容可用之前先校验预期字段。
快速入门文档介绍了使用 Session 来保持 Cookie 和复用连接。对于多请求的工作流,请保持会话、配置文件和预期的出口位置一致,并避免把某个配置文件与从无关机器复制来的任意浏览器版本请求头混用。
代理认证与目标站点认证是两回事。请只使用为您自己的授权服务签发的凭据,这个公开页面示例不需要登录目标站点。我们的 curl 转 Python 指南介绍了如何转换请求结构。
JA3 和 JA4 指纹有何区别?
JA3 会保留所选 ClientHello 字段的顺序,而 JA4 在哈希之前会对所选列表进行规范化。因此当扩展顺序发生变化时,JA4 更有用,但它并不能构成完整的客户端身份。
Salesforce 的 JA3 规范描述了一种由 TLS 版本、加密套件、扩展、支持的曲线组和点格式构成的指纹。FoxIO 的 JA4 规范会对加密套件和扩展进行排序,但保留签名算法的顺序。请不要把 JA4 描述为忽略所有顺序差异。
在我们的快照中,curl_cffi chrome 与 Playwright Chromium 145.0.7632.6 的 JA4 均为 t13d1516h2_8daaf6152771_d8a2da3f94cd,HTTP/2 指纹均为 52d84b11737d980aef856699f885ca86,而它们的 JA3 值并不相同。curl_chrome136 包装脚本与这两项 JA4 和 HTTP/2 数值也一致。
这些是测量端点上服务器观察到的匹配结果,并不能证明每个握手字节或应用行为都一致。请通过您实际要使用的网络路由进行测试,并同时比较两个传输层。对于您自己运营的系统,请检查服务端的证据。Cloudflare 的指纹文档介绍了如何在流量分析和规则中使用这些信号。
如何配置 HTTP、HTTPS 和 SOCKS 代理?
请将代理设置与浏览器配置文件分开配置。目标站点的协议与代理的协议描述的是两条不同的连接,因此 HTTPS 目标站点可以使用 HTTP 代理。
在 Python 语句中,字典键 https 用于选择 HTTPS 目标站点,其值则指明代理端点。curl_cffi 快速入门提供了 HTTP 和 SOCKS 代理的示例。我们实测的路由使用的是带认证的 HTTP 代理。
curl 的 HTTP 代理文档介绍了针对 HTTPS 目标站点的 CONNECT 隧道。在不进行 TLS 拦截的情况下,隧道传输的是客户端的加密通信,因此面向目标站点的请求头和 TLS 握手得以保留。HTTPS 代理还会对客户端到代理之间的连接进行加密。至于支持的协议和认证设置,请查阅官方代理选项参考。
请将代理密钥保存在共享脚本和诊断输出之外。先分别验证端点、协议、端口和认证,再比较应用层响应。代理连接失败与成功获取到验证挑战页面,是两种不同的证据。
对于有状态的请求序列,诊断期间建议使用稳定的出口。只有在建立了可用的基线之后,才可以针对独立且已获授权的请求考虑使用轮询。同时更改 IP 和传输层配置文件,会让结果更难解释。
我们的 curl 代理设置指南介绍了具体配置,而 curl 的代理选择有助于评估路由需求。无论是路由选择还是伪装,都不能保证请求一定被接受。
为什么浏览器能访问,curl 却仍然被拦截?
即使请求的是同一个 URL,浏览器与 HTTP 客户端也可能在多个层面存在差异。请在更换工具之前,先使用四层请求诊断模型来定位差异。
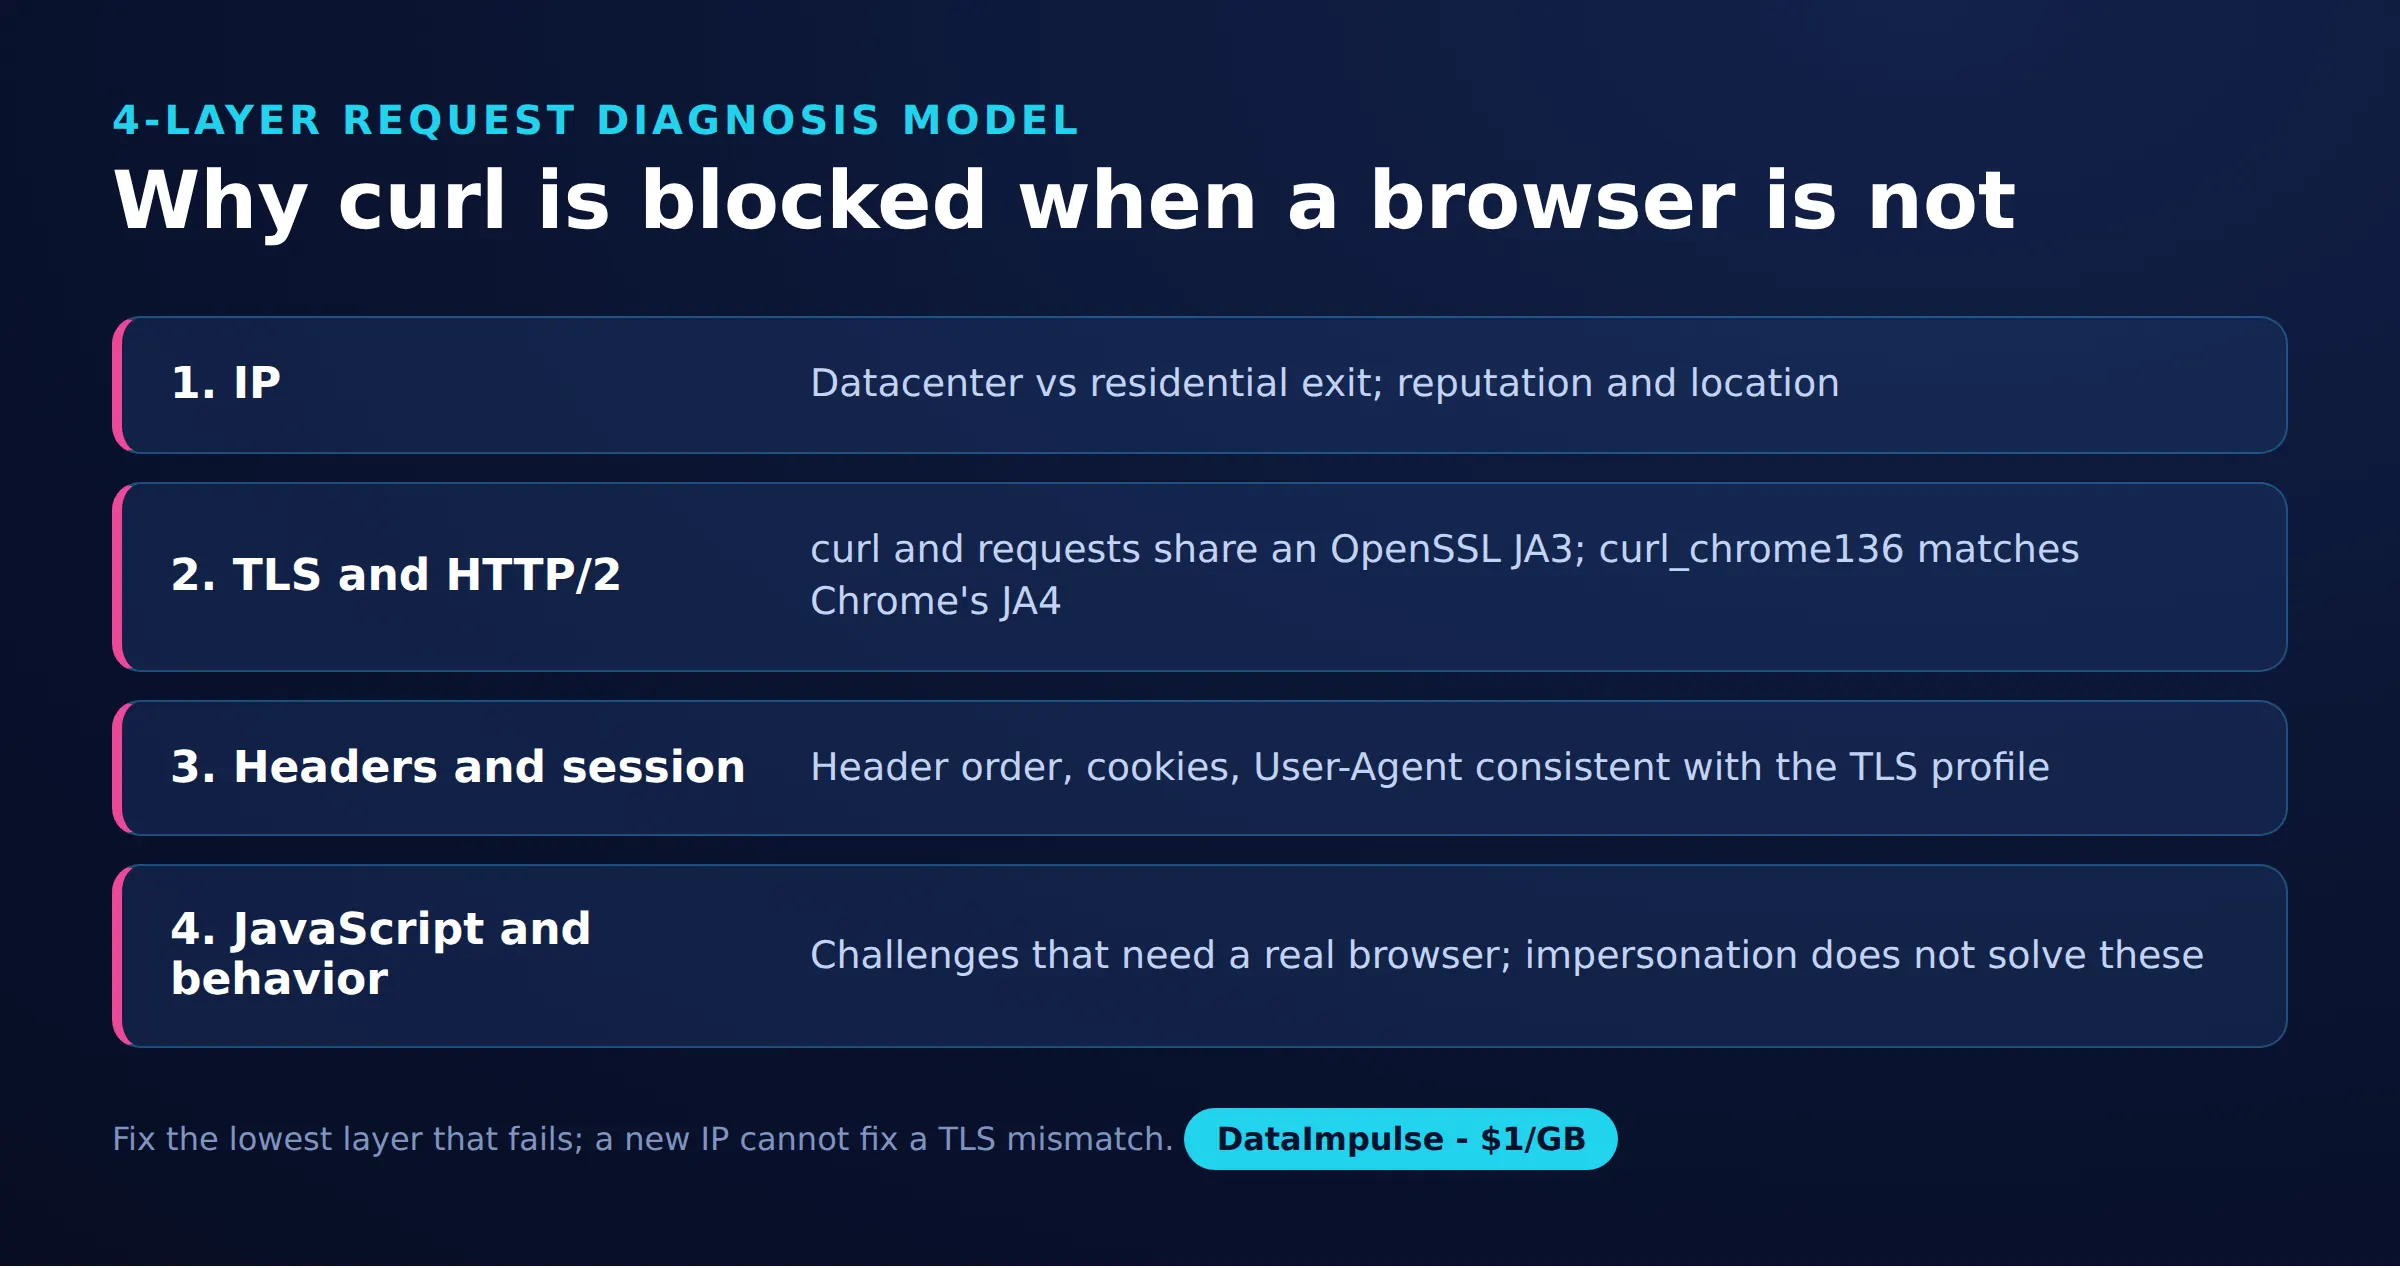
- 第 1 层:IP 与路由。保持客户端不变,对比直连与代理访问。记录国家、出口稳定性,以及失败是否发生在收到 HTTP 响应之前。
- 第 2 层:TLS 与 HTTP/2。保持路由不变,对比普通请求与伪装请求。请检查端点观察到的指纹,而不要轻信 User-Agent 字符串。
- 第 3 层:请求头与会话。对比重定向、Cookie、请求的 URL 以及预期的响应格式。请检查正文,因为 HTTP 状态成功时,应用层响应也可能是失败的。
- 第 4 层:JavaScript 与行为。判断数据是否只有在页面执行或交互之后才会出现。在传输层伪装之后,我们遇到的商品页面验证挑战依然没有解决。
每次对比都请记录状态、重定向目标、内容类型、响应大小以及一个内容标记。curl 的 HTTP 脚本文档介绍了响应检查、重定向、Cookie 和详细诊断。保留日志之前,请先清除其中的密钥。
不要把每一次拒绝都当作指纹问题。错误的 URL、缺失的会话状态或应用规则,都可能在更换传输层之后依然存在。对于您自己的服务,请把客户端观察结果与服务器日志相互关联。对于外部服务,请停止对验证挑战的重复重试,并重新评估被允许的访问途径。
什么时候应选择 curl-impersonate,而不是 Playwright 或 Selenium?
当一次 HTTP 响应就包含任务所需的全部内容时,请选择传输层伪装。当渲染或交互必不可少时,请选择浏览器自动化,并在您自己的工作负载中衡量其运行成本。
| 客户端 | 适合使用 X 的情况 | 不宜使用 X 的情况 |
|---|---|---|
| 标准 curl | 当普通 HTTP 已经足够时,使用标准 curl。 | 当已验证的指纹不匹配会造成影响时,避免使用标准 curl。 |
| curl-impersonate | 当类似浏览器的传输层行为适合该任务时,使用 curl-impersonate。 | 当需要执行 JavaScript 时,避免使用 curl-impersonate。 |
| Playwright/Selenium | 当渲染或交互必不可少时,使用 Playwright/Selenium。 | 当简单的 HTTP 就能满足需求时,避免使用 Playwright/Selenium。 |
Playwright 的网络文档介绍了如何观察浏览器请求,Selenium 的概览则介绍了浏览器自动化。浏览器会带来页面生命周期和资源加载方面的工作量。我们的测试既没有测量 CPU,也没有测量延迟,因此不能证明其在速度或扩展性上有任何优势。
Playwright 的 APIRequestContext 用于发送 API 请求,并且可以与浏览器上下文共享 Cookie。它并不等同于通过浏览器页面进行导航,请不要认为共享 Cookie 就意味着传输层行为完全相同。
浏览器自动化同样有其局限。Cloudflare 的受支持环境文档将自动化浏览器排除在生产环境验证挑战的支持范围之外(截至 2026 年 10 月)。更换工具并不是适用于所有情况的验证挑战解决方案。
我们的小规模公开页面测试显示了什么?
在 2026 年 10 月 16 日的快速测试中,使用伪装的请求取得了搜索内容,而普通请求则遇到了验证挑战。商品页面的失败表明,不宜把这次成功推而广之。
方法与样本:Andrii 在 TLS 检测端点上对比了八种客户端或配置文件组合:requests 2.x、系统 curl、四种 curl_cffi 配置文件、Playwright Chromium 以及 curl_chrome136。应用层样本包括四种 Python 客户端与路由的组合、两次 CLI 搜索结果,外加探索性的商品页面检查。这些是记录下来的观察结果,而不是多次重复试验得出的成功率。
指纹端点为 https://tls.peet.ws/api/all。Python 配置文件分别为 chrome、chrome131、safari 和 firefox。普通 requests 与系统 curl 的 JA3 均为 0149f47eabf9a20d0893e2a44e5a6323,但 requests 使用 HTTP/1.1,而系统 curl 使用 h2。仅此一点就说明,单个 TLS 哈希无法概括整条连接。
| Python 客户端 | 路由 | 状态 | 记录的大小 | 正文分类 |
|---|---|---|---|---|
| requests | 直连 | 200 | 15 KB | PerimeterX 验证挑战 |
| requests | 住宅 | 200 | 15 KB | PerimeterX 验证挑战 |
| curl_cffi chrome | 直连 | 200 | 1321 KB | 正常内容 |
| curl_cffi chrome | 住宅 | 200 | 1392 KB | 正常内容 |
CLI 对比使用了同一个 DataImpulse 美国住宅代理和同一个 Chrome User-Agent。普通 curl 收到了 307 重定向,指向一个标有 Robot or human? 的拦截页面。curl_chrome136 请求则返回了 200,传输的压缩数据约为 176 KB,HTML 中包含 __NEXT_DATA__ 商品 JSON。
Walmart 的商品页面仍然会对 curl_cffi 发起验证挑战。Sephora 的一个商品页面在住宅访问下返回了 Akamai 的 JavaScript 或行为类验证挑战。这些失败说明,不能把搜索页面的结果延伸为对任何一个网站的总体结论。
流量估算:按公布的住宅代理起步价每 GB 1 美元,并采用十进制单位计算,176 KB 约合 0.000176 美元。这只是对响应流量的示意,并非账单估算:请求字节数、重试、计费规则以及其他传输都可能改变总额。这里的 Python 大小与压缩传输量之间没有确定的对应关系,因此请不要将其与 CLI 数据直接比较。
这份快照没有耗时分布、重复请求次数,也没有对每一项请求头差异进行受控隔离。它支持的是对传输层的进一步调查,而不能把每一处响应差异都归因于 TLS。
如果要重复这份快照,请把确切的软件包版本、所选的包装脚本、路由、响应分类和度量单位一并记录。请将传输字节数与解码后的正文大小分别保存。在用于容量规划之前,请在受控条件下重复对比。如果页面模板或验证挑战响应发生变化,应当重新验证解析器。
您需要检查哪些授权和替代方案?
在把一次诊断请求变成持续的自动化之前,请先确认预期的数据采集已获得授权。公开可访问并不足以证明各种用途都已获得许可。
请查阅网站的服务条款、robots 说明、已发布的访问政策以及适用的义务。请保持采集范围尽量narrow,遵守所述限制,并避免对验证挑战反复重试。请不要重复使用第三方登录凭据,也不要试图绕过 CAPTCHA。
在维护脆弱的页面集成之前,请先查看是否有官方 API、导出文件、数据订阅源或已授权的数据集。请比较字段覆盖范围、数据新鲜度、认证要求以及允许的再利用方式。当访问权限不明确时,请寻求经批准的途径,而不要假定一次成功的响应就能解决这个问题。
常见问题
什么是 curl-impersonate?
它是一个经过修改的 curl 构建版本,目标是实现类似浏览器的网络握手。您可以用它来研究传输层差异,同时另行验证实际返回的内容。
为什么浏览器能成功,curl 却可能失败?
这两种请求可能在路由、传输层、会话状态或页面执行方面存在差异。在我们的测试中,HTTP 200 有时返回的其实是验证挑战,因此仅凭状态码来判断是否成功会产生误导。
curl_cffi 如何伪装 Chrome?
它的 impersonate 参数用于选择浏览器传输层配置文件。我们测试的 Python 调用选择的是 chrome。在记录复现步骤时,请将软件包版本与该别名一并保留。
curl-impersonate 可以配合代理使用吗?
我们的 curl_chrome136 请求通过带认证的 HTTP 住宅代理正常工作。请把代理连通性与应用层是否接受请求分开检查,因为一条可用的路由仍然可能返回验证挑战。
什么时候应该改用 Playwright?
当所需结果取决于页面执行或交互时,请选择浏览器工作流。请先确认所需数据确实不在初始响应中,并且不要把浏览器自动化视为保证能够访问。
JA4 匹配就能证明请求来自浏览器吗?
不能。我们的伪装客户端与 Chromium 共享了部分指纹,但这一观察结果既不能说明完整的浏览器行为,也不能说明已获得授权。
用清晰的基线测试网络层
如果您的诊断结果指向出口路由,请使用相同的客户端、配置文件和内容检查来评估 DataImpulse 住宅代理。DataImpulse 提供的是代理,而不是爬取 API、托管式解锁器、VPN 或数据。请从小规模开始,只有在确认已获得许可并且响应可用之后再逐步扩大。
最后更新:2026 年 10 月 16 日。