
In this Article
Reddit è tra le fonti di formazione sull’intelligenza artificiale più citate nel 2026 – Semrush e altre analisi di settore collocano Reddit a circa 2-4 volte la frequenza di citazioni di Wikipedia negli output LLM – e la licenza più costosa: Google paga Reddit ~ $ 60 milioni / anno (riportato pubblicamente, febbraio 2024), OpenAI ha firmato un accordo di licenza separato nel maggio 2024 (termini non divulgati ufficialmente; le stime del settore lo dicono in giro $ 70 milioni / anno) per l’accesso concesso in licenza agli stessi dati che sono liberamente visibili sul web ma esplicitamente vietati agli scraper secondo il contratto d’uso di Reddit. Questa lacuna è il motivo per cui Reddit ha citato in giudizio Anthropic (4 giugno 2025) per formazione di Claude senza licenza e ha presentato istanza di Reddit contro Perplexity a SDNY il 22 ottobre 2025, nominando **Perplexity, SerpApi, Oxylabs UAB e AWMProxy come co-imputati** nel caso di scraping senza licenza (si presume che AWMProxy gestisse una botnet; Oxylabs e SerpApi sono accusate di facilitare l’infrastruttura di scraping). I livelli Data API di Reddit partono da **$ 12.000 all’anno per il livello commerciale Standard** con $ 0,24/1.000 richieste in eccesso e opzioni con limite di velocità 100-1.000 RPM; l’impresa ha un preventivo personalizzato e inizia molto più in alto. Per i team ML, i fornitori di analisi del sentiment, SaaS di monitoraggio del marchio e pipeline di dati di formazione sull’intelligenza artificiale che non possono permettersi un accesso con licenza da 12.000 a 1 milione di dollari all’anno, la domanda pratica è: puoi raschiare il livello web pubblico di Reddit con proxy residenziali + Playwright stealth, e qual è l’esposizione legale se lo fai? La risposta è sfumata: la costanza della CFAA è chiara (post-hiQ), ma il diritto contrattuale di Reddit è applicabile e le cause legali relative ai marchi nel 2025 mostrano che Reddit prende sul serio l’applicazione.
Questa guida classifica gli 8 migliori proxy per lo scraping di Reddit nel 2026, esamina lo stack anti-bot di Reddit (Cloudflare + impronte digitali comportamentali + requisiti token OAuth), spiega dove l’accesso API con licenza prevale sullo scraping, copre il panorama legale post-Reddit-v-Anthropic ed esamina i modelli di produzione che sopravvivono ai livelli di escalation di Reddit. Vai al confronto veloce per una rosa di trenta secondi.
Fatti chiave
Lo scraping di Reddit è un mercato per procura perché il regime legale è stato inaugurato nel 2025, i limiti di tariffa sono aggressivi e l’applicazione anti-scraping di Reddit è reale. Cinque cose da sapere in anticipo:
- I livelli API Reddit Data sono costosi. Livello gratuito: autenticazione OAuth, 100 RPM, solo per uso personale/accademico/non commerciale. I prezzi commerciali standard sono quotati su misura (Reddit non pubblica un tariffario pubblico): il prezzo minimo riportato dal settore è di circa $ 12.000 all’anno con $ 0,24 per 1.000 richieste come tariffa per richiesta pubblicata. Livelli con limite di velocità da 100 a 1.000 RPM, che costano proporzionalmente di più (200 RPM ~$ 24.000/anno, 500 RPM ~$ 60.000/anno). Azienda: quotazione personalizzata (Reddit-Google ~$60 milioni/anno, Reddit-OpenAI ~$70 milioni/anno indicano il prezzo massimo). Il dirupo commerciale è ripido: la maggior parte dei team ML/SaaS che necessitano di dati Reddit in massa si scontrano con questo muro e cercano alternative.
- Reddit ha citato in giudizio i fornitori di scraping nel 2025. Reddit contro Anthropic (4 giugno 2025, Corte Superiore di San Francisco) sostiene che Anthropic abbia raschiato contenuti Reddit per addestrare Claude senza licenza. Reddit contro Perplessità et al. (22 ottobre 2025, SDNY) nominato Perplessità, SerpApi, Oxylabs UAB e AWMProxy come co-imputati nella presunta operazione di scraping senza licenza: AWMProxy avrebbe gestito una botnet, mentre Oxylabs e SerpApi avrebbero fornito l’infrastruttura di scraping che ha consentito l’operazione. Questo è il primo caso importante in cui Reddit ha perseguito direttamente i fornitori di proxy e API di ricerca, segnalando che i fornitori di scraping Reddit su scala di produzione sono esposti a violazioni contrattuali.
- Lo stack anti-bot di Reddit è di livello 2 ma ben calibrato. Cloudflare + impronte digitali comportamentali + verifica del token OAuth + punteggio del rischio legato all’account (modifiche API successive al 2023, anche l’accesso non autenticato tramite old.reddit.com richiede un’attenta cadenza). Rapporti della comunità di settore fino all’inizio del 2026: browser anti-rilevamento open source come Camoufox abbinati a proxy residenziali raggiungono tassi di passaggio elevati (i test della comunità riportano costantemente quasi il 100% su semplici letture di subreddit, inferiori sui flussi di accesso). Gli IP dei data center vengono contrassegnati rapidamente; residenziale e residenziale ISP sono i valori predefiniti per qualsiasi scraping di produzione.
- L’archivio Pushshift è limitato alle mod. Pushshift era storicamente l’archivio pubblico di Reddit (oltre 17 miliardi di post risalenti al 2008), ma dopo il 2023 è disponibile solo per i moderatori Reddit verificati per casi d’uso di moderazione. L’archivio Pushshift non può più costituire la base dello scraping commerciale di Reddit: i team di produzione devono eseguire lo scraping in tempo reale o ottenere la licenza tramite Reddit Data API.
- Reddit è tra le principali fonti di citazioni AI. Secondo le analisi di settore (Semrush 2024-2025 e studi simili), Reddit è citato 2-4 volte più frequentemente di Wikipedia negli output del modello AI. Gli accordi di licenza Reddit-Google (60 milioni di dollari/anno dichiarati pubblicamente) e Reddit-OpenAI (stima del settore di circa 70 milioni di dollari/anno, termini non divulgati ufficialmente) riflettono questo: i laboratori di intelligenza artificiale considerano i dati delle discussioni di Reddit come un corpus di formazione fondamentale. Per il monitoraggio del marchio, l’analisi del sentiment, le ricerche di mercato e le informazioni sulla concorrenza, Reddit è l’unica fonte di segnale più alta sul web aperto, motivo per cui Reddit addebita prezzi premium per l’accesso con licenza.
Come abbiamo selezionato questi proxy Reddit
Abbiamo scelto questi 8 fornitori perché hanno una copertura residenziale credibile o residenziale ISP che sopravvive al livello anti-bot di Reddit nel 2026, prezzi pubblici a partire da maggio 2026 e funzionalità documentate che contano per flussi di lavoro specifici di Reddit: lunghe sessioni permanenti per flussi associati a token OAuth, IP residenziali con diversità nazionale per il lavoro subreddit multiregione, ISP residenziale per Reddit Pro/Recruiter legati ad account account o API Reddit Scraper gestite che spostano la lotta anti-bot al fornitore di proxy. Abbiamo valutato il prezzo residenziale PAYG in tempo reale per GB, il tetto della sessione fissa, la presenza di benchmark specifici di Reddit e la situazione legale successiva all’ottobre 2025. I fornitori senza tassi di successo Reddit verificabili sono stati tagliati. Contesto importante: tutti e otto i fornitori operano nella stessa zona grigia legale di Oxylabs quando Reddit lo nominò co-imputato nell’ottobre 2025: l’infrastruttura proxy per lo scraping di Reddit è una vera e propria superficie di esposizione, non solo tecnica. Utilizza questo elenco con consulenti esperti in materia di diritto contrattuale.
Cosa rende un buon proxy per lo scraping di Reddit?
Un potente stack proxy Reddit risolve quattro problemi contemporaneamente. Autenticità residenziale o residenziale ISP – Il livello di impronte digitali comportamentali di Reddit è ottimizzato per contrassegnare gli IP dei datacenter entro decine di richieste; Il residenziale consumer-ISP è la base per qualsiasi raschiamento significativo di Reddit. Sessioni appiccicose di ore per giorni – per i flussi legati al token OAuth e lo scraping Reddit legato all’account, la rotazione IP interrompe la correlazione sessione-impronta digitale prevista dal punteggio di rischio di Reddit. Diversità nazionale per il lavoro subreddit multiregionale – r/Brasile, r/India, r/Germania, r/Messico, r/Russia hanno tutti post persistenti, mod e contesto comunitario regionali che differiscono in base alla geografia IP del visitatore; i corpora di formazione multilingue necessitano di autentici IP regionali. Associazione client TLS con riconoscimento dell’impronta digitale – i proxy da soli non battono Cloudflare; devi associarti a Playwright stealth, curl_cffi, undetected-chromedriver o Camoufox (il tesoro open source Reddit-bypass del 2026). Il proxy è metà dell’equazione; l’impronta digitale del client è l’altra metà.
Confronto rapido: i migliori proxy per lo scraping di Reddit in breve
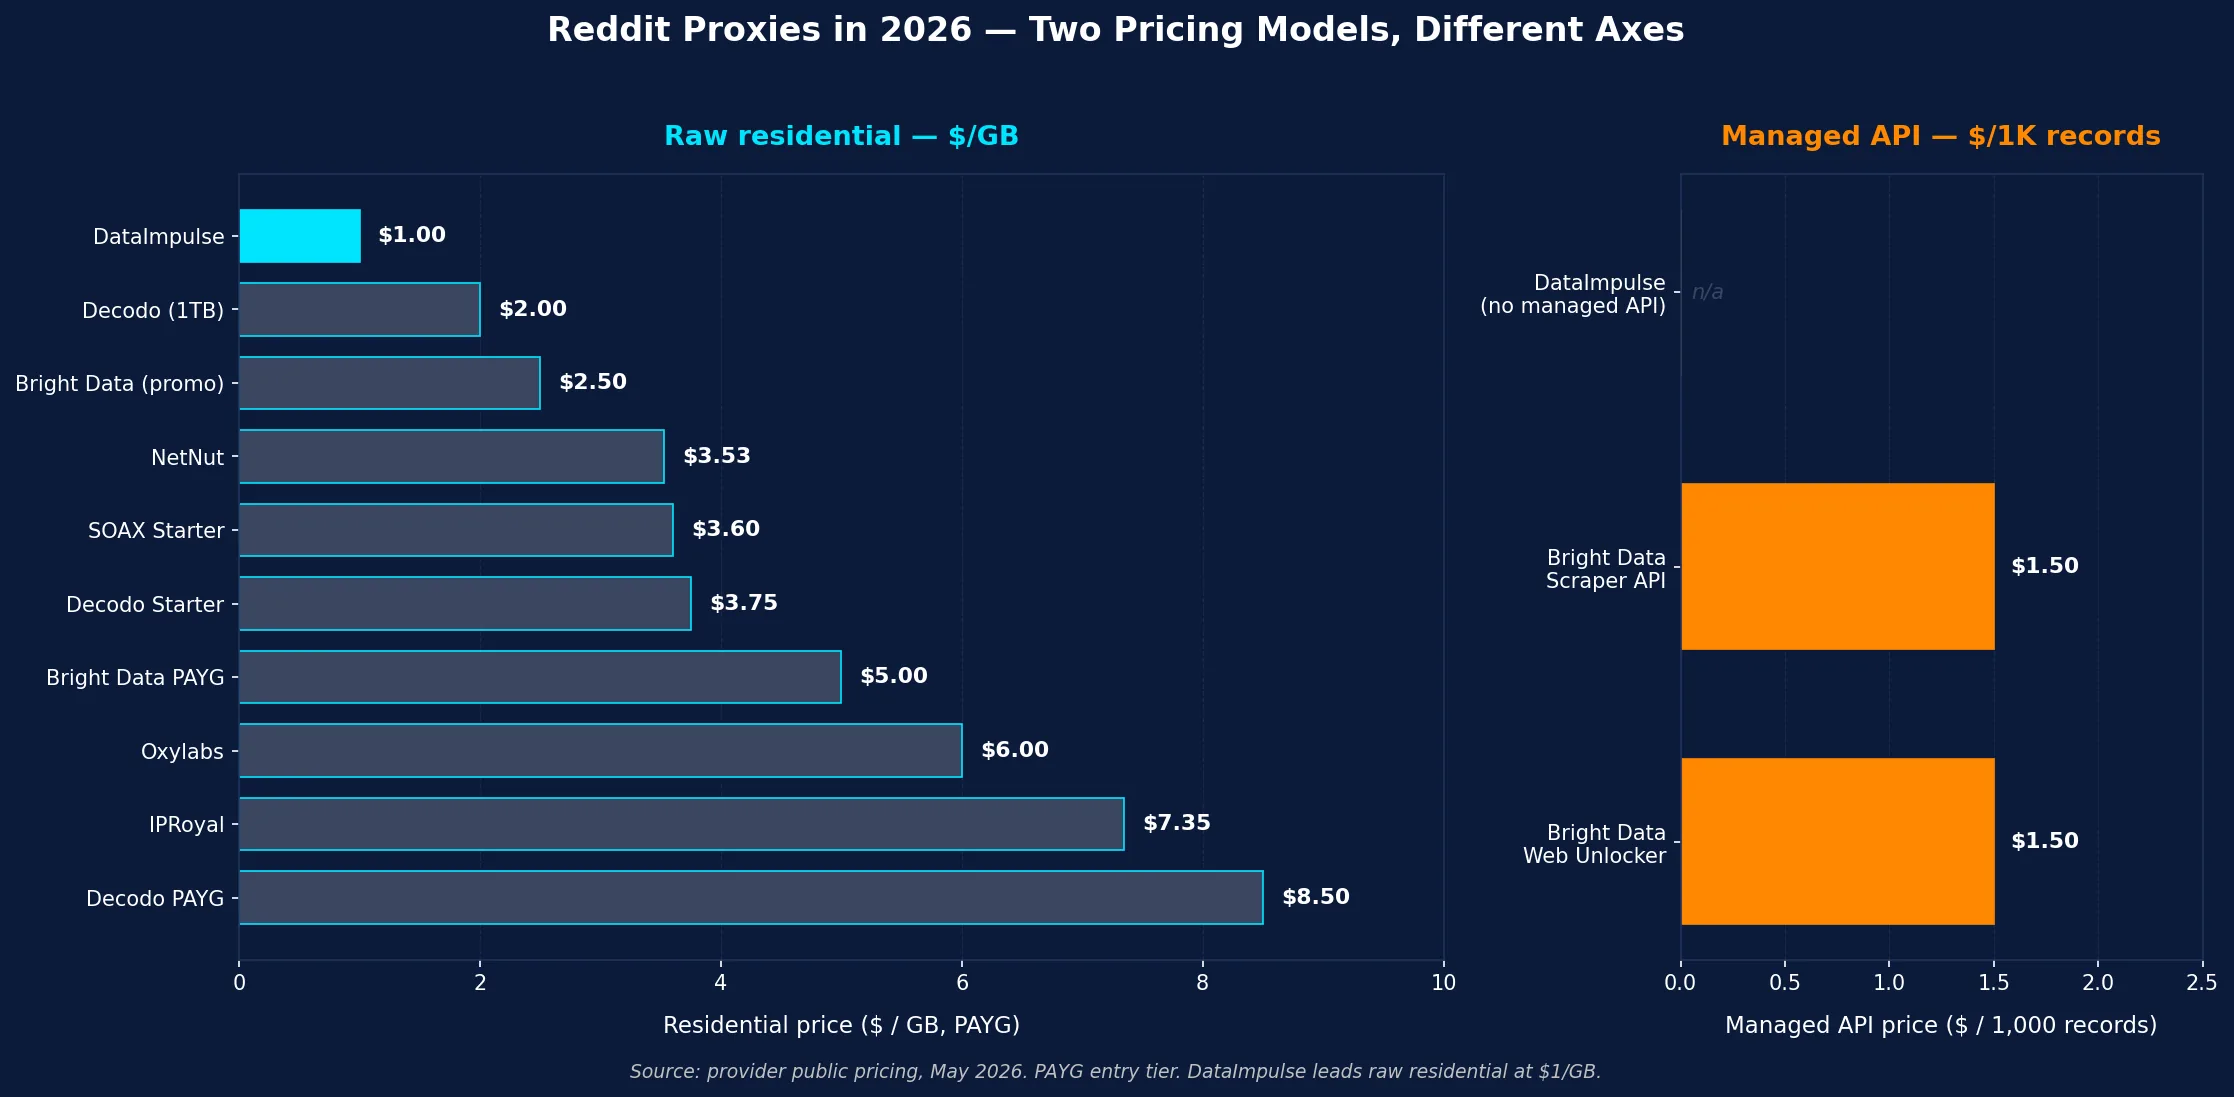
| Fornitore | Meglio per | Prezzo residenziale | Appiccicoso | Notevole |
|---|---|---|---|---|
| DataImpulse | Team Reddit interni con il miglior rapporto qualità-prezzo | PAGAMENTO $ 1/GB | Rotante + appiccicoso | Pool da oltre 90 milioni, mobile $ 2/GB per gli account più complessi |
| Dati luminosi | Set di dati Reddit gestiti e aziendali | ~$4/GB PAGAMENTO (promozione del 50%); $8/GB normale | Appiccicoso, dedicato | API Reddit Scraper + set di dati Reddit pre-raschiati |
| Oxylab | Enterprise (ma: Reddit contro Oxylabs co-imputato ottobre 2025) | a partire da $ 6/GB | Appiccicoso | L’API Web Scraper supporta Reddit; Successo al 99,95%. |
| Decodificato | ISP statunitense economico e di fascia media per account Reddit | $ 3,75/GB iniziale, $ 4-$ 8,50/GB A PAGAMENTO | Appiccicoso 24 ore su 24 | ISP statunitense da $ 0,27/IP |
| IPRoyal | Flussi di lavoro legati all’account | da $ 7,35/GB | Appiccicoso fino a 7 giorni | Il più lungo elenco appiccicoso: vincitore della sopravvivenza dell’account Reddit |
| SOAX | Misto (mobile + ISP per i casi più difficili) | $ 3,60/GB iniziale | Appiccicoso | Pool mobile di oltre 33 milioni per gli account Reddit più difficili |
| Condivisione web | Economico pubblico-solo su Reddit | da $ 3,50 al mese; $ 2,99/mese CC | Dipendente dal piano | NON per il lavoro Reddit legato all’account |
| NetNut | Affidabilità residenziale dell’ISP | da $ 3,53/GB | Appiccicoso | Autenticità consumatore-ISP (Comcast, Charter, AT&T). |
Quale tipo di proxy dovresti utilizzare per Reddit?
Lo scraping di Reddit nel 2026 si divide nettamente in due corsie: Reddit pubblico (pagine subreddit, elenchi di post, thread di commenti tramite old.reddit.com o il livello web pubblico) e Reddit legato all’account (Equivalenti vendite/reclutatore, account Pro con accesso, flussi di lavoro autenticati con OAuth). Ogni corsia necessita di una postura proxy diversa.
Proxy residenziali: impostazione predefinita per lo scraping pubblico di Reddit
I proxy residenziali sono la soluzione predefinita giusta per il lavoro pubblico su Reddit: scraping del catalogo subreddit, estrazione di post e commenti pubblici, aggregazione dei risultati di ricerca, scraping di comunità multilingue (r/Brasile, r/India, r/Russia, r/Messico, ecc.), rilevamento delle tendenze, monitoraggio del sentiment, monitoraggio delle menzioni del marchio. Gli IP di Real Comcast, Charter, AT&T, Verizon, BT, Deutsche Telekom leggono come normali lettori Reddit su Cloudflare + impronte digitali comportamentali e un nuovo pool residenziale supera regolarmente il guanto di sfida in cui i range dei datacenter vengono segnalati entro decine di richieste.
ISP/Proxy residenziali statici: impostazione predefinita per il lavoro legato all’account Reddit
I proxy ISP (residenziale statico) sono la scelta giusta per qualsiasi flusso di lavoro Reddit che necessita di continuità di sessione o identità di account persistente: consumatori API autenticati con OAuth (account a livello di limite di velocità dell’API Reddit Data), account Reddit Pro con accesso, automazione legata all’account, continuità della sessione di più giorni per il lavoro con cadenza Reddit. Gli IP degli ISP si trovano su indirizzi assegnati dall’ISP al consumatore con la stabilità dell’hosting statico; Decodo (da $ 0,27/IP), IPRoyal, NetNut, Bright Data e Webshare offrono tutti linee di prodotti ISP.
Proxy mobili: solo account più difficili
I proxy mobili passano attraverso reti di operatori reali (Verizon, T-Mobile, AT&T negli Stati Uniti; Vodafone, EE nell’UE) e guadagnano il loro posto per gli account Reddit più difficili: account che hanno già raggiunto il livello di escalation successivo su residenziale, account con karma/età elevati che il punteggio di rischio di Reddit controlla più attentamente, o nuovi account in fase di riscaldamento in cui gli IP degli operatori di telefonia mobile sembrano più nativi. Il cellulare è il più costoso per GB ($ 2-$ 10), quindi riservalo ai casi più difficili.
Proxy del data center: EVITARE per Reddit
I proxy dei datacenter sono essenzialmente morti per lo scraping di Reddit nel 2026. Il livello Cloudflare + behavioral Fingerprinting di Reddit contrassegna gli intervalli dei datacenter entro decine di richieste. Non utilizzare il datacenter per nessuna superficie Reddit. Prenota il datacenter per i livelli di dati pubblici adiacenti (mirror di scansione comune dei contenuti storici di Reddit tramite Wayback Machine, copertura stampa di terze parti degli argomenti di tendenza di Reddit).
Rotante vs appiccicoso per Reddit
La regola per Reddit: ruotare per ampiezza, mantenere per continuità account/OAuth. La rotazione residenziale gestisce ampi controlli del catalogo subreddit, aggregazione di post-list multi-subreddit, monitoraggio delle tendenze su r/all e r/popular, community scraping multilingue. Le sessioni permanenti (minimo 24 ore, 7 giorni ideali per gli account più difficili) gestiscono i flussi più profondi: consumatori API legati a token OAuth, account a livello di limite di velocità dell’API Reddit Data, flussi di lavoro Pro/Mod con accesso, navigazione di contenuti in base alla cadenza di più giorni. La maggior parte degli stack Reddit di produzione ruotano al 60% + 40% sono permanenti per il livello legato all’account.
I migliori proxy per Reddit: recensioni complete
Le scelte seguenti sono classificate in base al valore per lo scraping di Reddit: equilibrio tra autenticità residenziale/ISP, durata della sessione, diversità nazionale per il lavoro su subreddit, tasso di successo anti-bot e prezzo per scraping riuscito. DataImpulse è leader in termini di valore; Il periodo di validità di 7 giorni di IPRoyal è particolarmente efficace per il lavoro Reddit legato all’account; Bright Data è il track record legale post-Meta-v-Bright-Data gestito dall’API Reddit-Scraper-API.
1. DataImpulse
DataImpulse è la scelta più conveniente per i team interni che gestiscono i propri scraper Reddit: scraping del catalogo subreddit, raccolta di thread di commenti, monitoraggio del sentiment su r/wallstreetbets/r/stocks/r/CryptoCurrency per team finanziari, monitoraggio delle menzioni del marchio, scraping di comunità multilingue (r/Brasile, r/India, r/Russia, r/Messico), assemblaggio di dati di formazione AI da Reddit. Il residenziale inizia alle $ 1/GB, con pagamento in base al consumo, con traffico che non scade mai: una frazione dei costi di accesso all’API Reddit Data con licenza (livello Standard minimo $ 12.000/anno) e molto inferiore al prezzo per record dell’API gestita dall’azienda. Il pool comprende oltre 90 milioni di IP di provenienza etica in 195 paesi con una copertura credibile negli Stati Uniti e nell’UE, significativo sia per Reddit in lingua inglese che per le comunità subreddit multilingue. Il targeting per Paese è incluso in stato/città/CAP/ASN come componente aggiuntivo a pagamento (2 volte la tariffa per GB). Supporta HTTP, HTTPS e SOCKS5, sessioni rotanti e permanenti, accesso API completo e stack di scraping standard (Scrapy, Selenium, Playwright + stealth, Camoufox, undetected-chromedriver). Il mobile è disponibile a $ 2/GB per le reti degli operatori statunitensi/UE: il livello di escalation da raggiungere quando il residenziale viene contrassegnato sugli account Reddit più difficili.
Ciò che lo rende l’impostazione predefinita per una seria raccolta interna di Reddit è la posizione di audit legale combinata con il rapporto prezzo/pool. Gli IP di provenienza etica (DI pubblica la documentazione dell’SDK di consenso) contano di più dopo Reddit-v-Perplexity-and-Oxylabs (ottobre 2025): quando gli stessi fornitori di proxy vengono ora citati in cause legali, la documentazione sulla provenienza dell’IP diventa parte della difesa in caso di violazione del contratto. A $ 1/GB puoi sostenere la raccolta continua di Reddit senza i costi dell’API gestita per record e il modello PAYG significa che sperimentare nuovi target di dati subreddit non ti vincola a un abbonamento. Il supporto è umano 24 ore su 24, 7 giorni su 7; il tasso di successo pubblicato è del 99,51%; G2 è 4,8/5.
Specifiche rapide – Tipi: residenziale, mobile, data center · Pool: 90 milioni+ residenziali, 195 paesi, di provenienza etica · Rotazione: a rotazione + permanente · Geo: paese (stato/città/ZIP/ASN come componente aggiuntivo a pagamento a tariffa 2×) · Prezzo: $ 1/GB ris, $ 0,50/GB DC, $ 2/GB mobile · Successo pubblicazione: 99,51% · Valutazione: G2 4,8.
Ideale per: team interni di scraping di Reddit che desiderano prezzi PAYG bassi e approvvigionamento IP difendibile da audit.
2. Dati brillanti
Bright Data è la scelta aziendale se desideri che i dati Reddit siano un prodotto gestito. Oltre al residenziale puro a $ 8/GB con pagamento in base al consumo (attualmente scontato a ~ $ 4/GB con una promozione del 50% sul livello PAYG normale, con un ulteriore $ 2,50/GB sul livello ad alto volume di $ 1.999/mese) con un pool IP mensile di oltre 400 milioni e targeting gratuito per città/ZIP/ASN, Bright Data spedisce un endpoint API Reddit Scraper dedicato a $ 1,50 per 1.000 record su PAYG (circa $ 1,30/1K sul piano $ 499/mese). Il Web Unlocker con risultati di $ 1,50/1K gestisce le superfici protette da Reddit in modo generico. Bright Data pubblica anche set di dati Reddit pre-raschiati come prodotto separato (milioni di record di post/commenti, aggiornati periodicamente, venduti come dati in blocco) – per i team ML che desiderano dati di formazione Reddit senza eseguire autonomamente la pipeline di scraping. ISO 27001, SOC 2 Tipo II e conformità pronta per l’audit – e Bright Data ha vinto Meta contro Bright Data (23 gennaio 2024) nella distinzione tra pubblico e registrato, offrendo loro il più solido track record legale in questo elenco per lo scraping pubblico dei dati Reddit.
Specifiche rapide – Tipi: residenziale, DC, ISP, mobile + API Reddit Scraper dedicata + Web Unlocker + set di dati Reddit in blocco · Pool: oltre 400 milioni residenziali mensili · Rotazione: rotante, permanente, dedicata · Geo: paese/città/ZIP/ASN gratuito · Prezzo: ~$4/GB res PAYG (promo, $8 normale); ~$2,50/GB al livello di $1.999/mese; API Reddit Scraper da $ 1,50/1K registra PAYG (~$ 1,30/1K su piano $ 499); abbonamento da $ 499/mese · Conformità: ISO 27001, SOC 2 Tipo II.
Ideale per: team di dati Reddit aziendali che desiderano API Scraper gestite o set di dati Reddit in blocco con conformità pronta per l’audit.
3. Oxylab
Oxylabs si colloca accanto a Bright Data ai vertici aziendali con una forte copertura Reddit: il residenziale parte da circa $ 6/GB sul piano di ingresso con un pool di oltre 175 milioni in 195 paesi, targeting per città/stato/ZIP/ASN e un’API Web Scraper (entrata da $ 49/mese) che supporta Reddit come target con una percentuale di successo pubblicata del 99,95%. Contesto importante: Oxylabs è stato nominato come co-imputato nel caso Reddit v Perplexity (22 ottobre 2025, SDNY) insieme a Perplexity, SerpApi e AWMProxy nel caso dello scraping senza licenza. Questo è uno dei primi casi importanti in cui Reddit ha preso di mira i fornitori di proxy e API di ricerca direttamente come co-imputati. Il contenzioso è in corso a metà del 2026 e Oxylabs non è stata ritenuta responsabile. Per il lavoro su Reddit a livello di procurement, vale la pena soppesarlo: Oxylabs offre una solida infrastruttura tecnica e conformità ISO 27001 + SOC 2, ma la lente del rischio legale è cambiata da ottobre 2025.
Specifiche rapide – Tipi: residenziale, DC, ISP, mobile + API Web Scraper · Pool: 175 milioni+ residenziali, 195 paesi · Rotazione: flessibile, fissa, concorrenza illimitata · Geo: paese/stato/città/CAP/coordinate/ASN · Prezzo: da $ 6/GB residenziale; API Web Scraper da $ 49/mese · Successo di pubblicazione: 99,95% · Conformità: ISO 27001, SOC 2 · Contenzioso attivo: co-imputato in Reddit v Perplexity (ottobre 2025).
Ideale per: programmi Reddit aziendali che richiedono uno scraping di livello SLA con l’avvertenza che la posizione in materia di rischio legale è cambiata dall’ottobre 2025.
4. Decodifica
Decodo (precedentemente Smartproxy) è il punto debole del mercato medio per il lavoro legato all’account Reddit. I proxy residenziali partono da $ 3,75/GB sul piano iniziale da 3 GB, con PAYG che va da $ 4 a $ 8,50/GB a seconda del livello/pagina. IL residenziale/ISP statico parte da $ 0,27/IP – una delle tariffe ISP più aggressive per i flussi di lavoro legati all’account Reddit in cui la residenza dell’ISP non è negoziabile (account token OAuth, postazioni Reddit Pro dedicate, sessioni di cadenza Reddit di più giorni). Il targeting per Paese, città, CAP e ASN è incluso con oltre 115 milioni di IP in oltre 195 località. L’API Web Scraping include modelli per target in stile Reddit, con sessioni permanenti fino a 24 ore.
Specifiche rapide – Tipi: residenziale, DC, ISP, mobile + API Web Scraping · Pool: 115 milioni+ residenziale, 195+ paesi · Rotazione: per richiesta, permanente fino a 24 ore · Geo: paese/città/ZIP/ASN incluso · Prezzo: $ 3,75/GB iniziale, $ 4-$ 8,50/GB PAYG, $ 2/GB a 1 TB+; residenziale/ISP statico da $ 0,27/IP · Successo pubblicato: 99,86%.
Ideale per: team Reddit di fascia media che desiderano un ISP economico per scraper dedicati legati ad account.
5. IPReale
IPRoyal guadagna la corsia principale specifica per Reddit per un motivo: Sessioni appiccicose di 7 giorni, il più lungo in questo elenco. Il lavoro legato all’account Reddit sopravvive più a lungo con una continuità della sessione fissa che si estende su giorni lavorativi; la correlazione tra account e impronta digitale IP tracciata dal punteggio di rischio di Reddit premia un’identità IP coerente nel tempo. Il PAYG residenziale costa $ 7,35/GB all’ingresso (più economico in termini di volume) con un pool di oltre 32 milioni in oltre 195 paesi con targeting per paese, regione, città e ISP. È disponibile una linea di prodotti ISP statunitense dedicata e un Web Unblocker (CAPTCHA + bypass anti-bot) a un prezzo su richiesta. Per gli account Reddit associati a token OAuth, gli archivi sostitutivi Pushshift che richiedono continuità di più giorni e qualsiasi flusso di lavoro Reddit in cui la stabilità dell’impronta digitale della sessione per settimane è limitata, IPRoyal è la scelta più forte.
Specifiche rapide – Tipi: residenziale, ISP, mobile, DC + Web Unblocker · Pool: 32 milioni+ residenziali, 195+ paesi · Rotazione: rotante, permanente fino a 7 giorni · Geo: paese/regione/città/ISP · Prezzo: da $ 7,35/GB residenziale PAYG.
Ideale per: Flussi di lavoro legati all’account Reddit (account Pro autenticati con OAuth, accesso, archivi sostitutivi di Pushshift) che richiedono una continuità costante di 7 giorni.
6. SOAX
SOAX è la scelta quando i tipi di proxy misti sono importanti per un programma Reddit: residenziale per un ampio scraping di cataloghi subreddit, mobile per gli account Reddit più difficili, ISP per flussi di lavoro OAuth legati all’account. Il piano residenziale parte da $ 3,60/GB sul piano Starter (25 GB inclusi) e il modello di credito unificato significa che puoi spendere lo stesso budget per residenziale, mobile, ISP, data center o API Web Data. La piscina è una delle più grandi nel livello intermedio: oltre 155 milioni di residenze, Oltre 33 milioni di cellulari (forte per gli account Reddit più difficili in cui gli IP degli operatori di telefonia mobile sono l’ultima corsia sbloccata), oltre 2,6 milioni di ISP, con targeting per Paese, regione, città, ISP e ASN. Le sessioni permanenti sono supportate in tutti i tipi di proxy.
Specifiche rapide – Tipi: residenziale, mobile, ISP, DC + Web Data API · Pool: 155 milioni+ residenziale, 33 milioni+ mobile, 2,6 milioni+ ISP · Rotazione: per richiesta o intervallo, permanente supportato · Geo: paese/regione/città/ISP/ASN · Prezzo: $ 3,60/GB Starter.
Ideale per: I team Reddit eseguono stack di tipo misto (residenziale + ISP + mobile) con un unico abbonamento.
7. Condivisione sul web
Webshare guadagna il suo posto per i team Reddit che eseguono lavori economici e a basso volume sui dati Reddit pubblici: scraping di pagine pubbliche di old.reddit.com, catalogo di subreddit pubblici (quando non dietro la configurazione più rigorosa di Cloudflare), aggregazione di commenti pubblici su subreddit minori con difesa più debole. I piani partono da $ 2,99 al mese per il pacchetto data center da 100 proxy e $ 3,50 al mese per il piano residenziale a rotazione con oltre 80 milioni di residenziali disponibili su livelli superiori, oltre a proxy ISP statunitensi statici sui piani di abbonamento. Webshare residenziale è la soluzione migliore solo per i lavori pubblici su Reddit; per qualsiasi scraping legato all’account o al dominio Reddit principale, passa ai fornitori focalizzati sull’ISP sopra. I prodotti datacenter non funzionano su Reddit.
Specifiche rapide – Tipi: residenziale, ISP statico, datacenter · Pool: residenziale da 80 milioni+ (abbonamento); datacenter e ISP disponibili · Geografia: paese, città dipendente dal piano · Prezzo: da $ 2,99/mese datacenter (100 proxy); residenziale a rotazione da $ 3,50 al mese.
Ideale per: lavoro pubblico-Reddit economico e a basso volume. NON per lo scraping legato all’account o la superficie principale di Reddit.com.
8. NetNut
NetNut chiude l’elenco concentrandosi sull’affidabilità residenziale dell’ISP per i flussi di lavoro Reddit: IP consumer-ISP puliti (Comcast, Charter Spectrum, Verizon FiOS, AT&T, Cox negli Stati Uniti; Deutsche Telekom, Vodafone, BT nell’UE) che mantengono un’identità coerente durante i cicli di vita delle sessioni Reddit. La rotazione residenziale attualmente inizia intorno a $ 3,53/GB sui piani di ingresso, aumentando in volume; targeting a livello di Paese e città disponibile sui livelli superiori. Il valore aggiunto di NetNut per Reddit è l’autenticità del consumatore-ISP: gli IP vengono letti come normali lettori di Reddit, che è esattamente ciò che il modello comportamentale di Reddit si aspetta dagli utenti tipici. Associa l’ISP NetNut a sessioni permanenti e una cadenza lenta simile a quella umana per la sopravvivenza dell’account Reddit di più settimane.
Specifiche rapide – Tipi: ISP residenziale, residenziale, mobile · Pool: residenziale di livello ISP con ampia copertura USA/UE · Rotazione: rotante, permanente · Geo: paese (città sui piani più alti) · Prezzo: da $ 3,53/GB residenziale.
Ideale per: Team Reddit che desiderano l’autenticità residenziale-consumatore-ISP senza pagare prezzi aziendali.
Quanto costa lo scraping di Reddit?
Tre percorsi economici nel 2026:
- API dati Reddit con licenza (dal punto di vista legale più pulito): livello gratuito (100 RPM, OAuth, solo personale/accademico). Pubblicità standard: $ 12.000 / anno a partire + $ 0,24/1.000 richieste rispetto all’allocazione. I livelli con limite di velocità pari a 100-1.000 RPM costano proporzionalmente di più. Quotazioni aziendali personalizzate (Google ~$60 milioni/anno, OpenAI ~$70 milioni/anno su larga scala).
2. Procura + Drammaturgo invisibile + Camoufox (percorso tecnico, residenziale da $ 0,50 a $ 10/GB): DataImpulse residenziale a $ 1/GB PAYG copre la maggior parte dei programmi Reddit di produzione; mobile a $ 2/GB per gli account più difficili. Costo pratico su scala: $ 50-$ 500/mese per tipici programmi di monitoraggio del marchio/analisi del sentiment, $ 500-$ 5.000/mese per l’assemblaggio di dati di formazione ML. L’esposizione alla violazione del contratto è reale ma la maggior parte delle squadre lo accetta.
3. API di Reddit Scraper gestite (passaggio legale al fornitore): API Reddit Scraper di Bright Data a $ 1,50/1K record PAYG (~ $ 1,30 su piano $ 499/mese), voce API Oxylabs Web Scraper $ 49/mese, Apify Reddit Scraper Actors con prezzi basati sul calcolo. Costo pratico su larga scala: $ 200-$ 2.000 al mese. Bright Data ha vinto Meta v Bright Data (gennaio 2024) e ha il più solido track record legale sulla distinzione tra pubblico e registrato: un’assicurazione rilevante per il lavoro su Reddit.
La domanda sul costo reale per Reddit non è “qual è il percorso più economico” ma “qual è il costo totale più basso, inclusa la riserva per rischi legali, per record Reddit utilizzabile.” Per la maggior parte dei team di produzione, il residenziale interno ($ 1-$ 2/GB) più una piccola riserva legale batte l’API Reddit con licenza a un minimo di $ 12.000/anno fino a superare circa 5 milioni di record al mese; al di sopra di ciò, le API gestite vincono in termini di tempi operativi.
Lo scraping di Reddit è legale?
Lo scraping di Reddit nel 2026 si trova all’intersezione tra CFAA, diritto comune statale (post-hiQ), contratto con l’utente di Reddit (esplicitamente applicabile secondo la strategia contenziosa di Reddit) e l’ondata di cause legali del 2025 che Reddit ha intentato contro Anthropic e Perplexity + Oxylabs. Le basi:
- Lo scraping dei dati pubblici è sicuro secondo la CFAA. hiQ contro LinkedIn (9th Cir. April 2022) ha confermato che lo scraping di dati web accessibili al pubblico non viola il Computer Fraud and Abuse Act. Meta v Bright Data (23 gennaio 2024) ha rafforzato questo concetto con la distinzione tra pubblico e utente registrato. Le pagine pubbliche di Reddit (indici subreddit, elenchi di post, thread di commenti accessibili senza login) rientrano nell’ambito del carve-out CFAA di hiQ.
- MA: il contratto con l’utente di Reddit È applicabile ai sensi del diritto contrattuale e della legge statale sulla responsabilità civile. I Termini di servizio di Reddit vietano esplicitamente l’accesso automatizzato senza un contratto di licenza dei dati Reddit (DLA). Seguendo il playbook hiQ (dove LinkedIn ha vinto richieste di violazione del contratto anche dopo aver perso sul CFAA), Reddit ha citato in giudizio Anthropic (4 giugno 2025) e Perplexity + Oxylabs (22 ottobre 2025) per violazione del contratto con l’utente di Reddit. Per lo scraping commerciale di Reddit, le richieste di inadempimento contrattuale sono la vera superficie di esposizione, non la CFAA.
- L’applicazione di Reddit contro i provider proxy e API di ricerca è una novità. Il caso Reddit v Perplexity (SDNY) dell’ottobre 2025 ha nominato Perplexity, SerpApi, Oxylabs UAB e AWMProxy come co-imputati. Si presume che AWMProxy abbia gestito una botnet; Si presume che Oxylabs e SerpApi abbiano fornito infrastrutture di scraping. Questo è uno dei primi casi importanti in cui Reddit ha perseguito direttamente i fornitori di proxy e API di ricerca come co-imputati. Ciò segnala che i fornitori di infrastrutture nello scraping Reddit su scala di produzione sono esposti a violazioni contrattuali, non solo la società AI/SaaS che utilizza il proxy. Scegli fornitori proxy con IP di provenienza etica e atteggiamento di conformità documentato; la documentazione sulla provenienza della proprietà intellettuale fa parte della tua difesa in caso di violazione del contratto.
- I dati personali su Reddit attivano la normativa GDPR/CCPA/statale sulla privacy. I nomi utente, i contenuti dei post scritti da persone identificabili e i profili utente aggregati sono dati personali ai sensi del GDPR (membri dell’UE), CCPA/CPRA (California). Eliminare i dati personali dai corpora, ove possibile; documentare la fase di stripping.
- Il livello di licenza esiste per un motivo. Reddit-Google (60 milioni di dollari/anno) e Reddit-OpenAI (70 milioni di dollari/anno) stabiliscono il prezzo minimo per i dati Reddit concessi in licenza nella fascia alta. Il livello Standard da 12.000 dollari all’anno è la licenza pratica per i team SaaS/ML. Molti programmi Reddit di produzione vengono eseguiti nella zona grigia (proxy residenziali + azione furtiva del drammaturgo, nessuna licenza, accettazione del rischio di violazione del contratto); la domanda è se la tua organizzazione può assorbire una causa di cessazione e desistenza di Reddit o una causa Reddit-v-You se sei abbastanza di alto profilo da innescarne una.
La lettura onesta: lo scraping pubblico di Reddit è sicuro CFAA, ma l’esposizione alla violazione del contratto con l’utente di Reddit è reale e ben contenziosa nel 2025. Le più grandi aziende AI/SaaS sono state prese di mira (Anthropic, Perplexity, Oxylabs); le squadre più piccole in genere volano sotto il radar ma l’esposizione è diversa da zero. Ottieni familiarità con i consulenti statunitensi in materia di transazioni tecnologiche con il panorama dei contenziosi Reddit post-ottobre 2025 prima di ridimensionare una pipeline di produzione Reddit. Questa non è una consulenza legale.
Come avviare lo scraping di Reddit con DataImpulse
- Creare un account e scegli il tuo mix proxy. Residenziale ($ 1/GB) per subreddit Reddit pubblici e scraping post-list, lavoro comunitario multilingue, monitoraggio del sentiment; mobile ($ 2/GB) per gli account Reddit più difficili e i flussi OAuth legati all’account in cui il residenziale viene contrassegnato; datacenter ($ 0,50/GB) per livelli adiacenti (copertura di tendenza di Reddit in notizie di terze parti, mirror Wayback Machine di pagine Reddit pubbliche – NON per scraping diretto su Reddit.com).
- Aggiungi fondi e crea cadenza. Pagamento a consumo, senza abbonamento, senza scadenza. Il volume di scraping di Reddit viene eseguito a raffica (cicli mensili di monitoraggio del marchio, sprint di dati di formazione ML, corse di rilevamento di argomenti di tendenza). Accoppia il livello proxy con: Playwright + stealth o Camoufox o client chromedriver non rilevato (essenziale: Cloudflare di Reddit + flag di livello comportamentale ingenui raschiatori); ritardi lenti come quelli umani (5-30 secondi tra le richieste, randomizzati); Continuità dell’IP di sessione per i flussi autenticati con OAuth.
- Scegli come target il subreddit e ruota con attenzione. Imposta il paese Stati Uniti (o un paese specifico per il lavoro subreddit regionale: Regno Unito/CA/AU/DE/BR/IN), seleziona la rotazione per un ampio scraping del catalogo subreddit (60-70% del carico di lavoro tipico), seleziona permanente 24 ore su 24, 7 giorni su 7 per i flussi di lavoro autenticati con OAuth. Onora il robots.txt di Reddit dove puoi, tratta i contenuti creati dagli utenti come dati personali e continua a recuperare i registri per la traccia di controllo che desideri dopo l’incidente.
Per ulteriori informazioni sui flussi di lavoro correlati, consulta il nostro pagina del prodotto proxy residenziali, IL pagina del prodotto proxy mobili (per gli account Reddit più difficili), il i migliori proxy per la raccolta di dati di addestramento su ML e intelligenza artificiale roundup (Reddit è la categoria di fonti n. 1) e il i migliori proxy per il web scraping riepilogo.
Domande frequenti
Lo scraping di Reddit è legale nel 2026?
Lo scraping dei dati di Public-Reddit è sicuro CFAA sotto hiQ Labs v LinkedIn (9th Cir. 2022) + Meta v Bright Data (gennaio 2024). MA il contratto con l’utente di Reddit proibisce esplicitamente lo scraping e Reddit ha applicato in modo aggressivo reclami per violazione del contratto: Reddit ha citato in giudizio Anthropic (4 giugno 2025) e Perplexity + Oxylabs (22 ottobre 2025) per scraping senza licenza. Le pretese per violazione contrattuale e responsabilità civile costituiscono la vera superficie di esposizione. I dati personali dell’utente attivano il GDPR/CCPA. Ottieni consulenza sulle transazioni tecniche prima di ampliare le pipeline commerciali di Reddit. Questa non è una consulenza legale.
Quanto costa l’API Reddit Data nel 2026?
Livello gratuito: autenticato OAuth, 100 RPM, solo personale/accademico. Commerciale standard: minimo $ 12.000 / anno, con 0,24 USD per 1.000 richieste in eccesso rispetto all’allocazione. I livelli con limite di velocità (100-1.000 RPM) costano proporzionalmente di più: 200 RPM ~ $ 24.000, 500 RPM ~ $ 60.000. Quotazioni aziendali personalizzate (Reddit-Google ~$60 milioni/anno, Reddit-OpenAI ~$70 milioni/anno stabiliscono il tetto del prezzo di fascia alta). Per la maggior parte dei team SaaS/ML, il precipizio da 12.000 dollari è il punto di ingresso pratico.
Quali sono i migliori proxy per lo scraping di Reddit senza bruciare account?
ISP/residenziale statico è l’impostazione predefinita per Reddit legato all’account (OAuth, flussi di lavoro con accesso) – Decodo da $ 0,27/IP, IPRoyal (sticky di 7 giorni), NetNut, Bright Data ISP, Webshare ISP. Rotazione residenziale per un’ampia raccolta pubblica su Reddit: DataImpulse a $ 1 / GB è la scelta economica. Mobile (DataImpulse $ 2/GB, pool SOAX 33 milioni+) per gli account più difficili. Non utilizzare datacenter per Reddit. Abbinalo sempre a Playwright + Stealth, Camoufox o ChromeDriver non rilevato: i proxy da soli non battono Cloudflare + Behavior Fingering di Reddit.
Posso utilizzare l’archivio Pushshift Reddit nel 2026?
No, non per uso commerciale. Pushshift è limitato ai moderatori Reddit verificati per casi d’uso di moderazione cambiamenti post-2023; l’archivio pubblico Pushshift (oltre 17 miliardi di post storici risalenti al 2008) non è più disponibile per sviluppatori generici o team commerciali. Lo scraping Reddit di produzione deve essere effettuato in tempo reale o concesso in licenza tramite l’API Reddit Data.
Come posso raschiare Reddit senza essere bannato dall’account?
(1) Utilizza proxy residenziali o ISP residenziali: gli intervalli dei data center vengono contrassegnati rapidamente. (2) Abbinalo a Playwright + Stealth, Camoufox (il preferito di Reddit open source nel 2026) o ChromeDriver non rilevato per sconfiggere l’impronta digitale TLS di Cloudflare + il livello di sfida JS. (3) Cadenza lenta, simile a quella umana: 5-30 secondi tra una richiesta e l’altra, randomizzata, solo in base all’orario lavorativo dell’IP. (4) Per il lavoro OAuth/account, sessioni permanenti 24 ore su 24, 7 giorni su 7 (la sessione 7 giorni di IPRoyal è il gold standard per la cadenza Reddit di più giorni). (5) Un IP per account Reddit: non condividere mai IP tra account. (6) Riscaldare manualmente i nuovi account per 1-2 settimane prima dell’automazione. (7) Onora il robots.txt di Reddit dove puoi.
Reddit Data API vs scraping: quale è più conveniente?
Dipende dal volume. Per 1-5 milioni di record al mese: proxy residenziali interni + Playwright Stealth vincono sul costo grezzo ($ 1/GB + tempo di progettazione rispetto a $ 12.000/anno + Reddit Data API), con l’asterisco di esposizione a violazione del contratto. Oltre 5 milioni di record al mese: l’API Reddit Data o i set di dati Reddit pre-scrapped di Bright Data vincono in termini di tempo operativo e pulizia legale. Per l’assemblaggio di dati di addestramento ML su larga scala: il set di dati Reddit in blocco di Bright Data (venduto come JSON aggiornato periodicamente) è spesso la migliore combinazione legale+costo.
Proxy mobili per Reddit: quando?
Tre casi: (1) aumento della sopravvivenza del conto quando l’ISP-residenziale viene contrassegnato sugli account Reddit che raggiungono il livello di punteggio di rischio successivo; (2) Convalida dell’app mobile Reddit dove il contesto mobile presenta contenuti di feed/notifiche diversi rispetto a quelli desktop; (3) riscaldamento del nuovo account dove gli IP degli operatori di telefonia mobile sembrano più nativi durante i primi 30 giorni. SOAX (pool mobile di oltre 33 milioni), IPRoyal, DataImpulse e Bright Data offrono proxy mobili con instradamento Verizon/T-Mobile/AT&T. Prenota il cellulare per i casi più difficili: costano di più per GB.
Che dire degli accordi di licenza Reddit-Google e Reddit-OpenAI?
Reddit ha firmato accordi di licenza per la formazione sull’intelligenza artificiale con Google (~ 60 milioni di dollari/anno a partire da febbraio 2024) e OpenAI (~ 70 milioni di dollari/anno, stimati). Questi stabiliscono il prezzo massimo di fascia alta per i dati Reddit concessi in licenza e segnalano la visione di Reddit del valore commerciale del suo set di dati. Secondo quanto riferito, Reddit sta ora negoziando prezzi variabili/basati sul volume di produzione anziché tariffe annuali fisse. Per il tuo team ML/SaaS, queste offerte non cambiano nulla di pratico: rappresentano il limite massimo, non il tuo livello. Le tue opzioni rimangono: livello Standard da $ 12.000 all’anno o scraping della zona grigia con accettazione della violazione del contratto.
Dovrei preoccuparmi di Reddit-v-Perplexity (e co-imputati) ottobre 2025?
Sì, se sei un cliente Oxylabs/SerpApi/AWMProxy che esegue lo scraping di Reddit su larga scala OPPURE se sei un proxy o un fornitore di API di ricerca nello scraping di Reddit in produzione. Reddit contro Perplessità et al. (SDNY, 22 ottobre 2025) ha nominato Perplexity, SerpApi, Oxylabs UAB e AWMProxy come co-imputati. Si presume che AWMProxy abbia gestito una botnet; Si presume che Oxylabs e SerpApi abbiano fornito infrastrutture di scraping. Questo è il primo caso importante in cui Reddit ha preso di mira direttamente i fornitori di proxy e API di ricerca come co-imputati, e i risultati determineranno per anni il panorama della responsabilità dei fornitori. I risultati determineranno per anni il panorama della responsabilità dei fornitori proxy. Per la maggior parte dei team ML/SaaS che utilizzano proxy residenziali per Reddit, la lezione è: scegliere fornitori di provenienza etica con un atteggiamento di conformità documentato (ISO 27001, SOC 2, documentazione SDK di consenso) in modo che la provenienza IP faccia parte della difesa in caso di violazione del contratto. DataImpulse, Bright Data, Oxylabs e NetNut pubblicano tutti documentazione sulla provenienza; i fornitori più piccoli/economici spesso non lo fanno.
Pronto per eseguire lo scraping di Reddit con il livello proxy che sopravvive alla difesa comportamentale + Cloudflare di Reddit senza bruciare account? Inizia con DataImpulse – residenziale da $ 1/GB, data center da $ 0,50/GB, mobile da $ 2/GB, pagamento in base al consumo con oltre 90 milioni di IP di provenienza etica in 195 paesi, targeting per paese incluso (stato/città/CAP/ASN come componente aggiuntivo a pagamento), traffico che non scade mai e supporto umano 24 ore su 24, 7 giorni su 7.