
In this Article
I dati alternativi sono informazioni provenienti da fonti non tradizionali, pagine web, satelliti, transazioni e attività nelle app, che aziende e investitori usano per ottenere un vantaggio prima che quel segnale compaia nei report ufficiali. L’esempio classico è un hedge fund che conta le auto nei parcheggi dei negozi tramite immagini satellitari per prevedere le vendite trimestrali. Per la maggior parte delle aziende, però, la fonte più ampia e accessibile di dati alternativi è il web pubblico, raccolto tramite scraping, ed è per questo che i proxy sono al centro di qualsiasi seria operazione sui dati alternativi. Questa guida spiega cosa sono i dati alternativi, le principali tipologie, chi li usa e come vengono raccolti.
Sono Andrii Byzov, Fractional CMO AI-Native e realizzo pipeline di dati web. Qui trovi una definizione chiara, le fonti di dati alternativi che contano, i metodi di raccolta, il confine legale e il ruolo di DataImpulse per dati alternativi estratti dal web su larga scala.
Informazioni chiave
- I dati alternativi sono qualsiasi dataset non tradizionale usato per ricavare insight, al di fuori di bilanci standard, sondaggi e statistiche ufficiali.
- Il web pubblico è la più grande fonte accessibile per la maggior parte delle aziende: prezzi, recensioni, annunci di lavoro, cataloghi prodotti e inserzioni, raccolti tramite web scraping.
- Hedge fund e investitori ne sono stati pionieri, ma ora anche team di e-commerce, immobiliare, marketing e B2B li usano altrettanto.
- I dati alternativi estratti dal web si basano di solito sui proxy, i siti personalizzano in base alla posizione e limitano la frequenza, quindi la raccolta su larga scala si affida a residential proxy a rotazione.
- Il confine legale dipende soprattutto dal tipo di dati, i dati pubblici e non personali, come prezzi e inserzioni, sono l’area più difendibile; i dati personali sono regolamentati e conta anche il modo in cui vi accedi.
- Aggiornamento e struttura sono le parti difficili, i dati alternativi sono disordinati, non standardizzati e preziosi solo se raccolti in modo affidabile e puntuale.
Cosa sono i dati alternativi?
I dati alternativi sono informazioni raccolte da fonti non tradizionali e usate per orientare decisioni aziendali o di investimento, cioè tutto ciò che esula dagli input convenzionali come bilanci, report degli analisti e statistiche governative. Il termine viene dalla finanza, dove “alternativi” significa alternativi alle comunicazioni ufficiali che tutti già possiedono. Il valore sta nel vantaggio: un segnale che puoi leggere direttamente dal mondo prima che venga aggregato in un report trimestrale o in un dato di mercato. I prezzi in tempo reale di un rivenditore presso i concorrenti, il volume di annunci di lavoro pubblicati da un’azienda, il sentiment nelle recensioni dei prodotti: ciascuno è un dato alternativo che anticipa le prestazioni prima dei numeri ufficiali.
Il contrasto con i dati tradizionali è il punto centrale: i dati tradizionali sono in genere più standardizzati, meno tempestivi e ampiamente disponibili; i dati alternativi sono spesso meno strutturati, più tempestivi e danno un vantaggio a chi li raccoglie e interpreta per primo.
Tipologie di dati alternativi
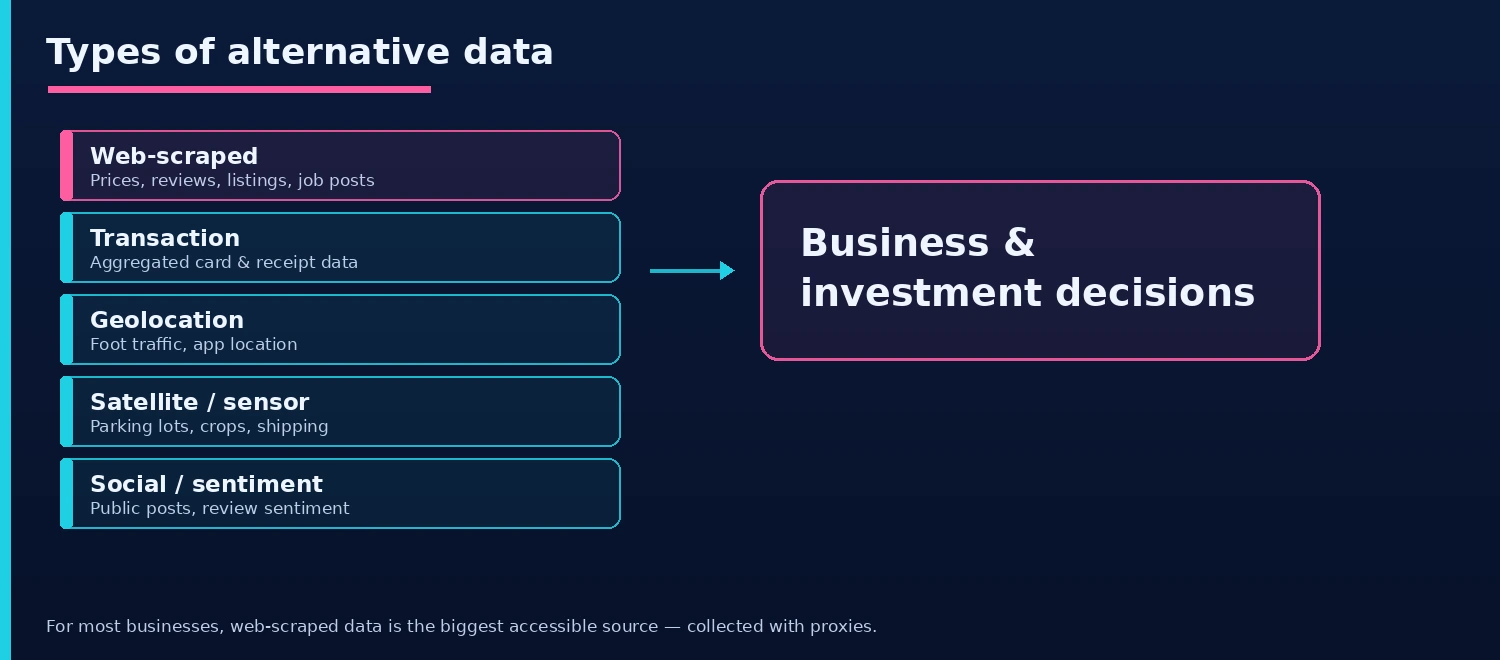
Le fonti di dati alternativi rientrano in alcune grandi categorie, dai dati estratti dal web che chiunque può raccogliere a feed insoliti acquistati solo dai grandi fondi:
| Tipo | Esempi | Come si ottengono |
|---|---|---|
| Dati estratti dal web | Prezzi, inserzioni di prodotti, recensioni, annunci di lavoro, annunci immobiliari, SERP | Web scraping (il più accessibile) |
| Dati transazionali | Dati aggregati e de-identificati di carte e ricevute (regolamentati dalla privacy) | Fornitori di dati / panel |
| Geolocalizzazione e mobilità | Affluenza pedonale, segnali di posizione delle app | SDK delle app, fornitori |
| Satelliti e sensori | Conteggi nei parcheggi, rese agricole, spedizioni | Fornitori di immagini, IoT |
| Social e sentiment | Post pubblici, sentiment delle recensioni, tendenze di ricerca | Web scraping, API |
Chi usa i dati alternativi?
Gli investitori sono stati i primi: hedge fund e gestori patrimoniali acquistano o costruiscono dati alternativi per prevedere i risultati di un’azienda prima degli utili, con prezzi estratti dal web, segnali sulle assunzioni, classifiche delle app e simili. Ma l’uso ora va ben oltre la finanza e questi team lo stanno adottando ampiamente:
- E-commerce e retail, monitoraggio dei prezzi dei concorrenti, dell’assortimento e delle scorte per definire i propri prezzi.
- Immobiliare, annunci immobiliari estratti e tendenze dei prezzi per valutazioni e investimenti.
- Marketing e brand, sentiment delle recensioni, share of voice e monitoraggio degli annunci.
- B2B e strategia, tendenze delle assunzioni, segnali sul tech stack e mappatura del mercato dai dati web pubblici.
Il filo conduttore: ogni team trasforma segnali pubblici in decisioni più rapidamente di quanto i concorrenti riescano a raccogliere, pulire o interpretare gli stessi dati.
Come vengono raccolti i dati alternativi?
Esistono tre vie principali. Acquistarli da fornitori di dati, la soluzione per feed transazionali, di geolocalizzazione e satellitari che non puoi raccogliere da solo. API, pulite e affidabili quando una fonte le offre, ma con copertura limitata e spesso con limiti di frequenza. E il web scraping, la via per la grande quantità di dati preziosi pubblici sui siti web ma privi di API: prezzi, recensioni, inserzioni e annunci di lavoro. Per la maggior parte delle aziende, è con il web scraping che avviene davvero la raccolta di dati alternativi, perché il segnale risiede nelle pagine web.
Estrarre questi dati su larga scala incontra ogni volta lo stesso ostacolo: i siti personalizzano i contenuti in base alla posizione, limitano le richieste aggressive e segnalano rapidamente gli IP datacenter. Ecco perché una pipeline di dati alternativi estratti dal web passa attraverso residential proxy, IP di utenti reali a rotazione che raccolgono dati accurati per posizione senza venire bloccati. Consulta la nostra guida ai migliori proxy per il web scraping per il livello infrastrutturale.
I dati alternativi sono legali?
La raccolta di dati alternativi è ampiamente difendibile, ma la legittimità dipende dal tipo di dati, dalla fonte e dal modo in cui vi accedi, non solo dall’attività. I dati pubblici e non personali, come prezzi, inserzioni, specifiche dei prodotti e tendenze aggregate, sono l’area più difendibile, e il loro web scraping è una pratica diffusa e di lunga data. I rischi emergono quando i dati sono personali, come nomi, profili e recapiti, dietro login, o quando contenuti protetti da copyright vengono ripubblicati integralmente, aree strettamente disciplinate da autorità e contratti. La regola pratica per un programma di dati alternativi: raccogli dati pubblici non personali, resta disconnesso, rispetta robots.txt e i limiti di frequenza, ed escludi i dati personali dalla pipeline. Per un quadro completo, consulta la nostra guida su se il web scraping è legale. Queste sono informazioni generali, non consulenza legale.
Sfide comuni
- Disordinati e non strutturati, i dati alternativi raramente arrivano puliti; prima di poterli usare servono parsing, deduplicazione e normalizzazione.
- Aggiornamento, il vantaggio svanisce rapidamente, quindi la raccolta deve seguire una pianificazione affidabile, non essere improvvisata.
- Copertura e blocchi, ottenere un’ampiezza sufficiente senza subire limiti di frequenza è il problema tecnico centrale che i proxy risolvono.
- Convalida, vale la pena agire su un segnale solo dopo aver confermato che correla con il risultato che ti interessa.
Come DataImpulse potenzia la raccolta di dati alternativi
La maggior parte dei dati alternativi che vale la pena avere si trova sul web pubblico e il collo di bottiglia per raccoglierli sono IP puliti e geo-accurati su larga scala. DataImpulse offre questo livello: residential proxy a $1/GB su oltre 90 Mln IP in 195 paesi, con una rotazione che evita che la tua raccolta venga segnalata e geotargeting, fino al livello di stato USA, affinché prezzi e inserzioni riflettano il mercato giusto. Il servizio è pay-as-you-go, con traffico che non scade mai, proxy datacenter a $0.50/GB per obiettivi meno protetti e assistenza umana 24/7. Che il segnale sia il prezzo dei concorrenti, gli annunci di lavoro o il sentiment delle recensioni, la raccolta si basa sulla stessa infrastruttura. Correlati: proxy per dati finanziari e proxy per dati di addestramento AI, oltre al caso d’uso del web scraping.
FAQ
Cosa sono i dati alternativi, in parole semplici?
I dati alternativi sono informazioni da fonti non tradizionali, pagine web, satelliti, transazioni e attività nelle app, usate per orientare decisioni aziendali o di investimento prima che il segnale compaia nei report ufficiali. Per la maggior parte delle aziende si tratta di dati web pubblici, come prezzi, recensioni, inserzioni e annunci di lavoro, raccolti tramite scraping.
Quali sono le principali tipologie di dati alternativi?
Dati estratti dal web, come prezzi, inserzioni, recensioni e annunci di lavoro; dati transazionali, come dati aggregati di carte e ricevute; geolocalizzazione e mobilità; dati satellitari e da sensori; dati social e di sentiment. I dati estratti dal web sono i più accessibili per la maggior parte delle aziende; gli altri provengono di solito da fornitori specializzati.
Chi usa i dati alternativi?
Hedge fund e investitori ne sono stati pionieri per prevedere le prestazioni aziendali, ma ora li usano ampiamente anche e-commerce, per i prezzi dei concorrenti, immobiliare, per inserzioni e valutazioni, marketing, per sentiment e monitoraggio degli annunci, e team di strategia B2B, ovunque un segnale pubblico possa orientare una decisione in anticipo.
Come vengono raccolti i dati alternativi?
In tre modi: acquistandoli da fornitori di dati, per feed transazionali, di geolocalizzazione e satellitari; tramite API quando disponibili; e con il web scraping per la grande quantità di dati pubblici preziosi privi di API. Il web scraping è dove avviene la maggior parte della raccolta di dati alternativi e, su larga scala, passa attraverso residential proxy per evitare blocchi e ottenere dati accurati per posizione.
La raccolta di dati alternativi è legale?
Raccogliere dati pubblici e non personali è ampiamente legittimo e una pratica standard. Il rischio deriva da dati personali, contenuti protetti da login o dalla ripubblicazione di materiale protetto da copyright. Resta disconnesso, raccogli dati pubblici non personali, rispetta robots.txt e i limiti di frequenza, ed escludi i dati personali dalla pipeline. Queste sono informazioni generali, non consulenza legale.
Conclusione
I dati alternativi permettono ad aziende e investitori di leggere direttamente il mondo invece di aspettare i numeri ufficiali e, per la maggior parte di loro, questi dati vivono sul web pubblico. La definizione è semplice, fonti non tradizionali usate per ottenere un vantaggio; le tipologie vanno dai dati estratti dal web a quelli satellitari; e il collo di bottiglia della raccolta è quasi sempre lo stesso: raccogliere dati web pubblici su larga scala senza essere bloccati. Se imposti correttamente il livello dei proxy, il resto della pipeline di dati alternativi, parsing, convalida e decisioni, avrà input puliti su cui lavorare.
Ultimo aggiornamento: 25 giugno 2026.