
In this Article
本指南介绍如何使用 Python 抓取 Glassdoor 的公司评价和汇总薪资数据,并同样说明其中的法律和技术边界。Glassdoor 是一个很难处理的目标:它使用 JavaScript 渲染内容,积极防御机器人,并将大量数据置于注册墙之后。因此,因此,抓取 Glassdoor 需要真实浏览器(Playwright)和住宅代理,并且必须遵循明确的界限:只访问公开页面,尽量少保存内容,绝不绕过登录。同时还应了解,Glassdoor 的条款本身限制自动化访问。
我是 Andrii Byzov,一名专注于构建网络数据管道的 AI 原生兼职 CMO。下文将介绍:你可以和不可以在 Glassdoor 上抓取什么、需要提前了解的法律注意事项,以及用于公开评价和薪资页面的可运行代码模式。
关键事实
- Glassdoor 由 JavaScript 渲染且防护严密。普通的
requests往往不够,通常需要 Playwright 这类无头浏览器。 - Glassdoor 的条款限制未经书面许可的自动化访问。因此,即使抓取公开的未登录页面,也可能违反其 ToS。登录墙是额外风险,而不是唯一界线。
- 评论是带有个人属性的用户生成内容。Glassdoor 本身也表示无法保证匿名性。尽量减少保留的数据,不要存储身份信息,也不要重新发布评论文本。
- 住宅代理有助于规模化采集。Glassdoor 会迅速限速并标记数据中心 IP,但没有任何工具能保证访问成功或使抓取行为合规。
- 请将本文视为教育用途。 对于任何商业用途或规模化操作,请获得 Glassdoor 的许可并寻求法律建议。
在 Glassdoor 上可以和不可以抓取的内容
先明确这条界限,是让 Glassdoor 抓取项目尽可能合规的关键,也是整个抓取流程中最重要的决策。
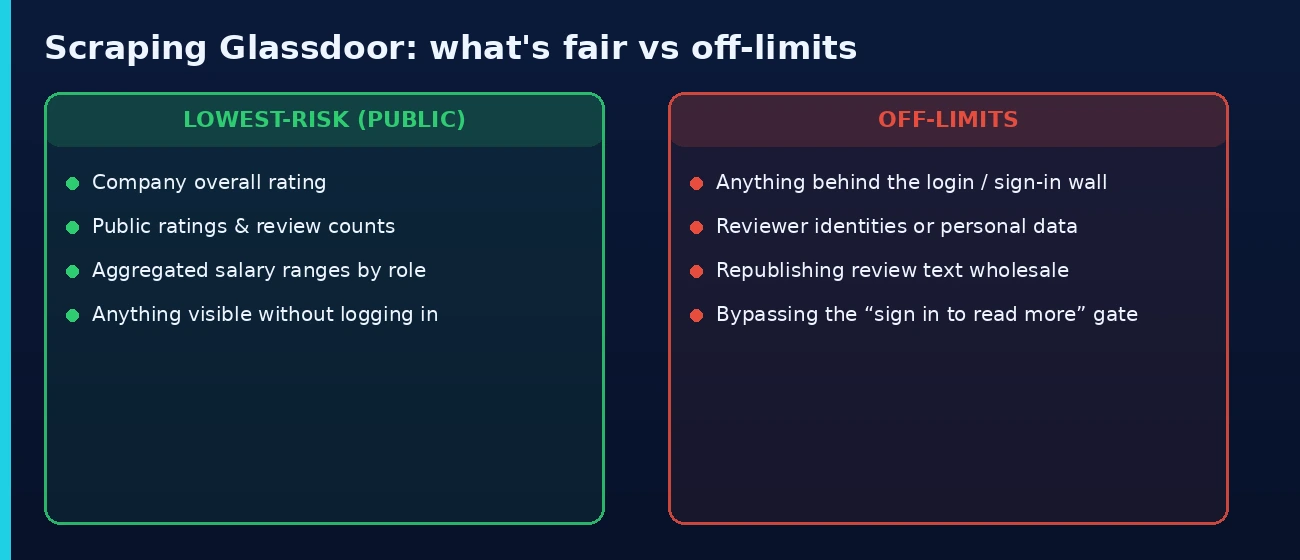
- 风险最低(公开、非个人):公司总体评分和按职位汇总的薪资范围,也就是 Glassdoor 无需账户即可展示的主要数据。
- 谨慎使用(公开但敏感):评论摘要(评分、优点/缺点文本)虽为公开内容,但属于带有个人属性的用户生成内容。如果收集这类内容,应尽量最小化处理:保留汇总信号,去除身份信息,绝不重新发布原文。
- 不可触碰:任何位于登录/注册墙之后的内容、评论者身份或任何个人数据,以及重新发布评论内容。不要绕过“sign in to read more”的访问限制。
抓取 Glassdoor 合法吗?
这取决于具体情况,而且这里的限制比大多数网站更为严格。Glassdoor 的服务条款限制未经书面许可的自动化访问,因此,即使抓取公开的、未登录页面,也可能违反其 ToS;登录墙只是额外风险,并不是唯一风险。此外,许多内容受登录限制,评论又属于用户生成内容,涉及版权和隐私问题。风险最低的做法是:保持未登录状态,优先使用公开汇总数据(评分、薪资范围),尽量最小化收集并且不存储个人数据,遵守 robots.txt 和速率限制,不重新发布评论文本,并为任何商业用途取得 Glassdoor 的许可。如需完整框架,请参阅我们的指南:网络抓取是否合法。这是一般信息,不构成法律建议;在开展任何商业性 Glassdoor 数据项目前,请先咨询法律顾问。
步骤 1:设置环境
由于 Glassdoor 大量依赖 JavaScript,应通过 Playwright 驱动真实浏览器,而不是直接发送原始 HTTP 请求。
# Glassdoor renders content with JavaScript and defends hard, so use a
# real browser (Playwright) rather than plain requests.
pip install playwright beautifulsoup4
playwright install chromium
第 2 步:加载公开的 Glassdoor 页面
通过住宅代理启动无头 Chromium,并加载一个公开的公司评价 URL,无需登录。浏览器会执行页面的 JavaScript,因此在你读取 HTML 之前,评价内容会先完成渲染。
from playwright.sync_api import sync_playwright
# Route the browser through a residential proxy (see Step 4)
PROXY = {"server": "http://gw.dataimpulse.com:823",
"username": "YOUR_DI_LOGIN", "password": "YOUR_DI_PASSWORD"}
def get_html(url):
with sync_playwright() as p:
browser = p.chromium.launch(proxy=PROXY, headless=True)
page = browser.new_page(locale="en-US")
page.goto(url, wait_until="networkidle", timeout=60000)
html = page.content()
browser.close()
return html
# A PUBLIC company reviews page (do not log in)
html = get_html("https://www.glassdoor.com/Reviews/Example-Company-Reviews-E12345.htm")
步骤 3:抓取公开的 Glassdoor 评论
要抓取 Glassdoor 评论,可将公开可见的评论卡片解析为结构化字段,如 rating、title、pros、cons 和 date。Glassdoor 的类名经过混淆且经常变化,因此请在 DevTools 中确认当前选择器;下面的 data-test 属性仅作示例。
from bs4 import BeautifulSoup
def parse_reviews(html):
"""Parse the publicly visible reviews. Selectors change often —
confirm the current ones in DevTools before relying on them."""
soup = BeautifulSoup(html, "html.parser")
reviews = []
for card in soup.select('[data-test="review-details"]'):
def t(sel):
el = card.select_one(sel)
return el.get_text(strip=True) if el else None
reviews.append({
"rating": t('[data-test="review-rating"]'),
"title": t('[data-test="review-title"]'),
"pros": t('[data-test="pros"]'),
"cons": t('[data-test="cons"]'),
"date": t('[data-test="review-date"]'),
})
return reviews
print(parse_reviews(html)[:3])
步骤 4:抓取汇总薪资数据
Glassdoor 的薪资页面会按职位显示汇总数据,包括薪资基数中位数和范围,而非个人信息。这种公开的汇总视图才是适合采集的内容,可按同样的方式抓取。
def parse_salaries(html):
"""Parse aggregated, public salary ranges (role-level, not individuals)."""
soup = BeautifulSoup(html, "html.parser")
rows = []
for row in soup.select('[data-test="salary-row"]'):
def t(sel):
el = row.select_one(sel)
return el.get_text(strip=True) if el else None
rows.append({
"job_title": t('[data-test="job-title"]'),
"base_pay": t('[data-test="median-base"]'),
"range": t('[data-test="pay-range"]'),
})
return rows
salary_html = get_html("https://www.glassdoor.com/Salaries/example-company-salaries-E12345.htm")
print(parse_salaries(salary_html)[:3])
步骤 5:应对 Glassdoor 的反机器人防护
Glassdoor 采用严格的反机器人技术,包括 IP 声誉评分、速率限制和机器人检测挑战。没有任何方法能保证绕过这些防护,而且使用浏览器和代理也不代表抓取行为合规。不过,有两项措施可以减少公开页面被封锁的情况:带有真实请求头的真实浏览器上下文,以及使用 轮换住宅代理,避免单个 IP 的请求量过高。在这里,数据中心 IP 很快就会被标记;DataImpulse residential proxies($1/GB,支持轮换,覆盖 195 个国家/地区)可使请求更接近真实用户流量。控制请求频率。高频请求 Glassdoor 会导致访问被封锁,并可能增加服务器负载,从而削弱你的法律立场。
# Rotate residential IPs and look like a real browser.
# Use a fresh session id per run so each crawl gets a clean IP.
PROXY = {"server": "http://gw.dataimpulse.com:823",
"username": "YOUR_DI_LOGIN__cr.us;sid.run1",
"password": "YOUR_DI_PASSWORD"}
def fetch(url):
with sync_playwright() as p:
browser = p.chromium.launch(proxy=PROXY, headless=True)
ctx = browser.new_context(
locale="en-US",
user_agent=("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
"(KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36"),
viewport={"width": 1366, "height": 900},
)
page = ctx.new_page()
page.goto(url, wait_until="networkidle") # pace requests; Glassdoor rate-limits
html = page.content()
browser.close() # always clean up the browser
return html
步骤 6:导出数据
将收集到的公开汇总数据保存为 JSON 和 CSV。避免包含个人数据,只存储评分和汇总文本,不保存评论者身份。
import json, csv
reviews = parse_reviews(html)
with open("glassdoor_reviews.json", "w", encoding="utf-8") as f:
json.dump(reviews, f, indent=2, ensure_ascii=False)
if reviews:
with open("glassdoor_reviews.csv", "w", newline="", encoding="utf-8") as f:
w = csv.DictWriter(f, fieldnames=reviews[0].keys())
w.writeheader(); w.writerows(reviews)
常见问题
抓取 Glassdoor 合法吗?
这取决于具体情况,而且相关限制不容忽视:Glassdoor 的条款限制在未经书面许可的情况下进行自动化访问,因此即使抓取公开页面也可能违反其 ToS,网站的大部分内容需要登录才能访问,评论也属于受版权保护的带有个人属性的用户生成内容。如果你仍要继续,风险最低的做法是仅收集公开的聚合数据(评分、薪资范围),保持未登录状态,尽量减少采集,不重新发布评论内容,并为商业用途获取许可/法律顾问意见。这是一般信息,不构成法律建议。请参阅我们的网页抓取合法性指南。
我可以在不登录的情况下抓取 Glassdoor 吗?
可以,而且应保持未登录状态。Glassdoor 会公开显示一些公司评分、评论摘要和聚合薪资数据。抓取登录后的内容意味着违反你在登录时接受的条款,这属于高风险区域。只收集无需账户即可看到的内容。
为什么简单的 requests 脚本无法在 Glassdoor 上工作?
Glassdoor 使用 JavaScript 渲染内容并运行机器人检测,因此普通 HTTP 请求只能返回很少的可用数据或一个验证页面。你需要一个能够执行页面 JavaScript 的无头浏览器(Playwright 或类似工具),再配合住宅代理以避免被标记。
抓取 Glassdoor 需要代理吗?
如果要抓取的页面不止少量,通常需要。Glassdoor 会进行速率限制,并且会很快标记数据中心 IP,因此单个 IP 很快就会被封锁。轮换住宅代理可以将请求分散到大量真实用户 IP 上,有助于规模化采集并降低触发防护机制的概率。
我可以抓取个人薪资或评论者姓名吗?
不可以,也不应这样做。Glassdoor 薪资数据应以聚合形式读取(按职位统计的中位数和范围),评论者身份属于个人数据,属于受监管的个人数据。只收集聚合的、非个人化的信号。