
In this Article
Ten poradnik pokazuje, jak scrapować Glassdoor w Pythonie, zbierać opinie o firmach i zagregowane dane o wynagrodzeniach, a co równie ważne, gdzie przebiegają granice prawne i techniczne. Glassdoor to trudny cel: renderuje treść za pomocą JavaScript, agresywnie broni się przed botami i ukrywa dużą część danych za rejestracją. Scraper Glassdoor potrzebuje więc prawdziwej przeglądarki (Playwright), residential proxy i jasnej zasady, by pozostać po właściwej stronie granicy: ogranicz się do stron publicznych, minimalizuj zakres przechowywanych danych i nigdy nie omijaj logowania, pamiętając, że regulamin Glassdoor już sam w sobie ogranicza zautomatyzowany dostęp.
Jestem Andrii Byzov, AI-Native Fractional CMO, który tworzy potoki danych z sieci. Poniżej znajdziesz informacje o tym, co możesz, a czego nie możesz scrapować w Glassdoor, zastrzeżenia prawne na początek oraz działające wzorce kodu dla publicznych stron z opiniami i wynagrodzeniami.
Najważniejsze fakty
- Glassdoor renderuje treść w JavaScript i jest silnie chroniony — zwykłe
requestsczęsto nie wystarcza; zazwyczaj potrzebujesz przeglądarki bez interfejsu, takiej jak Playwright. - Regulamin Glassdoor ogranicza zautomatyzowany dostęp bez pisemnej zgody — dlatego nawet scrapowanie publicznych stron bez logowania może naruszać jego ToS. Bariera logowania stanowi dodatkowe ryzyko, a nie jedyną granicę.
- Opinie to generowane przez użytkowników treści częściowo osobiste — Samo Glassdoor zaznacza, że anonimowość nie jest gwarantowana. Minimalizuj zakres przechowywanych danych, nie zapisuj tożsamości i nie publikuj ponownie tekstów opinii.
- Residential proxy pomagają na większą skalę — Glassdoor szybko ogranicza liczbę żądań i oznacza adresy IP z datacenter, ale żadne narzędzie nie gwarantuje dostępu ani nie sprawia, że scrapowanie jest zgodne z wymaganiami.
- Traktuj to jako materiał edukacyjny. W przypadku działań komercyjnych lub na większą skalę uzyskaj zgodę Glassdoor i poradę prawną.
Co możesz, a czego nie możesz scrapować w Glassdoor
Wyznaczenie tej granicy na początku sprawia, że projekt scrapowania Glassdoor jest możliwie najlepiej uzasadniony, i jest to najważniejsza decyzja w każdym procesie scrapowania Glassdoor.
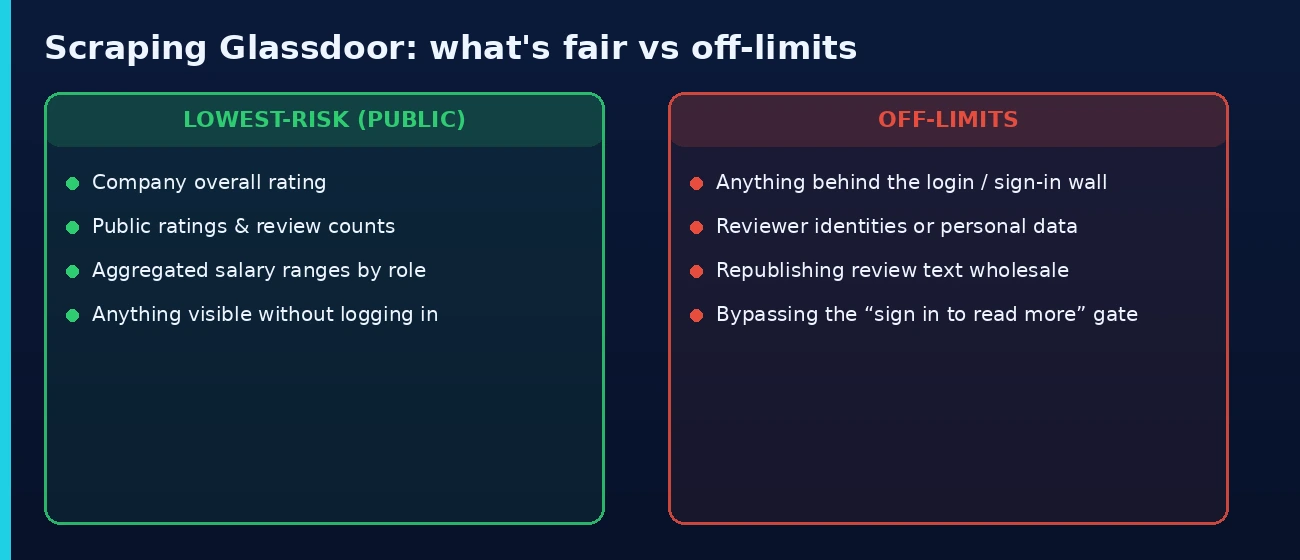
- Najmniejsze ryzyko (publiczne, nieosobowe): ogólna ocena firmy i zagregowane przedziały wynagrodzeń według stanowiska, czyli główne dane, które Glassdoor wyświetla bez konta.
- Korzystaj ostrożnie (publiczne, ale wrażliwe): fragmenty opinii (ocena, tekst zalet i wad) są publiczne, lecz generowane przez użytkowników i częściowo osobiste. Jeśli je zbierasz, minimalizuj zakres: zachowaj zagregowany sygnał, usuń tożsamości i nigdy nie publikuj tekstu ponownie.
- Poza zakresem: wszystko, co znajduje się za barierą logowania/rejestracji, tożsamości autorów opinii lub jakiekolwiek dane osobowe, a także ponowne publikowanie treści opinii. Nie omijaj blokady “zaloguj się, aby przeczytać więcej”.
Czy scrapowanie Glassdoor jest legalne?
To zależy, a zastrzeżenia są tu ważniejsze niż na większości stron. Regulamin Glassdoor ogranicza zautomatyzowany dostęp bez pisemnej zgody, więc nawet scrapowanie publicznych stron bez logowania może naruszać jego ToS. Bariera logowania stanowi dodatkowe ryzyko, a nie jedyne. Ponadto duża część treści wymaga logowania, a opinie są treściami tworzonymi przez użytkowników, które mają znaczenie z perspektywy praw autorskich i prywatności. Podejście o najmniejszym ryzyku: pozostań wylogowany, wybieraj publiczne dane zagregowane (oceny, przedziały wynagrodzeń), minimalizuj zakres i nie przechowuj danych osobowych, respektuj robots.txt i limity żądań, nie publikuj tekstów opinii ponownie oraz uzyskaj zgodę Glassdoor na wszelkie działania komercyjne. Pełne omówienie znajdziesz w naszym poradniku czy web scraping jest legalny. To są informacje ogólne, a nie porada prawna; przed każdym komercyjnym projektem wykorzystującym dane Glassdoor skonsultuj się z prawnikiem.
Krok 1. Skonfiguruj środowisko
Ponieważ Glassdoor intensywnie korzysta z JavaScript, scraper steruje prawdziwą przeglądarką przez Playwright zamiast wysyłać surowe żądania HTTP.
# Glassdoor renders content with JavaScript and defends hard, so use a
# real browser (Playwright) rather than plain requests.
pip install playwright beautifulsoup4
playwright install chromium
Krok 2. Wczytaj publiczną stronę Glassdoor
Uruchom Chromium bez interfejsu przez residential proxy i wczytaj publiczny URL strony z opiniami o firmie, bez logowania. Przeglądarka wykona JavaScript strony, dzięki czemu opinie zostaną wyrenderowane, zanim odczytasz HTML.
from playwright.sync_api import sync_playwright
# Route the browser through a residential proxy (see Step 4)
PROXY = {"server": "http://gw.dataimpulse.com:823",
"username": "YOUR_DI_LOGIN", "password": "YOUR_DI_PASSWORD"}
def get_html(url):
with sync_playwright() as p:
browser = p.chromium.launch(proxy=PROXY, headless=True)
page = browser.new_page(locale="en-US")
page.goto(url, wait_until="networkidle", timeout=60000)
html = page.content()
browser.close()
return html
# A PUBLIC company reviews page (do not log in)
html = get_html("https://www.glassdoor.com/Reviews/Example-Company-Reviews-E12345.htm")
Krok 3. Scrapuj publiczne opinie z Glassdoor
Aby scrapować opinie z Glassdoor, przeanalizuj publicznie widoczne karty opinii do ustrukturyzowanych pól: ocena, tytuł, zalety, wady, data. Nazwy klas Glassdoor są zaciemnione i często się zmieniają, więc potwierdź aktualne selektory w DevTools; poniższe atrybuty data-test mają charakter przykładowy.
from bs4 import BeautifulSoup
def parse_reviews(html):
"""Parse the publicly visible reviews. Selectors change often —
confirm the current ones in DevTools before relying on them."""
soup = BeautifulSoup(html, "html.parser")
reviews = []
for card in soup.select('[data-test="review-details"]'):
def t(sel):
el = card.select_one(sel)
return el.get_text(strip=True) if el else None
reviews.append({
"rating": t('[data-test="review-rating"]'),
"title": t('[data-test="review-title"]'),
"pros": t('[data-test="pros"]'),
"cons": t('[data-test="cons"]'),
"date": t('[data-test="review-date"]'),
})
return reviews
print(parse_reviews(html)[:3])
Krok 4. Scrapuj zagregowane dane o wynagrodzeniach
Strony z wynagrodzeniami Glassdoor pokazują zagregowane dane według stanowiska: medianę wynagrodzenia podstawowego i przedziały, a nie dane poszczególnych osób. Ten zagregowany, publiczny widok jest właściwym zakresem do zbierania; pobieraj go w ten sam sposób.
def parse_salaries(html):
"""Parse aggregated, public salary ranges (role-level, not individuals)."""
soup = BeautifulSoup(html, "html.parser")
rows = []
for row in soup.select('[data-test="salary-row"]'):
def t(sel):
el = row.select_one(sel)
return el.get_text(strip=True) if el else None
rows.append({
"job_title": t('[data-test="job-title"]'),
"base_pay": t('[data-test="median-base"]'),
"range": t('[data-test="pay-range"]'),
})
return rows
salary_html = get_html("https://www.glassdoor.com/Salaries/example-company-salaries-E12345.htm")
print(parse_salaries(salary_html)[:3])
Krok 5. Omijaj zabezpieczenia antybotowe Glassdoor
Glassdoor korzysta z agresywnego zestawu zabezpieczeń antybotowych: oceny reputacji IP, ograniczania liczby żądań i wyzwań wykrywających boty. Nie ma gwarantowanego sposobu obejścia, a przeglądarka wraz z proxy nie czyni scrapowania zgodnym z wymaganiami, lecz dwie rzeczy zmniejszają liczbę blokad na stronach publicznych: kontekst prawdziwej przeglądarki z realistycznymi headers oraz rotating residential proxies, dzięki którym żaden pojedynczy IP nie zostanie wyczerpany. IP z datacenter są tu szybko oznaczane; DataImpulse residential proxies ($1/GB, rotating, 195 countries) wyglądają jak prawdziwi użytkownicy. Rozkładaj żądania w czasie: intensywne obciążanie Glassdoor prowadzi do blokady i zwiększa problemy z obciążeniem serwera, które osłabiają Twoją pozycję prawną.
# Rotate residential IPs and look like a real browser.
# Use a fresh session id per run so each crawl gets a clean IP.
PROXY = {"server": "http://gw.dataimpulse.com:823",
"username": "YOUR_DI_LOGIN__cr.us;sid.run1",
"password": "YOUR_DI_PASSWORD"}
def fetch(url):
with sync_playwright() as p:
browser = p.chromium.launch(proxy=PROXY, headless=True)
ctx = browser.new_context(
locale="en-US",
user_agent=("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
"(KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36"),
viewport={"width": 1366, "height": 900},
)
page = ctx.new_page()
page.goto(url, wait_until="networkidle") # pace requests; Glassdoor rate-limits
html = page.content()
browser.close() # always clean up the browser
return html
Krok 6. Wyeksportuj dane
Zapisz zebrane publiczne, zagregowane dane w JSON i CSV. Nie uwzględniaj danych osobowych: przechowuj oceny i zagregowany tekst, a nie tożsamości autorów opinii.
import json, csv
reviews = parse_reviews(html)
with open("glassdoor_reviews.json", "w", encoding="utf-8") as f:
json.dump(reviews, f, indent=2, ensure_ascii=False)
if reviews:
with open("glassdoor_reviews.csv", "w", newline="", encoding="utf-8") as f:
w = csv.DictWriter(f, fieldnames=reviews[0].keys())
w.writeheader(); w.writerows(reviews)
Najczęściej zadawane pytania
Czy scrapowanie Glassdoor jest legalne?
To zależy, a zastrzeżenia są realne: regulamin Glassdoor ogranicza zautomatyzowany dostęp bez pisemnej zgody, więc nawet scrapowanie stron publicznych może naruszać jego ToS, duża część serwisu wymaga logowania, a opinie są chronionymi prawem autorskim, częściowo osobistymi treściami użytkowników. Jeśli działasz dalej, podejście o najmniejszym ryzyku to wyłącznie publiczne dane zagregowane (oceny, przedziały wynagrodzeń), bez logowania, w zminimalizowanym zakresie i bez ponownego publikowania, a w przypadku zastosowania komercyjnego uzyskaj zgodę i poradę prawną. To są informacje ogólne, a nie porada prawna. Zobacz nasz poradnik o legalności web scrapingu.
Czy mogę scrapować Glassdoor bez logowania?
Tak, i powinieneś pozostać wylogowany. Glassdoor publicznie pokazuje niektóre oceny firm, fragmenty opinii i zagregowane dane o wynagrodzeniach. Scrapowanie za logowaniem oznacza naruszenie warunków zaakceptowanych przy logowaniu, co jest strefą ryzyka. Zbieraj wyłącznie to, co jest widoczne bez konta.
Dlaczego prosty skrypt requests nie działa w Glassdoor?
Glassdoor renderuje treść za pomocą JavaScript i stosuje wykrywanie botów, więc zwykłe żądanie HTTP zwraca niewiele użytecznych danych albo stronę z wyzwaniem. Potrzebujesz przeglądarki bez interfejsu (Playwright lub podobnej), która wykonuje JS strony, oraz residential proxy, aby uniknąć oznaczenia.
Czy potrzebuję proxy, aby scrapować Glassdoor?
W przypadku więcej niż kilku stron, tak. Glassdoor szybko ogranicza liczbę żądań i oznacza IP z datacenter, więc pojedynczy IP szybko zostaje zablokowany. Rotating residential proxies rozkładają żądania na wiele IP prawdziwych użytkowników i pozwalają zbierać dane na większą skalę bez uruchamiania zabezpieczeń.
Czy mogę scrapować indywidualne wynagrodzenia lub nazwiska autorów opinii?
Nie i nie powinieneś tego robić. Dane o wynagrodzeniach w Glassdoor są przeznaczone do odczytu w postaci zagregowanej (median i przedziałów według stanowiska), a tożsamości autorów opinii to dane osobowe objęte regulacjami. Zbieraj wyłącznie zagregowany, nieosobowy sygnał.
Podsumowanie
Scrapowanie Glassdoor jest możliwe, lecz ograniczone: to strona renderowana w JavaScript i dobrze chroniona, na której większość wartościowych treści jest zablokowana, więc działający scraper Glassdoor potrzebuje przeglądarki bez interfejsu i rotating residential proxies oraz twardej zasady zbierania wyłącznie publicznych, nieosobowych danych zagregowanych bez omijania logowania. Zadbaj o warstwę techniczną dzięki Playwright i residential proxies, pozostań w możliwym do uzasadnienia zakresie i zapoznaj się z naszym poradnikiem najlepsze proxy do web scrapingu, aby poznać szerszą konfigurację.
Ostatnia aktualizacja: 25 czerwca 2026 r.