
In this Article
Google Trends をスクレイピングする前に、実際に何を収集するのかを理解しておくことが重要です。Google Trends は絶対的な検索ボリュームを公開していません。返されるのは0から100に正規化された関心指数で、指定したクエリ、地域、期間の中で最も高い時点を基準にスケーリングされています。
この記事では、データを取得する主な方法を紹介します。組み込みの CSV エクスポート、ドキュメント化されていないウィジェットの JSON エンドポイント、Python ライブラリの pytrends、そしてヘッドレスブラウザによる代替手段です。また、Google から 429 エラーが返される場合に、ローテーティング住宅用プロキシが役立つ理由と、実際に想定すべき制約も説明します。
DataImpulse は倫理的なプロキシプロバイダーで、195か国にわたって9,000万を超える住宅用、モバイル、データセンターの IP アドレスを提供しています。1GB あたり1ドルからの従量課金モデルを採用し、トラフィックは失効しません。ウェブスクレイピング、広告検証、価格監視、市場調査、複数アカウントの管理に利用できます。
重要なポイント
- Google Trends は生の件数ではなく相対的な指数を返します: 各値は選んだクエリ、地域、期間のピークを基準に0から100にスケーリングされるため、スクレイピングした数値は絶対的な検索ボリュームではなく比較値になります。
- 最適なプロキシの種類: ローテーティング住宅用プロキシ。検出されにくい実在の消費者向け IP を使用します。
- 料金: 1GB あたり1ドルから、従量課金制で、トラフィックは失効せず、サブスクリプションもありません。
- カバレッジ: 195か国にわたる9,000万以上の倫理的に調達された IP。
- 信頼性: 成功率99.51%、G2 で5点満点中4.8点の評価。
- プロトコルとターゲティング: HTTP、HTTPS、SOCKS5 に対応し、国別ターゲティングを標準で含みます。
Google Trends は実際にどんなデータを提供するのか?
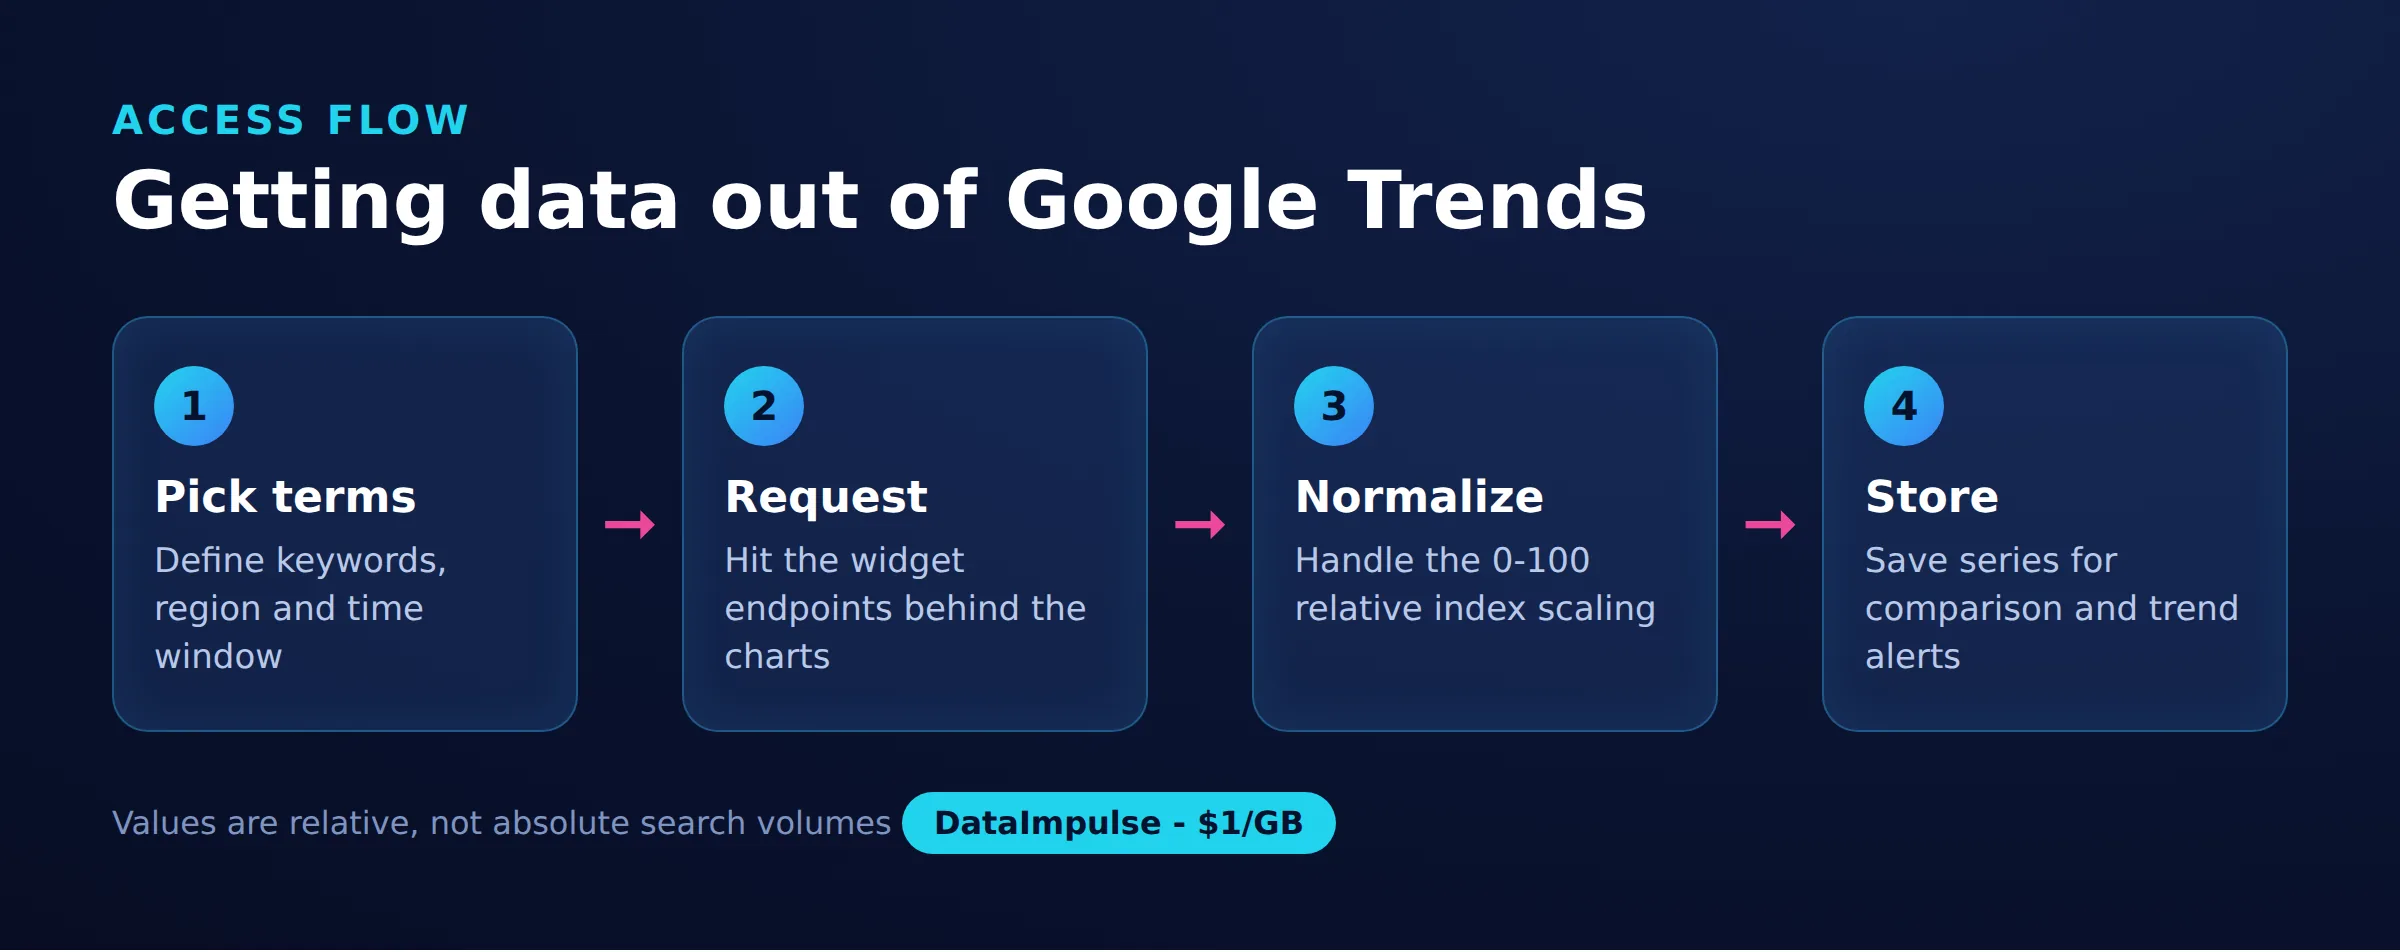
Google Trends が提供するのは検索回数ではなく、0から100の相対的な関心指数です。各ポイントは、クエリと期間におけるピーク値が100になるように正規化され、他のすべてのポイントはそれを基準にスケーリングされます。
これはあらゆるスクレイピング作業で重要です。なぜなら、2つの別々のエクスポートを絶対的な件数であるかのように直接比較することはできないからです。ある国で100を記録した用語と、別の国で100を記録した用語は、それぞれが自分のピークにあるのであって、同じ実世界のボリュームにあるわけではありません。用語を公平に比較するには、同じクエリでまとめてリクエストし、Google に共通の1つのスケールで正規化させてください。取得できる主なデータビューは、時系列の関心、地域別の関心、関連クエリ、関連トピックです。
Google Trends のデータを CSV としてエクスポートするには?
最も簡単な方法は、Google Trends のインターフェースに組み込まれた公式の CSV エクスポートです。Trends の結果ページでは、各ウィジェットにダウンロードアイコンがあり、そのビューを CSV ファイルとして保存できます。
これはサポートされた機能を使うため、最も正規かつ安定した選択肢であり、たまの調査や少数のキーワードには十分です。トレードオフは、手作業であること、一度に1つのウィジェットと1つのクエリしか扱えないこと、そして数百の用語には対応できないことです。コンテンツ計画のためのわずかな比較や手軽な市場チェックだけが必要なら、CSV エクスポートは自動スクレイピングに伴う信頼性の問題を完全に回避できます。
Google Trends のウィジェット JSON エンドポイントはどう動くのか?
Trends のサイトは、フロントエンドが各ウィジェットを描画するために呼び出す内部の JSON エンドポイントによって動いています。これらを直接スクレイピングするのがプログラムで取得する最速の方法ですが、ドキュメント化されておらず、予告なく変更されることがあります。
フローは2段階です。まずキーワード、地域、期間を付けて explore エンドポイントを呼び出すと、ウィジェットのトークンのセットが返されます。次に各トークンを、時系列の関心用など対応するデータエンドポイントに渡すと、実際の系列が JSON として受け取れます。実務上、注意すべき点が2つあります:
- レスポンスには anti-JSON の文字が接頭辞として付いており、パースする前に取り除く必要があります。
- トークンは短命なので、長くキャッシュしたり、セッションをまたいで再利用したりはできません。
これらのエンドポイントは非公式なので、これらを利用するスクレイパーは、Google がレスポンス形式を変更した場合に保守が必要になることを前提にしてください。
Google Trends のスクレイピングに pytrends を使うべきか?
pytrends は、上で説明したウィジェットエンドポイントをラップする人気の非公式 Python ライブラリで、最も手早く始められる方法です。実際に便利ですが、明確な期待を持って使うべきです。
pytrends は Google の公式製品ではありません。Google がエンドポイントを変更すると動作しなくなることがあり、レート制限も厳しいため、短時間にある程度の数を超えるリクエストを送るとすぐに 429 エラーが返されます。継続的な大量収集よりも、調査規模の作業に向いています。リクエストを複数の IP に分散するためにプロキシリストを指定した、基本的な時系列の関心データの取得例は次のとおりです:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
複数のプロキシをローテーションすれば、単一の IP が Google のアドレス単位の制限に達するのを防げます。リトライとバックオフの設定は、一時的な失敗の影響を抑えます。
なぜローテーティング住宅用プロキシは 429 エラーに役立つのか?
ローテーティング住宅用プロキシが役立つのは、Google が Trends のリクエストを IP アドレス単位で制限しており、あるアドレスが制限対象になると、429 Too Many Requests のレスポンスを受け取り続けるためです。多数の住宅用 IP にリクエストを分散し、指数バックオフと組み合わせることで、各アドレスをしきい値未満に保てます。
住宅用 IP は実在の消費者向けデバイスから来ているため、Google がより積極的に認識して制限するデータセンターのレンジよりも、通常のトラフィックとして扱われやすくなります。ローテーションでは、各リクエストまたは小規模なバッチが異なるアドレスから送信されるため、単一の IP にブロックされるほどのリクエストが集中しません。そのため、この用途では住宅用プロキシですが、コストがステルス性より重要な軽量で低頻度の作業なら、データセンタープロキシも利用できます。DataImpulse は195か国の9,000万以上の IP でローテーティングおよびスティッキーセッションを提供し、国別ターゲティングを標準で含むため、対象地域内の IP を使って、地域固有の Trends データを収集することもできます。
ローテーションだけでは十分ではありません。意図的に速度を落とす必要もあります。中心となるパターンは、429 を捕捉し、試行ごとに2倍になる遅延を待ち、失敗した対象に対する再試行が無限に続かないよう、一定回数で打ち切ることです:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
raise RuntimeError("Rate limited after retries")このバックオフをプロキシのローテーションと、成功したリクエストの間にランダムな待機時間を設けることと組み合わせてください。同じアンチブロッキングの原則は、あらゆる大規模な収集作業にも当てはまります。詳しくはブロックを避けてスクレイピングするガイドで解説しています。
代わりにヘッドレスブラウザを使うべきなのはいつか?
JSON エンドポイントが使えなくなった場合や、単純な HTTP クライアントでは対応できない認証チャレンジが返される場合は、ヘッドレスブラウザを使ってください。Playwright や Selenium のようなツールは、本物の Trends ページを読み込み、その JavaScript を実行し、描画されたウィジェットのデータを読み取ったり、ページが行うネットワーク通信を傍受したりできます。
このアプローチはセッションごとに完全なブラウザを動かすため、重く遅くなりますが、フロントエンドの変更に強く、単純なリクエストベースのスクレイパーを壊す一部のインタラクティブなチェックにも対応できます。自動化されたセッションも通常の訪問者によるアクセスに近づけるために、ブラウザをプロキシ、理想的にはモバイルプロキシまたは住宅用 IP 経由でルーティングしてください。ヘッドレスブラウザは根本的なレート制限を解消するわけではない点に注意してください。依然としてリクエストのペース配分と IP のローテーションが必要で、直接エンドポイント方式よりもリクエストあたりのオーバーヘッドも大きくなります。
スクレイピングした Google Trends のデータは何に使えるのか?
スクレイピングした Google Trends のデータは、正確なボリュームよりも相対的な方向性と季節性を見つけるのに最も役立ちます。数値は正規化された指数であるため、トラフィックの予測値ではなく、関心が高まっているか低下しているかを示すシグナルとして扱ってください。
一般的なユースケースには次のものがあります:
- SEO とコンテンツ計画: 関連する用語を同じスケールで比較し、どのトピックを優先するか、そして年間のどこで関心がピークに達するかを判断します。
- 製品需要: リソースを投じる前に、あるカテゴリーや機能への関心が伸びているか衰えているかを追跡します。
- 市場のタイミング: 季節的なパターンと地域差を活用し、関心が最も高まる時期にキャンペーンやローンチを計画します。
重要な限界は、Trends だけでは絶対的な需要やコンバージョン価値を教えてくれないことです。相対的なシグナルを意思決定に変えるには、検索ボリュームツール、売上データ、広告プラットフォームの数値と組み合わせてください。
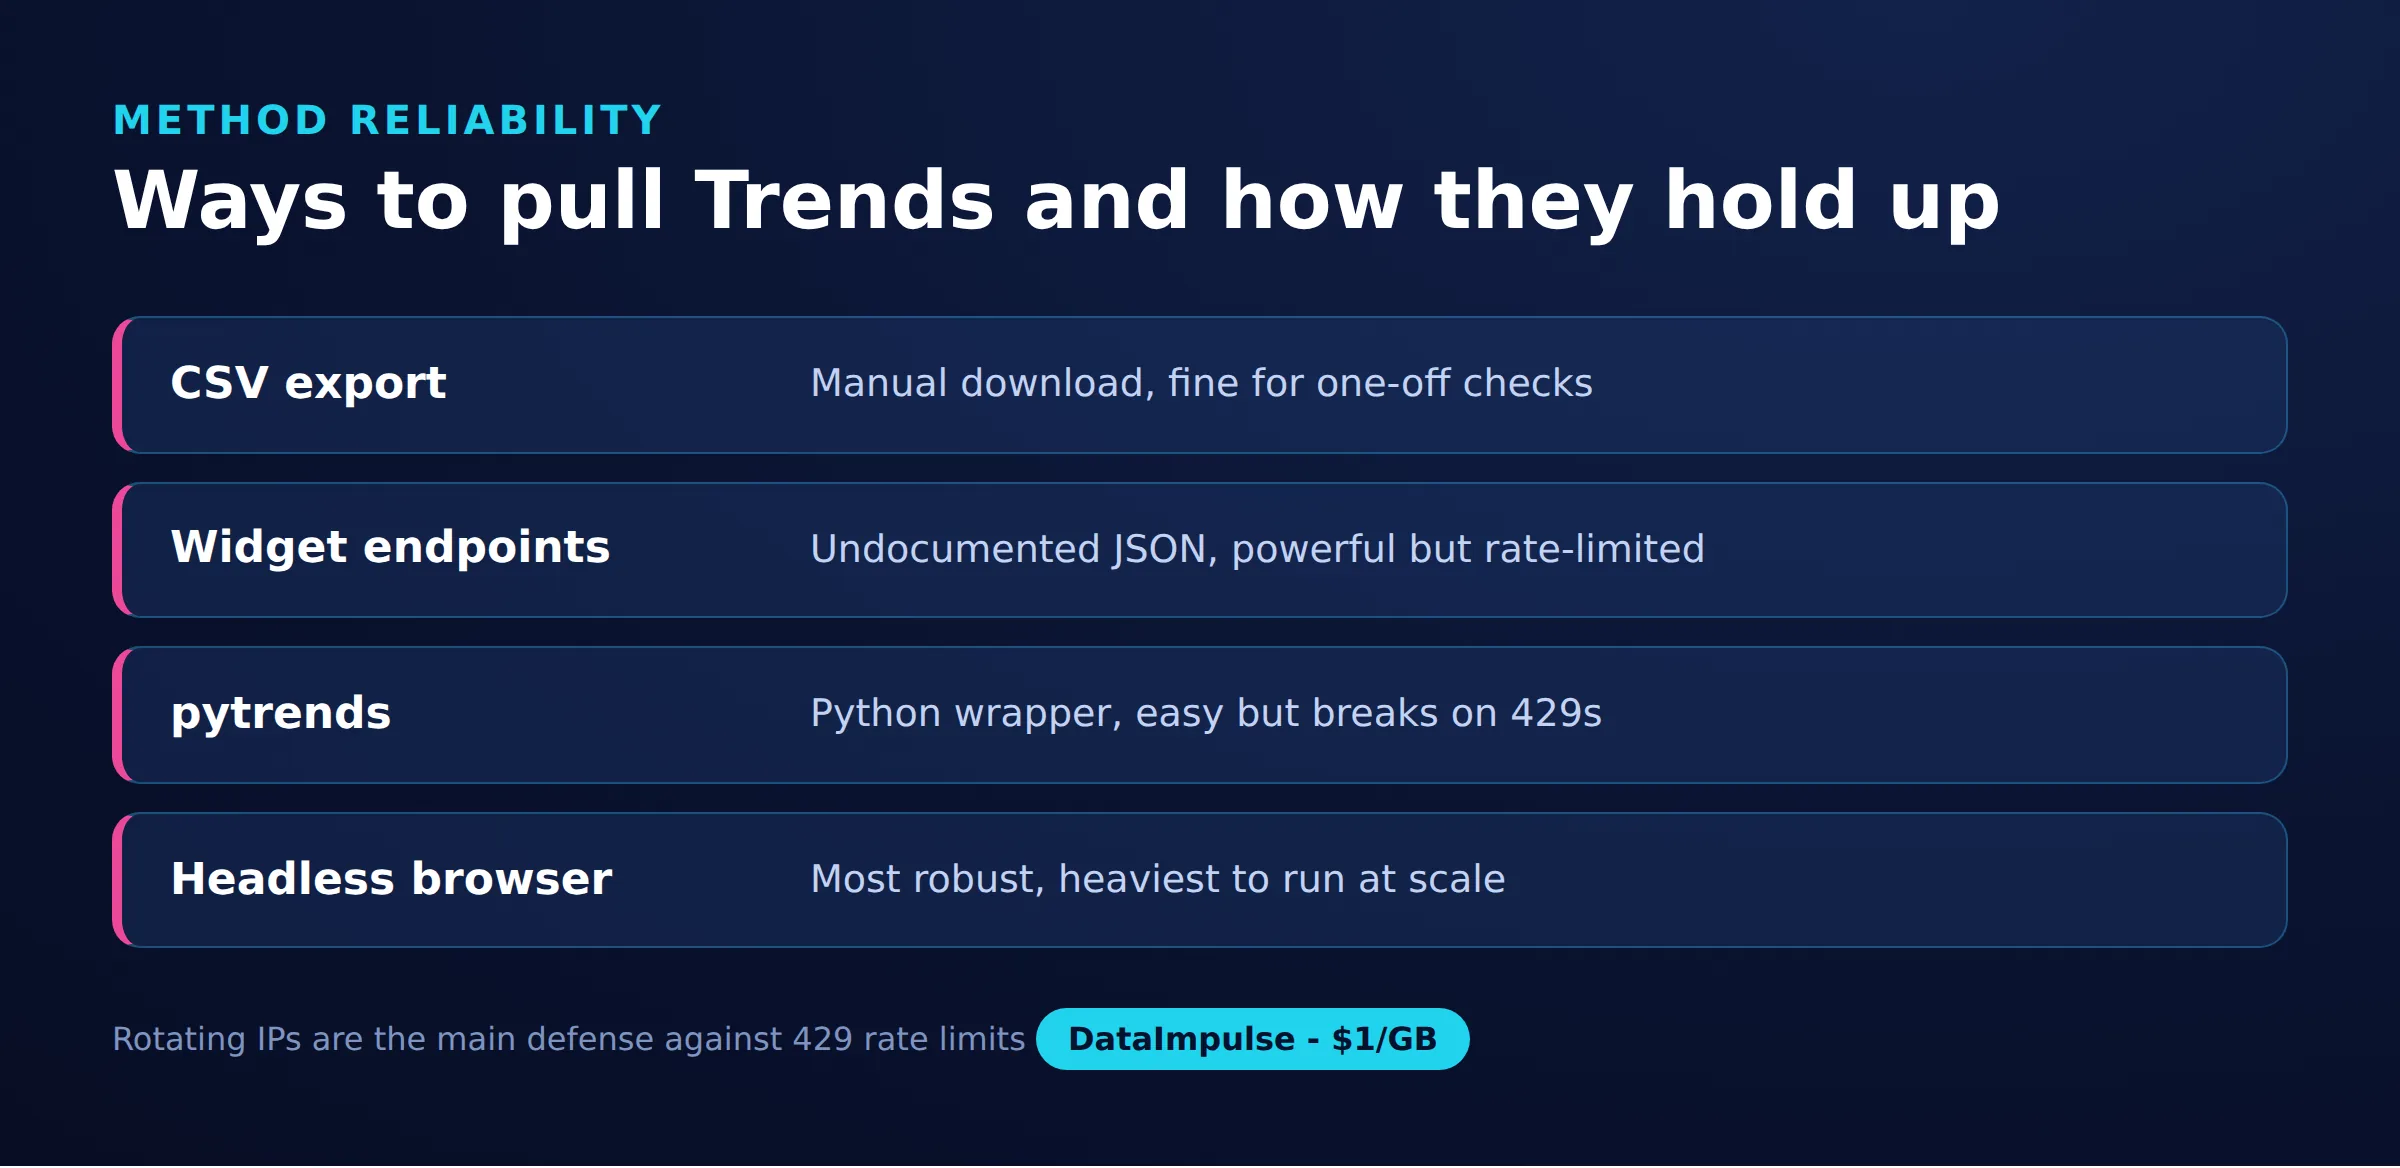
アクセス方法の比較
| 方法 | 信頼性 | 手間と制限 |
|---|---|---|
| CSV エクスポート | 高 | 手作業、単一クエリ |
| ウィジェットエンドポイント | 中 | 非公式、変わる可能性あり |
| pytrends | 中 | 簡単、レート制限あり |
| ヘッドレスブラウザ | 高 | 重い、プロキシが必要 |
よくある質問
Google Trends のスクレイピングは合法ですか?
公開されているデータのスクレイピングは多くの法域で概ね許容されますが、自動アクセスは Google の利用規約に抵触する可能性があります。利用規約と適用される現地の法律を確認し、可能な場合は公式の CSV エクスポートやサポートされたデータセットを優先してください。
Google Trends は実際の検索ボリュームを表示しますか?
いいえ。表示されるのは0から100の相対的な関心指数で、選んだクエリ、地域、期間のピークを基準に正規化されています。絶対的なボリュームを見積もるには、別のキーワードツールが必要です。
なぜ pytrends は 429 エラーを返し続けるのですか?
429 は、リクエストが短時間に多すぎるため Google があなたの IP をレート制限していることを意味します。指数バックオフで遅延を加え、リクエスト頻度を下げ、複数のプロキシをローテーションして、どの IP も制限を超えないようにしてください。
Google Trends のスクレイピングにプロキシは必要ですか?
少数の手動クエリなら不要です。自動化された、あるいは大規模な作業では、ローテーティング住宅用プロキシが IP 単位のレート制限を回避し、対象国内の IP から地域固有のデータを収集するのに役立ちます。
pytrends は Google の公式ライブラリですか?
いいえ。pytrends は Google の内部エンドポイントをラップする非公式のコミュニティライブラリです。調査にはよく機能しますが、Google がそれらのエンドポイントを変更すると定期的に壊れるため、ときどきメンテナンスが必要です。
DataImpulse が適さないのはどんなときですか?
静的な ISP プロキシ、フルマネージドのスクレイピング API、または銀行や政府のサイトへのアクセスが必要なら、DataImpulse は適したツールではありません。DataImpulse は、公開データの収集とコンテンツへのアクセスのために、ローテーティングの住宅用、モバイル、データセンタープロキシに特化しています。
Google Trends のデータを大規模に収集する
Trends のスクレイピングがスロットリングが発生している場合は、ローテーティング住宅用 IP が各リクエストを Google のアドレス単位の制限未満に保ちます。DataImpulse は、国別ターゲティングを標準で含み、1GB あたり1ドルからの従量課金で住宅用、モバイル、データセンタープロキシを提供します。始めるにはDataImpulse アカウントを作成してください。