
In this Article
I casi d’uso del web scraping sono passati da un espediente tecnico di nicchia a una componente standard del modo in cui le aziende raccolgono informazioni di mercato. In termini semplici, il web scraping è la raccolta automatizzata di dati pubblicamente disponibili dai siti web, strutturati affinché possano essere analizzati. Questo articolo illustra 12 casi d’uso concreti del web scraping, i dati specifici che ciascuno raccoglie e il risultato aziendale che supporta.
Ogni esempio seguente si basa sulla richiesta affidabile di molte pagine, ed è qui che la scelta del tipo di proxy conta. Indichiamo quale proxy si adatta a ciascuna attività man mano che procediamo.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza, ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerca di mercato e gestione di più account.
Informazioni chiave
- Ambito: I casi d’uso del web scraping includono prezzi nell’e-commerce, ricerca di mercato, generazione di lead, addestramento dell’AI, SEO, ad verification, protezione del brand, viaggi e finanza, tutti basati sulla raccolta di dati web pubblici su larga scala.
- Miglior tipo di proxy: residential proxy a rotazione, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90 Mln di IP ottenuti eticamente in 195 paesi.
- Affidabilità: tasso di successo del 99.51%, valutato 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Come viene usato il web scraping nell’e-commerce?
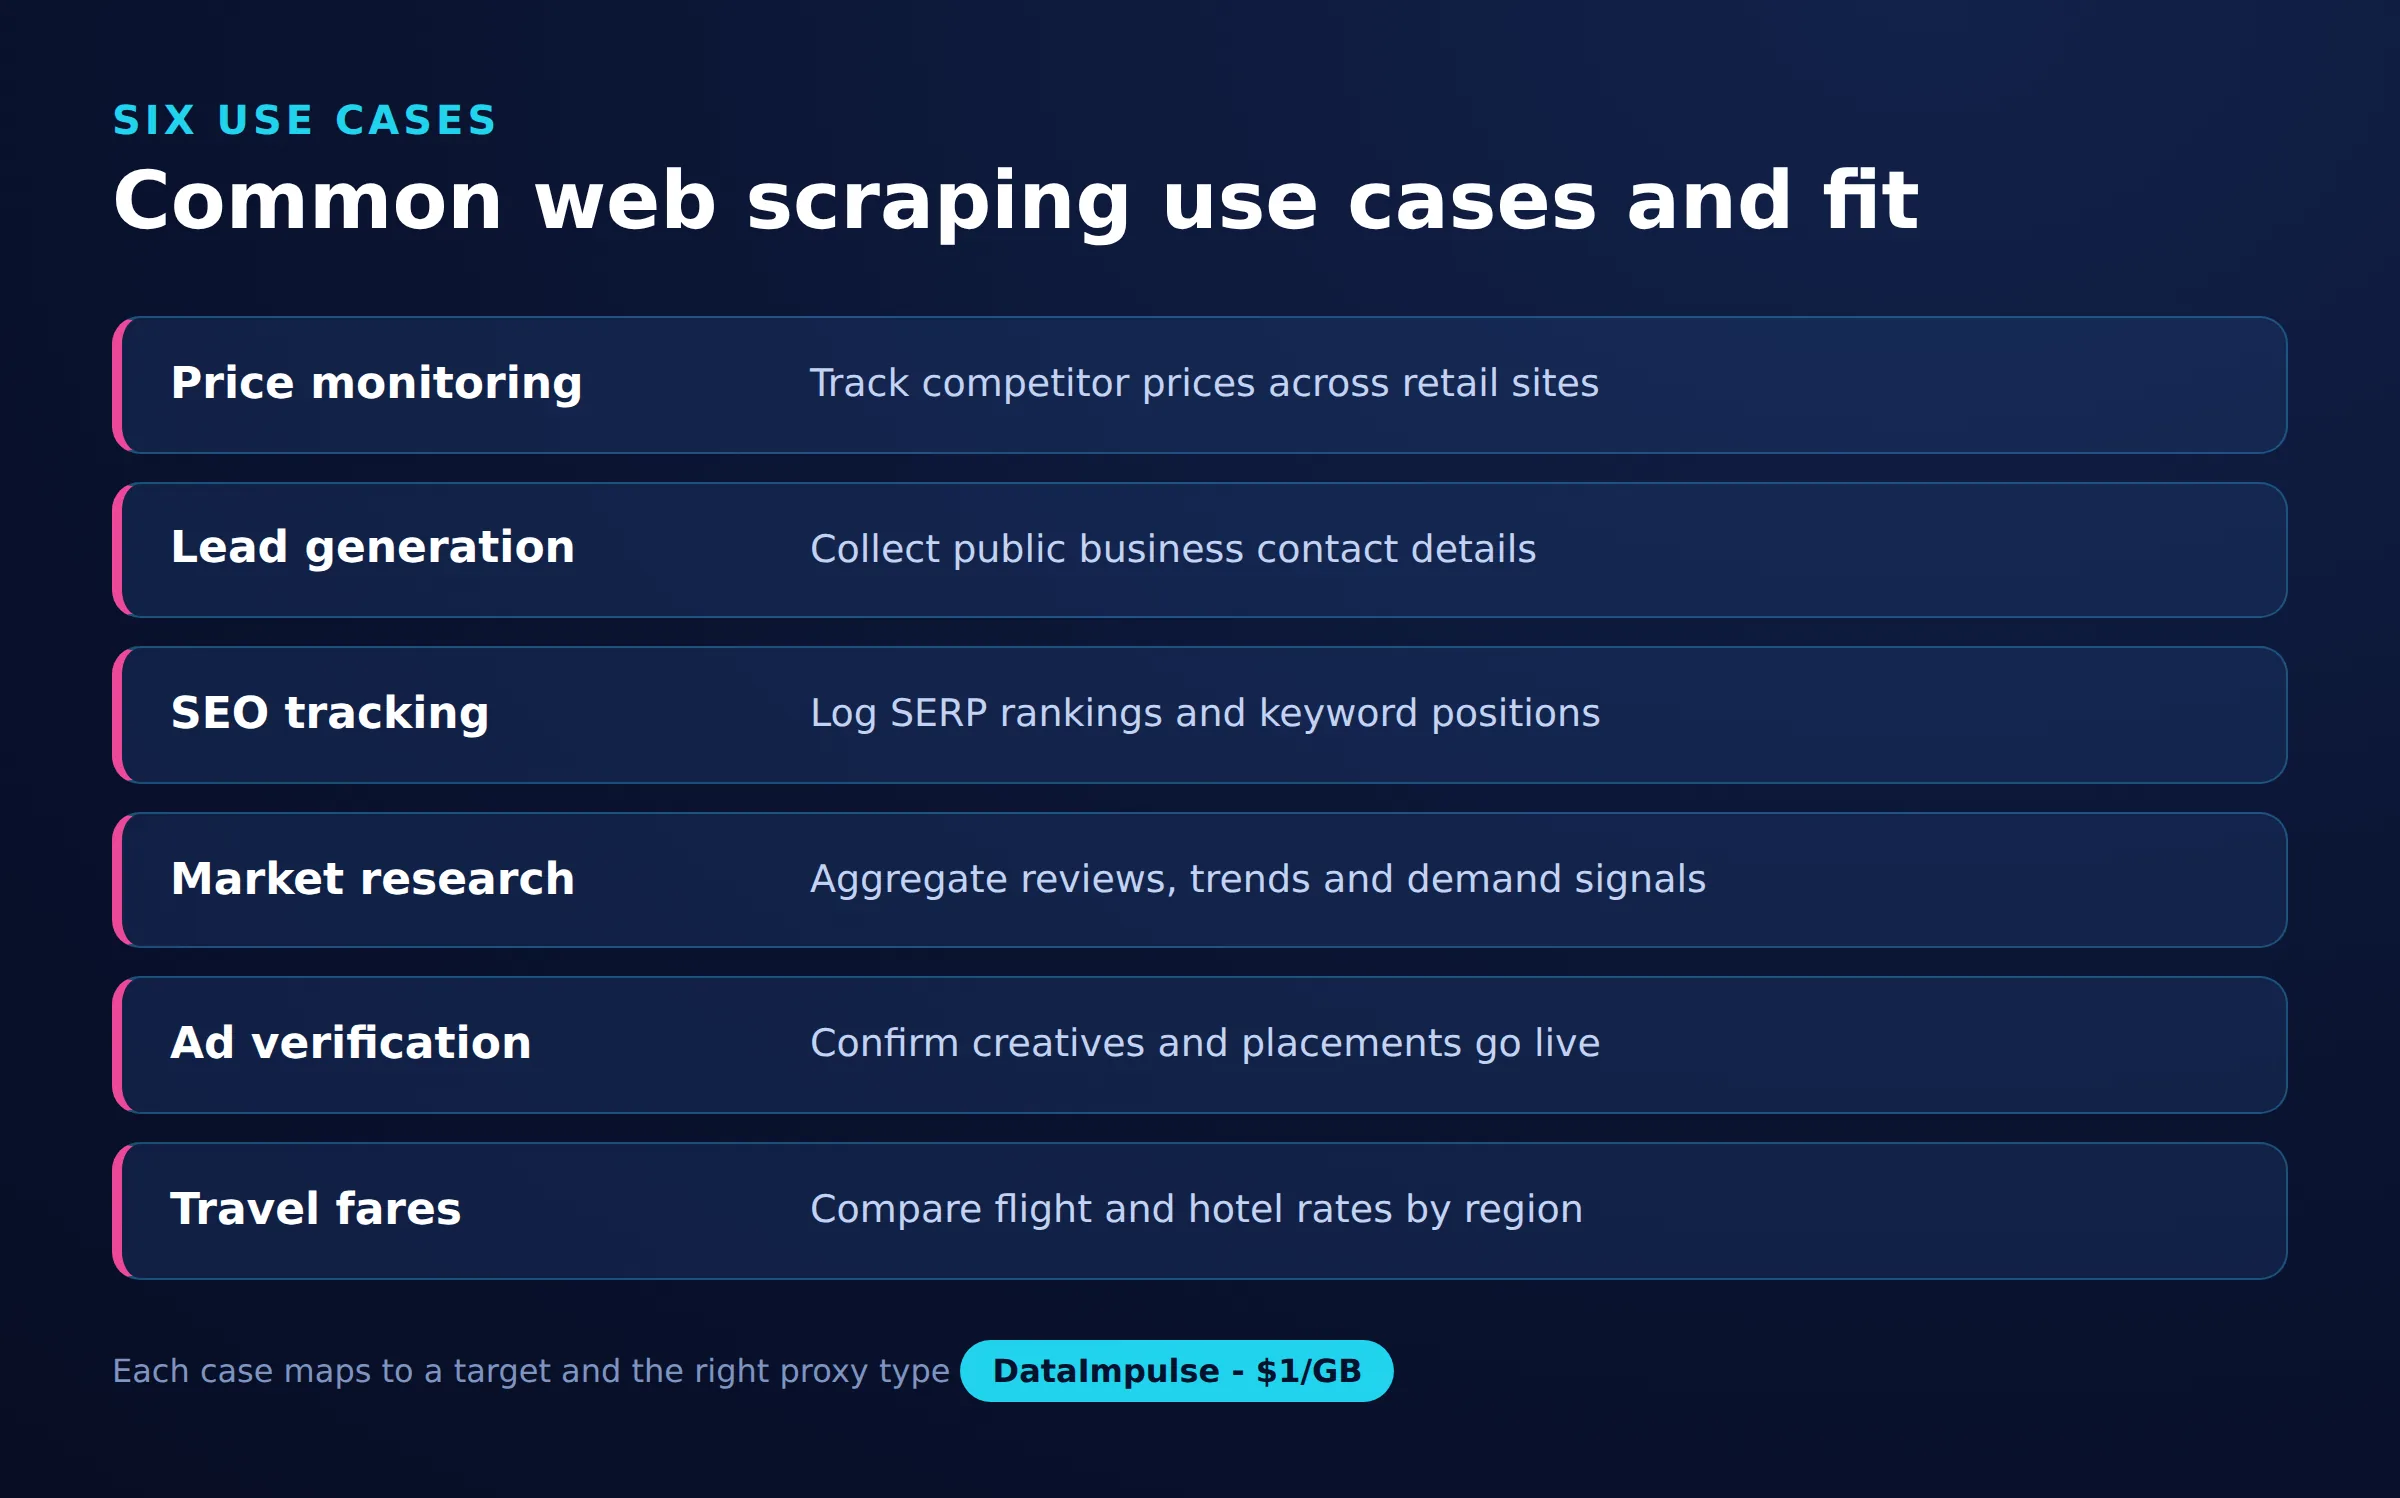
Nell’e-commerce, il web scraping viene usato per monitorare i prezzi della concorrenza, far rispettare le politiche di prezzo minimo pubblicizzato (MAP) e mappare l’assortimento dei prodotti tra i rivenditori. Questi tre casi d’uso condividono un input, l’elenco dei prodotti, ma orientano decisioni diverse.
- Monitoraggio dei prezzi: I rivenditori estraggono dalle pagine prodotto dei concorrenti prezzo, valuta e disponibilità più volte al giorno, quindi alimentano un motore di ricalcolo dei prezzi che modifica le proprie inserzioni. Il risultato è un margine protetto e meno vendite perse a favore di rivali più economici.
- Applicazione del MAP: I brand raccolgono il prezzo pubblicizzato mostrato da ogni rivenditore autorizzato e segnalano i venditori che violano la soglia concordata. Questo protegge il valore del brand e i rapporti di canale.
- Analisi dell’assortimento e del catalogo: I team estraggono le pagine di categoria per vedere quali SKU hanno in stock i concorrenti, quali sono esauriti e dove esistono lacune, così da decidere cosa aggiungere o promuovere.
I siti retail mostrano spesso prezzi localizzati e bloccano i visitatori ripetuti, quindi i residential proxy che presentano IP reali di abitazioni e supportano il targeting per paese sono la scelta comune in questo caso. Per i team alle prime armi con i blocchi, la nostra guida allo scraping senza essere bloccati copre le basi.
Quali casi d’uso del web scraping supportano la ricerca di mercato?
La ricerca di mercato usa il web scraping per quantificare domanda, opinioni e percezione dei prodotti da fonti pubbliche a una scala che i sondaggi non possono eguagliare. Qui dominano due casi d’uso.
- Analisi delle recensioni e delle opinioni: Gli analisti estraggono valutazioni a stelle, testo delle recensioni e date delle recensioni da marketplace e app store, quindi eseguono modelli di analisi delle opinioni per capire quali funzionalità i clienti apprezzano o criticano. Il risultato è una roadmap di prodotto prioritizzata e basata su feedback reali.
- Monitoraggio di prodotti e tendenze: I team raccolgono nel tempo nuovi lanci di prodotto, classifiche di categoria e posizioni dei bestseller per individuare le tendenze emergenti prima che raggiungano il picco, orientando scorte e tempistiche delle campagne.
Poiché queste fonti coprono molti paesi e si aggiornano spesso, le sessioni a rotazione su un ampio pool di IP mantengono stabile la raccolta senza attivare limiti di frequenza.
Il web scraping può generare lead e dati B2B?
Sì. Il web scraping è ampiamente usato per creare e arricchire database B2B di contatti e aziende a partire da directory pubbliche, siti aziendali e profili professionali. I campi raccolti includono in genere nome dell’azienda, settore, indicatori del numero di dipendenti, dati di contatto pubblici e riferimenti alle tecnologie.
I team di vendita usano questi dati per creare elenchi mirati di potenziali clienti e arricchire i record CRM esistenti con dettagli firmografici, migliorando la segmentazione e riducendo le attività di contatto sprecate. Il risultato aziendale è una pipeline più breve e meglio qualificata. Poiché le pagine di directory e profili spesso limitano il traffico automatizzato, i proxy datacenter gestiscono in modo conveniente le directory pubbliche più semplici, mentre gli obiettivi più difficili richiedono IP residential.
Come produce dati di addestramento per l’AI il web scraping?
Il web scraping fornisce gran parte del testo, delle immagini e dei dati strutturati usati per addestrare e valutare modelli di machine learning. I team raccolgono grandi corpora diversificati di contenuti web pubblici, poi li puliscono, eliminano i duplicati e li etichettano prima che raggiungano un modello.
Spiccano due casi d’uso comuni. Il primo è raccogliere dataset specifici per dominio, per esempio descrizioni di prodotti o articoli di assistenza, per effettuare il fine-tuning di un modello per un’attività circoscritta. Il secondo è la valutazione continua, in cui vengono estratti dati pubblici aggiornati per verificare se un modello continua a funzionare bene rispetto alle informazioni attuali. Il risultato è un modello addestrato su dati pertinenti e aggiornati anziché su istantanee obsolete. La raccolta ad alto volume in diverse regioni favorisce un ampio pool di IP ottenuti eticamente; gli proxy etici sono importanti qui perché la provenienza dei dati di addestramento è sottoposta a controlli sempre maggiori.
Quali casi d’uso del web scraping riguardano SEO e ad verification?
I team SEO e pubblicitari usano il web scraping per vedere il web come lo vedono i loro clienti e rivali, dalle classifiche di ricerca agli annunci effettivamente pubblicati. Tre casi d’uso sono tipici.
- Monitoraggio di SERP e posizionamento: I team estraggono le pagine dei risultati dei motori di ricerca per le parole chiave target, per tracciare i propri posizionamenti, quelli dei concorrenti e gli snippet in evidenza. Il risultato è una visione chiara dei contenuti che funzionano e delle lacune da colmare.
- Ad verification: Gli inserzionisti raccolgono gli annunci mostrati sui siti degli editori da località diverse per confermare che le loro creatività appaiano correttamente, conducano alla pagina giusta e non siano posizionate accanto a contenuti non sicuri.
- Controlli di affiliazione e conformità: I brand verificano che i partner mostrino offerte e prezzi approvati.
Sia i risultati SERP sia gli annunci pubblicati variano in base alla città e alla rete, quindi IP geograficamente accurati sono essenziali. I proxy mobile sono adatti per verificare i posizionamenti degli annunci mobile, poiché presentano IP di livello operatore che corrispondono al traffico reale dei telefoni.
Come viene usato il web scraping per la protezione del brand, i viaggi e la finanza?
Oltre allo stack di marketing, il web scraping alimenta casi d’uso di monitoraggio nella protezione del brand, nei viaggi, nel settore immobiliare e nella finanza. Ciascuno trasforma inserzioni pubbliche disperse in un unico dataset comparabile.
- Protezione del brand: Le aziende estraggono da marketplace e risultati di ricerca inserzioni contraffatte, usi non autorizzati del proprio nome e pagine di phishing, poi alimentano un flusso di lavoro per la rimozione. Il risultato è una rimozione più rapida dei contenuti lesivi.
- Viaggi e ospitalità: I siti di prenotazione e le compagnie aeree estraggono tariffe dei concorrenti, prezzi delle camere e disponibilità per definire prezzi dinamici. Le tariffe cambiano in base alla posizione dell’utente, quindi il targeting a livello di paese è importante.
- Settore immobiliare: Le piattaforme aggregano inserzioni, prezzi e caratteristiche degli immobili da molti portali per creare valutazioni di mercato e avvisare gli acquirenti di nuove disponibilità.
- Finanza e dati alternativi: I fondi raccolgono dati alternativi come annunci di lavoro, prezzi dei prodotti e numero di negozi come segnali precoci della performance aziendale, alimentando modelli di investimento.
Queste attività ricorrenti premiano tassi di successo affidabili rispetto alla pura velocità, ecco perché un’infrastruttura stabile e ottenuta eticamente come DataImpulse è adatta a esse.
Casi d’uso e tipo di proxy più adatto
| Caso d’uso | Dati raccolti | Miglior tipo di proxy |
|---|---|---|
| Monitoraggio dei prezzi | Prezzi dei concorrenti | Residential a rotazione |
| SEO e SERP | Posizionamenti di ricerca | Residential con targeting geografico |
| Ad verification | Posizionamenti degli annunci mostrati | Proxy mobile |
| Generazione di lead | Dati di contatto pubblici | Proxy datacenter |
| Dati di addestramento AI | Testo e media su larga scala | Residential a rotazione |
| Ricerca di mercato | Recensioni e tendenze | Residential proxy |
Domande frequenti
Il web scraping è legale?
L’estrazione di dati pubblicamente disponibili è generalmente consentita in molte giurisdizioni, ma la legittimità dipende dal tipo di dati, dai termini del sito e dalle leggi locali, come le norme sulla protezione dei dati. La raccolta di dati personali o l’aggiramento dei controlli di accesso aumenta il rischio, quindi verifica i termini e la legge applicabile prima di effettuare il web scraping.
Qual è il caso d’uso più comune del web scraping?
Il monitoraggio dei prezzi nell’e-commerce è tra i più comuni. Rivenditori e brand tracciano continuamente prezzi e livelli di scorte dei concorrenti per ricalcolare i prezzi dei propri prodotti e proteggere il margine.
Mi servono proxy per il web scraping?
Per attività piccole e una tantum, potresti non averne bisogno. Per raccolte ripetute o su larga scala, i proxy distribuiscono le richieste tra molti IP per evitare limiti di frequenza e blocchi geografici, e ti consentono di visualizzare pagine specifiche per regione, come prezzi localizzati o risultati di ricerca.
Quale tipo di proxy è migliore per il web scraping?
Dipende dall’obiettivo. I residential proxy sono adatti ai siti che bloccano il traffico automatizzato e richiedono IP reali di abitazioni, i proxy datacenter sono adatti a fonti pubbliche più semplici a un costo inferiore, mentre i proxy mobile sono adatti alle app mobile e ai contenuti forniti dall’operatore.
Il web scraping può raccogliere dati in paesi diversi?
Sì. Usando proxy con targeting per paese, puoi richiedere pagine come se navigassi da un paese specifico, cosa essenziale per prezzi localizzati, posizionamenti di ricerca e annunci. DataImpulse include il targeting per paese in 195 paesi.
Quando DataImpulse non è la soluzione adatta?
Se hai bisogno di proxy ISP statici, di un’API di scraping completamente gestita o dell’accesso a siti bancari e governativi, DataImpulse non è lo strumento adatto. Si concentra su proxy residential, mobile e datacenter a rotazione per la raccolta di dati pubblici e l’accesso ai contenuti.
Inizia a raccogliere i dati necessari al tuo caso d’uso
Qualunque sia il caso d’uso del web scraping adatto al tuo team, IP affidabili sono la base. DataImpulse offre proxy residential, mobile e datacenter ottenuti eticamente a partire da 1 dollaro per GB, con targeting per paese incluso. Crea un account e inizia con traffico pay-as-you-go che non scade.