
In this Article
Scegliere i metodi giusti per la raccolta dei dati determina se un’analisi sarà affidabile o fuorviante, prima ancora di tracciare un solo grafico. Questa guida spiega i principali metodi che i team usano oggi, dalla classica ricerca tramite sondaggi alla raccolta automatizzata di dati dal web, e quando è opportuno usare ciascuno di essi.
Tratta i metodi primari, secondari e digitali automatizzati, per poi approfondire la raccolta di dati dal web su larga scala, i controlli di qualità dei dati e le regole etiche e di conformità applicabili a ogni metodo.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza, ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione multi-account.
Dati principali
- Tre famiglie: i metodi di raccolta dei dati rientrano in metodi primari (sondaggi, interviste, osservazione, esperimenti), secondari (dataset pubblici e commerciali) e digitali automatizzati (web scraping, API, telemetria e sensori IoT).
- Miglior tipo di proxy: residential proxy rotanti, che usano IP reali di consumatori in grado di superare il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90M di IP ottenuti in modo etico in 195 paesi.
- Affidabilità: tasso di successo del 99,51%, valutazione di 4,8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Che cosa sono i metodi primari di raccolta dei dati?
I metodi primari di raccolta dei dati raccolgono dati originali direttamente da una fonte, più spesso attraverso sondaggi, interviste, osservazione ed esperimenti.
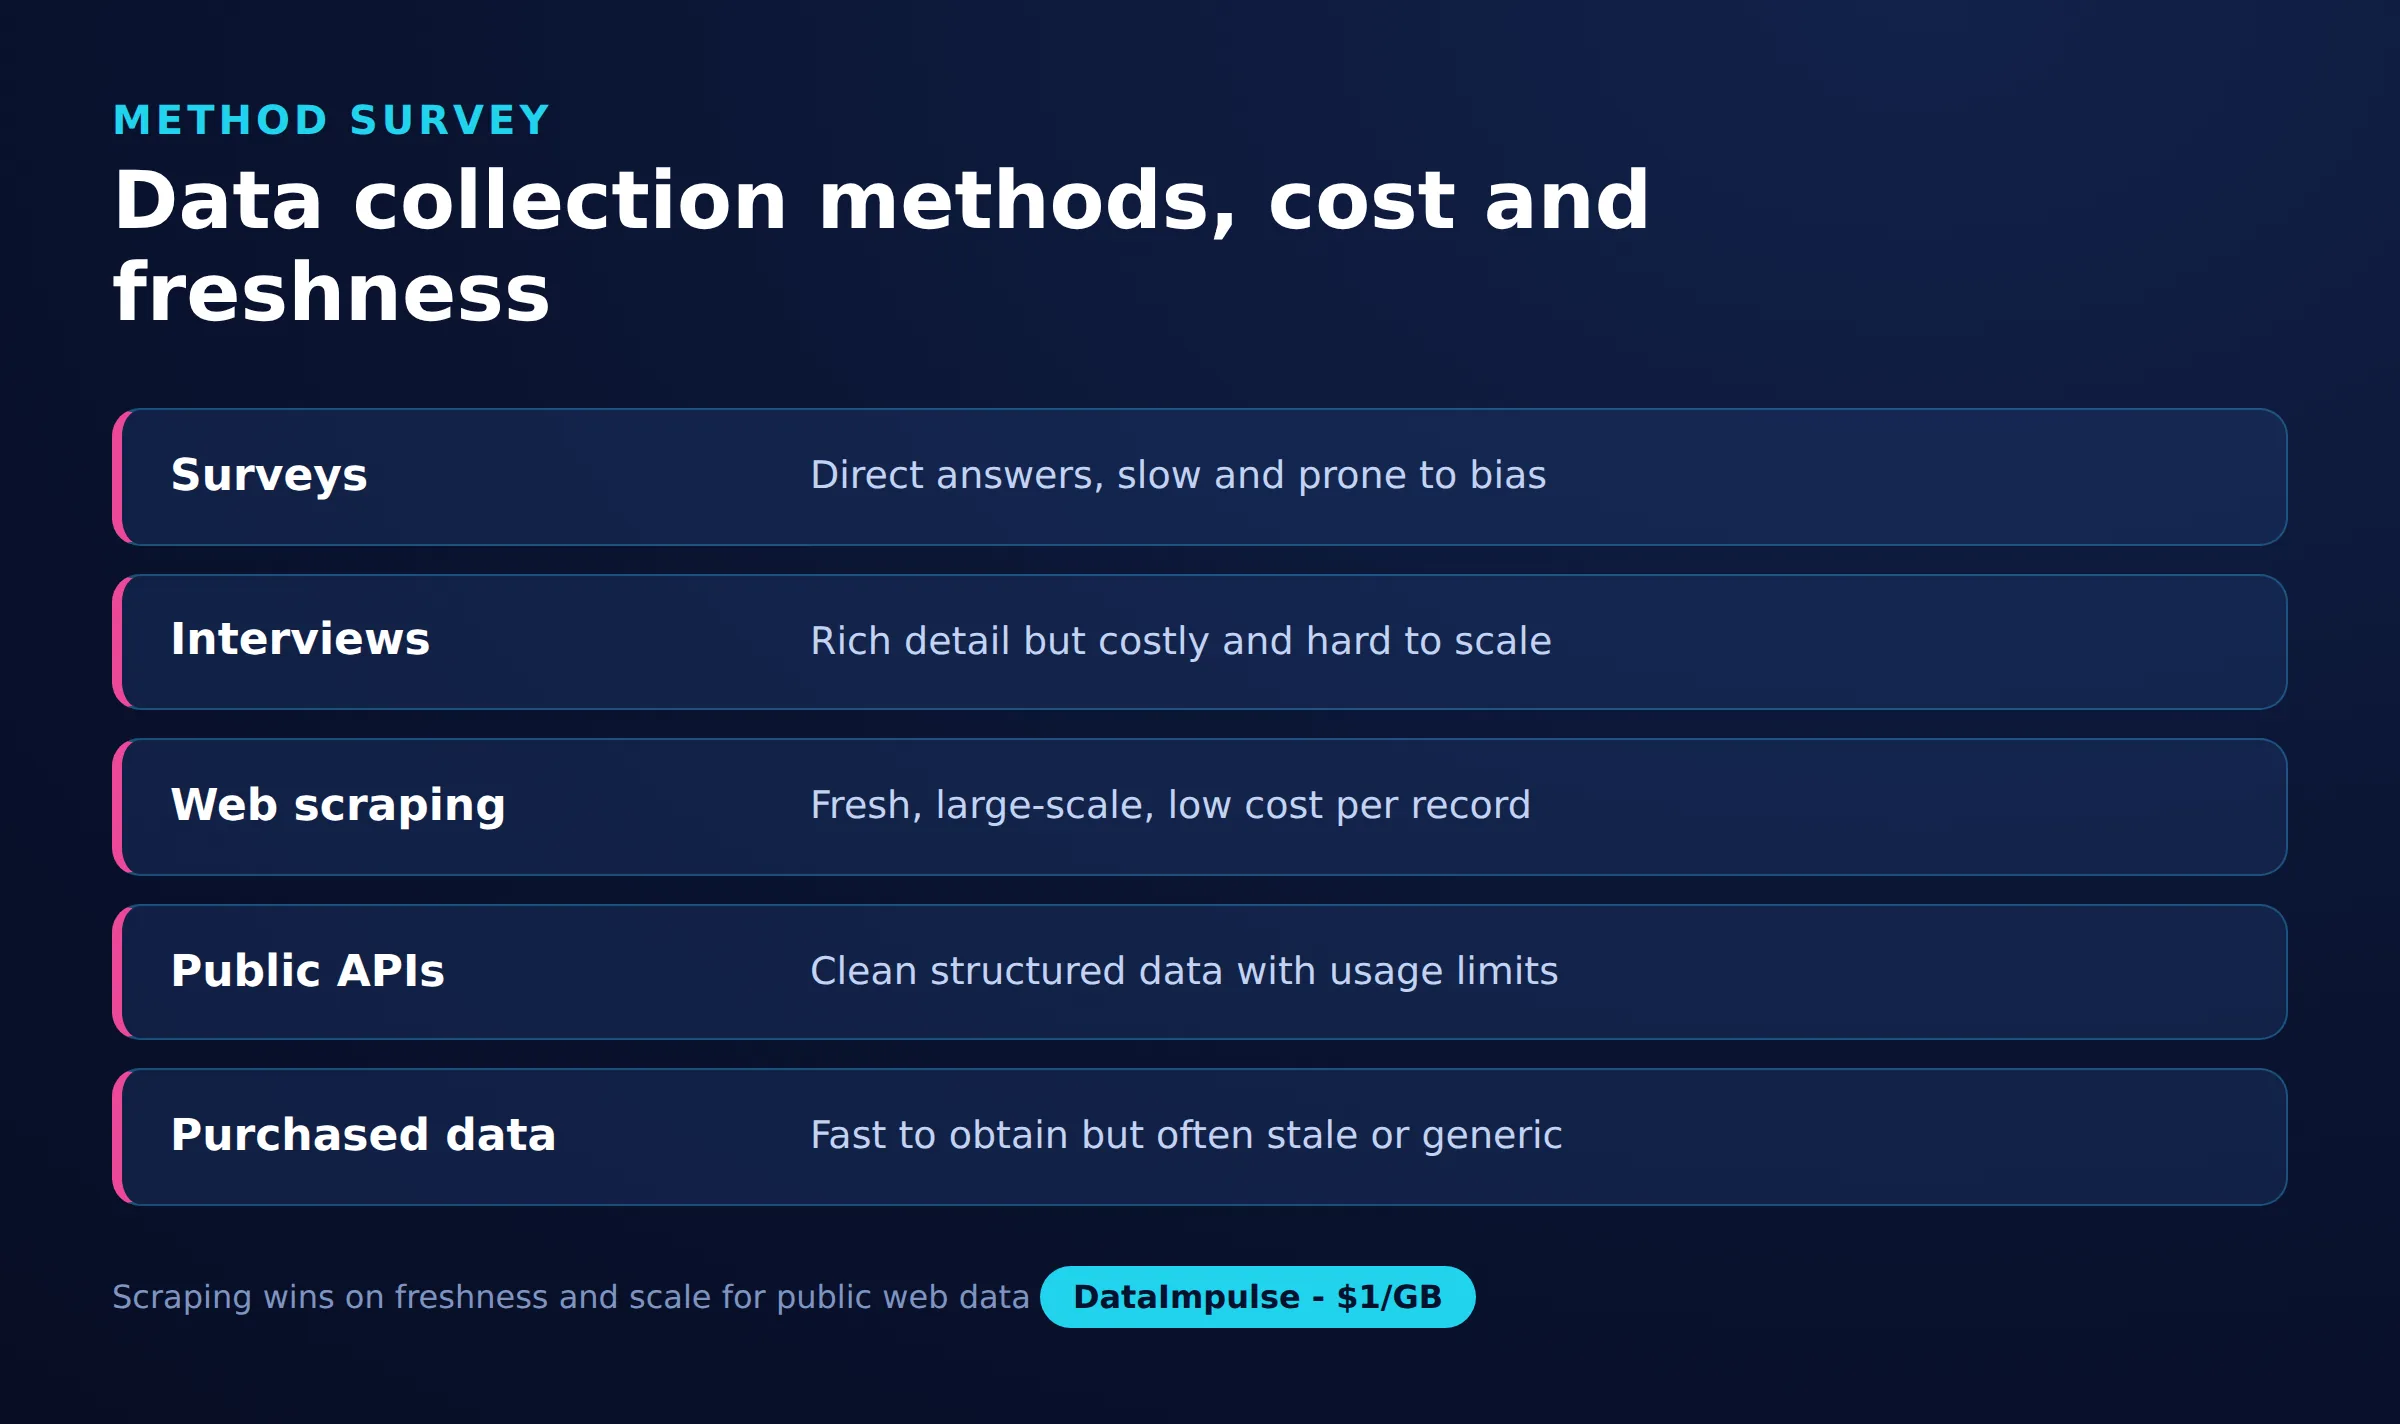
- Sondaggi e questionari: domande standardizzate inviate a un campione. Usali per misurare atteggiamenti o comportamenti su larga scala. Hanno un basso costo per risposta e sono facili da quantificare, ma soffrono di distorsione da autovalutazione e bassi tassi di risposta. Esempio: un’azienda SaaS svolge ogni trimestre un sondaggio NPS per monitorare la soddisfazione per fascia di piano.
- Interviste: conversazioni strutturate o aperte con singole persone. Usale quando ti servono profondità e contesto, non conteggi. Fanno emergere il perché dietro un numero, ma non consentono generalizzazioni basate su poche persone. Esempio: un team di prodotto intervista dieci clienti che hanno abbandonato il servizio per capire perché hanno annullato.
- Osservazione: osservazione diretta del comportamento, di persona o tramite registrazione delle sessioni. Usala quando ciò che le persone dicono differisce da ciò che fanno. Coglie le azioni reali, ma può richiedere molto lavoro ed essere soggetta a distorsioni dell’osservatore. Esempio: un rivenditore studia il flusso dei clienti in negozio per riprogettare la disposizione degli scaffali.
- Esperimenti: test controllati che modificano una variabile e ne misurano l’effetto, come un test A/B. Usali per stabilire la causalità, non solo la correlazione. Forniscono solide prove causali, ma richiedono un’attenta progettazione e un campione sufficientemente ampio. Esempio: un sito ecommerce esegue un test A/B su due flussi di checkout per vedere quale aumenta la conversione.
Quando dovresti usare la raccolta secondaria dei dati?
Usa la raccolta secondaria dei dati quando esistono già dati affidabili, quando velocità e budget contano più di una corrispondenza perfetta o quando ti serve un contesto storico o macro che non puoi raccogliere autonomamente.
Le fonti secondarie includono dataset pubblici e aperti, dati governativi e di agenzie statistiche, ricerca accademica e fornitori commerciali di dati. I dati pubblici e governativi, come i dati del censimento o gli indicatori economici aperti, sono autorevoli e di solito gratuiti, anche se possono essere in ritardo e poco granulari. I fornitori commerciali di dati vendono dataset curati, come dati aziendali, stime di mercato o panel di consumatori; fanno risparmiare lo sforzo della raccolta, ma aggiungono costi di licenza e una dipendenza dalla metodologia del fornitore. Il rischio principale di tutti i dati secondari è l’adeguatezza: definizioni, periodi temporali e geografia potrebbero non corrispondere alla tua domanda, quindi leggi sempre la documentazione prima di fidarti dei numeri. Esempio: una startup fintech stima un nuovo mercato usando registri governativi delle imprese più un report di settore acquistato, invece di intervistare ogni azienda.
Come funziona la raccolta automatizzata di dati dal web?
La raccolta digitale automatizzata usa software per acquisire continuamente dati dal web, dalle applicazioni e dai dispositivi connessi; i quattro metodi comuni sono web scraping, API ufficiali, raccolta di log e telemetria e sensori IoT.
- Web scraping: programmi che richiedono pagine web pubbliche ed estraggono campi strutturati dall’HTML. Usalo quando i dati sono visibili su un sito ma nessuna API li espone, per esempio per raccogliere i prezzi dei concorrenti in varie regioni. Offre un’ampia copertura, ma richiede manutenzione quando i siti cambiano e deve rispettare termini e limiti di frequenza.
- API ufficiali: un fornitore espone dati tramite un endpoint documentato che restituisce risposte pulite e strutturate. Usa un’API quando esiste e i suoi termini coprono il tuo utilizzo, poiché è il percorso più stabile e con minore manutenzione. I limiti riguardano ambito, soglie di frequenza e costo, e non tutti i dataset ne hanno una.
- Raccolta di log e telemetria: i tuoi sistemi emettono eventi, come visualizzazioni di pagina, clic o errori, che memorizzi e analizzi. Usala per capire come si comportano davvero gli utenti nel tuo prodotto. È first-party e precisa, ma copre solo la tua superficie.
- Dati IoT e dei sensori: dispositivi fisici trasmettono letture come temperatura, posizione o stato della macchina. Usali per operazioni, logistica e monitoraggio. Hanno un volume elevato e sono in tempo reale, ma richiedono un’infrastruttura per acquisirli e pulirli.
Questi metodi automatizzati hanno una scalabilità molto maggiore della raccolta manuale, ed è per questo che dominano le moderne pipeline di dati. Per una panoramica più ampia di ciò che i team realizzano con i dati estratti, consulta la nostra guida ai casi d’uso del web scraping.
Web scraping vs API vs acquisto di dati: qual è la scelta migliore?
La scelta migliore tra scraping, API ufficiali e acquisto di dataset dipende da tre compromessi: controllo sui dati, aggiornamento e costo totale, inclusa la manutenzione.
- API ufficiale: la scelta migliore quando esiste e i suoi termini e limiti di frequenza soddisfano le tue esigenze. Ottieni dati puliti e stabili con poca manutenzione, ma sei limitato a ciò che il fornitore espone e potresti pagare per chiamata.
- Web scraping: la scelta migliore quando i dati sono pubblici su un sito ma non esiste un’API utilizzabile, o quando ti serve un’ampia copertura su molte fonti. Controlli esattamente ciò che raccogli e quanto è aggiornato, a fronte del costo di sviluppo e manutenzione degli estrattori e della gestione delle misure anti-bot. La nostra guida sullo scraping senza essere bloccati tratta l’aspetto dell’affidabilità.
- Acquistare un dataset: la scelta migliore quando un fornitore vende già esattamente ciò che ti serve e la velocità prevale sul controllo. Eviti il lavoro di sviluppo, ma erediti aggiornamento, copertura e termini di licenza del fornitore.
Un modello comune è combinarli: usa le API quando disponibili, esegui lo scraping delle lacune e acquista dataset specialistici che non è pratico raccogliere. DataImpulse è un fornitore di proxy, non un’API di scraping gestita né un marketplace di dati, quindi si inserisce nel percorso dello scraping anziché sostituirlo.
Dove si collocano i proxy nella raccolta dei dati?
I proxy rientrano nel metodo automatizzato di raccolta dal web, in cui consentono agli scraper di raccogliere dati su larga scala e di vedere il web come lo vedono i veri utenti in un paese di destinazione.
I grandi lavori di raccolta inviano molte richieste e i siti spesso limitano la frequenza o bloccano un singolo indirizzo che si comporta come un bot. Instradare le richieste attraverso un pool di IP distribuisce il carico e riduce i blocchi. I proxy consentono anche una raccolta geograficamente accurata: prezzi, risultati di ricerca e disponibilità differiscono spesso in base alla posizione, quindi un IP nel mercato di destinazione restituisce i dati che vedono effettivamente gli utenti locali. I residential proxy usano indirizzi assegnati a nuclei familiari reali e sono adatti a siti con sistemi anti-bot rigorosi, i mobile proxy instradano attraverso reti di operatori per gli obiettivi più difficili e i proxy datacenter sono più veloci ed economici per fonti tolleranti. DataImpulse li offre come proxy etici, ottenuti da utenti che scelgono di aderire e vengono compensati, con targeting per paese incluso e prezzi pay-as-you-go a partire da un dollaro per GB. I proxy influenzano la consegna delle richieste, non la qualità dei dati stessa, quindi la validazione resta importante.
Come garantire la qualità dei dati tra diversi metodi?
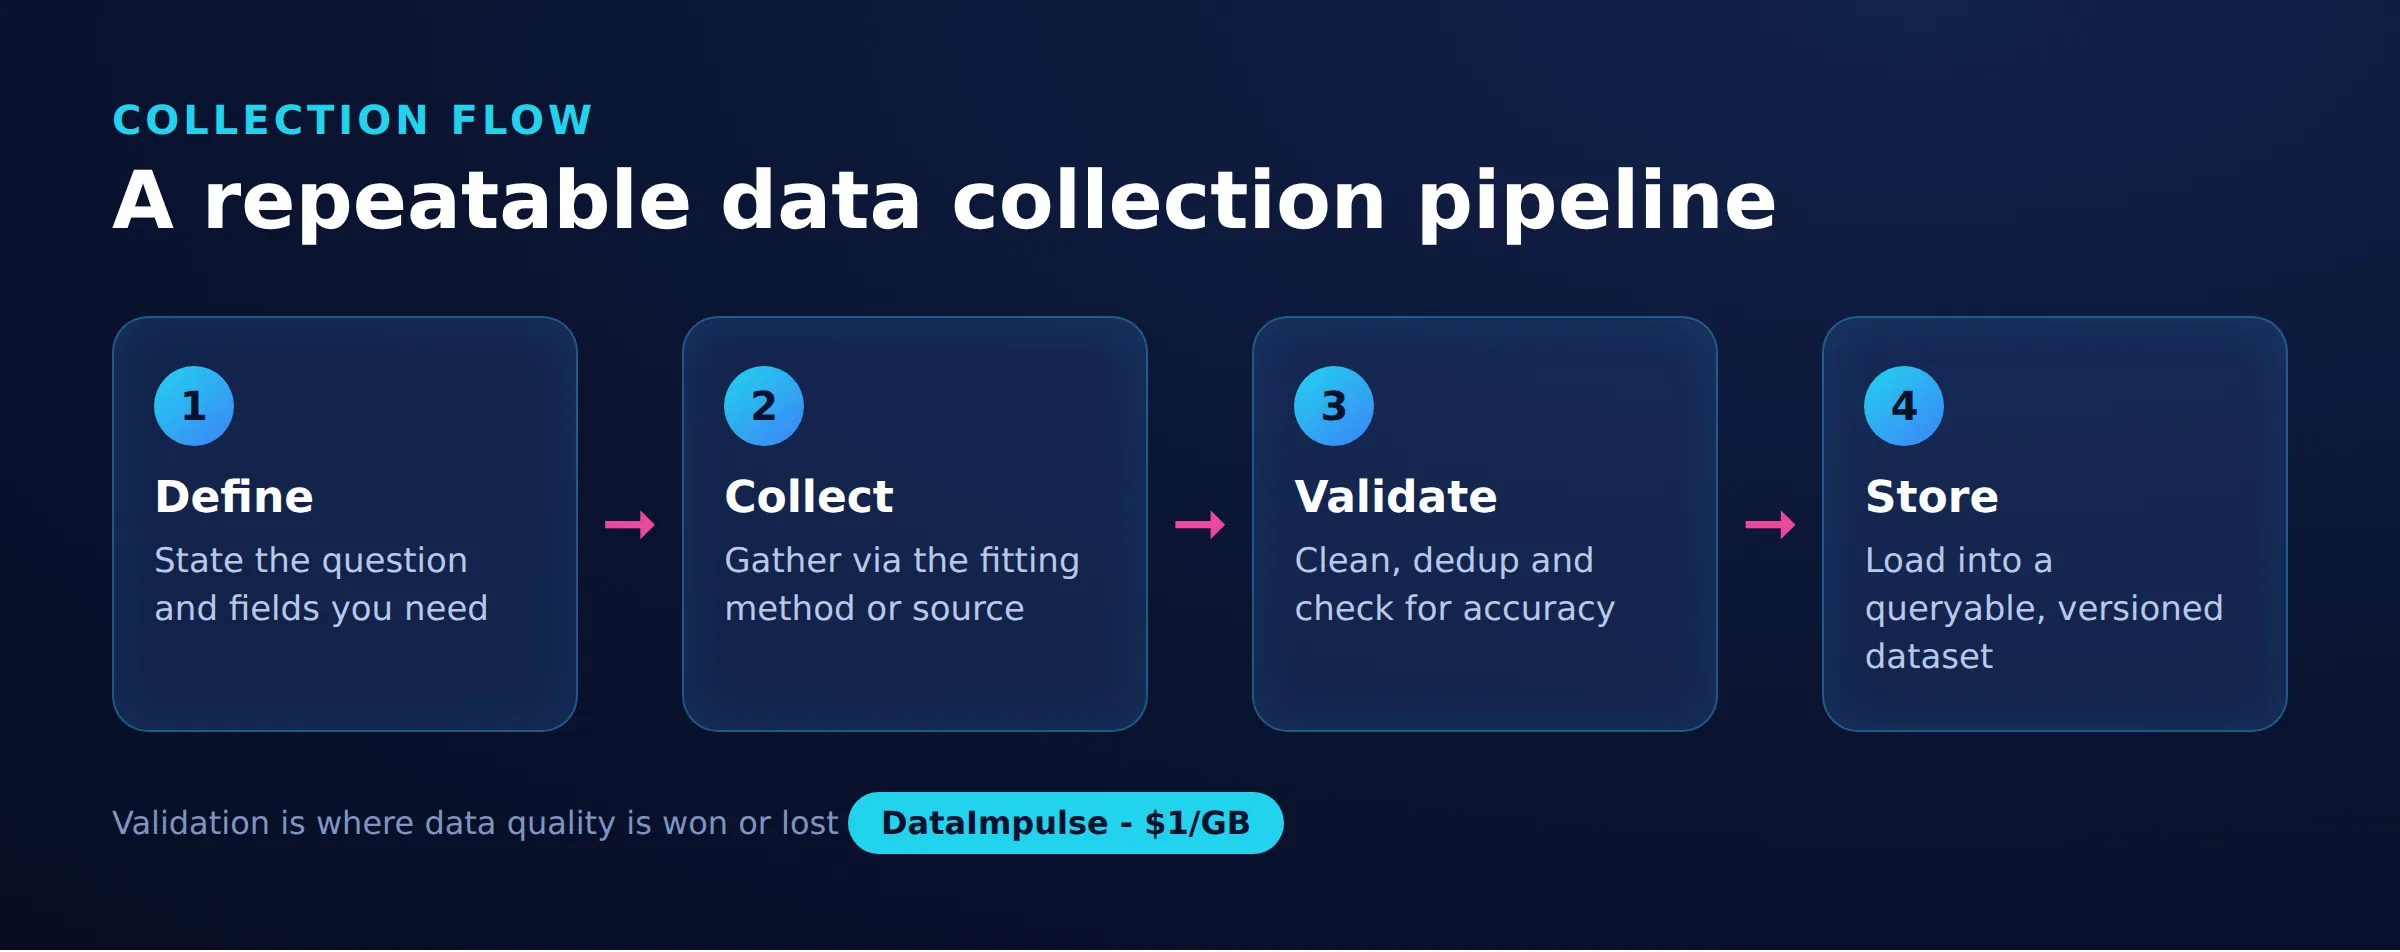
Garantire la qualità dei dati significa verificarne validità, rappresentatività e aggiornamento prima dell’analisi, indipendentemente dal metodo di raccolta che li ha prodotti.
- Validazione: conferma che ogni campo abbia il tipo, l’intervallo e il formato corretti, rimuovi i duplicati e, ove possibile, riconcilia con un riferimento noto. Le pipeline automatizzate dovrebbero rifiutare o segnalare i record malformati anziché memorizzarli silenziosamente.
- Distorsione del campionamento: chiediti se i dati rappresentano la popolazione che ti interessa. Un sondaggio a cui rispondono solo clienti soddisfatti, oppure pagine estratte da una sola regione, distorcerà le conclusioni. Documenta come è stato estratto il campione.
- Aggiornamento e decadimento: i dati perdono valore quando la realtà cambia. Prezzi, inventario e dati di contatto diventano rapidamente obsoleti, quindi definisci con quale frequenza aggiornare ciascun dataset e traccia i timestamp di raccolta.
Le buone pipeline rendono questi controlli continui, non una tantum, perché la raccolta automatizzata può interrompersi silenziosamente quando una fonte cambia formato.
Quali sono le regole etiche e di conformità per la raccolta dei dati?
Una raccolta dei dati etica e conforme si basa su base giuridica e consenso, minimizzazione dei dati e rispetto dei termini della fonte e della normativa sulla privacy applicabile, come il GDPR.
Raccogli dati personali solo con una base giuridica valida e preferisci dati aggregati o anonimizzati rispetto a record identificabili. Applica la minimizzazione dei dati raccogliendo solo i campi di cui hai effettivamente bisogno e conservandoli non più a lungo del necessario. Per la raccolta dal web, rispetta i termini di servizio di un sito, le direttive robots e i limiti di frequenza, ed evita di raccogliere dati personali da pagine in cui non sono chiaramente pubblici. Ai sensi del GDPR e di regimi simili, i dati personali comportano obblighi di trasparenza, limitazione delle finalità e diritti individuali, quindi molti team rimuovono le informazioni di identificazione personale al momento della raccolta. Anche l’approvvigionamento dell’infrastruttura di raccolta conta: DataImpulse ottiene i suoi IP da utenti che aderiscono esplicitamente e vengono compensati, è in linea con il GDPR e offre un accordo sul trattamento dei dati, mantenendo il livello di raccolta coerente con una pratica responsabile sui dati.
Confronto tra i metodi di raccolta dei dati
| Metodo | Costo | Aggiornamento e controllo |
|---|---|---|
| Sondaggio | Medio | Aggiornato, controllo elevato |
| Intervista | Alto | Aggiornato, controllo approfondito |
| Osservazione | Medio | In tempo reale, controllo moderato |
| Web scraping | Basso | Attuale, controllo elevato |
| API | Da basso a medio | In tempo reale, limitato dal fornitore |
| Dataset acquistati | Variabile | Spesso obsoleti, controllo ridotto |
Domande frequenti
Qual è la differenza tra metodi primari e secondari di raccolta dei dati?
I metodi primari raccolgono nuovi dati direttamente da una fonte tramite sondaggi, interviste, osservazione o esperimenti, perciò i dati rispondono esattamente alla tua domanda ma richiedono più tempo e denaro. I metodi secondari riutilizzano dati esistenti, come dataset pubblici o commerciali, un approccio più rapido ed economico che potrebbe però non corrispondere con precisione alle tue esigenze.
Quale metodo di raccolta dei dati è migliore per grandi volumi di dati online?
Per grandi volumi di dati online, vincono i metodi automatizzati: usa un’API ufficiale quando copre la tua esigenza e il web scraping quando i dati sono pubblici ma non esiste un’API utilizzabile. Entrambi hanno una scalabilità molto maggiore della raccolta manuale e lo scraping su larga scala di solito richiede proxy per evitare limitazioni di frequenza.
Il web scraping è un metodo legittimo di raccolta dei dati?
Lo scraping di dati pubblicamente disponibili può essere lecito, ma la legittimità dipende dai termini di servizio del sito, dal tipo di dati e dalle leggi sulla privacy come il GDPR. Evita di raccogliere dati personali senza una base giuridica, rispetta limiti di frequenza e termini e chiedi consulenza legale per il tuo caso d’uso specifico.
In che modo i proxy aiutano nella raccolta dei dati?
I proxy instradano le richieste di raccolta attraverso molti indirizzi IP, distribuendo il carico per ridurre i blocchi e consentendoti di raccogliere dati geograficamente accurati come li vedrebbero gli utenti locali. Influenzano il modo in cui vengono consegnate le richieste, non la qualità dei dati, quindi la validazione è comunque necessaria.
Come mantenere accurati nel tempo i dati raccolti?
Convalida tipo, intervallo e duplicati dei campi al momento della raccolta, verifica che il campione rappresenti la popolazione di destinazione e aggiorna i dati secondo una pianificazione, perché prezzi, inventario e contatti decadono rapidamente. I controlli continui intercettano le interruzioni silenziose quando una fonte cambia formato.
Quando DataImpulse non è la scelta giusta?
Se ti servono proxy ISP statici, un’API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento giusto. Si concentra su residential proxy, mobile proxy e proxy datacenter rotanti per raccogliere dati pubblici e accedere ai contenuti.
Inizia a raccogliere dati dal web su larga scala
Se il tuo progetto si basa sulla raccolta automatizzata di dati dal web, proxy affidabili con targeting geografico mantengono operativa la pipeline. Crea un account DataImpulse per raccogliere dati su larga scala con IP residential, mobile e datacenter etici, pay-as-you-go.