
In this Article
การเลือกวิธีเก็บรวบรวมข้อมูลที่เหมาะสมเป็นตัวตัดสินว่าการวิเคราะห์น่าเชื่อถือหรือชวนให้เข้าใจผิด ตั้งแต่ก่อนสร้างแผนภูมิแม้แต่แผนภูมิเดียว คู่มือนี้อธิบายวิธีหลักที่ทีมต่างๆ ใช้ในปัจจุบัน ตั้งแต่งานวิจัยแบบสำรวจดั้งเดิมไปจนถึงการเก็บข้อมูลเว็บแบบอัตโนมัติ และช่วงเวลาที่แต่ละวิธีเหมาะสม
เนื้อหาครอบคลุมวิธีการแบบปฐมภูมิ ทุติยภูมิ และดิจิทัลอัตโนมัติ จากนั้นเจาะลึกการเก็บข้อมูลจากเว็บในระดับขนาดใหญ่ การตรวจสอบคุณภาพข้อมูล ตลอดจนกฎด้านจริยธรรมและการปฏิบัติตามข้อกำหนดที่ใช้กับทุกวิธี
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรม โดยมีที่อยู่ IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการครอบคลุม 195 ประเทศ ใช้รูปแบบจ่ายตามการใช้งาน เริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมปริมาณการใช้งานที่ไม่มีวันหมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- สามกลุ่ม: วิธีเก็บรวบรวมข้อมูลแบ่งเป็นแบบปฐมภูมิ (แบบสำรวจ การสัมภาษณ์ การสังเกต และการทดลอง) แบบทุติยภูมิ (ชุดข้อมูลสาธารณะและเชิงพาณิชย์) และแบบดิจิทัลอัตโนมัติ (web scraping, API, telemetry และเซ็นเซอร์ IoT)
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxy ซึ่งใช้ IP ของผู้บริโภคจริงที่หลีกเลี่ยงการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน ปริมาณการใช้งานไม่มีวันหมดอายุ และไม่มีค่าสมาชิก
- ความครอบคลุม: IP ที่จัดหาด้วยหลักจริยธรรมมากกว่า 90M ครอบคลุม 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
วิธีเก็บรวบรวมข้อมูลปฐมภูมิคืออะไร
วิธีเก็บรวบรวมข้อมูลปฐมภูมิรวบรวมข้อมูลต้นฉบับโดยตรงจากแหล่งข้อมูล โดยมักใช้แบบสำรวจ การสัมภาษณ์ การสังเกต และการทดลอง
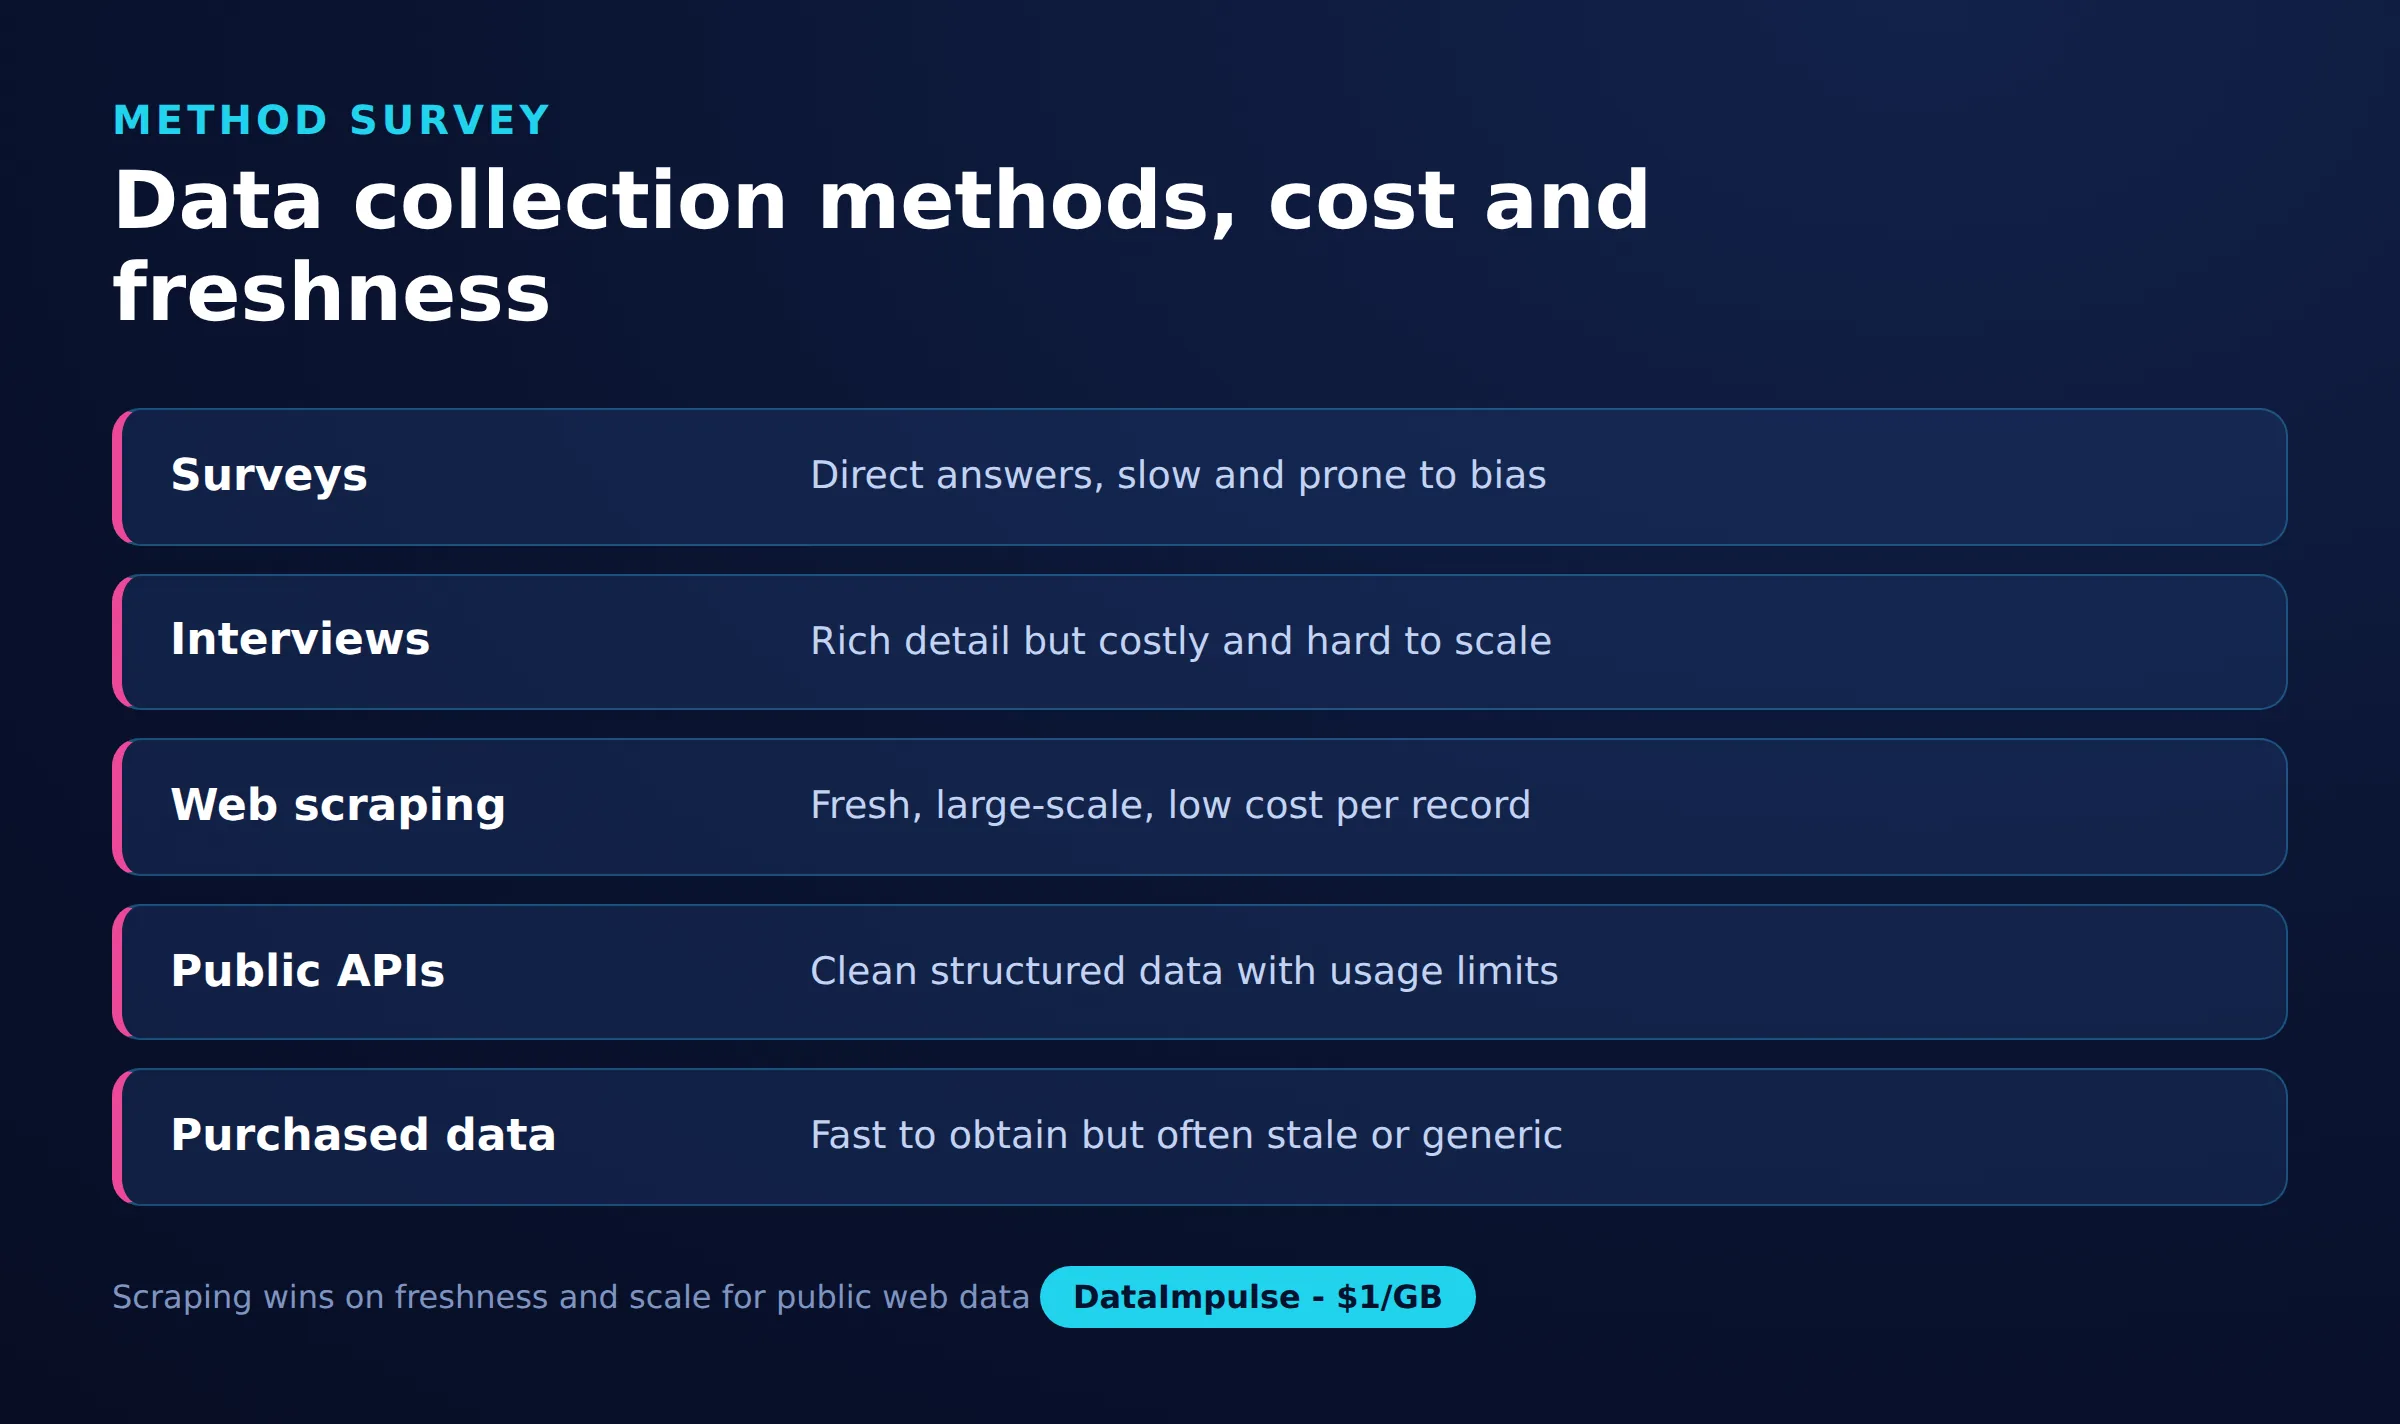
- แบบสำรวจและแบบสอบถาม: คำถามมาตรฐานที่ส่งไปยังกลุ่มตัวอย่าง ใช้เพื่อวัดทัศนคติหรือพฤติกรรมในวงกว้าง มีต้นทุนต่อคำตอบต่ำและวัดเชิงปริมาณได้ง่าย แต่อาจมีอคติจากการรายงานด้วยตนเองและอัตราการตอบกลับต่ำ ตัวอย่าง: บริษัท SaaS จัดทำแบบสำรวจ NPS รายไตรมาสเพื่อติดตามความพึงพอใจตามระดับแผนบริการ
- การสัมภาษณ์: การสนทนาแบบมีโครงสร้างหรือแบบเปิดกับบุคคล ใช้เมื่อจำเป็นต้องเข้าใจเชิงลึกและบริบท ไม่ใช่จำนวน ช่วยเปิดเผยเหตุผลเบื้องหลังตัวเลข แต่ไม่อาจสรุปทั่วไปจากคนเพียงไม่กี่คน ตัวอย่าง: ทีมผลิตภัณฑ์สัมภาษณ์ลูกค้า 10 รายที่เลิกใช้บริการเพื่อทำความเข้าใจเหตุผลที่ยกเลิก
- การสังเกต: เฝ้าดูพฤติกรรมโดยตรงด้วยตนเองหรือผ่านการบันทึกเซสชัน ใช้เมื่อสิ่งที่คนพูดแตกต่างจากสิ่งที่ทำ จับการกระทำจริงได้ แต่อาจใช้แรงงานมากและมีแนวโน้มเกิดอคติจากผู้สังเกต ตัวอย่าง: ผู้ค้าปลีกศึกษาการสัญจรในร้านเพื่อออกแบบผังชั้นวางใหม่
- การทดลอง: การทดสอบแบบควบคุมที่เปลี่ยนตัวแปรหนึ่งตัวและวัดผลกระทบ เช่น การทดสอบ A/B ใช้เพื่อยืนยันเหตุและผล ไม่ใช่เพียงความสัมพันธ์ ช่วยให้หลักฐานเชิงเหตุผลที่หนักแน่น แต่ต้องออกแบบอย่างรอบคอบและมีขนาดตัวอย่างเพียงพอ ตัวอย่าง: เว็บไซต์อีคอมเมิร์ซทดสอบ A/B ขั้นตอนชำระเงิน 2 แบบเพื่อดูว่าแบบใดเพิ่มอัตราการแปลงได้มากกว่า
ควรใช้การเก็บรวบรวมข้อมูลทุติยภูมิเมื่อใด
ใช้การเก็บรวบรวมข้อมูลทุติยภูมิเมื่อมีข้อมูลที่น่าเชื่อถืออยู่แล้ว เมื่อความรวดเร็วและงบประมาณสำคัญกว่าความพอดีอย่างสมบูรณ์แบบ หรือเมื่อจำเป็นต้องใช้บริบททางประวัติศาสตร์หรือมหภาคที่ไม่สามารถรวบรวมเองได้
แหล่งข้อมูลทุติยภูมิรวมถึงชุดข้อมูลสาธารณะและแบบเปิด ข้อมูลจากรัฐบาลและหน่วยงานสถิติ งานวิจัยทางวิชาการ และผู้ให้บริการข้อมูลเชิงพาณิชย์ ข้อมูลสาธารณะและภาครัฐ เช่น ตัวเลขสำมะโนหรือดัชนีเศรษฐกิจแบบเปิด มีความน่าเชื่อถือและมักไม่มีค่าใช้จ่าย แม้อาจล่าช้าและขาดรายละเอียดเชิงลึก ผู้ให้บริการข้อมูลเชิงพาณิชย์ขายชุดข้อมูลที่คัดสรรแล้ว เช่น ข้อมูลลักษณะบริษัท ขนาดตลาด หรือกลุ่มผู้บริโภค ซึ่งช่วยประหยัดแรงในการรวบรวม แต่เพิ่มต้นทุนด้านใบอนุญาตและการพึ่งพาวิธีการของผู้ขาย ความเสี่ยงหลักของข้อมูลทุติยภูมิทั้งหมดคือความสอดคล้องกัน: คำจำกัดความ ช่วงเวลา และภูมิศาสตร์อาจไม่ตรงกับคำถาม จึงควรอ่านเอกสารประกอบก่อนเชื่อถือตัวเลขเสมอ ตัวอย่าง: สตาร์ทอัพ fintech ประเมินขนาดตลาดใหม่โดยใช้ทะเบียนธุรกิจของรัฐร่วมกับรายงานอุตสาหกรรมที่ซื้อมา แทนการสำรวจทุกบริษัทด้วยตนเอง
การเก็บข้อมูลเว็บอัตโนมัติทำงานอย่างไร
การเก็บข้อมูลดิจิทัลอัตโนมัติใช้ซอฟต์แวร์เก็บข้อมูลอย่างต่อเนื่องจากเว็บ แอปพลิเคชัน และอุปกรณ์ที่เชื่อมต่อกัน โดย 4 วิธีที่พบบ่อยคือ web scraping, API อย่างเป็นทางการ, การเก็บ log และ telemetry และเซ็นเซอร์ IoT
- Web scraping: โปรแกรมร้องขอหน้าเว็บสาธารณะและดึงฟิลด์ที่มีโครงสร้างจาก HTML ใช้เมื่อข้อมูลปรากฏบนเว็บไซต์แต่ไม่มี API เปิดให้ใช้ เช่น การเก็บราคาคู่แข่งข้ามภูมิภาค ให้ความครอบคลุมกว้าง แต่ต้องบำรุงรักษาเมื่อเว็บไซต์เปลี่ยนแปลง และต้องเคารพเงื่อนไขกับขีดจำกัดอัตราการร้องขอ
- API อย่างเป็นทางการ: ผู้ให้บริการเปิดเผยข้อมูลผ่าน endpoint ที่มีเอกสารและส่งคืนคำตอบที่สะอาดมีโครงสร้าง ใช้ API เมื่อมีให้ใช้และเงื่อนไขครอบคลุมการใช้งาน เพราะเป็นเส้นทางที่เสถียรที่สุดและดูแลรักษาน้อยที่สุด ข้อจำกัดคือขอบเขต เพดานอัตรา และต้นทุน และไม่ใช่ทุกชุดข้อมูลจะมี API
- การเก็บ log และ telemetry: ระบบของตนเองสร้างเหตุการณ์ เช่น การดูหน้าเว็บ การคลิก หรือข้อผิดพลาด ซึ่งนำไปจัดเก็บและวิเคราะห์ ใช้เพื่อทำความเข้าใจว่าผู้ใช้มีพฤติกรรมอย่างไรในผลิตภัณฑ์จริง ข้อมูลนี้เป็น first-party และแม่นยำ แต่ครอบคลุมเฉพาะพื้นที่ของตนเอง
- ข้อมูล IoT และเซ็นเซอร์: อุปกรณ์จริงส่งค่าที่อ่านได้ เช่น อุณหภูมิ ตำแหน่ง หรือสถานะเครื่องจักร ใช้สำหรับงานปฏิบัติการ โลจิสติกส์ และการติดตามตรวจสอบ มีปริมาณมากและเป็นเวลาจริง แต่ต้องมีโครงสร้างพื้นฐานเพื่อรับเข้าและทำความสะอาดข้อมูล
วิธีอัตโนมัติเหล่านี้ขยายขนาดได้ไกลเกินกว่าการเก็บข้อมูลด้วยมือ จึงครองบทบาทใน data pipeline สมัยใหม่ หากต้องการมุมมองที่กว้างขึ้นเกี่ยวกับสิ่งที่ทีมต่างๆ สร้างด้วยข้อมูลที่ scrape แล้ว ดูคู่มือ กรณีใช้งาน web scraping ของเรา
Web scraping เทียบกับ API และการซื้อข้อมูล: แบบใดดีที่สุด
ตัวเลือกที่ดีที่สุดระหว่าง scraping, API อย่างเป็นทางการ และการซื้อชุดข้อมูล ขึ้นอยู่กับข้อแลกเปลี่ยน 3 ประการ ได้แก่ การควบคุมข้อมูล ความใหม่ของข้อมูล และต้นทุนรวมรวมถึงการบำรุงรักษา
- API อย่างเป็นทางการ: เหมาะที่สุดเมื่อมี API และเงื่อนไขกับขีดจำกัดอัตราการร้องขอสอดคล้องกับความต้องการ จะได้ข้อมูลที่สะอาดและเสถียรโดยดูแลรักษาน้อย แต่จำกัดอยู่ที่สิ่งที่ผู้ให้บริการเปิดเผย และอาจต้องจ่ายต่อการเรียกใช้
- Web scraping: เหมาะที่สุดเมื่อข้อมูลเป็นสาธารณะบนเว็บไซต์แต่ไม่มี API ที่ใช้ได้ หรือเมื่อต้องการความครอบคลุมกว้างจากหลายแหล่ง สามารถควบคุมได้อย่างแม่นยำว่าจะเก็บอะไรและให้ข้อมูลใหม่เพียงใด โดยแลกกับการสร้างและดูแล extractor และจัดการมาตรการต่อต้านบอต คู่มือ การ scraping โดยไม่ถูกบล็อก ของเราครอบคลุมด้านความน่าเชื่อถือ
- การซื้อชุดข้อมูล: เหมาะที่สุดเมื่อผู้ขายมีข้อมูลตรงกับที่ต้องการอยู่แล้ว และความรวดเร็วสำคัญกว่าการควบคุม ข้ามงานวิศวกรรมได้ แต่ต้องรับช่วงต่อความใหม่ ความครอบคลุม และเงื่อนไขใบอนุญาตของผู้ขาย
รูปแบบที่พบบ่อยคือการผสานทั้งสามอย่าง: ใช้ API ในจุดที่มีให้ใช้ scrape ส่วนที่ขาด และซื้อชุดข้อมูลเฉพาะทางที่ไม่คุ้มจะรวบรวมเอง DataImpulse เป็นผู้ให้บริการ proxy ไม่ใช่ API สำหรับ scraping แบบจัดการครบวงจรหรือตลาดข้อมูล ดังนั้นจึงเหมาะกับเส้นทาง scraping แทนที่จะมาทดแทน
proxy มีบทบาทอย่างไรในการเก็บรวบรวมข้อมูล
proxy อยู่ในวิธีเก็บข้อมูลเว็บอัตโนมัติ โดยช่วยให้ scraper รวบรวมข้อมูลในระดับขนาดใหญ่และมองเห็นเว็บในแบบที่ผู้ใช้จริงในประเทศเป้าหมายเห็น
งานเก็บข้อมูลขนาดใหญ่ส่งคำขอจำนวนมาก และเว็บไซต์มักจำกัดอัตราการร้องขอหรือบล็อกที่อยู่เดียวที่มีพฤติกรรมคล้ายบอต การส่งคำขอผ่านกลุ่ม IP ช่วยกระจายภาระและลดการถูกบล็อก proxy ยังช่วยให้เก็บข้อมูลตามตำแหน่งทางภูมิศาสตร์ได้แม่นยำ: ราคา ผลการค้นหา และความพร้อมใช้งานมักต่างกันตามสถานที่ ดังนั้น IP ในตลาดเป้าหมายจึงส่งคืนข้อมูลที่ผู้ใช้ในพื้นที่เห็นจริง Residential proxy ใช้ที่อยู่ที่กำหนดให้ครัวเรือนจริงและเหมาะกับเว็บไซต์ที่มีระบบต่อต้านบอตเข้มงวด mobile proxy ส่งผ่านเครือข่ายผู้ให้บริการมือถือสำหรับเป้าหมายที่ยากที่สุด และ datacenter proxy รวดเร็วกว่าและถูกกว่าสำหรับแหล่งที่ผ่อนปรน DataImpulse มีบริการเหล่านี้ในรูปแบบ proxy ที่มีจริยธรรม โดยจัดหาจากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน รวมการกำหนดเป้าหมายตามประเทศ และคิดราคาแบบจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB proxy ส่งผลต่อการนำส่งคำขอ ไม่ใช่คุณภาพของข้อมูลเอง ดังนั้นการตรวจสอบความถูกต้องยังสำคัญ
จะรับประกันคุณภาพข้อมูลข้ามวิธีการได้อย่างไร
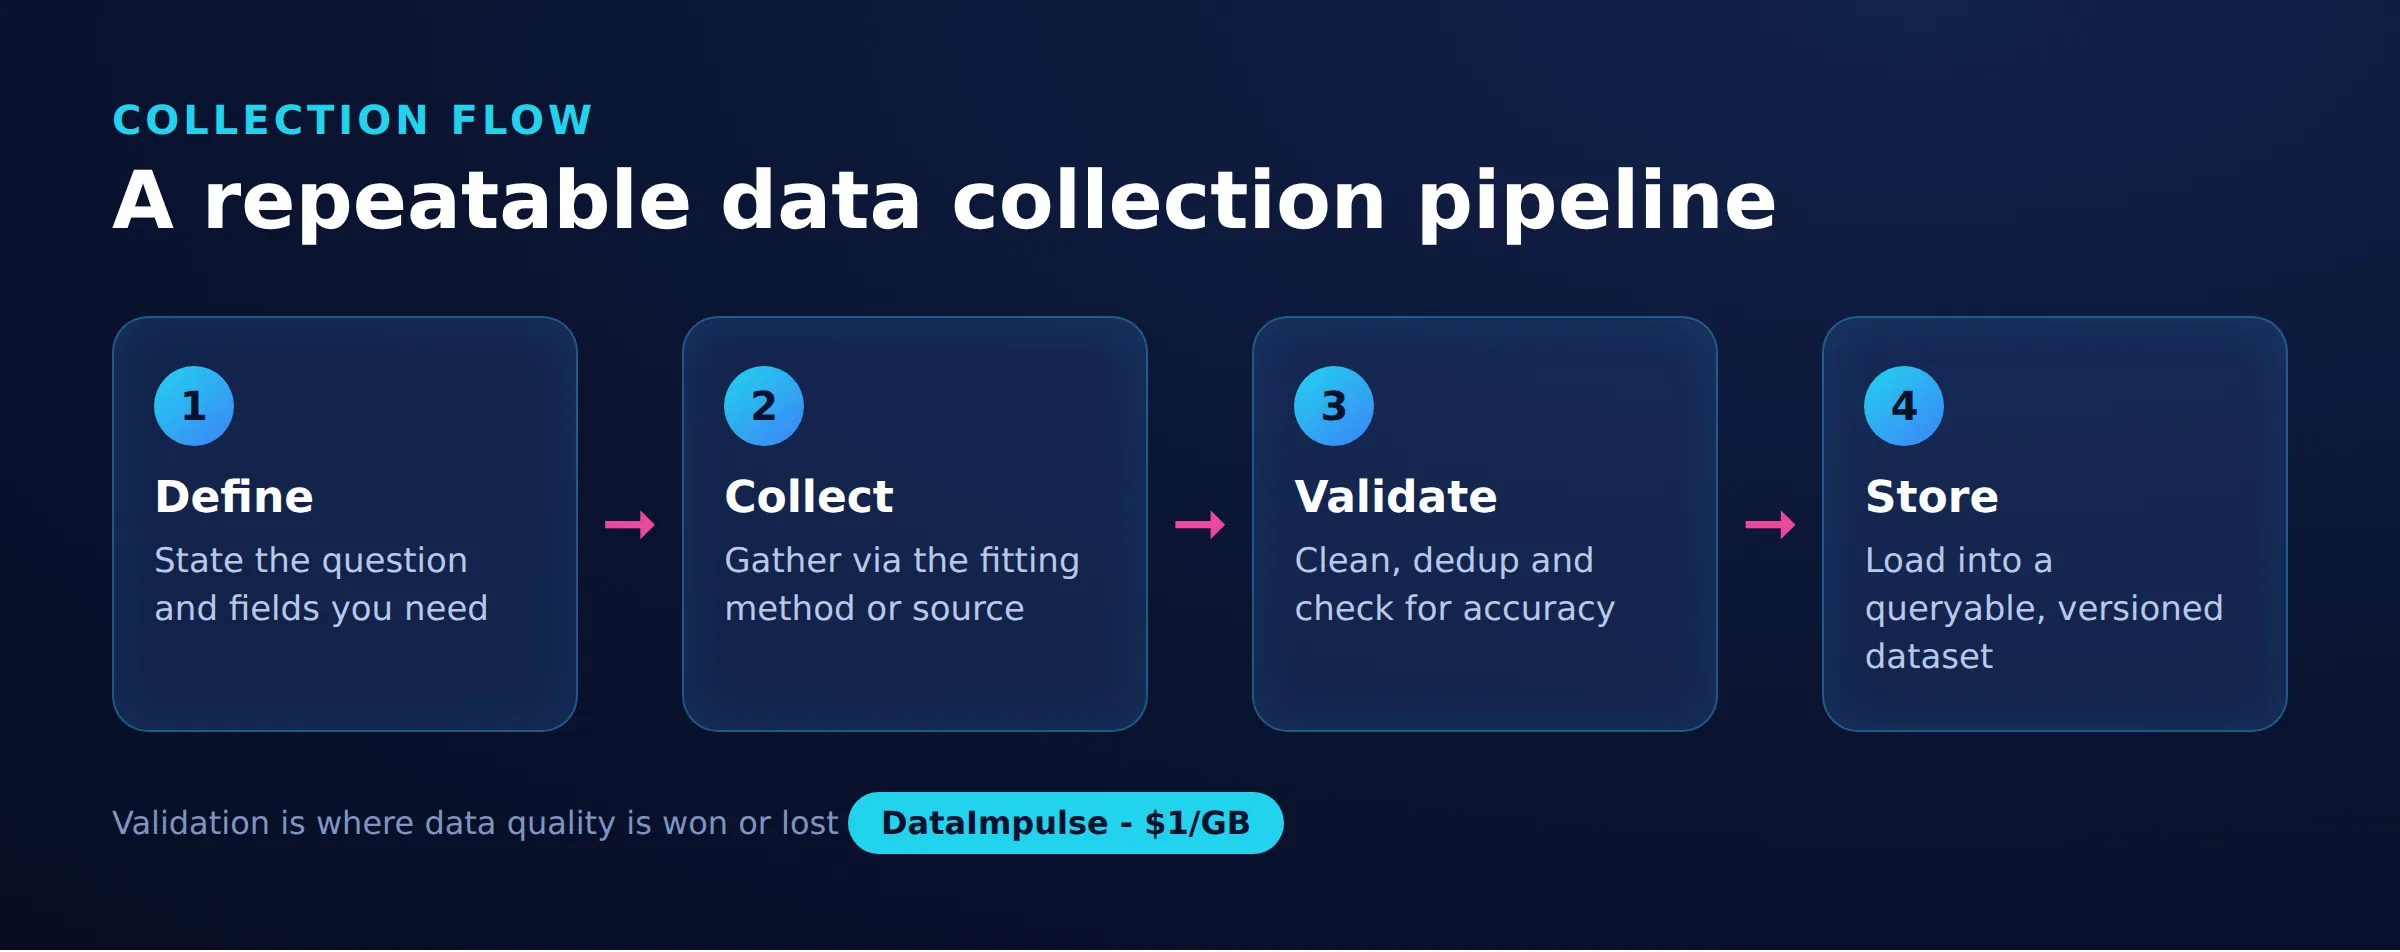
การรับประกันคุณภาพข้อมูลหมายถึงการตรวจสอบความถูกต้อง ความเป็นตัวแทน และความใหม่ของข้อมูลก่อนวิเคราะห์ ไม่ว่าจะผลิตข้อมูลด้วยวิธีเก็บรวบรวมใดก็ตาม
- การตรวจสอบความถูกต้อง: ยืนยันว่าแต่ละฟิลด์มีประเภท ช่วง และรูปแบบที่ถูกต้อง ลบข้อมูลซ้ำ และตรวจเทียบกับแหล่งอ้างอิงที่ทราบเมื่อทำได้ data pipeline อัตโนมัติควรปฏิเสธหรือทำเครื่องหมายระเบียนที่มีรูปแบบผิด แทนการจัดเก็บอย่างเงียบๆ
- อคติจากการสุ่มตัวอย่าง: ถามว่าข้อมูลเป็นตัวแทนของประชากรที่สนใจหรือไม่ แบบสำรวจที่มีเฉพาะลูกค้าพึงพอใจตอบ หรือหน้าเว็บที่ scrape จากภูมิภาคเดียว จะทำให้ข้อสรุปเอนเอียง ควรบันทึกวิธีคัดเลือกกลุ่มตัวอย่าง
- ความใหม่และการเสื่อมค่า: ข้อมูลสูญเสียคุณค่าเมื่อความเป็นจริงเปลี่ยนแปลง ราคา สินค้าคงคลัง และข้อมูลติดต่อเก่าเร็ว จึงต้องกำหนดว่าชุดข้อมูลแต่ละชุดควรรีเฟรชบ่อยเพียงใดและติดตามเวลาเก็บข้อมูล
data pipeline ที่ดีทำให้การตรวจสอบเหล่านี้ดำเนินต่อเนื่อง ไม่ใช่ทำครั้งเดียว เพราะการเก็บข้อมูลอัตโนมัติอาจขัดข้องอย่างเงียบๆ เมื่อแหล่งข้อมูลเปลี่ยนรูปแบบ
กฎด้านจริยธรรมและการปฏิบัติตามข้อกำหนดสำหรับการเก็บข้อมูลคืออะไร
การเก็บข้อมูลอย่างมีจริยธรรมและสอดคล้องข้อกำหนดตั้งอยู่บนฐานทางกฎหมายและความยินยอม การเก็บข้อมูลเท่าที่จำเป็น และการเคารพเงื่อนไขของแหล่งข้อมูลกับกฎหมายความเป็นส่วนตัวที่ใช้บังคับ เช่น GDPR
เก็บข้อมูลส่วนบุคคลเฉพาะเมื่อมีฐานทางกฎหมายที่ถูกต้อง และควรเลือกข้อมูลรวมกลุ่มหรือข้อมูลที่ไม่ระบุตัวตนแทนระเบียนที่ระบุตัวบุคคลได้ ปฏิบัติตามหลักเก็บข้อมูลเท่าที่จำเป็นด้วยการรวบรวมเฉพาะฟิลด์ที่ต้องใช้จริง และเก็บไว้นานเท่าที่จำเป็น สำหรับการเก็บข้อมูลเว็บ ให้เคารพเงื่อนไขการให้บริการ คำสั่ง robots และขีดจำกัดอัตราการร้องขอของเว็บไซต์ และหลีกเลี่ยงการเก็บข้อมูลส่วนบุคคลจากหน้าที่ไม่ได้เปิดเผยเป็นสาธารณะอย่างชัดเจน ภายใต้ GDPR และระเบียบที่คล้ายกัน ข้อมูลส่วนบุคคลมีภาระหน้าที่ด้านความโปร่งใส การจำกัดวัตถุประสงค์ และสิทธิของบุคคล ดังนั้นหลายทีมจึงตัดข้อมูลที่ระบุตัวบุคคลได้ออก ณ จุดเก็บรวบรวม แหล่งที่มาของโครงสร้างพื้นฐานในการเก็บข้อมูลก็สำคัญเช่นกัน: DataImpulse จัดหา IP จากผู้ใช้ที่เลือกเข้าร่วมอย่างชัดเจนและได้รับค่าตอบแทน สอดคล้องกับ GDPR และมีข้อตกลงการประมวลผลข้อมูล ซึ่งทำให้ชั้นการเก็บข้อมูลสอดคล้องกับแนวปฏิบัติด้านข้อมูลที่รับผิดชอบ
เปรียบเทียบวิธีเก็บรวบรวมข้อมูล
| วิธี | ต้นทุน | ความใหม่และการควบคุม |
|---|---|---|
| แบบสำรวจ | ปานกลาง | ใหม่ ควบคุมได้สูง |
| การสัมภาษณ์ | สูง | ใหม่ ควบคุมเชิงลึก |
| การสังเกต | ปานกลาง | เวลาจริง ควบคุมได้ปานกลาง |
| Web scraping | ต่ำ | ปัจจุบัน ควบคุมได้สูง |
| API | ต่ำถึงปานกลาง | สด จำกัดโดยผู้ให้บริการ |
| ชุดข้อมูลที่ซื้อ | แตกต่างกัน | มักเก่า ควบคุมได้น้อย |
คำถามที่พบบ่อย
วิธีเก็บรวบรวมข้อมูลปฐมภูมิและทุติยภูมิต่างกันอย่างไร
วิธีปฐมภูมิรวบรวมข้อมูลใหม่โดยตรงจากแหล่งข้อมูลผ่านแบบสำรวจ การสัมภาษณ์ การสังเกต หรือการทดลอง ดังนั้นข้อมูลจึงตรงกับคำถามอย่างแม่นยำ แต่ใช้เวลาและเงินมากกว่า วิธีทุติยภูมินำข้อมูลที่มีอยู่แล้ว เช่น ชุดข้อมูลสาธารณะหรือเชิงพาณิชย์ กลับมาใช้ จึงรวดเร็วและถูกกว่า แต่อาจไม่ตรงกับความต้องการอย่างพอดี
วิธีเก็บข้อมูลใดดีที่สุดสำหรับข้อมูลออนไลน์ขนาดใหญ่
สำหรับข้อมูลออนไลน์ปริมาณมาก วิธีอัตโนมัติเหนือกว่า: ใช้ API อย่างเป็นทางการเมื่อครอบคลุมความต้องการ และใช้ web scraping เมื่อข้อมูลเป็นสาธารณะแต่ไม่มี API ที่ใช้ได้ ทั้งสองวิธีขยายขนาดได้ไกลกว่าการเก็บด้วยมือ และการ scraping ในระดับขนาดใหญ่มักต้องใช้ proxy เพื่อหลีกเลี่ยงการจำกัดอัตราการร้องขอ
web scraping เป็นวิธีเก็บรวบรวมข้อมูลที่ถูกกฎหมายหรือไม่
การ scraping ข้อมูลที่เผยแพร่สู่สาธารณะอาจชอบด้วยกฎหมาย แต่สถานะทางกฎหมายขึ้นอยู่กับเงื่อนไขการให้บริการของเว็บไซต์ ประเภทข้อมูล และกฎหมายความเป็นส่วนตัว เช่น GDPR หลีกเลี่ยงการเก็บข้อมูลส่วนบุคคลโดยไม่มีฐานทางกฎหมาย เคารพขีดจำกัดอัตราการร้องขอและเงื่อนไข และขอคำแนะนำทางกฎหมายสำหรับกรณีใช้งานเฉพาะของคุณ
proxy ช่วยในการเก็บรวบรวมข้อมูลอย่างไร
proxy ส่งคำขอเก็บข้อมูลผ่านที่อยู่ IP จำนวนมาก ซึ่งกระจายภาระเพื่อลดการถูกบล็อก และช่วยให้เก็บข้อมูลตามตำแหน่งทางภูมิศาสตร์ได้แม่นยำตามที่ผู้ใช้ท้องถิ่นเห็น proxy ส่งผลต่อวิธีนำส่งคำขอ ไม่ใช่คุณภาพของข้อมูล ดังนั้นยังต้องตรวจสอบความถูกต้อง
จะรักษาความแม่นยำของข้อมูลที่เก็บไว้เมื่อเวลาผ่านไปได้อย่างไร
ตรวจสอบประเภท ช่วง และข้อมูลซ้ำของฟิลด์ขณะเก็บข้อมูล ตรวจว่ากลุ่มตัวอย่างเป็นตัวแทนประชากรเป้าหมาย และรีเฟรชข้อมูลตามกำหนด เพราะราคา สินค้าคงคลัง และข้อมูลติดต่อเสื่อมความใหม่เร็ว การตรวจสอบอย่างต่อเนื่องช่วยจับความขัดข้องเงียบๆ เมื่อแหล่งข้อมูลเปลี่ยนรูปแบบ
เมื่อใดที่ DataImpulse ไม่เหมาะสม
หากต้องการ static ISP proxy, API สำหรับ scraping ที่มีการจัดการครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและภาครัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยเน้น rotating residential, mobile และ datacenter proxy สำหรับเก็บข้อมูลสาธารณะและเข้าถึงเนื้อหา
คู่มือที่เกี่ยวข้อง
เริ่มเก็บข้อมูลเว็บในระดับขนาดใหญ่
หากโครงการอาศัยการเก็บข้อมูลเว็บอัตโนมัติ proxy ที่กำหนดเป้าหมายทางภูมิศาสตร์ได้และเชื่อถือได้จะช่วยให้ data pipeline ทำงานต่อเนื่อง สร้างบัญชี DataImpulse เพื่อเก็บข้อมูลในระดับขนาดใหญ่ด้วย IP แบบ residential, mobile และ datacenter ที่มีจริยธรรมและจ่ายตามการใช้งาน