
In this Article
Doğru veri toplama yöntemlerini seçmek, tek bir grafik çizilmeden önce analizin güvenilir mi yoksa yanıltıcı mı olacağını belirler. Bu rehber, klasik anket araştırmalarından otomatik web veri toplamaya kadar ekiplerin bugün kullandığı başlıca yöntemleri ve her birinin ne zaman uygun olduğunu açıklar.
Birincil, ikincil ve otomatik dijital yöntemleri ele alır; ardından web’den geniş ölçekte veri toplamayı, veri kalitesi kontrollerini ve her yönteme uygulanan etik ve uyumluluk kurallarını daha ayrıntılı inceler.
DataImpulse, 195 ülkede 90 milyondan fazla residential, mobile ve datacenter IP adresi sunan etik bir proxy sağlayıcısıdır. GB başına 1 dolardan başlayan, süresi dolmayan trafik içeren kullandıkça öde modeli kullanır ve web scraping, reklam doğrulama, fiyat izleme, pazar araştırması ve çoklu hesap yönetimi için kullanılır.
Önemli Bilgiler
- Üç kategori: Veri toplama yöntemleri; birincil (anketler, görüşmeler, gözlem, deneyler), ikincil (kamuya açık ve ticari veri kümeleri) ve otomatik dijital yöntemler (web scraping, API’ler, telemetri ve IoT sensörleri) olarak ayrılır.
- En iyi proxy türü: Bot tespitinden kaçabilen gerçek tüketici IP’lerini kullanan dönen residential proxy’ler.
- Fiyat: GB başına 1 dolardan başlayan, abonelik gerektirmeyen ve süresi dolmayan trafik içeren kullandıkça öde modeli.
- Kapsama: 195 ülkede etik biçimde tedarik edilmiş 90 milyondan fazla IP.
- Güvenilirlik: %99,51 başarı oranı, G2’de 5 üzerinden 4,8 puan.
- Protokoller ve hedefleme: Ülke hedefleme dahil HTTP, HTTPS ve SOCKS5.
Birincil veri toplama yöntemleri nelerdir?
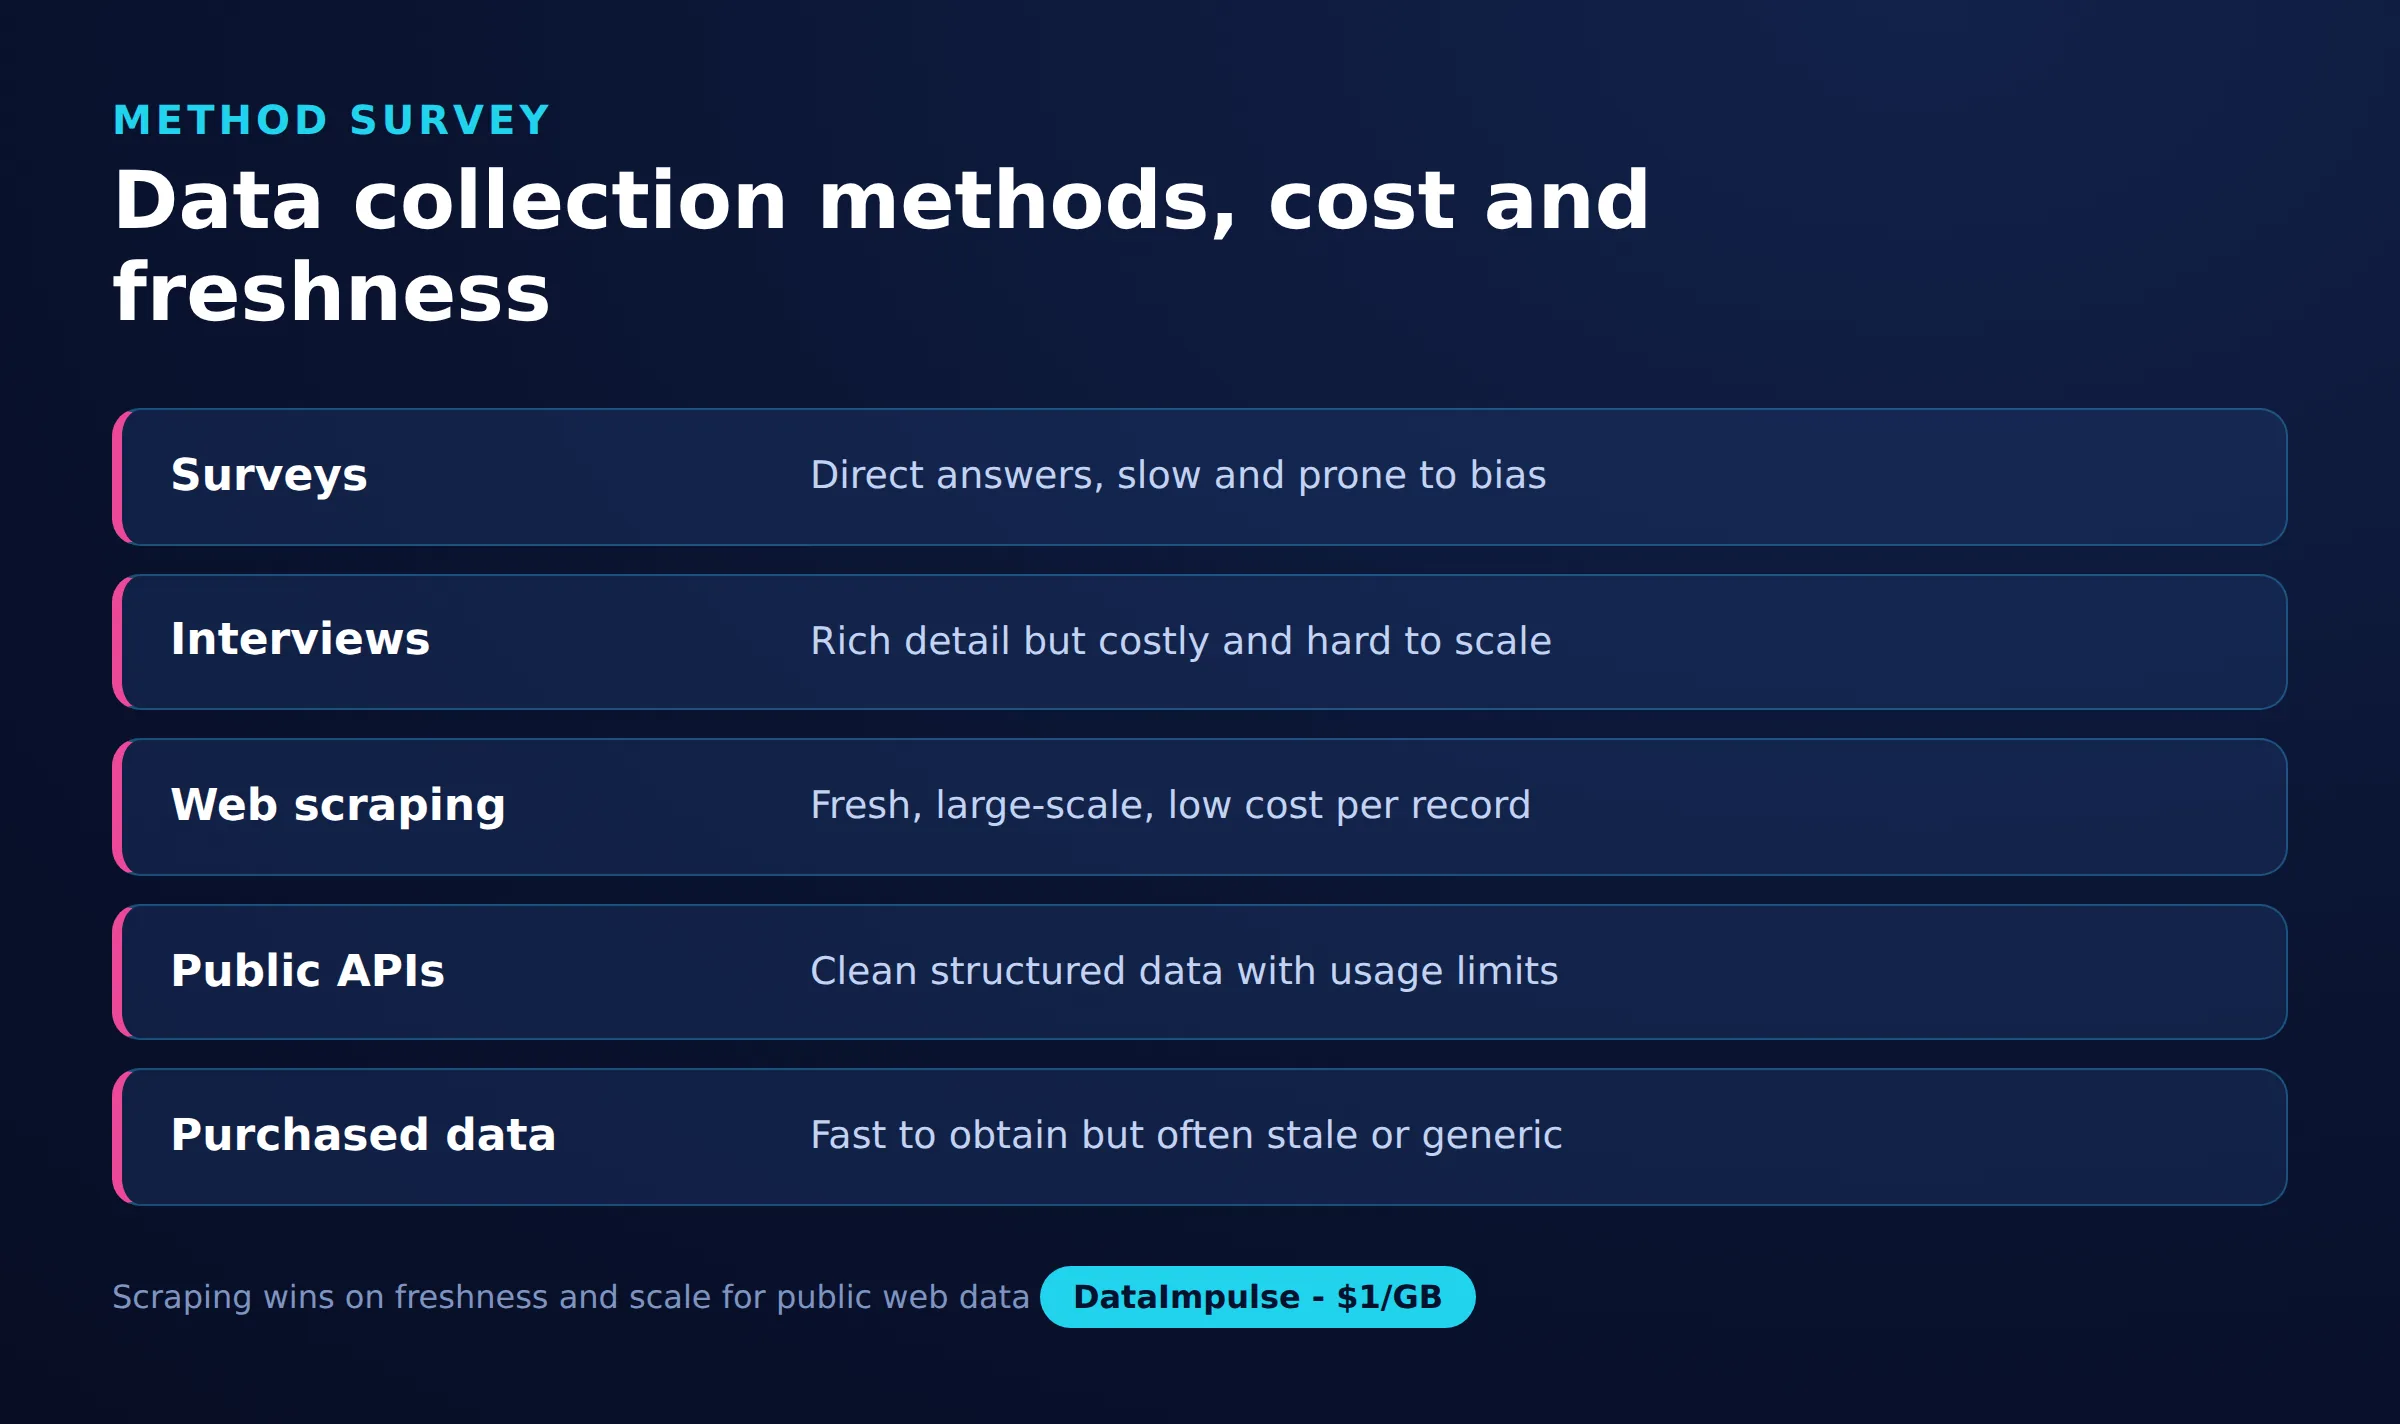
Birincil veri toplama yöntemleri, çoğunlukla anketler, görüşmeler, gözlem ve deneyler aracılığıyla doğrudan bir kaynaktan özgün veri toplar.
- Anketler ve soru formları: Bir örnekleme gönderilen standartlaştırılmış sorulardır. Tutumları veya davranışları geniş ölçekte ölçmek için kullanın. Yanıt başına maliyetleri düşüktür ve nicelleştirilmeleri kolaydır; ancak öz bildirim yanlılığı ve düşük yanıt oranlarından etkilenirler. Örnek: Bir SaaS şirketi, plan katmanlarına göre memnuniyeti izlemek için üç aylık NPS anketi yapar.
- Görüşmeler: Kişilerle yapılan yapılandırılmış veya açık uçlu konuşmalardır. Sayılardan çok derinlik ve bağlama ihtiyaç duyduğunuzda kullanın. Bir sayının arkasındaki nedeni ortaya çıkarırlar, ancak az sayıda kişiden genelleme yapılamaz. Örnek: Bir ürün ekibi, neden iptal ettiklerini anlamak için hizmeti bırakan on müşteriyle görüşür.
- Gözlem: Davranışı yüz yüze veya oturum kaydı üzerinden doğrudan izlemektir. İnsanların söyledikleri yaptıklarından farklı olduğunda kullanın. Gerçek eylemleri yakalar ancak emek yoğun olabilir ve gözlemci yanlılığına açıktır. Örnek: Bir perakendeci, raf düzenini yeniden tasarlamak için mağaza içi yaya trafiğini inceler.
- Deneyler: A/B testi gibi tek bir değişkeni değiştirip etkisini ölçen kontrollü testlerdir. Yalnızca korelasyonu değil, nedenselliği ortaya koymak için kullanın. Güçlü nedensel kanıt sunarlar ancak dikkatli tasarım ve yeterli örneklem büyüklüğü gerektirirler. Örnek: Bir e-ticaret sitesi, hangisinin dönüşümü artırdığını görmek için iki ödeme akışını A/B testine tabi tutar.
İkincil veri toplamayı ne zaman kullanmalısınız?
Güvenilir veri zaten mevcutsa, hız ve bütçe kusursuz uyumdan daha önemliyse veya kendi başınıza toplayamayacağınız geçmişe dönük ya da makro bağlama ihtiyaç duyuyorsanız ikincil veri toplamayı kullanın.
İkincil kaynaklar; kamuya açık ve açık veri kümelerini, devlet ve istatistik kurumu verilerini, akademik araştırmaları ve ticari veri sağlayıcılarını içerir. Nüfus sayımı rakamları ya da açık ekonomik göstergeler gibi kamu ve devlet verileri yetkin ve genellikle ücretsizdir; ancak gecikebilir ve ayrıntı düzeyi yetersiz olabilir. Ticari veri sağlayıcıları şirket profilleri, pazar büyüklüğü veya tüketici panelleri gibi düzenlenmiş veri kümelerini satar; toplama çabasından tasarruf sağlarlar ancak lisans maliyeti ve sağlayıcının metodolojisine bağımlılık getirirler. Tüm ikincil verilerdeki temel risk uyumdur: Tanımlar, zaman aralıkları ve coğrafya sorunuzla örtüşmeyebilir, bu nedenle rakamlara güvenmeden önce her zaman dokümantasyonu okuyun. Örnek: Bir fintech girişimi, her şirketi kendisi araştırmak yerine devlet işletme kayıtları ile satın alınmış bir sektör raporunu kullanarak yeni bir pazarın büyüklüğünü belirler.
Otomatik web veri toplama nasıl çalışır?
Otomatik dijital veri toplama, verileri web’den, uygulamalardan ve bağlı cihazlardan sürekli yakalamak için yazılım kullanır. Yaygın dört yöntem web scraping, resmi API’ler, günlük ve telemetri toplama ile IoT sensörleridir.
- Web scraping: Programlar kamuya açık web sayfalarına istek gönderir ve HTML’den yapılandırılmış alanları çıkarır. Veriler bir sitede görünür durumdaysa ancak bunları sunan bir API yoksa, örneğin bölgeler genelinde rakip fiyatlarını toplamak için kullanın. Geniş kapsama sağlar ancak siteler değiştikçe bakım gerektirir ve koşullara ile hız sınırlarına uyulmalıdır.
- Resmi API’ler: Bir sağlayıcı, temiz ve yapılandırılmış yanıtlar döndüren belgelenmiş bir uç nokta üzerinden veri sunar. Mevcut olduğunda ve koşulları kullanımınızı kapsadığında API kullanın; en istikrarlı ve en az bakım gerektiren yoldur. Kapsam, hız sınırları ve maliyet kısıtlayıcıdır; ayrıca her veri kümesinin API’si yoktur.
- Günlük ve telemetri toplama: Kendi sistemleriniz; sayfa görüntülemeleri, tıklamalar veya hatalar gibi, depolayıp analiz ettiğiniz olaylar üretir. Kullanıcıların ürününüzde gerçekte nasıl davrandığını anlamak için kullanın. Birinci taraflı ve kesindir, ancak yalnızca kendi yüzeyinizi kapsar.
- IoT ve sensör verileri: Fiziksel cihazlar sıcaklık, konum veya makine durumu gibi ölçümleri aktarır. Operasyonlar, lojistik ve izleme için kullanın. Hacmi yüksektir ve gerçek zamanlıdır, ancak alma ve temizleme için altyapı gerektirir.
Bu otomatik yöntemler manuel toplamayı büyük ölçüde aşacak şekilde ölçeklenir; bu nedenle modern veri ardışık düzenlerine hakimdir. Ekiplerin kazınmış verilerle neler oluşturduğuna daha geniş bir bakış için web scraping kullanım alanları rehberimize göz atın.
Web scraping, API’ler ve veri satın alma: Hangisi en iyisi?
Scraping, resmi API’ler ve veri kümeleri satın alma arasındaki en iyi seçim üç denge unsuruna bağlıdır: veri üzerindeki kontrol, güncellik ve bakım dahil toplam maliyet.
- Resmi API: Mevcut olduğunda, koşulları ve hız sınırları gereksiniminize uyduğunda en iyisidir. Az bakımla temiz ve istikrarlı veri alırsınız; ancak sağlayıcının sunduklarıyla sınırlı kalırsınız ve çağrı başına ödeme yapabilirsiniz.
- Web scraping: Veriler bir sitede herkese açıksa ama kullanılabilir API yoksa veya birçok kaynak genelinde geniş kapsama ihtiyacınız varsa en iyisidir. Ne toplayacağınızı ve ne kadar güncel olacağını tam olarak kontrol edersiniz; bunun karşılığında çıkarıcılar oluşturup sürdürmeniz ve bot karşıtı önlemleri ele almanız gerekir. Engellenmeden scraping rehberimiz güvenilirlik yönünü ele alır.
- Veri kümesi satın alma: Bir satıcı ihtiyacınız olanı zaten tam olarak satıyorsa ve hız kontrolden daha önemliyse en iyisidir. Mühendislik işini atlarsınız ancak satıcının güncelliğini, kapsamını ve lisans koşullarını devralırsınız.
Yaygın bir yaklaşım bunları birleştirmektir: Mevcut olduğunda API’leri kullanın, eksikleri scrape edin ve toplanması pratik olmayan uzmanlık veri kümelerini satın alın. DataImpulse bir proxy sağlayıcısıdır; yönetilen scraping API’si veya veri pazaryeri değildir, dolayısıyla onun yerine geçmekten çok scraping yoluna uygundur.
Proxy’ler veri toplamada nereye oturur?
Proxy’ler otomatik web toplama yöntemine dahildir; scraper’ların verileri geniş ölçekte toplamasını ve web’i hedef ülkedeki gerçek kullanıcıların gördüğü biçimde görmesini sağlar.
Büyük toplama işleri çok sayıda istek gönderir ve siteler genellikle bot gibi davranan tek bir adresi hız sınırına takar veya engeller. İstekleri bir IP havuzu üzerinden yönlendirmek yükü dağıtır ve engellenmeyi azaltır. Proxy’ler ayrıca coğrafi olarak doğru toplama yapılmasını sağlar: Fiyatlar, arama sonuçları ve kullanılabilirlik çoğu zaman konuma göre farklılık gösterir; bu nedenle hedef pazardaki bir IP, yerel kullanıcıların gerçekten gördüğü verileri döndürür. Residential proxy’ler gerçek hanelere atanmış adresleri kullanır ve katı bot karşıtı sistemlere sahip siteler için uygundur, mobile proxy’ler en zor hedefler için operatör ağları üzerinden yönlendirir ve datacenter proxy’ler toleranslı kaynaklar için daha hızlı ve daha ucuzdur. DataImpulse bunları, onay veren ve karşılığında ücret alan kullanıcılardan etik biçimde tedarik edilen etik proxy’ler olarak sunar; ülke hedefleme dahildir ve fiyatlandırma GB başına bir dolardan başlayan kullandıkça öde modelindedir. Proxy’ler isteklerin iletilmesini etkiler, veri kalitesini değil; bu nedenle doğrulama yine önemlidir.
Yöntemler genelinde veri kalitesini nasıl sağlarsınız?
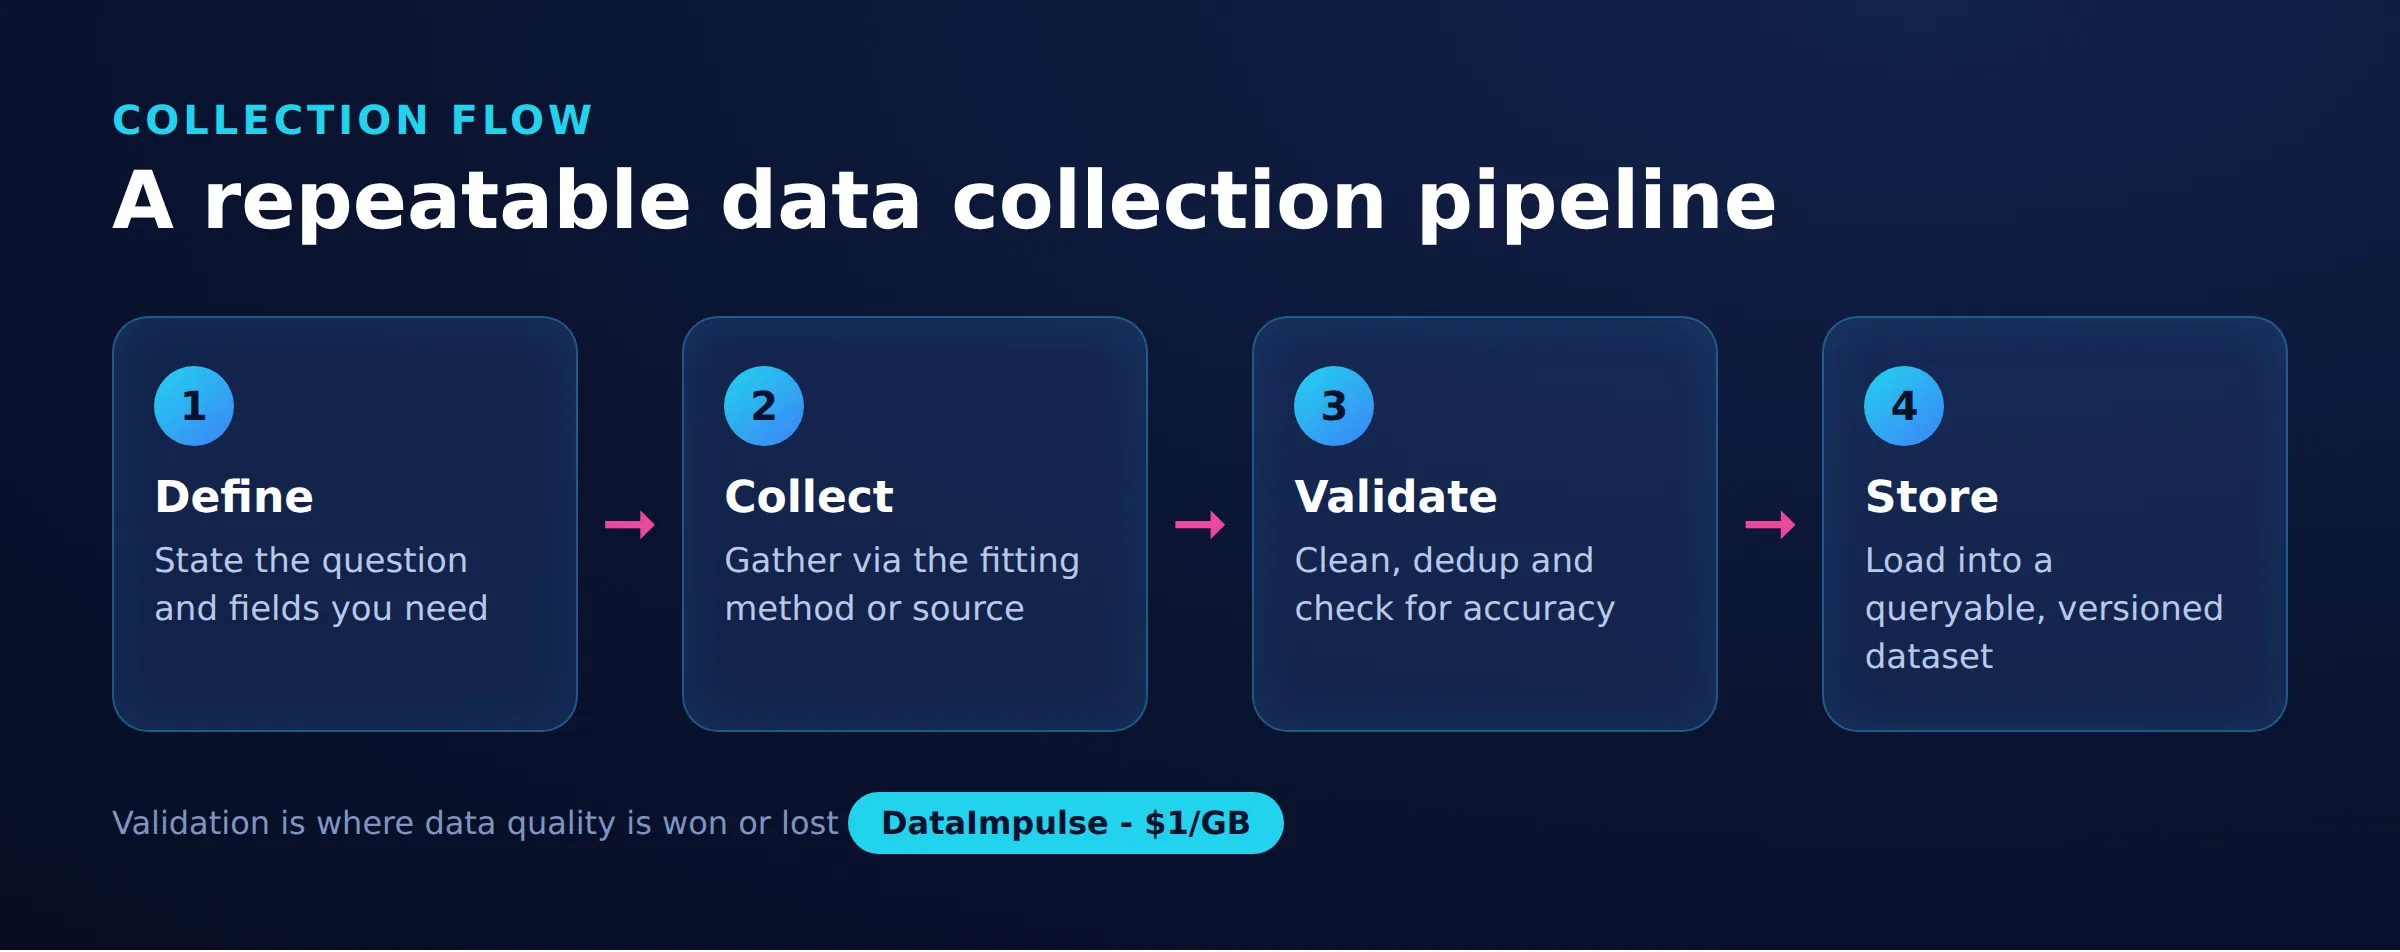
Veri kalitesini sağlamak, veriyi hangi toplama yöntemi üretmiş olursa olsun analizden önce geçerliliği, temsil ediciliği ve güncelliği kontrol etmek demektir.
- Doğrulama: Her alanın doğru tür, aralık ve biçime sahip olduğunu onaylayın, yinelenenleri kaldırın ve mümkünse bilinen bir referansla karşılaştırın. Otomatik ardışık düzenler, hatalı biçimlendirilmiş kayıtları sessizce depolamak yerine reddetmeli veya işaretlemelidir.
- Örneklem yanlılığı: Verinin önem verdiğiniz popülasyonu temsil edip etmediğini sorun. Yalnızca memnun müşterilerin yanıtladığı bir anket veya tek bir bölgeden scrape edilen sayfalar sonuçları çarpıtır. Örneklemin nasıl seçildiğini belgelendirin.
- Güncellik ve eskime: Gerçeklik değiştikçe verinin değeri azalır. Fiyatlar, stoklar ve iletişim bilgileri hızla güncelliğini yitirir; bu nedenle her veri kümesinin ne sıklıkla yenilenmesi gerektiğini tanımlayın ve toplama zaman damgalarını takip edin.
İyi ardışık düzenler bu kontrolleri tek seferlik değil sürekli hale getirir; çünkü bir kaynak biçimini değiştirdiğinde otomatik toplama fark edilmeden bozulabilir.
Veri toplamada etik ve uyumluluk kuralları nelerdir?
Etik ve uyumlu veri toplama; hukuki dayanak ve onaya, veri minimizasyonuna ve kaynağın koşullarıyla GDPR gibi geçerli gizlilik yasalarına saygıya dayanır.
Kişisel verileri yalnızca geçerli bir hukuki dayanakla toplayın ve kimliği belirlenebilir kayıtlar yerine toplulaştırılmış veya anonimleştirilmiş verileri tercih edin. Yalnızca gerçekten ihtiyacınız olan alanları toplayarak ve bunları gerekenden uzun süre tutmayarak veri minimizasyonu uygulayın. Web toplamada bir sitenin hizmet koşullarına, robots yönergelerine ve hız sınırlarına uyun; açıkça kamuya açık olmayan sayfalardan kişisel veri toplamaktan kaçının. GDPR ve benzer düzenlemeler kapsamında kişisel veriler; şeffaflık, amaç sınırlaması ve bireysel haklarla ilgili yükümlülükler taşır. Bu nedenle birçok ekip, kişisel olarak tanımlanabilir bilgileri toplama noktasında ayıklar. Toplama altyapısının tedarik edilme biçimi de önemlidir: DataImpulse IP’lerini açıkça onay veren ve karşılığında ücret alan kullanıcılardan tedarik eder, GDPR ile uyumludur ve bir veri işleme sözleşmesi sunar; böylece toplama katmanı sorumlu veri uygulamasıyla tutarlı kalır.
Veri toplama yöntemleri karşılaştırması
| Yöntem | Maliyet | Güncellik ve kontrol |
|---|---|---|
| Anket | Orta | Güncel, yüksek kontrol |
| Görüşme | Yüksek | Güncel, derin kontrol |
| Gözlem | Orta | Gerçek zamanlı, orta düzey kontrol |
| Web scraping | Düşük | Güncel, yüksek kontrol |
| API | Düşük ile orta arası | Canlı, sağlayıcıyla sınırlı |
| Satın alınmış veri kümeleri | Değişir | Genellikle eski, düşük kontrol |
Sık sorulan sorular
Birincil ve ikincil veri toplama yöntemleri arasındaki fark nedir?
Birincil yöntemler, anketler, görüşmeler, gözlem veya deneyler aracılığıyla doğrudan bir kaynaktan yeni veri toplar; bu nedenle veri tam sorunuza uyar, ancak daha fazla zaman ve para gerektirir. İkincil yöntemler, kamuya açık veya ticari veri kümeleri gibi mevcut verileri yeniden kullanır; bu daha hızlı ve ucuzdur ancak ihtiyaçlarınıza tam olarak uymayabilir.
Büyük ölçekli çevrimiçi veriler için hangi veri toplama yöntemi en iyisidir?
Büyük hacimli çevrimiçi veriler için otomatik yöntemler öne çıkar: Gereksiniminizi kapsıyorsa resmi API kullanın, veri herkese açıksa ancak kullanılabilir bir API yoksa web scraping kullanın. Her ikisi de manuel toplamadan çok daha geniş ölçekte çalışır ve geniş ölçekte scraping yapmak, hız sınırlarına takılmamak için genellikle proxy’ler gerektirir.
Web scraping yasal bir veri toplama yöntemi midir?
Kamuya açık verileri scrape etmek yasal olabilir, ancak yasallık sitenin hizmet koşullarına, veri türüne ve GDPR gibi gizlilik yasalarına bağlıdır. Hukuki dayanak olmadan kişisel veri toplamaktan kaçının, hız sınırlarına ve koşullara uyun; özel kullanım durumunuz için hukuki rehberliğe başvurun.
Proxy’ler veri toplamaya nasıl yardımcı olur?
Proxy’ler toplama isteklerini birçok IP adresi üzerinden yönlendirir; bu, engellenmeyi azaltmak için yükü dağıtır ve yerel kullanıcıların göreceği şekilde coğrafi olarak doğru veri toplamanızı sağlar. İsteklerin nasıl iletildiğini etkilerler, verinin kalitesini değil; bu nedenle doğrulama yine gereklidir.
Toplanan verileri zaman içinde nasıl doğru tutarsınız?
Toplama sırasında alanları tür, aralık ve yinelenenler açısından doğrulayın; örnekleminizin hedef popülasyonu temsil ettiğini kontrol edin ve fiyatlar, stoklar ile iletişim bilgileri hızla eskidiği için verileri bir takvime göre yenileyin. Sürekli kontroller, bir kaynak biçimini değiştirdiğinde sessiz bozulmaları yakalar.
DataImpulse ne zaman doğru seçim değildir?
Statik ISP proxy’lere, tamamen yönetilen bir scraping API’sine veya bankacılık ve devlet sitelerine erişime ihtiyacınız varsa DataImpulse doğru araç değildir. Kamuya açık verileri toplamak ve içeriğe erişmek için dönen residential, mobile ve datacenter proxy’lere odaklanır.
Web verilerini geniş ölçekte toplamaya başlayın
Projeniz otomatik web veri toplamaya dayanıyorsa, güvenilir coğrafi hedeflemeli proxy’ler ardışık düzenin çalışmasını sürdürür. Etik, kullandıkça öde residential, mobile ve datacenter IP’lerle geniş ölçekte veri toplamak için bir DataImpulse hesabı oluşturun.