
In questo articolo
Il marketing dipende sempre di più dall’analisi immediata delle piattaforme social. Ad esempio, la ricerca di influencer comporta lo scraping dei profili Instagram per valutare i livelli di coinvolgimento, la crescita dei follower e le tendenze dei contenuti. Potresti analizzare decine di account ogni giorno per valutare la portata, i tassi di coinvolgimento, la crescita dei follower o la frequenza dei contenuti sponsorizzati. Questo significa che devi estrarre contenuti in località diverse. Senza la configurazione giusta, verrai bloccato a metà strada oppure raccoglierai dati incompleti che possono portare a decisioni sbagliate.
Dopo aver letto questo articolo, scoprirai cosa comprende lo stack essenziale e come può trasformare scraper fragili in macchine affidabili per la raccolta dati.
Come vengono raccolti oggi i dati dei social media
I dati dei social media non compaiono magicamente nei dashboard di marketing. La maggior parte dei team si affida a strumenti automatizzati e script personalizzati che estraggono dati pubblici come commenti, hashtag, numero di follower o menzioni. Che tu raccolga dati da Twitter, Reddit, Instagram o TikTok, il web scraping è il modo in cui i marketer sfruttano l’enorme volume di informazioni grezze nascoste in bella vista. L’obiettivo? Trasformare questo flusso caotico in qualcosa di strutturato.
Un marketer può estrarre centinaia di tweet o discussioni Reddit sul proprio brand o sul lancio di un prodotto, quindi passare quel testo attraverso un classificatore per rilevare se le persone lo adorano o lo criticano duramente. Ma se i dati sono parziali, ad esempio mancano post regionali, sono filtrati in modo troppo restrittivo o vengono bloccati dopo poche richieste, l’istantanea del sentiment risulta distorta. In superficie, la tua campagna sembra un successo, ma la realtà potrebbe essere diversa altrove.
Ecco perché l’accuratezza è importante. Gli specialisti del marketing devono disporre di set di dati puliti e completi. Il loro successo dipende da questo. Ma raccogliere dati di qualità non è facile. Tra limiti di frequenza, blocchi degli IP e contenuti con restrizioni geografiche, ottenere il quadro completo è una sfida tecnica. Ti mostreremo che la vera soluzione sta nell’usare il toolkit adatto.
Non è solo cliccare e raccogliere
A prima vista, lo scraping dei social media sembra un’attività semplice: basta prendere uno strumento e lasciarlo lavorare. Ma sotto la superficie è un labirinto di ostacoli. Piattaforme come Instagram, TikTok e X (in precedenza Twitter) sono progettate per resistere agli accessi automatizzati. Frequenti blocchi degli IP, restrizioni geografiche, barriere captcha, caricamento dinamico dei contenuti e limiti di frequenza rendono difficile perfino la raccolta dei dati di base.
Immagina di monitorare i concorrenti su più piattaforme. Vuoi analizzare le interazioni del loro pubblico, la frequenza dei post e il modo in cui rispondono ai feedback. Tuttavia, alcune piattaforme rilevano subito i pattern di scraping, soprattutto quando le richieste provengono dallo stesso IP. Altre caricano i contenuti dinamicamente, perciò gli scraper devono imitare utenti reali solo per accedere ai dati.
Questi livelli di difesa non sono soltanto fastidi tecnici: incidono direttamente sulla qualità e sull’affidabilità delle informazioni che raccogli.
Strumenti per risolvere il rompicapo dello scraping
Molte piattaforme modificano continuamente le proprie policy e rendono più difficile accedere ai dati. Per questo ogni specialista ha bisogno di uno stack tecnologico intelligente e aggiornato, composto da scraper affidabili, browser headless e strumenti in grado di gestire contenuti dinamici, elementi nascosti e solide difese anti-bot.
Partiamo dalle basi. Framework Python gratuiti e open-source come Scrapy o piattaforme cloud come Apify rendono semplice creare configurazioni di scraping flessibili e scalabili. Che tu stia monitorando hashtag TikTok o raccogliendo statistiche di coinvolgimento da Instagram, questi strumenti possono esserti utili.
Per i marketer che preferiscono evitare il codice, piattaforme visive come Octoparse e ParseHub offrono interfacce intuitive con trascinamento. Sono un’ottima scelta per attività rapide di raccolta dati specifiche per una campagna, da completare nel breve periodo.
Ma gli scraper da soli non bastano. Quando le piattaforme social caricano i contenuti dinamicamente o richiedono l’accesso, servono strumenti di automazione del browser come Playwright, Selenium, o Puppeteer per simulare il comportamento di utenti reali. Questi strumenti sono essenziali per raccogliere post completi, statistiche di coinvolgimento o contenuti nascosti dietro funzionalità di scorrimento.
Un altro passaggio consiste nell’integrare un risolutore di captcha come CapSolver. Con questo supporto, la tua configurazione può gestire anche gli ambienti di scraping più restrittivi. E naturalmente, altrettanto importanti sono i proxy. I residential proxy e i proxy mobile manterranno i tuoi IP in rotazione e ti aiuteranno a non essere rilevato.
Come rapido riepilogo, ecco i componenti principali di uno stack di scraping affidabile:
- Scraper – Piattaforme come Scrapy, Apify o Octoparse per una raccolta dati strutturata e scalabile;
- Automazione del browser – Strumenti come Playwright, Selenium o Puppeteer per gestire contenuti dinamici e simulare il comportamento degli utenti;
- Risolutori di controlli di sicurezza – Servizi come CapSolver per supportare un accesso stabile;
- Proxy – residential proxy o proxy mobile per ruotare gli IP e non essere rilevato.
Assicurati di avere tutti questi elementi.
Lavora su dati più puliti con i proxy
Perché i proxy? Per la libertà di raccogliere e la sicurezza di agire. Gestiscono professionalmente le richieste usando un pool di IP in rotazione, garantendo un’elevata disponibilità e integrità dei dati. Il risultato è un sistema affidabile per raccogliere dati senza tempi di inattività.
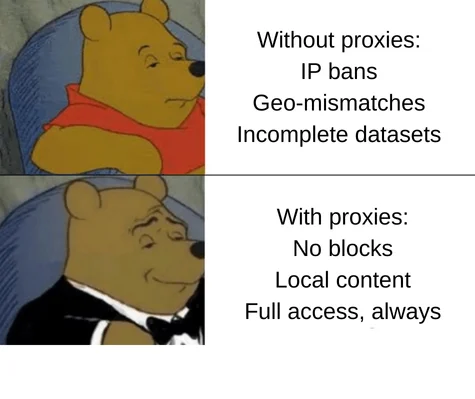
Ma quale tipo di proxy è il migliore per lo scraping social? Per chi lavora nel marketing, è importante raccogliere dati senza barriere e accedere a contenuti da località diverse. In questo caso, i proxy devono offrire stabilità, anonimato e tassi di successo elevati. Sono proprio questi i punti di forza dei residential proxy. Con DataImpulse, puoi provarli a soli $1 per 1 GB senza scadenza del traffico. Poiché il traffico non scade mai, è un modo intelligente e a basso rischio per fare test e capire cosa funziona.
Conclusione
In breve, uno scraping social efficace non dipende dalla fortuna, ma dalla costruzione del sistema giusto. Che tu stia monitorando tendenze o cercando contatti, disporre di dati di qualità è indispensabile. Ti servono dati accurati e affidabili per compiere azioni che contano davvero. E i proxy, come strumento, possono aiutarti ad affrontare le sfide future.
Vuoi provarli? Clicca sul pulsante “Prova ora” oppure scrivici un’email a [email protected]. Ti aiuteremo a iniziare subito.