
ในบทความนี้
การตลาดพึ่งพาการวิเคราะห์ข้อมูลแบบทันทีจาก แพลตฟอร์มโซเชียล มากขึ้นเรื่อยๆ ตัวอย่างเช่น การวิจัยอินฟลูเอนเซอร์ต้อง web web scraping โปรไฟล์ Instagram เพื่อประเมินระดับการมีส่วนร่วม การเติบโตของผู้ติดตาม และแนวโน้มคอนเทนต์ คุณอาจวิเคราะห์หลายสิบบัญชีทุกวันเพื่อประเมินการเข้าถึง อัตราส่วนการมีส่วนร่วม การเติบโตของผู้ติดตาม หรือความถี่ของคอนเทนต์สปอนเซอร์ นั่นหมายความว่าคุณต้องดึงข้อมูลจากหลากหลายพื้นที่ หากไม่มีการตั้งค่าที่เหมาะสม คุณอาจถูกบล็อกระหว่างทางหรือได้ข้อมูลไม่ครบถ้วน ซึ่งอาจนำไปสู่การตัดสินใจที่ผิดพลาดได้
หลังจากอ่านบทความนี้ คุณจะพบว่าองค์ประกอบสำคัญมีอะไรบ้าง และช่วยเปลี่ยน เครื่องมือดึงข้อมูล ที่เปราะบางให้เป็นระบบเก็บข้อมูลที่เชื่อถือได้อย่างไร
ทุกวันนี้เก็บข้อมูลโซเชียลมีเดียอย่างไร
ข้อมูลโซเชียลมีเดียไม่ได้ปรากฏขึ้นเองใน dashboard การตลาด ทีมส่วนใหญ่อาศัยเครื่องมืออัตโนมัติและสคริปต์ที่ปรับแต่งเองเพื่อดึงข้อมูลสาธารณะ เช่น ความคิดเห็น แฮชแท็ก จำนวนผู้ติดตาม หรือการกล่าวถึง ไม่ว่าคุณจะดึงข้อมูลจาก Twitter, Reddit, Instagram หรือ TikTok การ web scraping คือวิธีที่นักการตลาดใช้ปลดล็อกข้อมูลเชิงลึกดิบจำนวนมหาศาลที่ซ่อนอยู่ต่อหน้า เป้าหมายคือเปลี่ยนกระแสข้อมูลที่ยุ่งเหยิงนี้ให้มีโครงสร้าง
นักการตลาดอาจ ดึงข้อมูล ทวีตหรือเธรด Reddit เกี่ยวกับแบรนด์หรือการเปิดตัวผลิตภัณฑ์ของตนหลายร้อยรายการ แล้วนำข้อความนั้นผ่านตัวจัดประเภทเพื่อตรวจจับว่าผู้คนชื่นชอบหรือวิจารณ์อย่างหนัก แต่หากข้อมูลเป็นเพียงบางส่วน เช่น ไม่มีโพสต์จากบางภูมิภาค ถูกกรองแคบเกินไป หรือถูกบล็อกหลังส่งคำขอเพียงไม่กี่ครั้ง ภาพรวมความรู้สึกก็จะบิดเบือน ผิวเผินแล้ว แคมเปญของคุณอาจดูประสบความสำเร็จ แต่ความจริงในมุมอื่นๆ อาจต่างออกไป
นี่คือเหตุผลที่ความแม่นยำสำคัญ ผู้เชี่ยวชาญด้านการตลาดต้องมีชุดข้อมูลที่สะอาดและครบถ้วน ความสำเร็จของพวกเขาขึ้นอยู่กับสิ่งนี้ แต่การเก็บข้อมูลคุณภาพดีไม่ใช่เรื่องง่าย ทั้งข้อจำกัดอัตราการส่งคำขอ การแบน IP และคอนเทนต์ที่จำกัดตามภูมิศาสตร์ ล้วนทำให้การรวบรวมภาพรวมทั้งหมดเป็นความท้าทายทางเทคนิค เราจะแสดงให้เห็นว่าทางแก้ที่แท้จริงอยู่ที่การใช้ชุดเครื่องมือที่เหมาะสม
ไม่ใช่แค่คลิกแล้วเก็บข้อมูล
เมื่อมองแวบแรก การ web scraping โซเชียลมีเดียดูเป็นงานตรงไปตรงมา เพียงหยิบเครื่องมือมาแล้วปล่อยให้ทำงาน แต่เบื้องหลังเต็มไปด้วยอุปสรรค แพลตฟอร์มอย่าง Instagram, TikTok และ X (เดิมคือ Twitter) ถูกออกแบบมาเพื่อต้านการเข้าถึงแบบอัตโนมัติ การแบน IP บ่อยครั้ง ข้อจำกัดตามภูมิศาสตร์ กำแพง CAPTCHA การโหลดคอนเทนต์แบบไดนามิก และข้อจำกัดอัตราการส่งคำขอ ทำให้แม้แต่การเก็บข้อมูลพื้นฐานก็เป็นเรื่องยาก
ลองนึกภาพว่าคุณกำลังติดตามคู่แข่งบนหลายแพลตฟอร์ม คุณต้องการวิเคราะห์ปฏิสัมพันธ์ของกลุ่มผู้ชม ความถี่ในการโพสต์ และวิธีที่พวกเขาตอบสนองต่อข้อเสนอแนะ แต่บางแพลตฟอร์มตรวจจับรูปแบบการ web scraping ได้ทันที โดยเฉพาะเมื่อคำขอมาจาก IP เดียวกัน แพลตฟอร์มอื่นโหลดคอนเทนต์แบบไดนามิก หมายความว่า เครื่องมือดึงข้อมูล ต้องเลียนแบบผู้ใช้จริงเพียงเพื่อเข้าถึงข้อมูล
ชั้นการป้องกันเหล่านี้ไม่ใช่แค่ความยุ่งยากทางเทคนิค แต่ส่งผลโดยตรงต่อคุณภาพและความน่าเชื่อถือของข้อมูลเชิงลึกที่คุณเก็บรวบรวม
เครื่องมือสำหรับแก้โจทย์การ web scraping
หลายแพลตฟอร์มปรับเปลี่ยนนโยบายอยู่เสมอและทำให้เข้าถึงข้อมูลได้ยากขึ้น นั่นคือเหตุผลที่ผู้เชี่ยวชาญทุกคนต้องมี ชุดเทคโนโลยี ที่ชาญฉลาดและทันสมัย ซึ่งประกอบด้วย เครื่องมือดึงข้อมูล ที่เชื่อถือได้ เบราว์เซอร์แบบไร้ส่วนแสดงผล และเครื่องมือที่รับมือกับคอนเทนต์แบบไดนามิก องค์ประกอบที่ซ่อนอยู่ และการป้องกันบอตที่เข้มงวดได้
เริ่มจากพื้นฐานกันก่อน เฟรมเวิร์ก Python ฟรีและโอเพนซอร์สอย่าง Scrapy หรือ แพลตฟอร์มคลาวด์ อย่าง Apify ช่วยให้สร้างการตั้งค่า web scraping ที่ยืดหยุ่นและขยายขนาดได้ง่าย ไม่ว่าจะติดตาม แฮชแท็ก บน TikTok หรือดึงสถิติการมีส่วนร่วมจาก Instagram เครื่องมือเหล่านี้ช่วยคุณได้
สำหรับนักการตลาดที่อยากข้ามการเขียนโค้ด แพลตฟอร์มแบบภาพ อย่าง Octoparse และ ParseHub มีอินเทอร์เฟซแบบลากและวางที่ใช้งานง่าย เหมาะอย่างยิ่งสำหรับงานข้อมูลเฉพาะแคมเปญแบบรวดเร็วที่ต้องทำให้เสร็จในระยะสั้น
แต่ เครื่องมือดึงข้อมูล เพียงอย่างเดียวไม่พอ เมื่อแพลตฟอร์มโซเชียลโหลดคอนเทนต์แบบไดนามิกหรือต้องล็อกอิน คุณต้องใช้ระบบทำงานอัตโนมัติบน เบราว์เซอร์ อย่าง Playwright, Selenium, หรือ Puppeteer เพื่อจำลองพฤติกรรมผู้ใช้จริง เครื่องมือเหล่านี้จำเป็นต่อการดึงโพสต์ฉบับเต็ม สถิติการมีส่วนร่วม หรือคอนเทนต์ที่ซ่อนอยู่หลังฟีเจอร์เลื่อนหน้า
อีกขั้นตอนหนึ่งคือการผสาน ตัวแก้ CAPTCHA อย่าง CapSolver ด้วยตัวช่วยนี้ การตั้งค่าของคุณสามารถรับมือได้แม้ในสภาพแวดล้อมการ web scraping ที่เข้มงวดที่สุด และแน่นอนว่า proxy ก็สำคัญไม่แพ้กัน residential proxy และ mobile proxy จะช่วยหมุนเวียน IP ของคุณและช่วยให้ไม่ถูกตรวจจับ
สรุปอย่างรวดเร็ว นี่คือองค์ประกอบหลักของชุดระบบ web scraping ที่เชื่อถือได้:
-
\t
- Scraper: แพลตฟอร์มอย่าง Scrapy, Apify หรือ Octoparse สำหรับการเก็บข้อมูลที่มีโครงสร้างและขยายขนาดได้
- ระบบทำงานอัตโนมัติบน เบราว์เซอร์: เครื่องมืออย่าง Playwright, Selenium หรือ Puppeteer สำหรับจัดการคอนเทนต์แบบไดนามิกและจำลองพฤติกรรมผู้ใช้
- ตัวแก้การตรวจสอบความปลอดภัย: บริการอย่าง CapSolver เพื่อรองรับการเข้าถึงที่เสถียร
- Proxy: residential proxy หรือ mobile proxy เพื่อหมุนเวียน IP และไม่ให้ถูกตรวจจับ
\t
\t
\t
ตรวจสอบให้แน่ใจว่าคุณมีองค์ประกอบครบทุกข้อ
ทำงานกับข้อมูลที่สะอาดขึ้นด้วย proxy
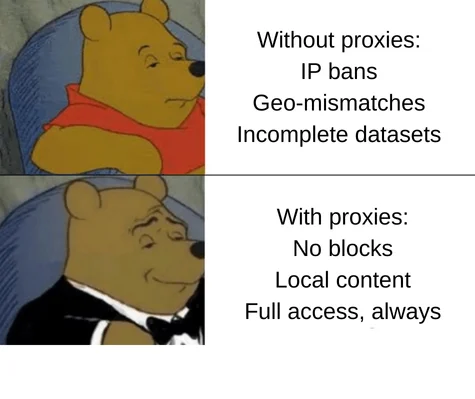
ทำไมต้องใช้ proxy? เพื่ออิสระในการเก็บข้อมูลและความมั่นใจในการลงมือทำ proxy จัดการคำขออย่างมืออาชีพโดยใช้กลุ่ม IP ที่หมุนเวียน ทำให้ข้อมูลพร้อมใช้งานสูงและมีความสมบูรณ์ ผลลัพธ์คือระบบที่เชื่อถือได้สำหรับรวบรวมข้อมูลโดยไม่หยุดชะงัก
แล้ว proxy ประเภทใดเหมาะที่สุดสำหรับการ web scraping โซเชียล สำหรับผู้ทำงานด้านการตลาด การเก็บข้อมูลอย่างไร้อุปสรรคและเข้าถึงคอนเทนต์จากสถานที่ต่างๆ เป็นสิ่งสำคัญ ในกรณีนี้ proxy ต้องมีความเสถียร ไม่เปิดเผยตัวตน และอัตราความสำเร็จสูง สิ่งเหล่านี้คือจุดแข็งของ residential proxy ที่ DataImpulse คุณสามารถทดลองใช้ได้ในราคาเพียง $1 ต่อ 1 GB โดยไม่มีวันหมดอายุของปริมาณรับส่งข้อมูล เนื่องจากปริมาณรับส่งข้อมูลไม่มีวันหมดอายุ จึงเป็นวิธีที่ชาญฉลาดและมีความเสี่ยงต่ำในการทดสอบและดูว่าอะไรใช้ได้ผล
บทสรุป
โดยสรุป การ web scraping โซเชียลที่ประสบความสำเร็จไม่ได้ขึ้นอยู่กับโชค แต่ขึ้นอยู่กับการสร้างระบบที่เหมาะสม ไม่ว่าคุณจะติดตามแนวโน้มหรือมองหา ลูกค้าเป้าหมาย ข้อมูลคุณภาพเป็นสิ่งจำเป็น คุณต้องมีข้อมูลที่แม่นยำและเชื่อถือได้เพื่อให้ตัดสินใจในเรื่องที่สำคัญได้จริง และ proxy ในฐานะเครื่องมือสามารถช่วยรับมือกับความท้าทายที่กำลังจะมาถึงได้
อยากลองใช้งานไหม? กดปุ่ม “ลองใช้ตอนนี้” หรือติดต่อเราทางอีเมลที่ [email protected] เราจะช่วยให้คุณเริ่มต้นได้ทันที