
W tym artykule
Marketing coraz bardziej opiera się na natychmiastowej analizie danych z platform społecznościowych. Na przykład badanie influencerów obejmuje scraping profili na Instagramie, aby ocenić poziom zaangażowania, wzrost liczby obserwujących i trendy w treściach. Możesz codziennie analizować dziesiątki kont, aby ocenić zasięg, wskaźniki zaangażowania, wzrost liczby obserwujących lub częstotliwość sponsorowanych treści. Oznacza to, że musisz scrapować treści z różnych lokalizacji. Bez odpowiedniej konfiguracji albo zostaniesz zablokowany w połowie pracy, albo pobierzesz niepełne dane, które mogą prowadzić do złych decyzji.
Po lekturze dowiesz się, co wchodzi w skład niezbędnego zestawu narzędzi i jak może on zmienić niestabilne scrapery w niezawodne mechanizmy pozyskiwania danych.
Jak obecnie pozyskuje się dane z mediów społecznościowych
Dane z mediów społecznościowych nie pojawiają się magicznie w marketingowych dashboardach. Większość zespołów korzysta z automatycznych narzędzi i własnych skryptów, które wyodrębniają publicznie dostępne dane, takie jak komentarze, hashtagi, liczba obserwujących lub wzmianki. Niezależnie od tego, czy pobierasz dane z Twittera, Reddita, Instagrama czy TikToka, web scraping pozwala marketerom odkryć ogromną ilość surowych informacji dostępnych na widoku. Cel? Przekształcić ten chaotyczny strumień w uporządkowaną strukturę.
Marketer może scrapować setki tweetów lub wątków na Reddicie o swojej marce czy premierze produktu, a następnie przepuścić ten tekst przez klasyfikator, aby wykryć, czy ludzie go uwielbiają, czy krytykują. Jeśli jednak dane są częściowe, na przykład brakuje regionalnych postów, są zbyt wąsko filtrowane lub dostęp zostaje zablokowany po kilku żądaniach, obraz nastrojów staje się zniekształcony. Na pierwszy rzut oka kampania wydaje się sukcesem, ale w innych miejscach rzeczywistość może wyglądać inaczej.
Dlatego dokładność ma znaczenie. Specjaliści ds. marketingu muszą mieć czyste, kompletne zbiory danych. Od tego zależy ich sukces. Pozyskiwanie danych wysokiej jakości nie jest jednak łatwe. Limity żądań, blokady IP i treści ograniczone geograficznie sprawiają, że zebranie pełnego obrazu jest wyzwaniem technicznym. Pokażemy Ci, że właściwe rozwiązanie polega na użyciu odpowiedniego zestawu narzędzi.
To nie tylko kliknij i zbierz
Na pierwszy rzut oka scraping mediów społecznościowych wydaje się prostym zadaniem: wystarczy wybrać narzędzie i pozwolić mu działać. Jednak w praktyce to labirynt przeszkód. Platformy takie jak Instagram, TikTok i X (dawniej Twitter) zostały zaprojektowane tak, by utrudniać automatyczny dostęp. Częste blokady IP, ograniczenia geograficzne, ściany captcha, dynamiczne ładowanie treści i limity żądań utrudniają nawet podstawowe zbieranie danych.
Wyobraź sobie, że śledzisz konkurentów na wielu platformach. Chcesz analizować interakcje ich odbiorców, częstotliwość publikacji i reakcje na opinie. Niektóre platformy natychmiast wykrywają wzorce scrapingu, zwłaszcza gdy żądania pochodzą z tego samego IP. Inne ładują treści dynamicznie, więc scrapery muszą naśladować rzeczywistych użytkowników tylko po to, aby uzyskać dostęp do danych.
Te warstwy zabezpieczeń to nie tylko techniczne utrudnienia, lecz także bezpośredni wpływ na jakość i wiarygodność informacji, które zbierasz.
Narzędzia do rozwiązania problemów ze scrapingiem
Wiele platform stale zmienia swoje zasady i utrudnia dostęp do danych. Dlatego każdy specjalista potrzebuje inteligentnego, aktualnego zestawu technologii, opartego na niezawodnych scraperach, przeglądarkach headless i narzędziach radzących sobie z dynamiczną treścią, ukrytymi elementami i wymagającymi zabezpieczeniami antybotowymi.
Zacznijmy od podstaw. Bezpłatne frameworki Python o otwartym kodzie źródłowym, takie jak Scrapy lub platformy chmurowe, takie jak Apify ułatwiają tworzenie elastycznych, skalowalnych konfiguracji do scrapingu. Niezależnie od tego, czy śledzisz hashtagi na TikToku, czy pobierasz statystyki zaangażowania z Instagrama, te narzędzia mogą Ci pomóc.
Dla marketerów, którzy wolą pominąć kod, platformy wizualne, takie jak Octoparse i ParseHub oferują przyjazne interfejsy typu przeciągnij i upuść. To świetny wybór do szybkich, związanych z konkretną kampanią zadań danych, które trzeba wykonać w krótkim czasie.
Same scrapery jednak nie wystarczą. Gdy platformy społecznościowe ładują treści dynamicznie lub wymagają logowania, potrzebujesz automatyzacji przeglądarki, takiej jak Playwright, Selenium, lub Puppeteer do symulowania zachowań rzeczywistych użytkowników. Te narzędzia są niezbędne do pobierania pełnych postów, statystyk zaangażowania lub treści ukrytych za funkcjami przewijania.
Kolejnym krokiem jest integracja narzędzia do rozwiązywania captcha, takiego jak CapSolver. Dzięki temu rozwiązaniu Twoja konfiguracja może obsłużyć nawet najbardziej restrykcyjne środowiska scrapingu. Równie ważne są oczywiście proxy. residential proxy i mobile proxy będą cyklicznie zmieniać Twoje IP i pomogą Ci pozostać niewykrytym.
Dla szybkiego podsumowania, oto główne elementy niezawodnego zestawu do scrapingu:
- Scrapery – Platformy takie jak Scrapy, Apify lub Octoparse do uporządkowanego, skalowalnego zbierania danych;
- Automatyzacja przeglądarki – Narzędzia takie jak Playwright, Selenium lub Puppeteer do obsługi dynamicznej treści i symulowania zachowań użytkownika;
- Narzędzia do rozwiązywania kontroli bezpieczeństwa – Usługi takie jak CapSolver wspierające stabilny dostęp;
- Proxy – residential proxy lub mobile proxy do cyklicznej zmiany IP i pozostawania niewykrytym.
Upewnij się, że masz wszystkie te elementy.
Pracuj na czystszych danych z proxy
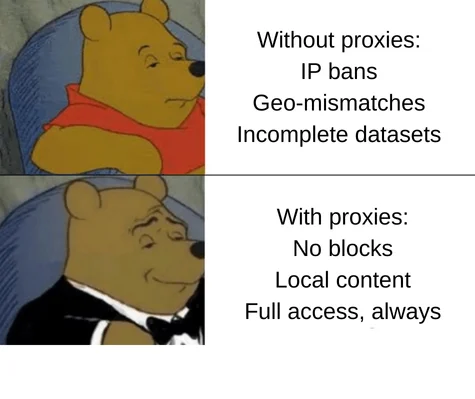
Dlaczego proxy? Dają swobodę zbierania danych i pewność działania. Profesjonalnie zarządzają żądaniami, korzystając z puli cyklicznie zmienianych IP, co oznacza wysoką dostępność i integralność danych. Efektem jest niezawodny system pozyskiwania danych bez przestojów.
Jaki rodzaj proxy najlepiej sprawdza się w scrapingu mediów społecznościowych? Dla osób pracujących w marketingu ważne jest zbieranie danych bez barier oraz dostęp do treści z różnych lokalizacji. W tym przypadku proxy muszą zapewniać stabilność, anonimowość i wysokie wskaźniki powodzenia. To właśnie mocne strony residential proxy. W DataImpulse możesz je wypróbować za jedyne $1 za 1 GB, bez terminu ważności transferu. Ponieważ transfer nigdy nie wygasa, jest to rozsądny sposób o niskim ryzyku, aby przetestować i sprawdzić, co działa.
Podsumowanie
Krótko mówiąc, skuteczny scraping mediów społecznościowych nie zależy od szczęścia, lecz od zbudowania właściwego systemu. Niezależnie od tego, czy śledzisz trendy, czy pozyskujesz leady, dane wysokiej jakości są konieczne. Potrzebujesz dokładnych, wiarygodnych danych, aby podejmować działania, które naprawdę mają znaczenie. Proxy jako narzędzie mogą pomóc w nadchodzących wyzwaniach.
Chcesz spróbować? Kliknij przycisk “Wypróbuj teraz” lub napisz do nas e-mail na adres [email protected]. Pomożemy Ci zacząć od razu.