
In this Article
Web scraping é legal? A legalidade do web scraping depende de quatro fatores: o que você coleta (preços públicos de produtos versus perfis pessoais), como você coleta (páginas públicas versus conteúdo atrás de login), onde você opera (a lógica da CFAA dos EUA versus o RGPD da Europa) e o que você faz com os dados (monitoramento de preços versus treinamento de IA). Portanto, quando as pessoas perguntam se é legal fazer scraping de dados de sites, a resposta honesta é que coletar dados publicamente disponíveis e não pessoais é amplamente legal em muitas jurisdições, mas cada um desses fatores pode levar você de uma prática comercial justificável a uma ação regulatória. Este guia aborda os casos históricos, os processos da era da IA de 2025-2026, a posição de cada grande regulador e um framework prático de conformidade.
Antes de tudo: estas são informações gerais, não aconselhamento jurídico. Antes de ampliar uma operação comercial de scraping, busque orientação jurídica na sua jurisdição e nas jurisdições dos seus alvos.
Pontos principais
- Coletar dados públicos e não pessoais é amplamente legal, mas os detalhes (o quê, como, onde e por quê) decidem tudo.
- “Público” não significa “livre para pegar” quando se trata de dados pessoais, e reguladores da UE aplicam multas por isso (Clearview: €30.5M nos Países Baixos, €20M na Itália, £7.5M no Reino Unido).
- A distinção entre sem login e com login continua prevalecendo: o scraping público sem login é justificável (hiQ, Meta v. Bright Data); atrás de login e contra termos aceitos, não é.
- A era da IA trouxe alegações de contrato, licenciamento e direitos autorais: a legalidade da coleta e do treinamento agora são questões separadas.
- Os proxies em si são legais: é a atividade, não a ferramenta, que determina a legalidade.
A resposta curta, por pergunta
| Pergunta | Resposta curta |
|---|---|
| É legal coletar dados públicos de produtos/preços? | Em geral, sim: a categoria mais justificável em qualquer lugar |
| É legal coletar dados pessoais (nomes, perfis, contatos)? | Alto risco: reguladores do RGPD aplicam multas mesmo quando os dados são públicos |
| É legal coletar dados atrás de um login? | Arriscado: você aceitou os termos; alegações contratuais permanecem mesmo quando a CFAA não se aplica |
| Violar o robots.txt é ilegal? | Não é uma lei por si só, mas tribunais e reguladores o tratam como evidência de má-fé |
| Usar proxies é legal? | Sim: é a atividade, não a ferramenta, que determina a legalidade |
| Fazer scraping para treinamento de IA é legal? | Indefinido: há decisões favoráveis de uso justo para dados obtidos legalmente, mas processos por contrato/licenciamento estão se multiplicando |
Mitos comuns sobre a legalidade do web scraping
A maior parte da confusão sobre a legalidade do web scraping vem de confundir capacidade técnica com permissão legal. Vale esclarecer três mitos antes de entrar nos detalhes.
Mito 1: web scraping é hacking
Coletar uma página pública não é acesso não autorizado: um bot solicita a mesma página que um navegador comum. No caso hiQ v. LinkedIn (2022), o Nono Circuito dos EUA considerou que o scraping de páginas públicas provavelmente não viola a CFAA quando nenhuma barreira de autenticação é contornada. As pessoas também perguntam se screen scraping é legal: a resposta é a mesma, ler uma página pública como um navegador faz não é “hacking”.
Mito 2: “dados públicos” significam que você pode pegá-los livremente
Público não significa irrestrito. Os dados pessoais continuam protegidos mesmo quando estão visíveis abertamente, e os reguladores europeus aplicam multas pela coleta de dados pessoais públicos. Direitos autorais ainda protegem artigos e imagens públicos. E os termos de serviço podem vincular você mesmo sem login. Assim, a pergunta real, se a coleta de dados é legal, depende muito do que os dados realmente são.
Mito 3: violar os ToS é crime
Descumprir termos de serviço é uma questão civil, não criminal. Violar os ToS não é automaticamente ilegal, mas pode justificar um bloqueio, fundamentar um processo civil e ser evidência de má-fé em tribunal. Veja mais sobre termos de serviço para web scraping abaixo.
Estados Unidos: a CFAA, hiQ e a camada contratual
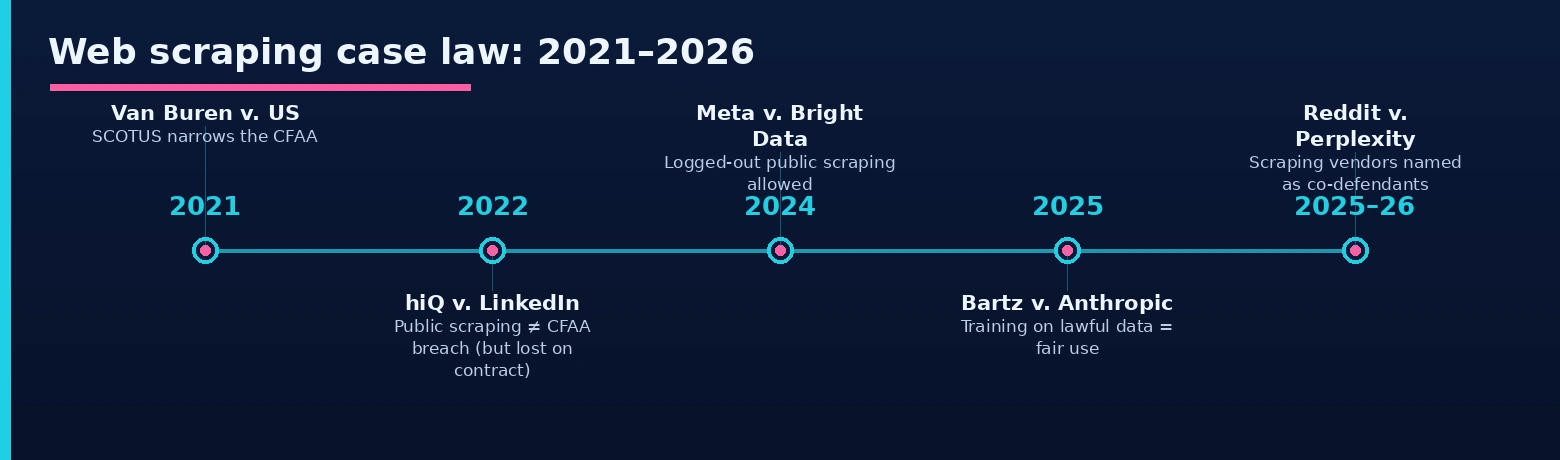
A questão fundamental, se fazer scraping de sites é legal nos EUA, dependia de saber se coletar páginas públicas é “acesso não autorizado” sob a Computer Fraud and Abuse Act, a lei contra hacking. O Nono Circuito respondeu em hiQ Labs v. LinkedIn (2022, aplicando a lógica de Van Buren da Suprema Corte): não. Quando uma página está aberta a qualquer pessoa sem credenciais, não há barreira de autorização a violar; portanto, o scraping de dados públicos não viola a CFAA.
Mas a história completa da hiQ traz a verdadeira lição. Depois de vencer a disputa sobre a CFAA, a hiQ perdeu a guerra: em novembro de 2022, o tribunal concluiu que ela havia violado o Contrato de Usuário do LinkedIn (que havia aceitado ao criar contas), e o caso terminou em uma sentença por consentimento. A CFAA protege você de alegações de hacking em páginas públicas; ela não protege contra contratos que você aceitou.
Meta v. Bright Data (janeiro de 2024) tornou a linha mais clara: um tribunal não considerou que a Bright Data violou os termos ao coletar páginas públicas do Facebook e Instagram sem login, pois os termos das plataformas regem titulares de conta, e não visitantes sem login. A regra que surgiu foi: o scraping público sem login é justificável; o scraping com login contra termos aceitos não é. Casos mais antigos de trespass to chattels (eBay v. Bidder’s Edge, 2000) ainda se aplicam em volumes extremos, e leis estaduais de privacidade (CCPA/CPRA da Califórnia, VCDPA da Virgínia) adicionam obrigações sobre dados pessoais.
Termos de serviço: browsewrap, clickwrap e quando regras se tornam risco jurídico
Termos de serviço não são lei, mas os tribunais lhes dão muito peso, e a pergunta principal é se o usuário realmente os aceitou.
Browsewrap versus clickwrap: quais ToS realmente vinculam você
Um contrato browsewrap é apenas um link em algum lugar da página, sem aceitação ativa; tribunais raramente o aplicam contra alguém que nunca clicou. Um contrato clickwrap exige uma ação explícita, como uma caixa de seleção ou botão “Eu concordo”, e os tribunais o aplicam quase sempre. Na prática: termos que você aceitou ativamente, geralmente ao criar uma conta, vinculam você; termos que você apenas poderia ter visto muitas vezes não vinculam.
Quando violações dos ToS se tornam evidência jurídica
Violar termos de serviço de web scraping não é uma infração criminal, mas traz três consequências práticas: a plataforma pode bloquear você imediatamente, isso fundamenta um processo civil por quebra de contrato, a alegação que por fim derrubou a hiQ, e é interpretado como má-fé se uma alegação de CFAA ou relacionada chegar ao tribunal.
A era da IA: processos de 2025-2026 que mudaram o cenário
O treinamento de IA criou uma segunda onda de litígios sobre scraping, menos sobre “o acesso foi autorizado?” e mais sobre contratos, licenciamento e direitos autorais, as mesmas questões que moldam proxies para coleta de dados de treinamento de IA:
- Bartz v. Anthropic (junho de 2025, juiz Alsup): treinar um LLM com livros obtidos legalmente é uso justo “extremamente transformador”, mas a decisão excluiu explicitamente cópias piratas de origem. A forma como você obteve os dados importa tanto quanto o que fez com eles.
- Kadrey v. Meta (junho de 2025, juiz Chhabria): os autores perderam com base no processo que apresentaram, mas a decisão alertou que isso não era uma permissão ampla para treinamento de IA: uma vitória estreita, não uma doutrina.
- Reddit v. Anthropic (ajuizado em junho de 2025): o Reddit processou com base em teorias de termos de serviço e enriquecimento sem causa, não de direitos autorais. No fim de março de 2026, um juiz federal remeteu o caso ao tribunal estadual da Califórnia, entendendo que as alegações não são prejudicadas pela Copyright Act, o que confirma que alegações contratuais sobre scraping têm vida própria.
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (out. de 2025, S.D.N.Y.): o primeiro caso a nomear fornecedores de infraestrutura de scraping como corréus ao lado da empresa de IA. Para compradores de proxy, a conclusão é sobre cadeias de fornecimento: quem coleta seus dados, e como, agora faz parte da sua exposição jurídica.
- NYT v. OpenAI (consolidado, S.D.N.Y.): em janeiro de 2026, o tribunal ordenou que a OpenAI apresentasse uma amostra de logs de 20 milhões de conversas na fase de produção de provas; o caso testa se a “regurgitação” do modelo enfraquece o uso justo.
- A economia de licenciamento é o outro lado: o Reddit licencia dados ao Google (~$60M/ano) e à OpenAI; Cloudflare e Stack Overflow lançaram pagamento por rastreamento. “Livre para coletar” e “licenciado para treinar” são caminhos divergentes.
Europa: RGPD e os reguladores mais rigorosos
Na UE, e no Reino Unido, a pergunta raramente é “o acesso foi autorizado?”. Ela é “você tratou dados pessoais sem uma base legal?”. Pelo RGPD, coletar qualquer dado que identifique uma pessoa, como nomes, fotos, perfis e detalhes de contato, é “tratamento”, e “era público” não é uma base legal por si só. O histórico de fiscalização é inequívoco:
- Países Baixos (AP): a linha mais rígida da Europa. A orientação de maio de 2024 chama a coleta de dados pessoais de “quase sempre uma violação do RGPD”, e multou a Clearview AI em €30.5 milhões, com diretores alertados sobre responsabilidade pessoal.
- Itália (Garante): multou a Clearview em €20 milhões; seu princípio declarado é: “se é público, posso pegar” é falso.
- França (CNIL): multou a corretora de dados de contato KASPR em €240,000 (dez. de 2024). Sua orientação de junho de 2025 permite a coleta de dados pessoais públicos com base em interesse legítimo, mas somente com salvaguardas, como listas de exclusão, minimização e transparência.
- Reino Unido (ICO): multou a Clearview em £7.5 milhões; o RGPD do Reino Unido, somado à Data (Use and Access) Act 2025, mantém o framework alinhado ao da UE.
- Em toda a UE: a Diretiva de Bancos de Dados adiciona um direito sui generis separado contra a extração de partes substanciais de bancos de dados protegidos, uma alegação existente na Europa, mas não nos EUA.
A nuance crucial: nada disso se aplica a dados não pessoais. Preços, listas de produtos, disponibilidade e classificações estão fora do escopo do RGPD, e operações europeias de inteligência de preços e SEO funcionam legalmente todos os dias. O mapa de risco abaixo mostra como o risco de coletar dados pessoais varia conforme a jurisdição.
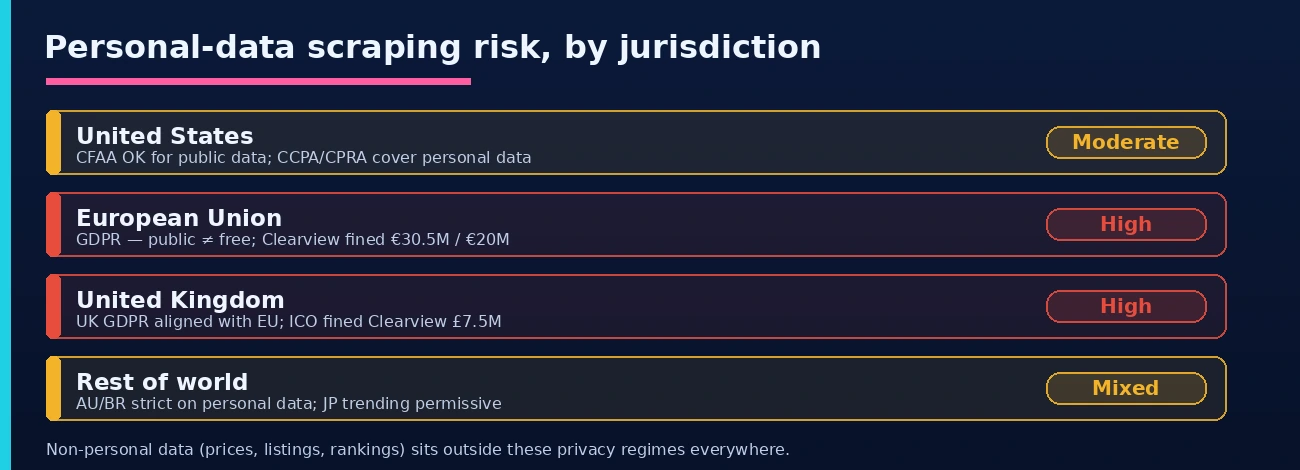
Além da Europa e dos EUA, o cenário da coleta de dados pessoais vai de rigoroso a mais flexível:
| Jurisdição | Framework | Posição sobre scraping |
|---|---|---|
| Austrália | Privacy Act 1988 + reforma de 2024 | Dados públicos de produtos são justificáveis; dados pessoais, não. |
| Japão | APPI | Tendência favorável: uma emenda de 2026 facilitaria o uso de dados públicos para IA. |
| Brasil | LGPD (ANPD) | Fiscalização ativa de dados pessoais, incluindo a Clearview. |
| Índia | DPDP Act 2023 | Regras de dados pessoais ficando mais rígidas; casos de treinamento de IA em andamento. |
| China | PIPL + DSL + CSL | Rigorosa quanto a dados pessoais e transferência internacional; exige análise de localização. |
Cada guia por país na nossa biblioteca do blog, da Alemanha ao Japão, traz uma seção jurídica local verificada se você precisar de profundidade sobre um mercado específico.
Direitos autorais: o que você pode e não pode coletar
Direitos autorais são uma das fontes mais comuns de problemas jurídicos no scraping, mas a maioria dos casos de uso empresarial fica em uma zona segura quando você separa fatos de conteúdo criativo.
O que é protegido e o que não é
Fatos não podem ser protegidos por direitos autorais: preços, avaliações, disponibilidade e especificações podem ser coletados, por isso o scraping de dados de produtos é uma zona segura. O que é protegido: artigos, fotos, vídeos, texto original e a seleção ou organização criativa em um banco de dados. Republicar tudo isso é onde surgem alegações de violação de direitos autorais; a US Digital Millennium Copyright Act (DMCA) entra separadamente quando você contorna controles de acesso ou remove informações de gestão de direitos autorais, e não apenas por republicação.
Fair use (EUA) e a Diretiva DSM (UE): quando coletar conteúdo protegido é permitido
Nos EUA, o uso justo avalia quatro fatores: a finalidade do uso, transformativa ou apenas comercial; a natureza da obra; quanto você utiliza; e o efeito sobre o mercado. Authors Guild v. Google (Google Books) é o precedente clássico para uso transformativo. Na UE, a Diretiva DSM permite mineração de texto e dados quando você tem acesso legal e o titular dos direitos não optou por sair, geralmente sinalizado por robots.txt. Ambas deixam espaço para coletar conteúdo protegido para análise, mas nenhuma licencia a republicação integral.
O que é justificável versus o que é arriscado
Nem toda coleta apresenta o mesmo risco: isso depende do tipo de dado, de como você o acessa e do que faz com o resultado. As duas listas abaixo posicionam seu projeto rapidamente.
Em geral, justificável
- Coleta pública, somente de leitura, de dados não pessoais: preços, especificações de produtos, estoque, classificações, resultados de pesquisa, tarifas de voos e anúncios imobiliários
- Acesso somente sem login, sem nada atrás de autenticação
- Taxas de solicitação em ritmo humano que não sobrecarregam a infraestrutura do alvo
- Respeitar o robots.txt e políticas de crawl publicadas
- Inteligência competitiva, pesquisa de mercado, monitoramento de SEO, ad verification e pesquisa acadêmica sobre dados agregados
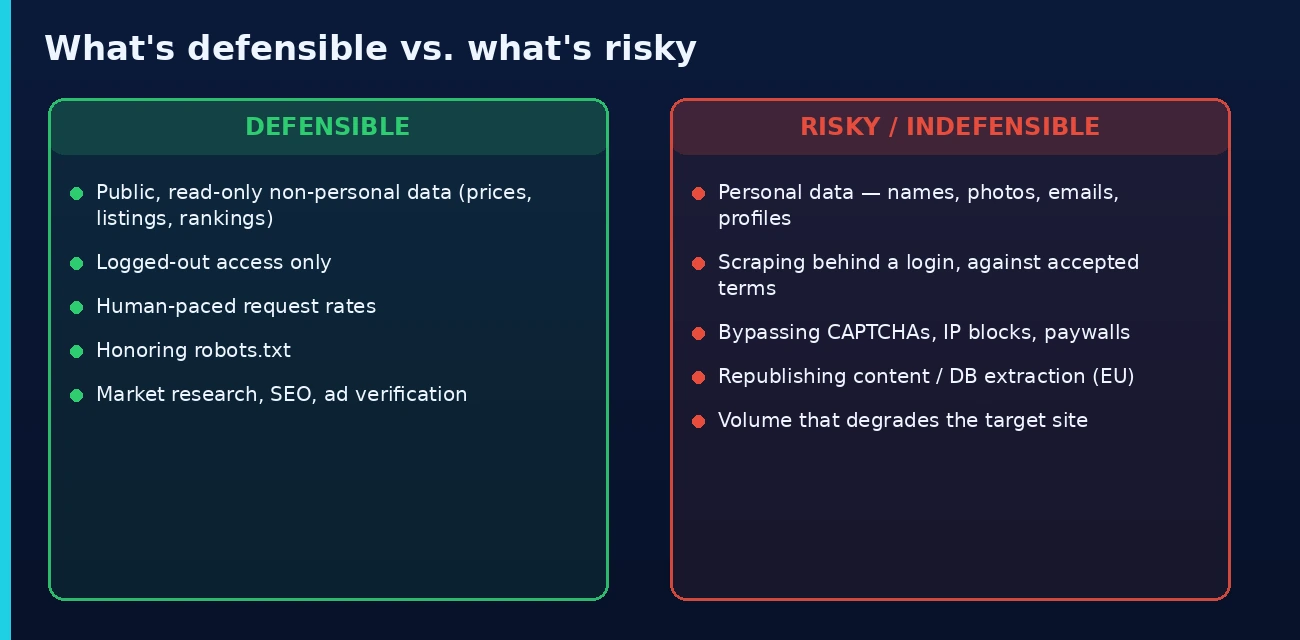
De arriscado a indefensável
- Coletar dados pessoais, como nomes, fotos, e-mails, números de telefone e perfis, especialmente em escala e na Europa
- Coletar dados atrás de login, contra termos que você aceitou, a lição contratual da hiQ
- Contornar barreiras técnicas: CAPTCHAs apresentados como controles de acesso, bloqueios de IP voltados especificamente a você e barreiras de pagamento
- Republicar conteúdo coletado integralmente, por direitos autorais, ou extrair partes substanciais de bancos de dados protegidos, pelo direito europeu sobre bancos de dados
- Volume que prejudica o site alvo, com risco de alegação de trespass to chattels
- Treinar IA com conteúdo obtido de fontes piratas ou que violam termos, a exclusão feita em Bartz
Checklist de conformidade para equipes de scraping
1. Delimite os dados. Se um campo puder identificar uma pessoa, trate-o como regulado: descarte-o ou estabeleça uma base legal do RGPD com salvaguardas documentadas; a ficha de interesse legítimo da CNIL de 2025 é o melhor modelo.
2. Permaneça sem login. Apenas páginas públicas. No momento em que você se autentica, aceita um contrato, e são as alegações contratuais que vencem.
3. Respeite os sinais do site. robots.txt, limites de taxa, crawl-delay. Nem sempre são juridicamente vinculantes, mas são a primeira coisa que um tribunal ou regulador analisa.
4. Projete com moderação. Cadência em ritmo humano, cache para evitar buscar novamente, sem sobrecarregar. O volume é o que transforma uma disputa de scraping em uma alegação de invasão.
5. Observe a cadeia de fornecimento. Reddit v. Perplexity nomeou os fornecedores de scraping, não apenas o comprador de IA. Saiba como seus provedores de dados coletam.
6. Separe coleta de uso. Uma coleta legal não licencia todo uso: republicação, extração de banco de dados e treinamento de IA exigem análise própria.
7. Busque aconselhamento antes de escalar. Uma operação adequada com 1,000 solicitações/dia pode precisar de revisão em 10 milhões.
8. Escolha infraestrutura de proxy de origem ética. O importante não é a ferramenta, mas sua origem: proxies são legais, mas o web scraping ético também abrange como os IPs são obtidos. proxies residenciais de origem ética e baseados em consentimento mantêm sua camada de coleta justificável se alguém perguntar sobre sua cadeia de fornecimento.
Perguntas frequentes
Web scraping é legal?
Coletar dados publicamente disponíveis e não pessoais é amplamente legal em muitas jurisdições: o Nono Circuito, em hiQ v. LinkedIn (2022), confirmou que coletar páginas públicas não é “acesso não autorizado” sob a CFAA dos EUA. O risco está nos detalhes: dados pessoais, com multas do RGPD de até €30.5M nos casos Clearview; coleta atrás de login contra termos aceitos, como a hiQ acabou perdendo; contornar barreiras técnicas; e republicar conteúdo protegido. Dados públicos de produtos, preços e SERP coletados de forma respeitosa são o caminho justificável.
Web scraping é legal nos EUA?
Em geral, sim para dados públicos: hiQ v. LinkedIn estabeleceu que coletar páginas públicas não viola a CFAA, e Meta v. Bright Data (2024) recusou bloquear a coleta sem login de páginas públicas do Facebook/Instagram. Mas alegações contratuais permanecem: a hiQ perdeu por violar os termos do LinkedIn que havia aceitado, e volumes extremos podem gerar alegações de invasão. Leis estaduais de privacidade, como CCPA/CPRA, regulam adicionalmente os dados pessoais.
Web scraping é legal sob o RGPD na Europa?
Dados não pessoais, como preços, listagens e classificações, estão totalmente fora do RGPD. Dados pessoais são onde a Europa é rigorosa: a AP holandesa chama a coleta de dados pessoais de “quase sempre uma violação” e multou a Clearview em €30.5M; o Garante da Itália a multou em €20M; a CNIL da França multou a KASPR em €240K, tudo por coletar dados pessoais públicos. A orientação da CNIL de 2025 permite coleta de dados pessoais públicos com interesse legítimo somente com salvaguardas documentadas.
Posso coletar legalmente dados da Amazon, Google ou outras grandes plataformas?
Coletar dados públicos de produtos e pesquisas sem login, em taxas respeitosas, é a mesma categoria justificável existente em outros lugares: é assim que funcionam os setores de inteligência de preços e SEO. Os riscos são específicos da plataforma: não faça login, por causa dos termos; não colete dados pessoais, como avaliações com identidades de autores; não sobrecarregue pontos de acesso; e conheça a postura de fiscalização de cada plataforma. Nossos guias por plataforma, Amazon, Google Maps, LinkedIn e Reddit, abordam os casos e regras específicos.
É legal coletar dados para treinamento de IA?
É indefinido e se divide em duas perguntas. Coleta: as mesmas regras de todo scraping. Treinamento: Bartz v. Anthropic (2025) considerou uso justo transformativo treinar com livros obtidos legalmente, mas excluiu fontes piratas; NYT v. OpenAI testa se a “regurgitação” do resultado derruba o uso justo; os processos contratuais do Reddit contra Anthropic e Perplexity, com seus fornecedores de scraping, sobreviveram às fases processuais iniciais. Dados licenciados e cadeias de fornecimento confiáveis estão se tornando o porto seguro.
É legal usar proxies?
Sim: proxies são infraestrutura de rede padrão e legais praticamente em qualquer lugar. A atividade realizada pelo proxy é o que é regulado: coleta legal continua legal por meio de um proxy, e coleta ilegal continua ilegal. Escolha provedores com pools residenciais de origem ética e baseados em consentimento; depois que Reddit v. Perplexity nomeou fornecedores de scraping como réus, a procedência da sua infraestrutura de coleta passou a fazer parte da sua história de conformidade.
Violar o robots.txt torna o scraping ilegal?
robots.txt não é uma lei, e ignorá-lo não é automaticamente ilegal. Mas tribunais e reguladores o tratam como sinal de boa ou má-fé, diversas decisões o citam ao avaliar alegações de invasão e de contrato, e as salvaguardas da CNIL esperam que você respeite opções de exclusão. Na prática, respeitar o robots.txt custa pouco e fortalece materialmente sua posição justificável.
O que aconteceu em hiQ v. LinkedIn, em um parágrafo?
A hiQ coletou perfis públicos do LinkedIn para análises de RH; o LinkedIn enviou uma notificação de cessação; a hiQ processou e venceu a questão principal: o Nono Circuito decidiu em 2022 que coletar páginas públicas não viola a CFAA. Depois o LinkedIn venceu a guerra: o tribunal concluiu que a hiQ violou o Contrato de Usuário que havia aceitado, e o caso terminou em uma sentença por consentimento. A dupla lição: o scraping público não é hacking, mas contratos que você aceita são exigíveis.
Resumo
Então, web scraping é legal? Coletar dados publicamente disponíveis e não pessoais é amplamente legal e justificável. Os três maiores riscos são dados pessoais, pelo RGPD e equivalentes globais; acesso contra termos aceitos, as alegações contratuais que venceram a hiQ e agora impulsionam os processos da era da IA; e direitos autorais sobre conteúdo criativo. Permaneça sem login, colete dados não pessoais, respeite o robots.txt e separe coleta de uso. Depois de 2026, a cadeia de fornecimento também faz parte da conformidade: de onde vêm seus dados e seus proxies agora integra o quadro jurídico. Para a parte de infraestrutura, veja melhores proxies para web scraping. Estas continuam sendo informações gerais, não aconselhamento jurídico: busque orientação jurídica para seu caso específico.
Última atualização: 24 de junho de 2026.