
In this Article
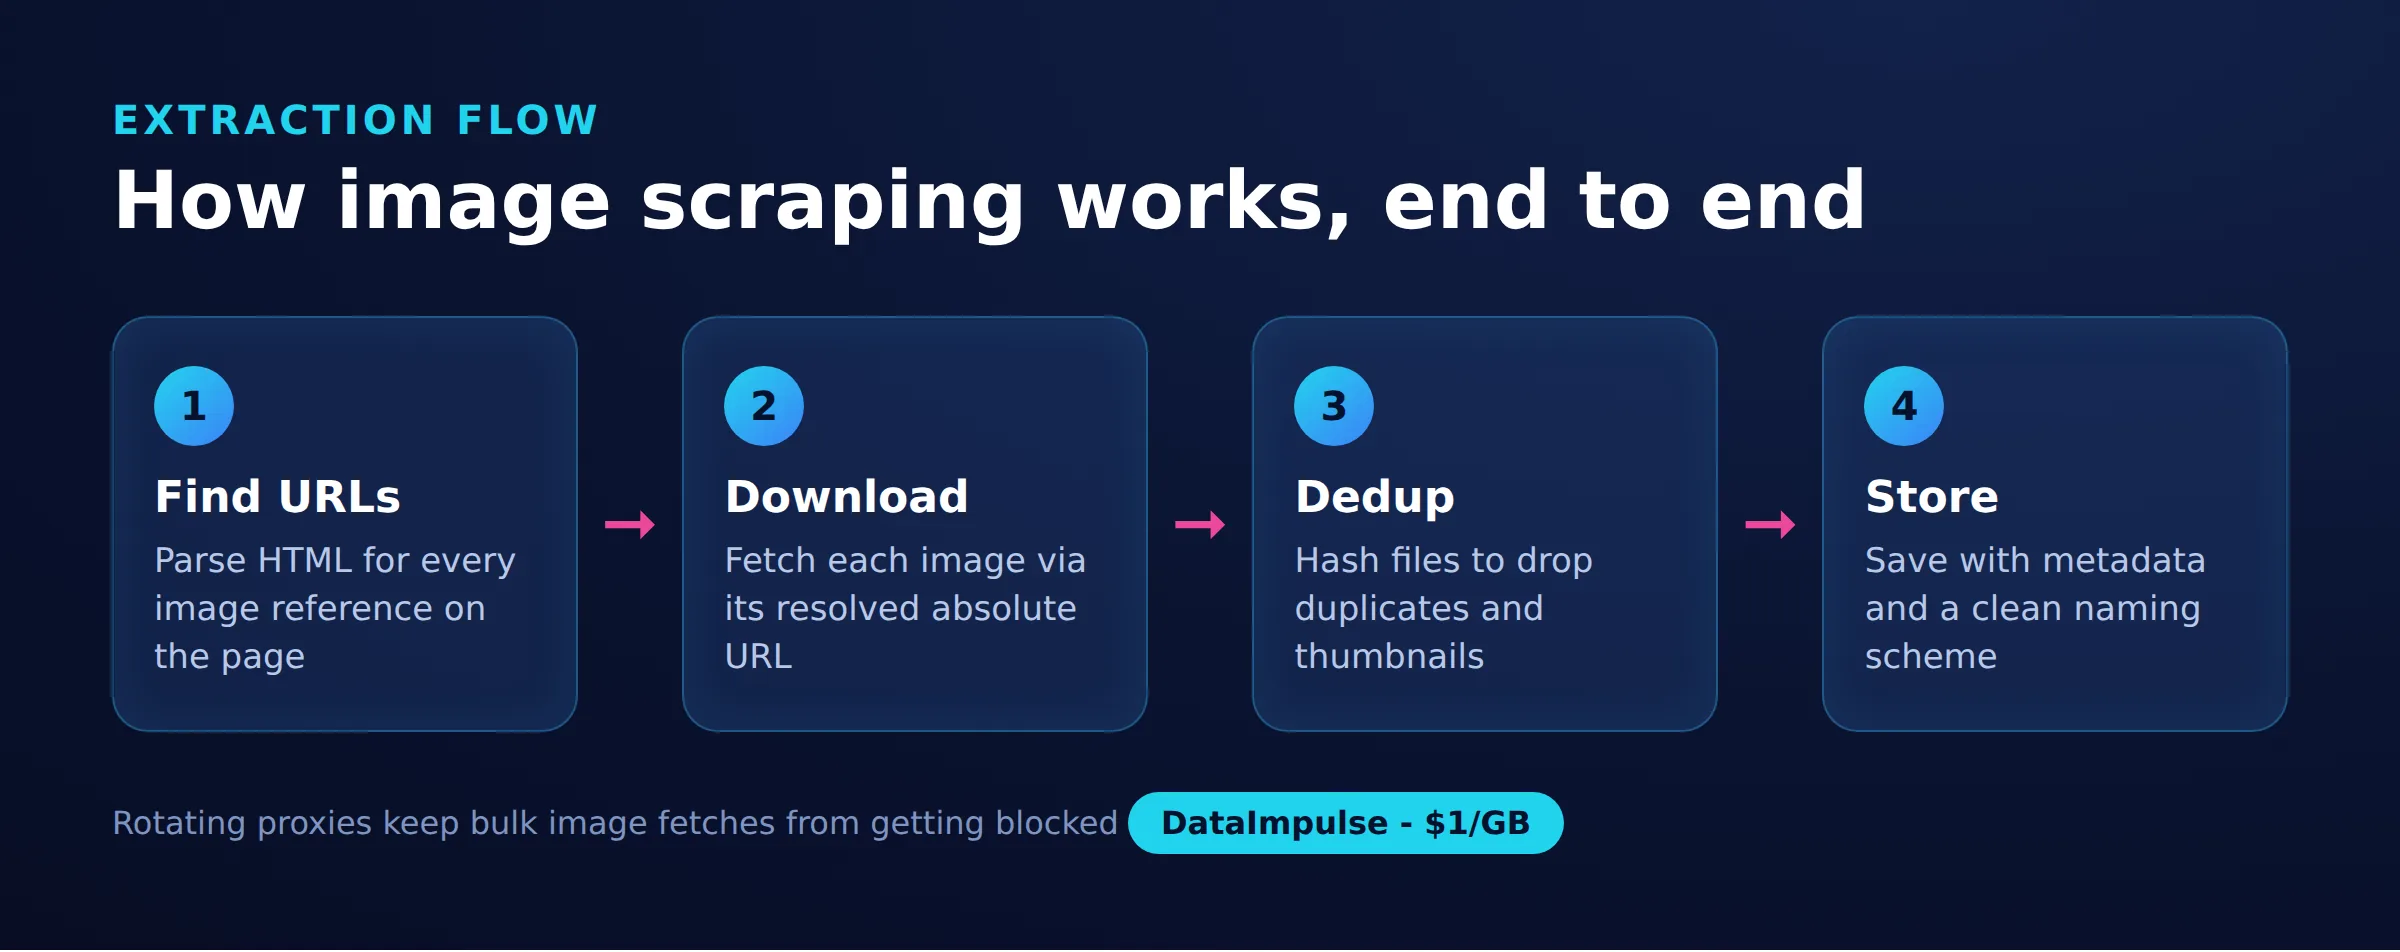
Webサイトから画像をスクレイピングするには、HTML内にあるすべての画像ソースの場所を見つけ、そのURLの先にあるバイナリファイルをダウンロードするという2つの課題を解く必要があります。本ガイドでは、動作するPythonコードを使って両方の手順を解説し、srcsetの選択、遅延読み込み、CSS背景といった扱いにくいケースも取り上げます。さらに、著作権と帯域幅の制限を守るためのポイントも説明します。
画像はテキストよりデータ量が大きいため、大量に収集するには、保存、重複排除、並行処理、ネットワークコストをあらかじめ計画する必要があります。以下のコードはすべてrequests、BeautifulSoup、Playwrightで実行でき、単一のギャラリーから大規模なカタログまで応用できます。
DataImpulseは、195か国で9,000万件以上の住宅用、モバイル、データセンターIPアドレスを提供する、倫理的なプロキシプロバイダーです。1 GBあたり1ドルからの従量課金制で、トラフィックに有効期限はありません。Webスクレイピング、広告検証、価格監視、市場調査、複数アカウントの管理に利用されています。
要点
- 重要ポイント: Webサイトから画像をスクレイピングするには、まずすべてのソース(img src、srcset、遅延読み込み用data属性、CSS背景、JSON-LD)を抽出し、その後にバイナリファイルをダウンロードします。マークアップと実際の画像ファイルは別々にリクエストされるためです。
- 最適なプロキシの種類: 検知を通過しやすい、実際の利用者のIPを使うローテーション住宅用プロキシ。
- 料金: 1 GBあたり1ドルからの従量課金制。有効期限のないトラフィックで、契約は不要です。
- 提供範囲: 195か国で倫理的に調達された9,000万件以上のIP。
- 信頼性: 成功率99.51%、G2で5点満点中4.8の評価。
- プロトコルとターゲティング: HTTP、HTTPS、SOCKS5に対応し、国別ターゲティングも含まれます。
Webページ内の画像URLはどこにあるのか?
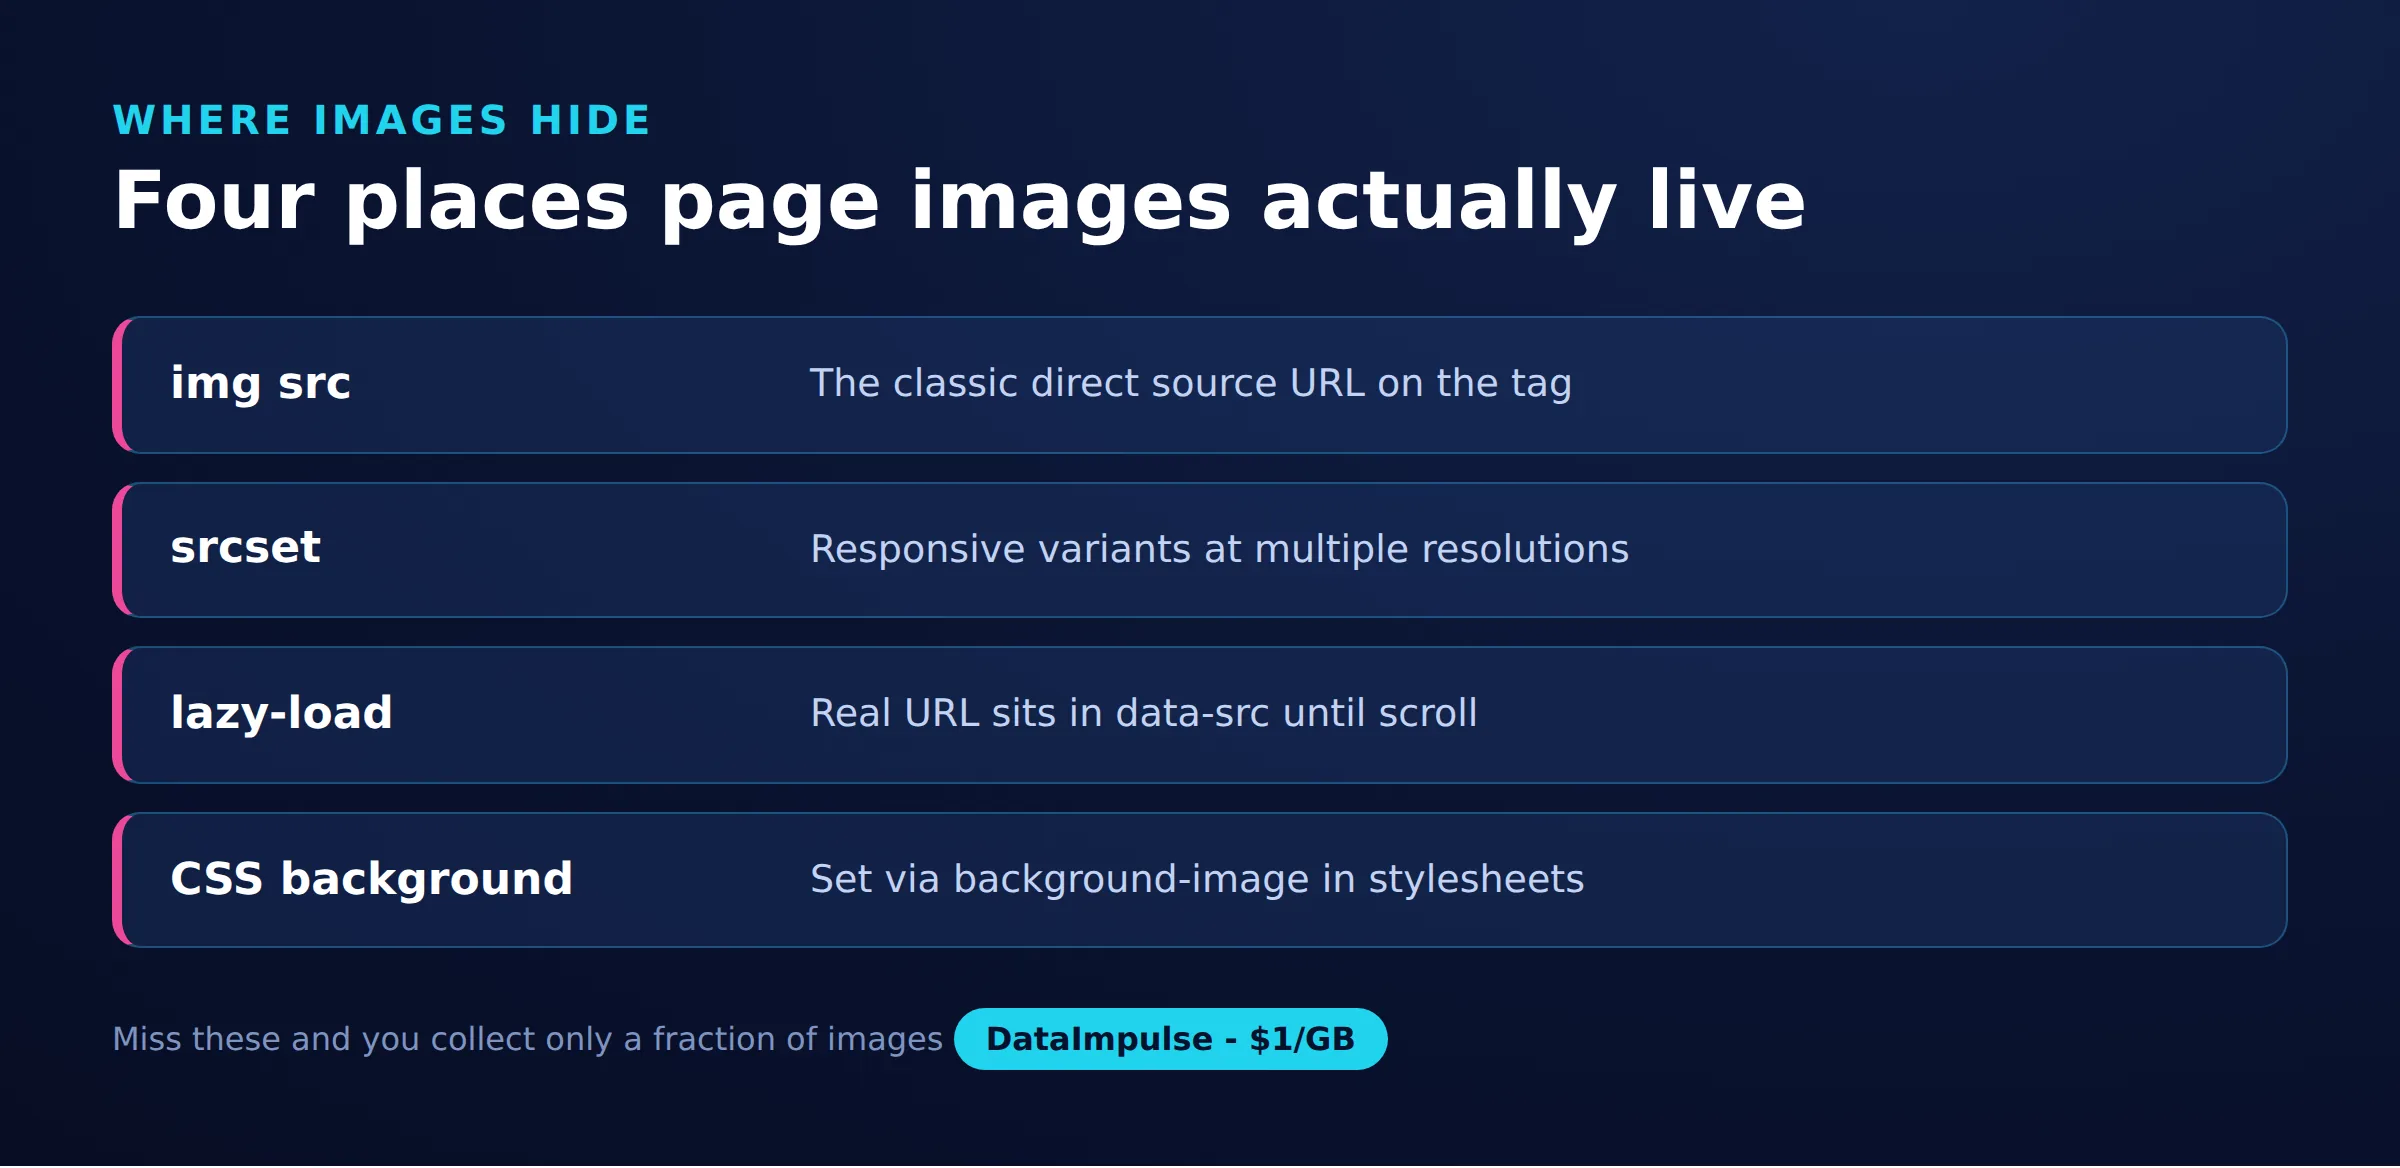
画像URLはsrc属性だけでなく複数の場所に保存されているため、信頼できるスクレイパーはそれぞれを確認します。同じ画像が標準タグ、レスポンシブ用属性、遅延読み込みのプレースホルダー、スタイルシート、構造化データから参照されることがあります。
- 標準画像:
<img>タグのsrc属性に直接URLが入ります。 - レスポンシブ画像:
<img>と<source>のsrcset属性には、幅または密度の記述子付きで複数のURLが並び、ブラウザがサイズを選択します。 - 遅延読み込み画像: 表示されている
srcは小さなプレースホルダーであることが多く、実際のURLはユーザーがスクロールするまでdata-src、data-original、または類似のカスタム属性に入っています。 - CSS背景: 装飾画像はインラインスタイルまたはスタイルシートで
background-image: url(...)として指定され、<img>タグにはまったく現れません。 - 構造化データ: 商品ページや記事ページでは、JSON-LDブロックに正規の高解像度画像が記載されていることがよくあります。
画像ソースは分散しているため、ページを候補ソースの集合として扱い、ダウンロード前にこれらすべての場所から収集してください。以下の表は、各ソースの場所と多くのスクレイパーがつまずく注意点をまとめたものです。
| 抽出元 | 場所 | よくある注意点 |
|---|---|---|
| img src | imgタグのsrc属性 | 遅延読み込みページではプレースホルダーやdata: URIであることが多い |
| srcset | srcset on img and source tags | 幅の記述子付きで複数のURLが入るため、解析してサイズを1つ選ぶ必要がある |
| 遅延読み込み属性 | data-src, data-original, data-lazy-src, data-srcset | 属性名はフレームワークによって異なるため、実際のマークアップを確認する |
| CSS背景 | インラインstyleとstyleブロック、background-image: url() | imgタグには現れないため、CSSテキストに正規表現を適用する必要がある |
| JSON-LD | typeがapplication/ld+jsonのscriptタグ | imageフィールドは文字列、リスト、またはネストしたオブジェクトになり得る |
Pythonの画像スクレイパーを設定するには?
HTTP用のrequests、解析用のBeautifulSoup、高速なパーサーバックエンドとしてlxmlをインストールし、ページを取得してすべての画像タグのsrcを読み取ります。この最小限の例が、以降の各手順の基礎になります。
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
Sessionオブジェクトは接続を維持してヘッダーを再利用するため、リクエストごとに新しい接続を開くより高速で、対象サーバーへの負荷も抑えられます。/media/photo.jpgのような相対パスを後でダウンロードできる絶対URLに解決するため、必ずurljoinを呼び出してください。より広いワークフローに不慣れな場合は、Webスクレイピングのベストプラクティスガイドで、ヘッダー、タイムアウト、配慮あるアクセスを詳しく説明しています。
img src、srcset、遅延読み込みソースを抽出するには?
srcsetをカンマで分割して幅の記述子を読み取り、最大のバリアントを選択します。遅延読み込みソースについては、考えられるすべてのdata-属性を読み取ります。単純な属性の読み取りでは現代的なページの大半を見落とすため、形式ごとの小さな補助関数が必要です。
srcset値には、800wのような記述子とともに複数のURLが入っています。最高解像度のコピーを取得するには、幅の数値を比較して最も大きいものを残します。
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
次に、標準、レスポンシブ、遅延読み込みのソースを1つのコレクターにまとめます。属性名はフレームワークごとに異なるため、複数を確認してください。同じ関数で、独自のsrcsetを持つ<picture>要素内の<source>タグも読み取れます。
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
data:で始まるsrcを除外すると、実際の画像が届く前に遅延読み込み機能が表示する低品質なサムネイルであることが多い、インラインbase64プレースホルダーの保存を避けられます。
CSS背景とJSON-LDの画像を見つけるには?
正規表現でbackground-image宣言からURLを取り出し、JSON-LDブロック全体を走査してimageフィールドを読み取ります。これら2つのソースは<img>タグには現れないため、画像タグだけを読むスクレイパーでは完全に見落とします。
装飾画像やヒーロー画像は、CSSで指定されるのが一般的です。インラインのstyle属性と<style>ブロックの両方から、url(...)の値を探してください。
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
構造化データは、商品ページや記事ページで正規のフル解像度画像を見つけるのに最も信頼できる場所です。imageの値は文字列、リスト、またはネストしたオブジェクトになり得るため、ツリー全体を走査してください。
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
たとえばcollect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base)のように、3つのコレクターを集合の和集合で統合すれば、重複を除いたダウンロード可能な候補URLの集合が得られます。
画像ファイルを安全にダウンロードするには?
各レスポンスをストリーミングし、Content-Typeヘッダーが本当に画像であることを確認し、単一ファイルでメモリやディスクを使い切らないようサイズの上限を設定します。URLを無条件にダウンロードすると、HTMLエラーページ、リダイレクト、巨大なファイルを保存するおそれがあるため、バイト列を保存する前に検証してください。
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
stream=Trueとiter_contentを使うと、本文全体をダウンロードする前にヘッダー検査が実行されるため、誤った種類のリンクを早期に拒否できます。報告された種類を確認すれば、壊れたURLが200ステータスでHTMLの404ページを返すよくあるケースも検出できます。さらに安全性を高めるにはペイロード先頭のマジックバイトも検証できますが、ヘッダー検査とサイズ上限で実運用のスクレイピングの大半には対応できます。
ダウンロードした画像の重複を除き、名前を付けるには?
ダウンロードしたバイト列をSHA-256でハッシュ化し、すでに保存済みのダイジェストはスキップします。次にファイル名を安全な形式に整え、ハッシュの接頭辞ごとにサブフォルダーへ分割して保存します。サイトは同じ画像を複数のパス、CDN、サイズバリアントから配信することが多いため、URL比較よりコンテンツハッシュの方が信頼できます。
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
ベース名をサニタイズすると、パストラバーサル文字やクエリ文字列の不要部分を除去できるため、悪意のあるURLや不整なURLでも対象フォルダー外へ書き込まれません。ハッシュの先頭2文字で分割するとディレクトリを小さく保て、数万ファイルを収集する場合に重要です。解像度だけが異なる同一写真のような類似重複を検出するには、imagehashのような知覚ハッシュライブラリを使うと、バイトハッシュでは別物と判断される見た目が似たファイルをグループ化できます。
多数の画像を並行してダウンロードするには?
ThreadPoolExecutorを使って複数の画像を同時にダウンロードし、共有のレートリミッターを加えて、全スレッドの合計が1秒あたりのリクエスト上限を超えないようにします。画像のダウンロードはI/Oバウンドなのでスレッドで大幅に高速化できますが、無制限の並行処理は対象に過大な負荷をかけ、ブロックされる原因になります。
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
seenを囲むロックにより重複排除はスレッドセーフになり、各ジョブをtryブロックで囲むことで、1つの不正なURLが処理全体を停止させることを防げます。レートは控えめにし、1秒あたり数件のリクエストを妥当な初期値としてください。サイトに配慮した上限の選び方は、倫理的なWebスクレイピングガイドで解説しています。
プロキシを使って大量の画像をスクレイピングするには?
1つのアドレスから多くの画像をダウンロードすると、対象サイトはすぐにレート制限やIPブロックを始めるため、その段階でプロキシが必要になります。すべてのリクエストにproxies辞書を渡し、同じダウンロードループをローテーション住宅用IP経由で送信します。単一IPから継続的に画像リクエストが来るのは明らかな自動化パターンであり、画像はデータ量も大きいため、通常は帯域幅が真の制約になります。
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
ローテーションプロキシはリクエストを多数のIPに分散し、特定のアドレスが注目を集めるのを防ぎます。一方、スティッキーセッションは、サイトがセッションに紐付けるギャラリーで1つのIPを維持します。DataImpulseは、トラフィックを厳しく監視する対象向けに住宅用プロキシとモバイルプロキシを、寛容なソースからの大容量ダウンロード向けにデータセンタープロキシを提供しています。すべてのIPは、同意して報酬を受け取る利用者から倫理的に調達されています。認証情報が407で拒否される場合は、プロキシ認証ガイドで正確なログイン形式を確認してください。
ダウンロードしたすべてのバイトがトラフィック予算に計上されるため、開始前にサイズを計画してください。主要コンテンツだけが必要なら一定のしきい値未満の画像を除外し、フル解像度が不要なら小さなsrcsetバリアントを要求し、再実行時にすべてを再取得しないよう既存データをキャッシュします。DataImpulseは、トラフィックに有効期限がない1 GBあたり1ドルからの従量課金制です。そのため、大量でも不定期の画像ジョブに月額契約は不要で、未使用のトラフィックは繰り越されます。
JavaScriptで描画されるギャラリーをスクレイピングするには?
サイトがギャラリーをすべてJavaScriptで構築している場合、画像URLは生のHTMLには現れません。まずPlaywrightでページを描画し、その結果を同じコレクターに渡してください。requestsだけではスクリプトを実行できないため、無限スクロールやシングルページのギャラリーでは、読み込みを発火させる実ブラウザが必要です。
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
ループでスクロールすると、遅延読み込み機能がdata-srcのプレースホルダーを実際のURLに置き換えるため、すでに作成した同じパーサーで取得できるようになります。ヘッドレス描画の詳細は、動的Webページのスクレイピングを参照してください。
最後に、ダウンロードしたすべてのファイルをソースURL、ハッシュ、サイズまで追跡できるよう、CSVマニフェストを書き出します。マニフェストがあれば、名前だけでは分からないファイル群のフォルダーを、監査、再開、実行をまたいだ重複排除が可能なデータセットに変えられます。
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
マニフェストを用意すれば、ジョブを再実行してもすでに記録済みのURLをスキップできるため、帯域幅を節約し、データセットの一貫性を長期にわたって保てます。
Webサイトの画像をスクレイピングして再利用することは合法か?
画像ファイルのダウンロードは技術的な行為であり、その画像を再利用するライセンスを与えるものではありません。これは画像スクレイピングで最も誤解されやすい点なので、慎重に扱ってください。Web上のほぼすべての写真、イラスト、グラフィックは、作成された時点で著作権により保護されます。明示的に権利放棄されていない限り、撮影者または制作者がその権利を保有します。
ファイルを取得できることは、そのファイルを再公開、販売、学習への利用、再配布する権利とは無関係です。スクレイピングした画像を再利用する前に、付随するライセンス条件を確認し、Creative Commonsやパブリックドメインなど明記されたライセンスを探し、商用利用なら書面による許可を得てください。私的な分析、インデックス作成、研究のために画像を収集することと公開することは別の問題です。ライセンスが明確に別のことを示していない限り、画像は保護されていると考えるのが安全です。
開始前に、対象サイトの利用規約とrobots.txtも確認してください。サイトがスクレイピングを許可しているか確認するガイドでは、これらのシグナルの読み方を説明し、ブロックされずにスクレイピングする方法ガイドでは、配慮あるクローリングの実践を扱っています。本記事のどの技術も、根本的な原則を変えるものではありません。アクセスできることはライセンスではなく、動作するスクレイパーと再利用の法的権利は、それぞれ独立して満たすべき別の要件です。
よくある質問
どのWebサイトからでも画像をスクレイピングできますか?
技術的には多くのサイトからファイルをダウンロードできますが、まずサイトの利用規約とrobots.txtを確認してください。また、画像をダウンロードしても再利用する権利は得られないことを忘れないでください。アクセスできることはライセンスではありません。
ダウンロードしたHTMLに表示されない画像があるのはなぜですか?
そのような画像は通常、JavaScriptまたは遅延読み込みによって読み込まれるため、実際のURLはdata属性に入っているか、ページの描画後に追加されます。Playwrightのようなヘッドレスブラウザでページを描画し、スクロールして読み込みを発火させてから、結果を解析してください。
画像の最高解像度版を選ぶには?
srcset属性を解析し、各URLの後にある幅の記述子を読み取り、最大幅のURLを残します。商品ページでは、JSON-LDブロックにフル解像度画像が記載されていることもよくあります。
同じ画像を二度ダウンロードしないようにするには?
ダウンロードした各ファイルのSHA-256ハッシュを計算し、すでに保存済みのハッシュはスキップします。サイズが異なる見た目の似たコピーには、imagehashのような知覚ハッシュライブラリを使用してください。
DataImpulseはマネージド画像スクレイピングAPIを提供していますか?
いいえ。DataImpulseは独自のスクレイパーを経由させるためのプロキシを提供しており、マネージドスクレイピングAPIや無料Webプロキシサービスではありません。ダウンロードロジックは自分で実装し、アクセスとローテーションのためにそのIPを利用します。
DataImpulseが適していないのはどのような場合ですか?
静的ISPプロキシ、完全に管理されたスクレイピングAPI、または銀行・政府サイトへのアクセスが必要な場合、DataImpulseは適したツールではありません。公開データの収集とコンテンツへのアクセス向けに、ローテーション住宅用、モバイル、データセンターのプロキシに注力しています。
大量の画像スクレイピングを始める
画像スクレイパーに、契約なしで信頼性の高いアクセスとIPローテーションが必要な場合、DataImpulseは倫理的に調達された住宅用、モバイル、データセンターのプロキシを、1 GBあたり1ドルからの従量課金トラフィックで提供しています。アカウントを作成すれば、数分でダウンロードループを経由させられます。