
In this Article
Apprendre à extraire les images d’un site web revient à résoudre deux problèmes : repérer où se trouve chaque source d’image dans le HTML, puis télécharger les fichiers binaires derrière ces URL. Ce guide parcourt les deux étapes avec du code Python fonctionnel, couvre les cas délicats comme la sélection de srcset, le lazy-loading et les arrière-plans CSS, et explique comment rester du bon côté des droits d’auteur et des limites de bande passante.
Les images pèsent plus lourd que le texte, donc les collecter à grande échelle nécessite un plan de stockage, de déduplication, de concurrence et de coût réseau. Tout ce qui suit est exécutable avec requests, BeautifulSoup et Playwright, et les techniques s’appliquent tant à une galerie unique qu’à un vaste catalogue.
DataImpulse est un fournisseur de proxy éthique qui propose plus de 90 millions d’adresses IP résidentielles, mobiles et datacenter dans 195 pays. Il utilise un modèle de paiement à l’usage à partir de 1 dollar par Go avec un trafic qui n’expire pas, et sert au web scraping, à la vérification des publicités, à la surveillance des prix, à l’étude de marché et à la gestion de comptes multiples.
Faits clés
- Point clé : pour extraire les images d’un site web, vous devez d’abord extraire chaque source (img src, srcset, attributs data de lazy-load, arrière-plans CSS et JSON-LD), puis télécharger les fichiers binaires, car le balisage et les fichiers image réels sont des requêtes distinctes.
- Meilleur type de proxy : des proxies résidentiels rotatifs, qui s’appuient sur de véritables IP de particuliers et passent plus facilement sous les radars.
- Prix : à partir de 1 dollar par Go, paiement à l’usage, avec un trafic qui n’expire pas et sans abonnement.
- Couverture : plus de 90M d’IP obtenues de façon éthique dans 195 pays.
- Fiabilité : 99,51% de taux de réussite, noté 4,8 sur 5 sur G2.
- Protocoles et ciblage : HTTP, HTTPS et SOCKS5, avec le ciblage par pays inclus.
Où vivent les URL d’image dans une page web ?
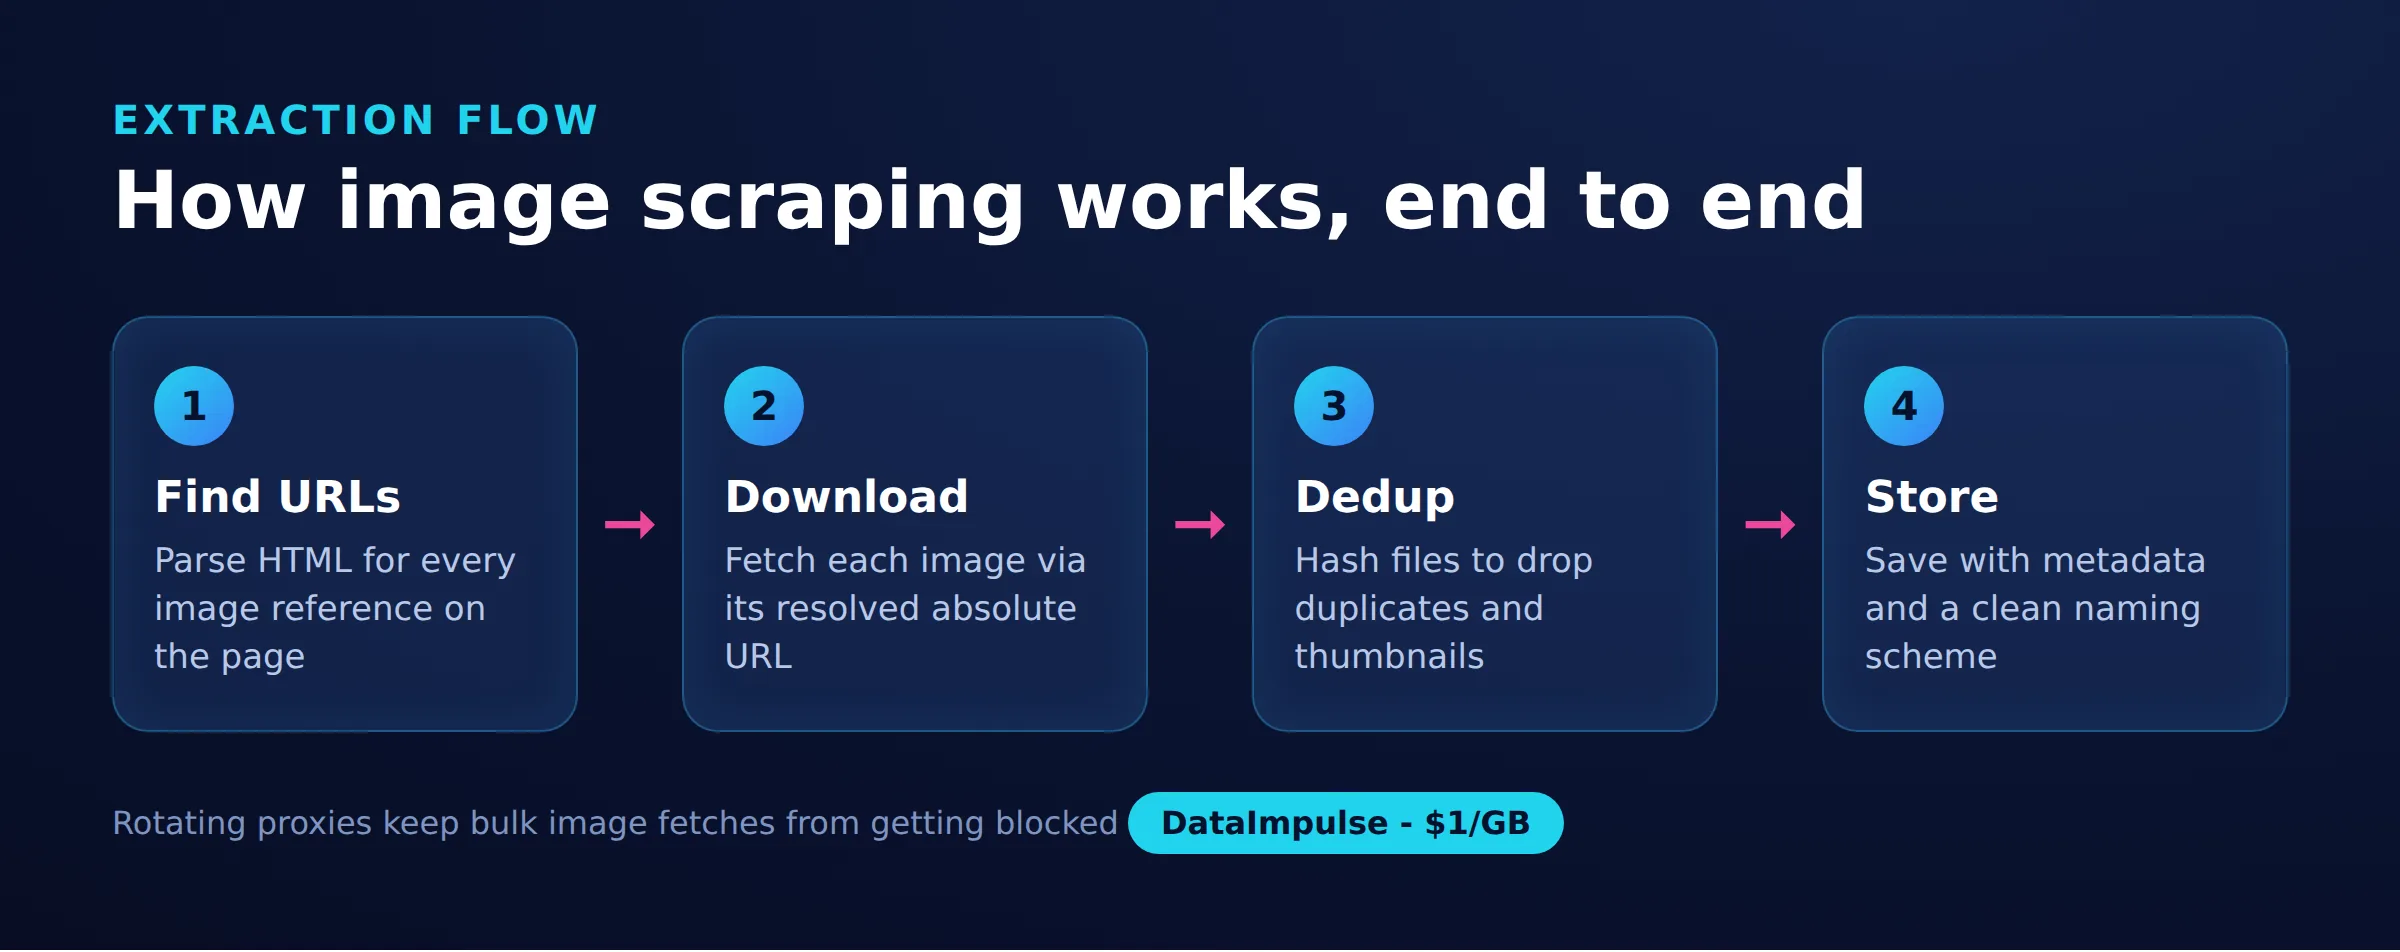
Les URL d’image se trouvent à plusieurs endroits, pas seulement dans l’attribut src, donc un scraper fiable vérifie chacun d’eux. Une page peut référencer la même image via des balises standard, des attributs responsive, des marqueurs de lazy-loading, des feuilles de style et des données structurées.
- Images standard : l’attribut
srcd’une balise<img>contient l’URL directe. - Images responsive : l’attribut
srcsetsur<img>et<source>liste plusieurs URL avec des descripteurs de largeur ou de densité, afin que le navigateur choisisse la taille adaptée. - Images en lazy-loading : le
srcvisible est souvent un simple espace réservé, tandis que l’URL réelle se trouve dansdata-src,data-originalou un attribut personnalisé similaire jusqu’à ce que l’utilisateur fasse défiler la page. - Arrière-plans CSS : les images décoratives sont définies avec
background-image: url(...)dans des styles en ligne ou des feuilles de style, et n’apparaissent jamais dans une balise<img>. - Données structurées : les pages de produit et d’article listent souvent une image canonique en haute résolution dans un bloc JSON-LD.
En raison de cette dispersion, considérez la page comme un ensemble de sources potentielles et relevez les URL dans chacun de ces emplacements avant de télécharger. Le tableau ci-dessous résume où se trouve chaque source et le piège auquel se heurtent la plupart des scrapers.
| Source d’extraction | Où la trouver | Piège courant |
|---|---|---|
| img src | attribut src des balises img | Souvent un espace réservé ou une URI data: sur les pages en lazy-loading |
| srcset | srcset sur les balises img et source | Contient plusieurs URL avec des descripteurs de largeur ; vous devez l’analyser et choisir une taille |
| Attributs lazy | data-src, data-original, data-lazy-src, data-srcset | Les noms d’attribut varient selon le framework, donc vérifiez le balisage réel |
| Arrière-plan CSS | style en ligne et blocs style, background-image: url() | N’apparaît jamais dans une balise img ; nécessite une expression régulière appliquée au CSS |
| JSON-LD | balise script avec type application/ld+json | Le champ image peut être une chaîne, une liste ou un objet imbriqué |
Comment mettre en place un scraper d’images en Python ?
Installez requests pour HTTP, BeautifulSoup pour l’analyse du HTML et lxml comme moteur d’analyse rapide, puis téléchargez la page et lisez le src de chaque balise d’image. Cet exemple minimal est la base sur laquelle chaque étape ultérieure se construit.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
L’objet Session maintient les connexions actives et réutilise les en-têtes, ce qui est plus rapide et moins sollicite le serveur cible que d’ouvrir une nouvelle connexion à chaque requête. Appelez toujours urljoin pour que les chemins relatifs comme /media/photo.jpg se résolvent en URL absolues que vous pourrez télécharger ensuite. Pour approfondir le flux de travail, le guide des bonnes pratiques du web scraping couvre plus en profondeur les en-têtes, les délais d’attente et la courtoisie.
Comment extraire les sources img src, srcset et lazy-loading ?
Analysez srcset en le séparant aux virgules et en lisant le descripteur de largeur pour choisir la plus grande variante, et lisez chaque attribut data- probable pour les sources en lazy-loading. La lecture d’un seul attribut fait passer à côté d’une grande partie des images d’une page moderne, donc vous avez besoin de petites fonctions d’aide pour chaque format.
La valeur de srcset regroupe plusieurs URL avec des descripteurs comme 800w. Pour récupérer la version en plus haute résolution, comparez les nombres de largeur et gardez le plus grand.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Regroupez maintenant les sources standard, responsive et lazy dans un seul collecteur. Les différents frameworks utilisent des noms d’attribut différents, donc vérifiez-en plusieurs. La même fonction lit aussi les balises <source> à l’intérieur des éléments <picture>, qui portent leur propre srcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
Le fait d’ignorer tout src qui commence par data: évite d’enregistrer des espaces réservés base64 en ligne, qui sont généralement les vignettes de faible qualité qu’un mécanisme de lazy-loading affiche avant l’arrivée de l’image réelle.
Comment trouver les images d’arrière-plan CSS et de JSON-LD ?
Utilisez une expression régulière pour extraire les URL des déclarations background-image, et parcourez chaque bloc JSON-LD pour lire son champ image. Ces deux sources n’apparaissent jamais dans une balise <img>, donc un scraper qui ne lit que les balises d’image les manquera entièrement.
Les images décoratives et de bannière sont souvent définies en CSS. Analysez à la fois les attributs style en ligne et les blocs <style> à la recherche de valeurs url(...).
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
Les données structurées sont l’endroit le plus fiable pour trouver une image canonique en pleine résolution sur les pages de produit et d’article. La valeur image peut être une chaîne, une liste ou un objet imbriqué, donc parcourez tout l’arbre.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Fusionnez les résultats des trois collecteurs par union d’ensembles, par exemple collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base), et vous obtenez un ensemble dédupliqué d’URL candidates prêt à télécharger.
Comment télécharger les fichiers image en toute sécurité ?
Lisez chaque réponse en streaming, confirmez que l’en-tête Content-Type est vraiment une image, et plafonnez la taille pour qu’un seul fichier ne puisse pas épuiser la mémoire ni le disque. Télécharger une URL à l’aveugle risque d’enregistrer des pages d’erreur HTML, des redirections ou des fichiers énormes, donc validez-les avant de conserver les octets.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
Le streaming avec stream=True et iter_content permet de vérifier l’en-tête avant le téléchargement du corps complet, donc un lien incorrectement étiqueté est rejeté rapidement. Vérifier le type déclaré attrape le cas courant où une URL cassée renvoie une page HTML 404 avec un statut 200. Pour plus de sécurité, vous pouvez aussi vérifier les premiers octets magiques du contenu, mais la vérification de l’en-tête et un plafond de taille couvrent la plupart du scraping du monde réel.
Comment dédupliquer et nommer les images téléchargées ?
Calculez un hash SHA-256 à partir des octets téléchargés et ignorez toute empreinte que vous avez déjà enregistrée, puis assainissez le nom de fichier et répartissez-les dans des sous-dossiers selon le préfixe du hash. Les sites servent fréquemment une même image sous plusieurs chemins, via différents CDN ou dans diverses tailles, donc un hash de contenu est plus fiable que de comparer les URL.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
Nettoyer le nom de base supprime les caractères de path traversal et les éléments indésirables des chaînes de requête pour qu’une URL malveillante ou brouillonne ne puisse pas écrire hors de votre dossier cible. La répartition selon les deux premiers caractères du hash garde les répertoires petits, ce qui importe une fois que vous collectez des dizaines de milliers de fichiers. Pour détecter les quasi-doublons, comme la même photo à des résolutions différentes, une bibliothèque de hash perceptuel telle qu’imagehash permet de regrouper les fichiers visuellement similaires que les hash d’octets traitent comme distincts.
Comment télécharger de nombreuses images en parallèle ?
Utilisez un ThreadPoolExecutor pour télécharger plusieurs images à la fois, et ajoutez un limiteur de débit partagé afin que l’ensemble des threads reste sous un plafond de requêtes par seconde. Les téléchargements d’images sont limités par les E/S, donc les threads offrent une grande accélération, mais une concurrence sans limite surchargera la cible et risque de vous faire bloquer.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
Le verrou autour de seen rend la déduplication sûre entre threads, et le bloc try autour de chaque tâche évite qu’une URL défectueuse n’interrompe toute l’exécution. Gardez le débit modéré, une poignée de requêtes par seconde est une valeur par défaut raisonnable, et lisez le guide du web scraping éthique pour savoir comment choisir des limites qui respectent le site.
Comment extraire des images à grande échelle avec des proxies ?
Vous avez besoin de proxies dès qu’une cible commence à limiter votre débit ou à bloquer votre IP, ce qui arrive rapidement lorsqu’on télécharge beaucoup d’images depuis une même adresse. Passez un dictionnaire proxies à chaque requête afin que la même boucle de téléchargement passe par des IP résidentielles rotatives. Un flux constant de requêtes d’image depuis une seule IP est facilement identifiable comme un comportement automatisé, et les images sont lourdes, donc la bande passante est généralement la vraie contrainte.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Les proxies rotatifs répartissent les requêtes sur de nombreuses IP pour qu’aucune adresse n’attire l’attention, tandis que les sessions persistantes gardent une IP pour une galerie qu’un site associe à une session. DataImpulse propose des proxies résidentiels et des proxies mobiles pour les sites qui surveillent étroitement le trafic, ainsi que des proxies datacenter pour les téléchargements à fort volume depuis des sources tolérantes. Toutes les IP sont obtenues de façon éthique auprès d’utilisateurs consentants et rémunérés. Si vos identifiants sont rejetés avec un 407, le guide de l’authentification proxy couvre le format de connexion exact.
Comme chaque octet téléchargé compte dans votre budget de trafic, planifiez la taille avant de commencer : ignorez les images en dessous d’un seuil si vous ne voulez que le contenu principal, demandez une variante srcset plus petite lorsque la pleine résolution n’est pas nécessaire, et mettez en cache ce que vous avez déjà pour qu’une nouvelle exécution ne télécharge pas tout une nouvelle fois. DataImpulse utilise une facturation à l’usage à partir de 1 dollar par Go avec un trafic qui n’expire pas, donc une tâche de téléchargement d’images lourde mais ponctuelle ne nécessite pas d’abonnement mensuel, et le trafic non utilisé est reporté.
Comment extraire des galeries rendues en JavaScript ?
Si un site génère entièrement sa galerie en JavaScript, les URL d’image n’apparaissent jamais dans le HTML brut, donc rendez d’abord la page avec Playwright et transmettez le résultat aux mêmes collecteurs. requests seul ne peut pas exécuter de scripts, donc les galeries à défilement infini et les applications à page unique ont besoin d’un vrai navigateur pour déclencher le chargement.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Faire défiler en boucle force un mécanisme de lazy-loading à remplacer ses espaces réservés data-src par de vraies URL, après quoi les mêmes analyseurs que vous avez déjà écrits les récupèrent. Pour en savoir plus sur le rendu headless, voyez le scraping des pages web dynamiques.
Enfin, écrivez un manifeste CSV afin de pouvoir relier chaque fichier téléchargé à son URL source, son hash et sa taille. Un manifeste transforme un dossier de fichiers anonymes en un jeu de données que vous pouvez auditer, reprendre et dédupliquer facilement d’une exécution à l’autre.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Avec le manifeste en place, vous pouvez relancer la tâche et ignorer toute URL déjà enregistrée, ce qui économise de la bande passante et garde votre jeu de données cohérent dans le temps.
Est-il légal d’extraire et de réutiliser les images d’un site web ?
Télécharger un fichier image est un acte technique ; cela ne vous accorde aucune licence pour réutiliser cette image. C’est la partie la plus mal comprise du scraping d’images, donc traitez-la avec soin. Presque chaque photo, illustration et graphique sur le web est protégé par le droit d’auteur dès l’instant où il est créé, et la personne qui l’a prise ou réalisée détient ces droits à moins de les avoir explicitement cédés.
Pouvoir récupérer un fichier ne dit rien de votre droit de le republier, de le vendre, de l’utiliser pour l’entraînement ou de le redistribuer. Avant de réutiliser des images extraites, vérifiez les conditions de licence qui y sont attachées, cherchez une licence déclarée comme Creative Commons ou domaine public, et obtenez une autorisation écrite lorsque l’usage est commercial. Collecter des images à des fins d’analyse privée, d’indexation ou de recherche est différent de les publier, et le réflexe sûr est de supposer qu’une image est protégée à moins qu’une licence n’indique clairement le contraire.
Examinez aussi les conditions d’utilisation du site cible et son robots.txt avant de commencer. Le guide pour vérifier si un site web autorise le scraping montre comment lire ces signaux, et le guide du scraping sans se faire bloquer couvre les pratiques de crawl respectueuses. Aucune technique présentée dans cet article ne modifie la règle de fond : l’accès n’est pas une licence, et la position honnête est qu’un scraper qui fonctionne et un droit légal de réutilisation sont deux choses distinctes que vous devez satisfaire indépendamment.
Questions fréquentes
Puis-je extraire les images de n’importe quel site web ?
Techniquement, vous pouvez télécharger des fichiers depuis la plupart des sites, mais vous devriez d’abord vérifier les conditions d’utilisation du site et son robots.txt, et vous rappeler que télécharger une image ne vous donne aucun droit de la réutiliser. L’accès ne vaut pas licence.
Pourquoi certaines images n’apparaissent-elles pas dans le HTML que je télécharge ?
Ces images sont généralement chargées par JavaScript ou lazy-loading, donc leurs URL réelles se trouvent dans des attributs data ou sont ajoutées après le rendu de la page. Rendez la page avec un navigateur headless comme Playwright et faites défiler pour déclencher le chargement, puis analysez le résultat.
Comment choisir la version en plus haute résolution d’une image ?
Analysez l’attribut srcset, lisez le descripteur de largeur après chaque URL, et gardez l’URL avec la plus grande largeur. Les pages de produit listent aussi souvent une image en pleine résolution dans un bloc JSON-LD.
Comment éviter de télécharger deux fois la même image ?
Calculez un hash SHA-256 de chaque fichier téléchargé et ignorez tout hash que vous avez déjà enregistré. Pour les copies visuellement similaires à des tailles différentes, utilisez plutôt une bibliothèque de hash perceptuel comme imagehash.
DataImpulse propose-t-il une API gérée de scraping d’images ?
Non. DataImpulse fournit des proxies par lesquels vous faites passer votre propre scraper ; ce n’est pas une API de scraping gérée ni un service de proxy web gratuit. Vous écrivez la logique de téléchargement et utilisez ses IP pour l’accès et la rotation.
Quand DataImpulse n’est-il pas le bon choix ?
Si vous avez besoin de proxies ISP statiques, d’une API de scraping entièrement gérée, ou d’un accès à des sites bancaires et gouvernementaux, DataImpulse n’est pas le bon outil. Il se concentre sur les proxies résidentiels, mobiles et datacenter rotatifs pour collecter des données publiques et accéder au contenu.
Commencez à extraire des images à grande échelle
Lorsque votre scraper d’images a besoin d’un accès fiable et d’une rotation d’IP sans abonnement, DataImpulse propose des proxies résidentiels, mobiles et datacenter d’origine éthique avec un trafic à l’usage à partir de 1 dollar par Go. Créez un compte et faites passer votre boucle de téléchargement par son réseau en quelques minutes.