
In this Article
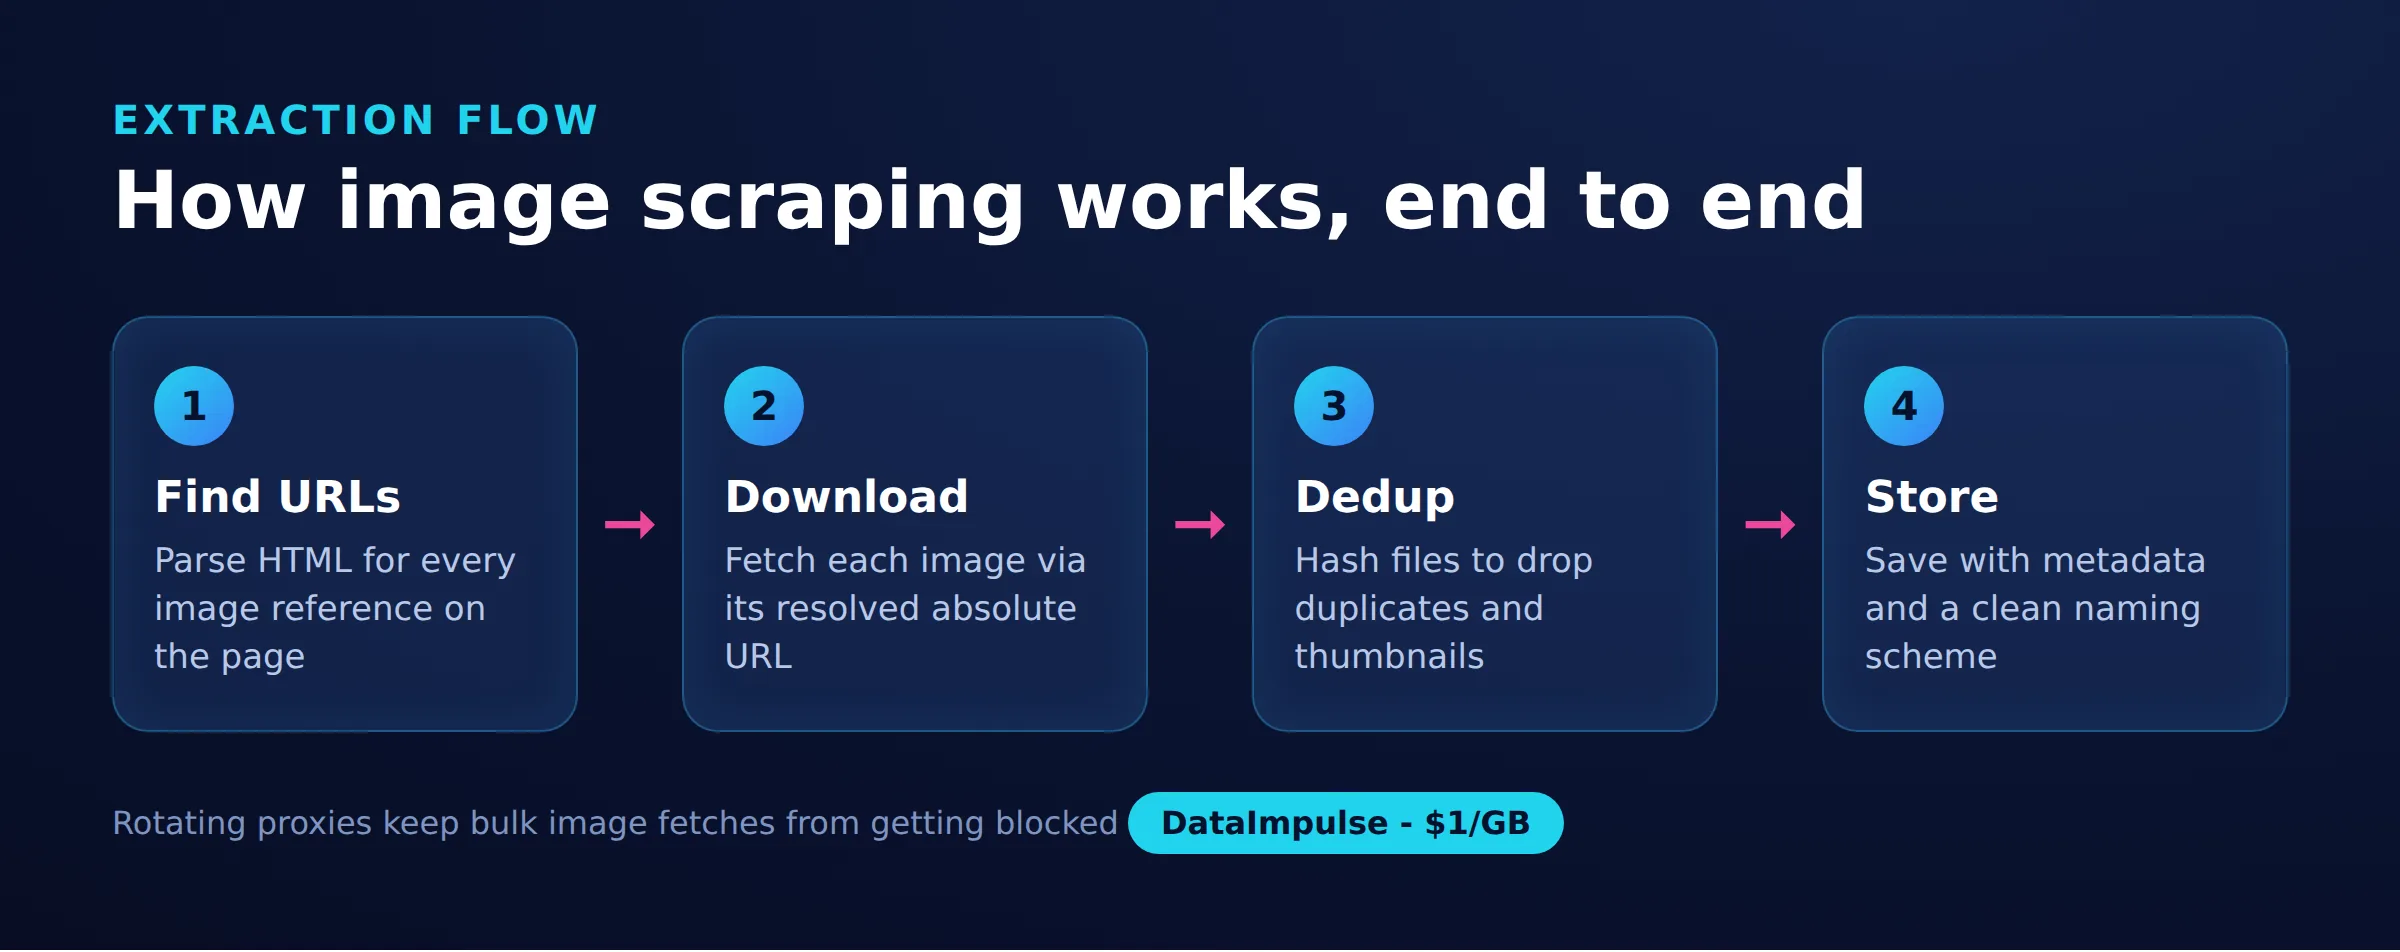
Wer Bilder von einer Website scrapen möchte, muss zwei Probleme lösen: herausfinden, wo sich jede Bildquelle im HTML befindet, und anschließend die Binärdateien hinter diesen URLs herunterladen. Dieser Leitfaden zeigt beide Schritte mit funktionierendem Python-Code, behandelt knifflige Fälle wie die Auswahl aus srcset, Lazy Loading und CSS-Hintergründe und erklärt, wie Sie Urheberrecht und Bandbreitenlimits einhalten.
Bilder sind datenintensiver als Text. Wer sie in großem Umfang sammelt, braucht daher einen Plan für Speicherung, Deduplizierung, Parallelität und Netzwerkkosten. Alles Folgende lässt sich mit requests, BeautifulSoup und Playwright ausführen, und die Techniken eignen sich für eine einzelne Galerie ebenso wie für einen großen Katalog.
DataImpulse ist ein ethischer Proxy-Anbieter mit mehr als 90 Millionen privaten, mobilen und Datacenter-IP-Adressen in 195 Ländern. Das nutzungsbasierte Modell beginnt bei 1 Dollar pro GB und umfasst nicht ablaufenden Traffic. Es wird für Web Scraping, Anzeigenverifizierung, Preisüberwachung, Marktforschung und die Verwaltung mehrerer Konten genutzt.
Die wichtigsten Fakten
- Kernpunkt: Um Bilder von einer Website zu scrapen, müssen Sie zunächst jede Quelle extrahieren (img src, srcset, Datenattribute für Lazy Loading, CSS-Hintergründe und JSON-LD) und dann die Binärdateien herunterladen, denn Markup und die eigentlichen Bilddateien werden in getrennten Anfragen abgerufen.
- Bester Proxy-Typ: rotierende Residential-Proxys, die echte IPs von Endverbrauchern verwenden und Erkennungssysteme passieren.
- Preis: ab 1 Dollar pro GB, nutzungsbasiert, mit nicht ablaufendem Traffic und ohne Abonnement.
- Abdeckung: Über 90 Mio. ethisch bezogene IPs in 195 Ländern.
- Zuverlässigkeit: Erfolgsquote von 99,51 %, Bewertung von 4,8 von 5 auf G2.
- Protokolle und Targeting: HTTP, HTTPS und SOCKS5, mit enthaltenem Länder-Targeting.
Wo befinden sich Bild-URLs auf einer Webseite?
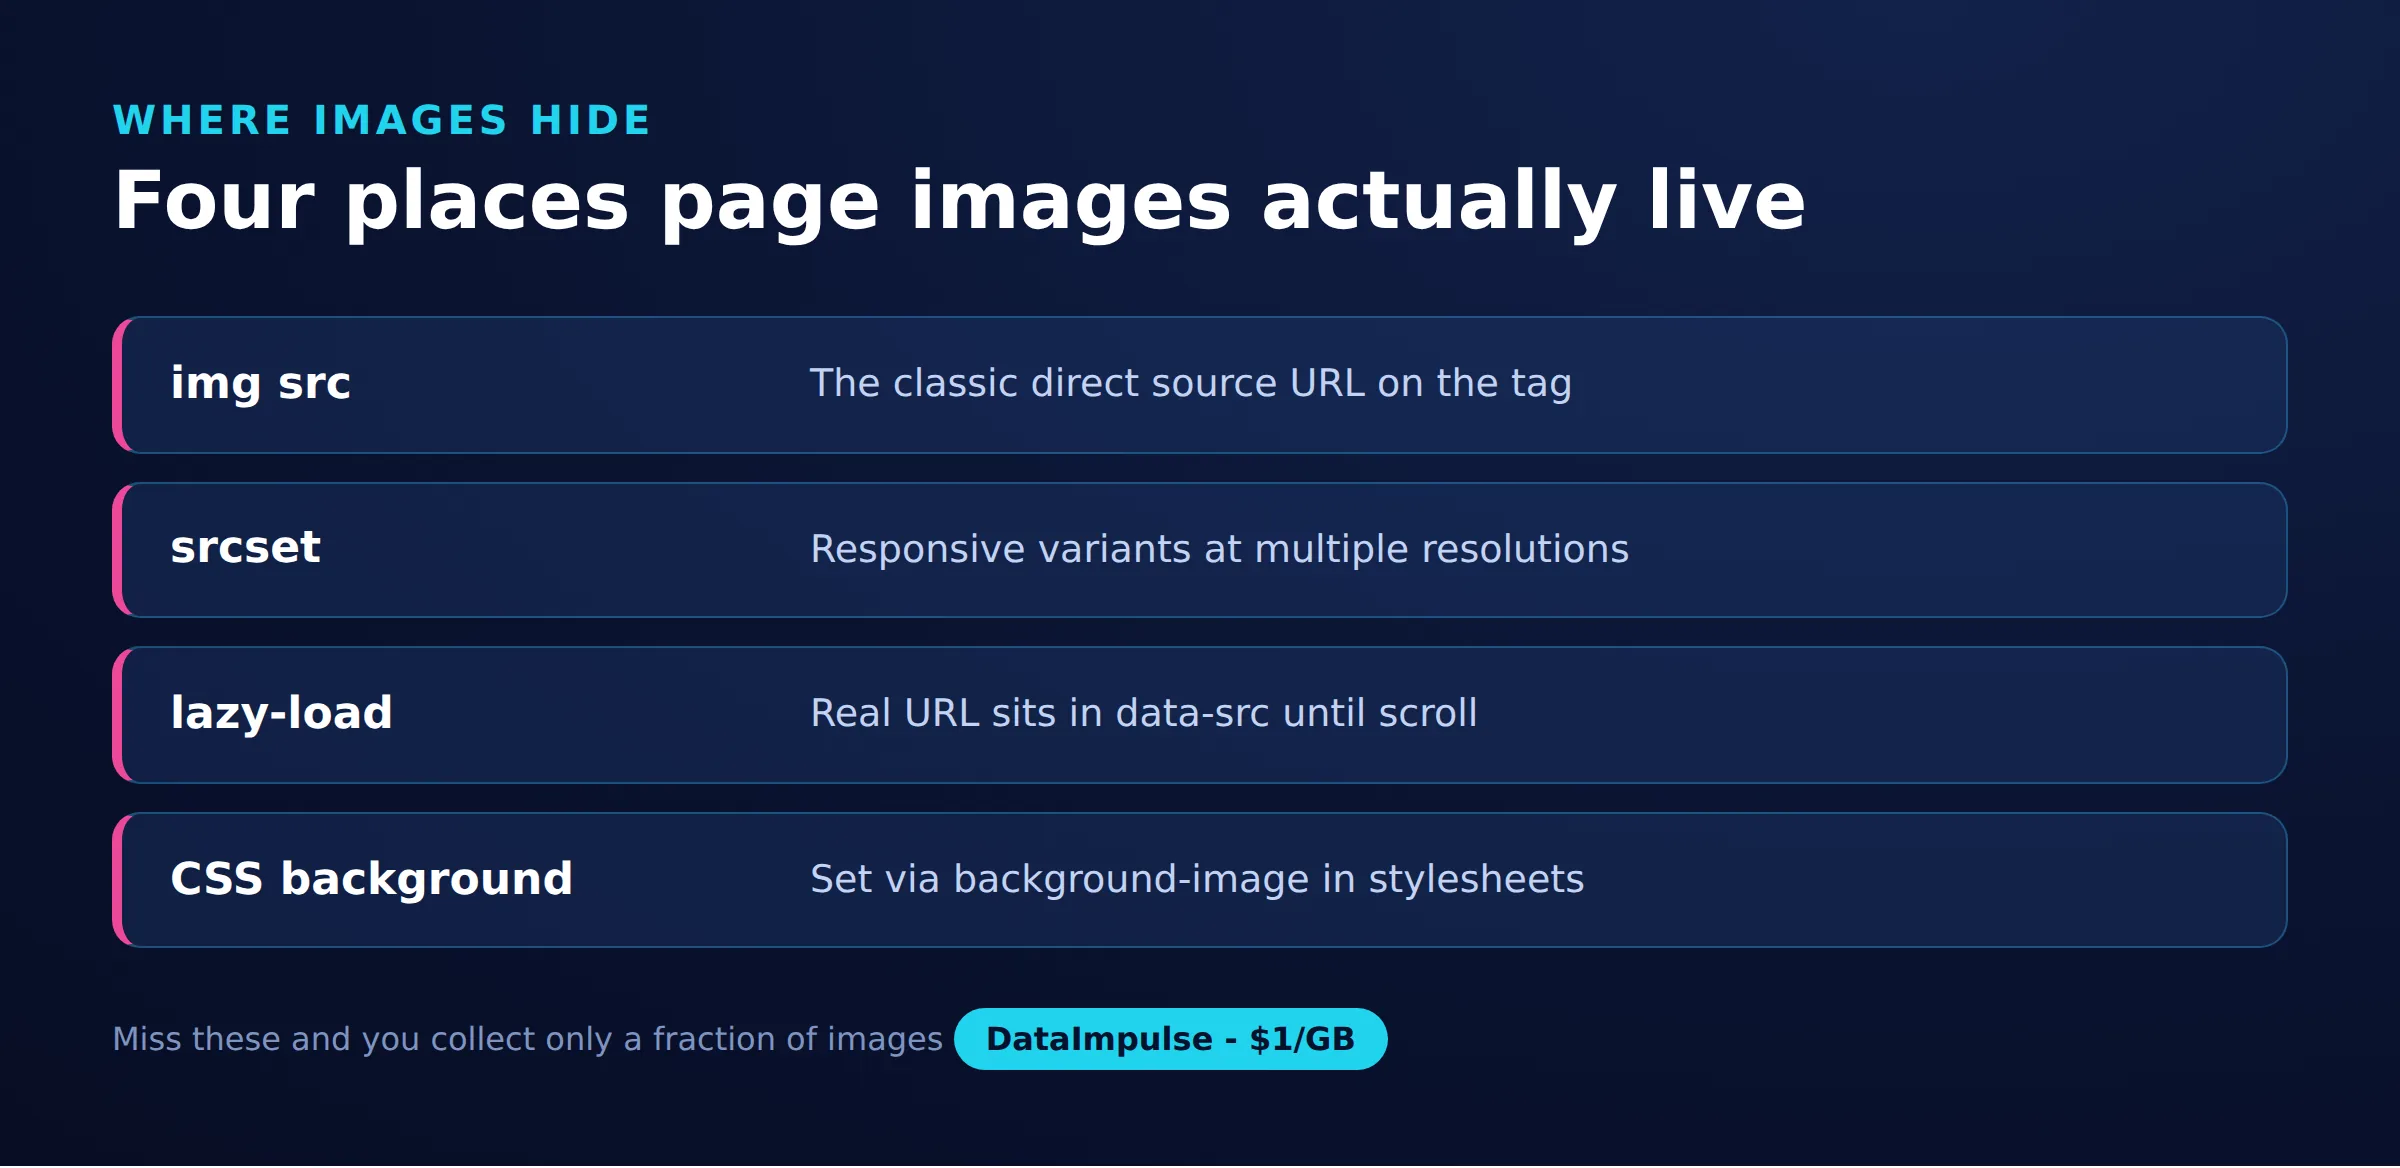
Bild-URLs werden an mehreren Stellen gespeichert, nicht nur im Attribut src. Ein zuverlässiger Scraper prüft daher jede davon. Eine Seite kann dasselbe Bild über Standard-Tags, responsive Attribute, Platzhalter für Lazy Loading, Stylesheets und strukturierte Daten referenzieren.
- Standardbilder: Das Attribut
srceines<img>-Tags enthält die direkte URL. - Responsive Bilder: Das Attribut
srcsetbei<img>und<source>listet mehrere URLs mit Breiten- oder Dichteangaben auf, aus denen der Browser eine Größe wählen kann. - Lazy-Loaded-Bilder: Das sichtbare
srcist oft nur ein winziger Platzhalter, während die echte URL indata-src,data-originaloder einem ähnlichen benutzerdefinierten Attribut liegt, bis der Nutzer scrollt. - CSS-Hintergründe: Dekorative Bilder werden mit
background-image: url(...)in Inline-Styles oder Stylesheets gesetzt und erscheinen überhaupt nicht in einem<img>-Tag. - Strukturierte Daten: Produkt- und Artikelseiten führen oft ein kanonisches Bild in hoher Auflösung in einem JSON-LD-Block auf.
Wegen dieser Verteilung sollten Sie die Seite als Sammlung potenzieller Quellen behandeln und vor dem Download an allen diesen Stellen sammeln. Die folgende Tabelle fasst zusammen, wo sich jede Quelle befindet und welche Falle die meisten Scraper ins Stolpern bringt.
| Extraktionsquelle | Fundort | Häufige Falle |
|---|---|---|
| img src | src-Attribut von img-Tags | Bei Seiten mit Lazy Loading oft ein Platzhalter oder eine data:-URI |
| srcset | srcset bei img- und source-Tags | Enthält mehrere URLs mit Breitenangaben; Sie müssen es parsen und eine Größe auswählen |
| Lazy-Attribute | data-src, data-original, data-lazy-src, data-srcset | Die Attributnamen unterscheiden sich je nach Framework, prüfen Sie daher das tatsächliche Markup |
| CSS-Hintergrund | Inline-Styles und Style-Blöcke, background-image: url() | Erscheint nie in einem img-Tag; erfordert einen regulären Ausdruck für den CSS-Text |
| JSON-LD | script-Tag mit type application/ld+json | Das Bildfeld kann eine Zeichenfolge, eine Liste oder ein verschachteltes Objekt sein |
Wie richten Sie einen Python-Bild-Scraper ein?
Installieren Sie requests für HTTP, BeautifulSoup zum Parsen und lxml als schnelles Parser-Backend. Rufen Sie dann die Seite ab und lesen Sie das src jedes Bild-Tags aus. Dieses minimale Beispiel ist die Grundlage für alle späteren Schritte.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
Das Objekt Session hält Verbindungen offen und verwendet Header erneut. Das ist schneller und schont den Zielserver mehr, als für jede Anfrage eine neue Verbindung zu öffnen. Rufen Sie immer urljoin auf, damit relative Pfade wie /media/photo.jpg zu absoluten URLs aufgelöst werden, die Sie später herunterladen können. Wenn Sie mit dem allgemeinen Workflow noch nicht vertraut sind, behandelt der Leitfaden bewährte Praktiken für Web Scraping Header, Timeouts und einen rücksichtsvollen Umgang ausführlicher.
Wie extrahieren Sie img src, srcset und Lazy-Loaded-Quellen?
Parsen Sie srcset, indem Sie an Kommata trennen und die Breitenangabe auslesen, damit Sie die größte Variante auswählen können. Lesen Sie außerdem jedes wahrscheinliche data--Attribut für Lazy-Loaded-Quellen. Ein einfaches Auslesen von Attributen übersieht den Großteil einer modernen Seite. Sie benötigen daher kleine Hilfsfunktionen für jedes Format.
Der Wert srcset bündelt mehrere URLs zusammen mit Angaben wie 800w. Um die Kopie mit der höchsten Auflösung zu erhalten, vergleichen Sie die Breitenwerte und behalten den größten.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Kombinieren Sie nun Standard-, responsive und Lazy-Quellen in einem Collector. Verschiedene Frameworks verwenden unterschiedliche Attributnamen, prüfen Sie also mehrere. Dieselbe Funktion liest auch <source>-Tags innerhalb von <picture>-Elementen, die ihr eigenes srcset enthalten.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
Wenn Sie jedes mit data: beginnende src überspringen, vermeiden Sie das Speichern von Inline-base64-Platzhaltern. Dabei handelt es sich meist um die Vorschaubilder niedriger Qualität, die ein Lazy Loader zeigt, bevor das echte Bild eintrifft.
Wie finden Sie CSS-Hintergrund- und JSON-LD-Bilder?
Verwenden Sie einen regulären Ausdruck, um URLs aus background-image-Deklarationen zu extrahieren, und durchlaufen Sie jeden JSON-LD-Block, um dessen Feld image auszulesen. Diese beiden Quellen erscheinen nie in einem <img>-Tag. Ein Scraper, der nur Bild-Tags ausliest, verpasst sie daher vollständig.
Dekorative Bilder und Hero-Bilder werden häufig in CSS festgelegt. Durchsuchen Sie sowohl Inline-Attribute style als auch <style>-Blöcke nach Werten url(...).
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
Strukturierte Daten sind die zuverlässigste Stelle, um auf Produkt- und Artikelseiten ein kanonisches Bild in voller Auflösung zu finden. Der Wert image kann eine Zeichenfolge, eine Liste oder ein verschachteltes Objekt sein. Durchlaufen Sie daher den gesamten Baum.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Führen Sie die drei Collector mit einer Mengenvereinigung zusammen, etwa collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base). Dann haben Sie eine deduplizierte Menge potenzieller URLs, die zum Download bereitsteht.
Wie laden Sie Bilddateien sicher herunter?
Streamen Sie jede Antwort, vergewissern Sie sich, dass der Header Content-Type tatsächlich ein Bild angibt, und begrenzen Sie die Größe, damit eine einzelne Datei weder Arbeitsspeicher noch Speicherplatz erschöpfen kann. Wer eine URL blind herunterlädt, riskiert das Speichern von HTML-Fehlerseiten, Weiterleitungen oder riesigen Dateien. Validieren Sie daher, bevor Sie die Bytes behalten.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
Durch Streaming mit stream=True und iter_content erfolgt die Header-Prüfung, bevor der vollständige Body heruntergeladen wird. Ein falsch bezeichneter Link wird also früh abgewiesen. Die Prüfung des gemeldeten Typs erfasst den häufigen Fall, dass eine defekte URL eine HTML-404-Seite mit dem Status 200 zurückgibt. Für zusätzliche Sicherheit können Sie auch die ersten Magic Bytes der Nutzlast prüfen, doch Header-Prüfung und Größenlimit reichen für die meisten realen Scraping-Fälle aus.
Wie deduplizieren und benennen Sie heruntergeladene Bilder?
Bilden Sie für die heruntergeladenen Bytes einen SHA-256-Hash und überspringen Sie jeden bereits gespeicherten Digest. Bereinigen Sie anschließend den Dateinamen und verteilen Sie Dateien nach Hash-Präfix auf Unterordner. Websites liefern dasselbe Bild häufig über mehrere Pfade, CDNs oder Größenvarianten aus. Ein Content-Hash ist daher zuverlässiger als der Vergleich von URLs.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
Das Bereinigen des Basisdateinamens entfernt Zeichen für Path Traversal und Query-String-Müll, sodass eine bösartige oder unordentliche URL nicht außerhalb Ihres Zielordners schreiben kann. Die Aufteilung nach den ersten zwei Hash-Zeichen hält Verzeichnisse klein, was wichtig wird, sobald Sie Zehntausende Dateien sammeln. Für die Erkennung ähnlicher Duplikate, etwa desselben Fotos in verschiedenen Auflösungen, gruppiert eine Perceptual-Hash-Bibliothek wie imagehash visuell ähnliche Dateien, die Byte-Hashes als unterschiedlich behandeln.
Wie laden Sie viele Bilder gleichzeitig herunter?
Verwenden Sie einen ThreadPoolExecutor, um mehrere Bilder gleichzeitig herunterzuladen, und ergänzen Sie einen gemeinsamen Rate Limiter, damit alle Threads zusammen unter einem Limit für Anfragen pro Sekunde bleiben. Bild-Downloads sind I/O-gebunden, daher bringen Threads einen deutlichen Geschwindigkeitsgewinn. Unbegrenzte Parallelität überlastet jedoch das Ziel und führt zu einer Sperre.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
Die Sperre um seen macht die Deduplizierung threadsicher, und jeder Job in einem try-Block sorgt dafür, dass eine fehlerhafte URL nicht den gesamten Lauf stoppt. Halten Sie die Rate moderat. Eine Handvoll Anfragen pro Sekunde ist ein vernünftiger Standardwert. Im Leitfaden ethisches Web Scraping erfahren Sie, wie Sie Limits wählen, die die Website respektieren.
Wie scrapen Sie Bilder im großen Maßstab mit Proxys?
Sobald ein Ziel Ihre IP drosselt oder blockiert, benötigen Sie Proxys. Das geschieht schnell, wenn Sie viele Bilder von einer einzigen Adresse herunterladen. Übergeben Sie jeder Anfrage ein Dictionary proxies, damit dieselbe Download-Schleife über rotierende Residential-IP-Adressen geleitet wird. Ein stetiger Strom von Bildanfragen von einer einzelnen IP ist ein offensichtliches automatisiertes Muster, und da Bilder datenintensiv sind, ist die Bandbreite meist die eigentliche Einschränkung.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Rotierende Proxys verteilen Anfragen auf viele IPs, sodass keine einzelne Adresse auffällt. Sticky Sessions behalten dagegen eine IP für eine Galerie bei, die eine Website mit einer Sitzung verknüpft. DataImpulse bietet Residential-Proxys und mobile Proxys für Ziele, die Traffic genau prüfen, sowie Datacenter-Proxys für umfangreiche Downloads von toleranten Quellen. Alle IPs stammen ethisch von Nutzern, die einwilligen und vergütet werden. Wenn Ihre Zugangsdaten mit einer 407 abgewiesen werden, beschreibt der Leitfaden Proxy-Authentifizierung das exakte Login-Format.
Da jedes heruntergeladene Byte Ihr Traffic-Budget belastet, sollten Sie die Größe vor dem Start einplanen: Überspringen Sie Bilder unterhalb eines Schwellenwerts, wenn Sie nur den Hauptinhalt möchten, fordern Sie eine kleinere srcset-Variante an, wenn keine volle Auflösung erforderlich ist, und cachen Sie bereits vorhandene Daten, damit ein erneuter Lauf nicht alles erneut abruft. DataImpulse rechnet nutzungsbasiert ab 1 Dollar pro GB mit nicht ablaufendem Traffic ab. Ein aufwendiger, aber gelegentlicher Bildjob erfordert daher kein monatliches Abonnement, und ungenutzter Traffic wird übertragen.
Wie scrapen Sie JavaScript-gerenderte Galerien?
Wenn eine Website ihre Galerie vollständig in JavaScript aufbaut, erscheinen die Bild-URLs nie im rohen HTML. Rendern Sie die Seite daher zuerst mit Playwright und übergeben Sie das Ergebnis an dieselben Collector. Requests allein kann keine Skripte ausführen. Galerien mit Infinite Scroll und Single-Page-Galerien benötigen daher einen echten Browser, um das Laden auszulösen.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Das Scrollen in einer Schleife zwingt einen Lazy Loader, seine Platzhalter data-src gegen echte URLs auszutauschen. Anschließend erfassen dieselben bereits geschriebenen Parser sie. Eine ausführlichere Behandlung des Headless-Renderings finden Sie unter dynamische Webseiten scrapen.
Schreiben Sie abschließend ein CSV-Manifest, damit sich jede heruntergeladene Datei auf ihre Quell-URL, ihren Hash und ihre Größe zurückverfolgen lässt. Ein Manifest verwandelt einen Ordner voller anonymer Dateien in einen Datensatz, den Sie prüfen, fortsetzen und laufübergreifend deduplizieren können.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Mit dem Manifest können Sie den Job erneut ausführen und jede bereits erfasste URL überspringen. Das spart Bandbreite und hält Ihren Datensatz über die Zeit konsistent.
Ist es legal, Bilder von einer Website zu scrapen und wiederzuverwenden?
Das Herunterladen einer Bilddatei ist ein technischer Vorgang. Es verschafft Ihnen keine Lizenz, dieses Bild wiederzuverwenden. Dies ist der am häufigsten missverstandene Teil des Bild-Scrapings. Gehen Sie daher sorgfältig damit um. Nahezu jedes Foto, jede Illustration und jede Grafik im Web ist ab dem Moment ihrer Erstellung urheberrechtlich geschützt. Die Person, die sie aufgenommen oder erstellt hat, besitzt diese Rechte, sofern sie diese nicht ausdrücklich freigegeben hat.
Eine Datei abrufen zu können, sagt nichts über Ihr Recht aus, sie erneut zu veröffentlichen, zu verkaufen, zum Trainieren zu verwenden oder weiterzuverbreiten. Prüfen Sie vor der Wiederverwendung gescrapter Bilder die damit verbundenen Lizenzbedingungen, suchen Sie nach einer angegebenen Lizenz wie Creative Commons oder Public Domain und holen Sie bei kommerzieller Nutzung eine schriftliche Genehmigung ein. Bilder für private Analyse, Indexierung oder Forschung zu sammeln, ist etwas anderes als sie zu veröffentlichen. Die sichere Annahme ist, dass ein Bild geschützt ist, sofern eine Lizenz nicht eindeutig etwas anderes besagt.
Lesen Sie vor dem Start auch die Nutzungsbedingungen der Ziel-Website und die robots.txt. Der Leitfaden prüfen, ob eine Website Scraping erlaubt zeigt, wie Sie diese Signale deuten. Der Leitfaden scrapen, ohne blockiert zu werden behandelt rücksichtsvolle Crawling-Praktiken. Keine der Techniken in diesem Artikel ändert die grundlegende Regel: Zugriff ist keine Lizenz. Ein funktionierender Scraper und ein rechtliches Recht zur Wiederverwendung sind zwei getrennte Voraussetzungen, die Sie unabhängig voneinander erfüllen müssen.
Häufig gestellte Fragen
Kann ich Bilder von jeder Website scrapen?
Technisch können Sie Dateien von den meisten Websites herunterladen. Prüfen Sie jedoch zuerst die Nutzungsbedingungen der Website und die robots.txt. Denken Sie daran, dass Ihnen das Herunterladen eines Bildes kein Recht auf dessen Wiederverwendung gibt. Zugriff ist keine Lizenz.
Warum erscheinen manche Bilder nicht im HTML, das ich herunterlade?
Diese Bilder werden gewöhnlich per JavaScript oder Lazy Loading geladen. Ihre echten URLs befinden sich daher in Datenattributen oder werden nach dem Rendern der Seite hinzugefügt. Rendern Sie die Seite mit einem Headless-Browser wie Playwright und scrollen Sie, um das Laden auszulösen. Parsen Sie anschließend das Ergebnis.
Wie wähle ich die Version eines Bildes mit der höchsten Auflösung?
Parsen Sie das Attribut srcset, lesen Sie die Breitenangabe nach jeder URL und behalten Sie die URL mit der größten Breite. Produktseiten führen häufig zusätzlich ein Bild in voller Auflösung in einem JSON-LD-Block auf.
Wie vermeide ich, dass ich dasselbe Bild zweimal herunterlade?
Berechnen Sie einen SHA-256-Hash jeder heruntergeladenen Datei und überspringen Sie jeden Hash, den Sie bereits gespeichert haben. Verwenden Sie für visuell ähnliche Kopien in unterschiedlichen Größen stattdessen eine Perceptual-Hash-Bibliothek wie imagehash.
Bietet DataImpulse eine verwaltete API zum Scrapen von Bildern?
Nein. DataImpulse stellt Proxys bereit, über die Sie Ihren eigenen Scraper leiten. Es ist keine verwaltete Scraping-API und kein kostenloser Web-Proxy-Dienst. Sie schreiben die Download-Logik und nutzen seine IPs für Zugriff und Rotation.
Wann ist DataImpulse nicht die richtige Wahl?
Wenn Sie statische ISP-Proxys, eine vollständig verwaltete Scraping-API oder Zugriff auf Banking- und Regierungswebsites benötigen, ist DataImpulse nicht das richtige Werkzeug. Der Fokus liegt auf rotierenden Residential-, mobilen und Datacenter-Proxys zum Sammeln öffentlicher Daten und zum Zugriff auf Inhalte.
Beginnen Sie mit dem Scrapen von Bildern im großen Maßstab
Wenn Ihr Bild-Scraper zuverlässigen Zugriff und IP-Rotation ohne Abonnement benötigt, bietet DataImpulse ethisch bezogene Residential-, mobile und Datacenter-Proxys mit nutzungsbasiertem Traffic ab 1 Dollar pro GB. Erstellen Sie ein Konto und leiten Sie Ihre Download-Schleife innerhalb weniger Minuten darüber.