
In this Article
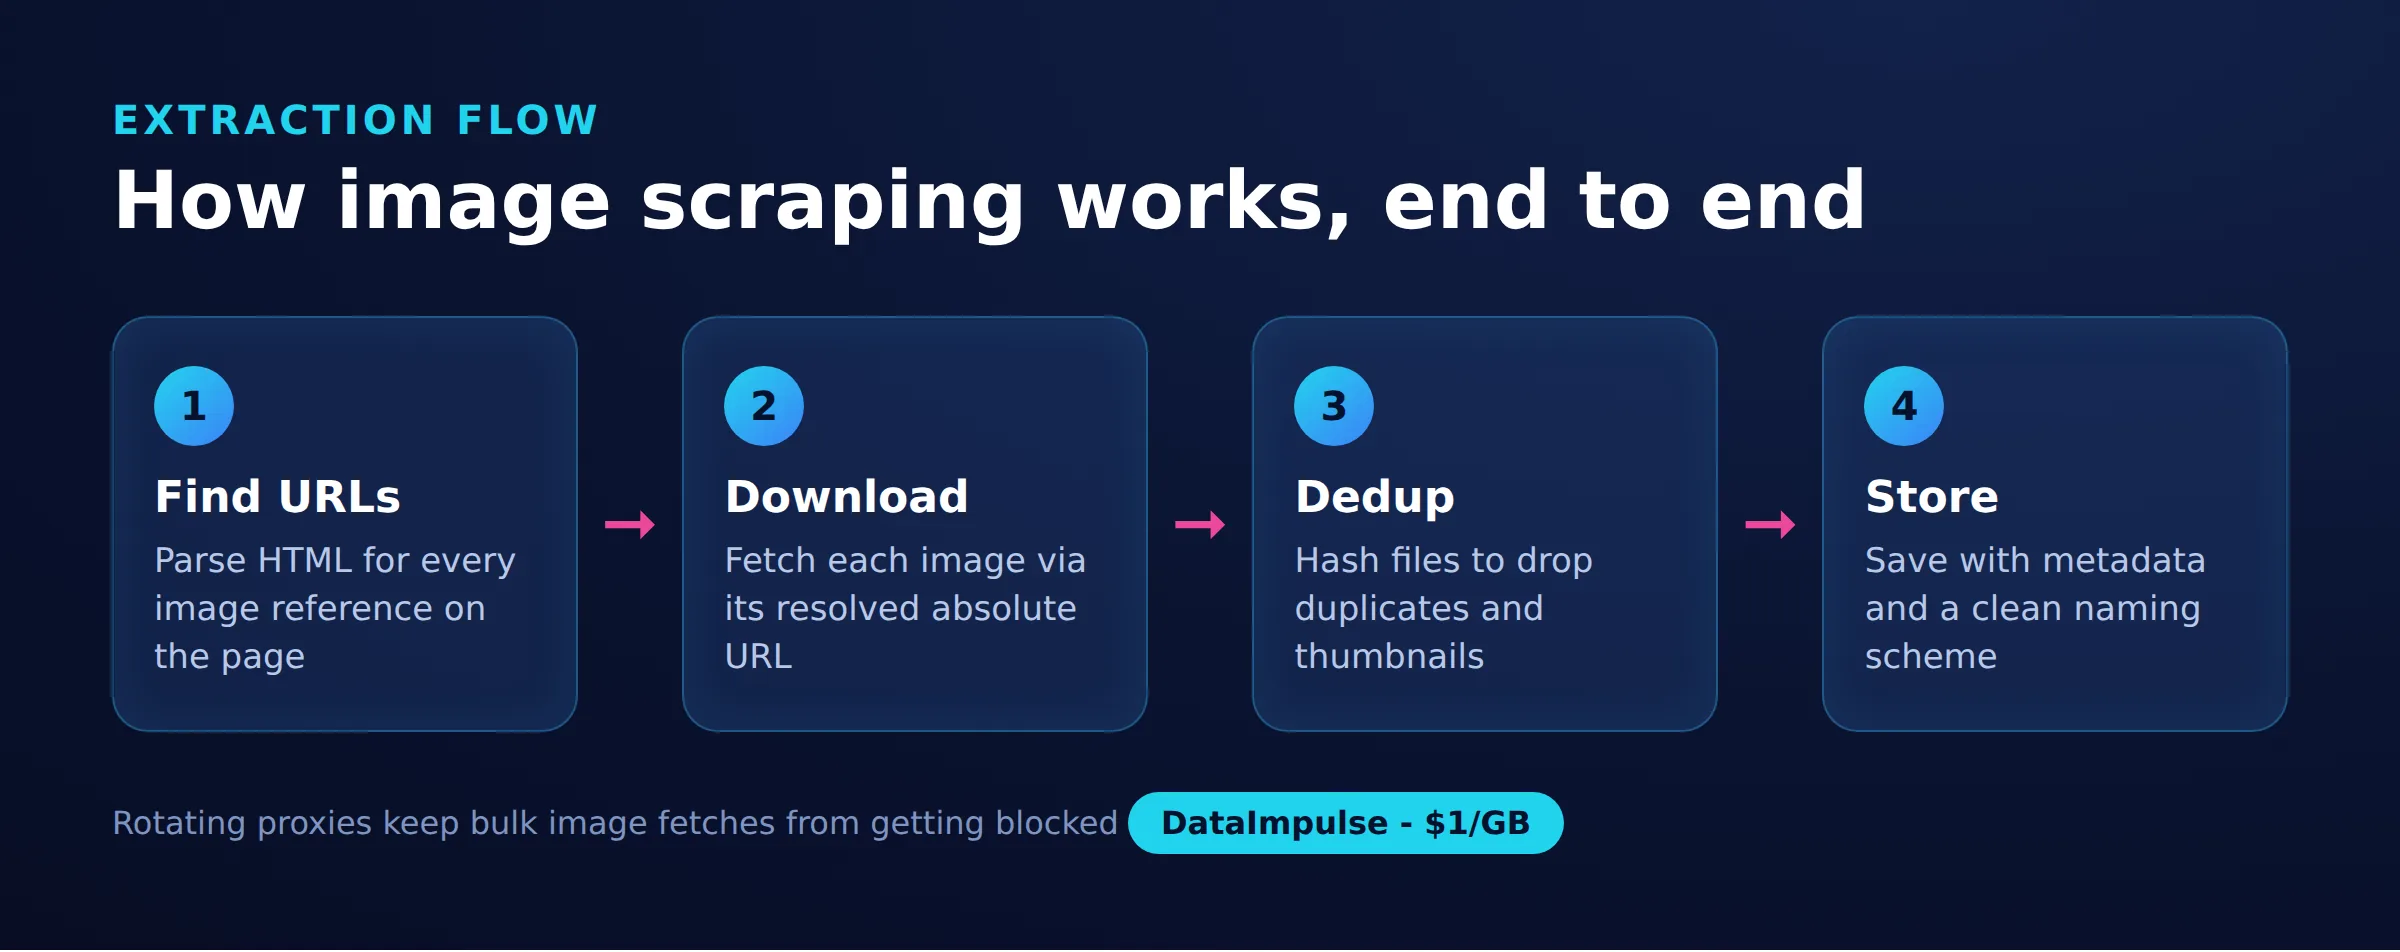
ویب سائٹ سے تصاویر اسکریپ کرنے کا مطلب دو کام کرنا ہے: پہلے یہ معلوم کرنا کہ ہر تصویر کا ماخذ HTML میں کہاں ہے، پھر ان URLs کے پیچھے موجود بائنری فائلیں ڈاؤن لوڈ کرنا۔ یہ گائیڈ دونوں مراحل کو چلنے والے Python کوڈ کے ساتھ سمجھاتی ہے، srcset کے انتخاب، لیزی لوڈنگ اور CSS بیک گراؤنڈز جیسے مشکل معاملات کا احاطہ کرتی ہے، اور بتاتی ہے کہ کاپی رائٹ اور بینڈوڈتھ کی حدود کا خیال کیسے رکھا جائے۔
تصاویر متن سے زیادہ بھاری ہوتی ہیں، اس لیے انہیں بڑے پیمانے پر جمع کرنے کے لیے اسٹوریج، ڈی ڈپلیکیشن، کنکرنسی اور نیٹ ورک لاگت کا منصوبہ درکار ہوتا ہے۔ نیچے دی گئی ہر چیز requests، BeautifulSoup اور Playwright کے ساتھ چلائی جا سکتی ہے، اور یہ تکنیکیں ایک گیلری یا بڑے کیٹلاگ دونوں پر لاگو ہوتی ہیں۔
DataImpulse اخلاقی پراکسیز فراہم کرنے والا ادارہ ہے جو 195 ممالک میں 9 کروڑ سے زائد رہائشی، موبائل اور ڈیٹا سینٹر IP ایڈریسز پیش کرتا ہے۔ یہ 1 ڈالر فی GB سے شروع ہونے والا پے ایز یو گو ماڈل دیتا ہے جس میں ٹریفک کبھی ختم نہیں ہوتی، اور اسے ویب اسکریپنگ، اشتہار کی تصدیق، قیمت کی نگرانی، مارکیٹ ریسرچ اور ملٹی اکاؤنٹ مینجمنٹ کے لیے استعمال کیا جاتا ہے۔
اہم حقائق
- اہم نکتہ: کسی ویب سائٹ سے تصاویر اسکریپ کرنے کے لیے آپ کو پہلے ہر ماخذ (img src، srcset، لیزی لوڈ data ایٹریبیوٹس، CSS بیک گراؤنڈز اور JSON-LD) نکالنا ہوگا، پھر بائنری فائلیں ڈاؤن لوڈ کرنی ہوں گی، کیونکہ مارک اپ اور اصل تصویری فائلیں الگ الگ درخواستیں ہیں۔
- بہترین پراکسی قسم: روٹیٹنگ رہائشی پراکسیز، جو حقیقی صارفین کے IPs استعمال کرتی ہیں اور عموما شناختی نظاموں سے گزر جاتی ہیں۔
- قیمت: 1 ڈالر فی GB سے، پے ایز یو گو، ایسی ٹریفک کے ساتھ جو ختم نہیں ہوتی اور بغیر کسی سبسکرپشن کے۔
- کوریج: 195 ممالک میں 9 کروڑ سے زائد اخلاقی طور پر حاصل کردہ IPs۔
- قابلِ اعتماد: 99.51% کامیابی کی شرح، G2 پر 5 میں سے 4.8 درجہ بندی۔
- پروٹوکولز اور ہدف بندی: HTTP، HTTPS اور SOCKS5، ملک کی سطح پر ہدف بندی کے ساتھ۔
ویب پیج میں تصویر کے URLs کہاں ہوتے ہیں؟
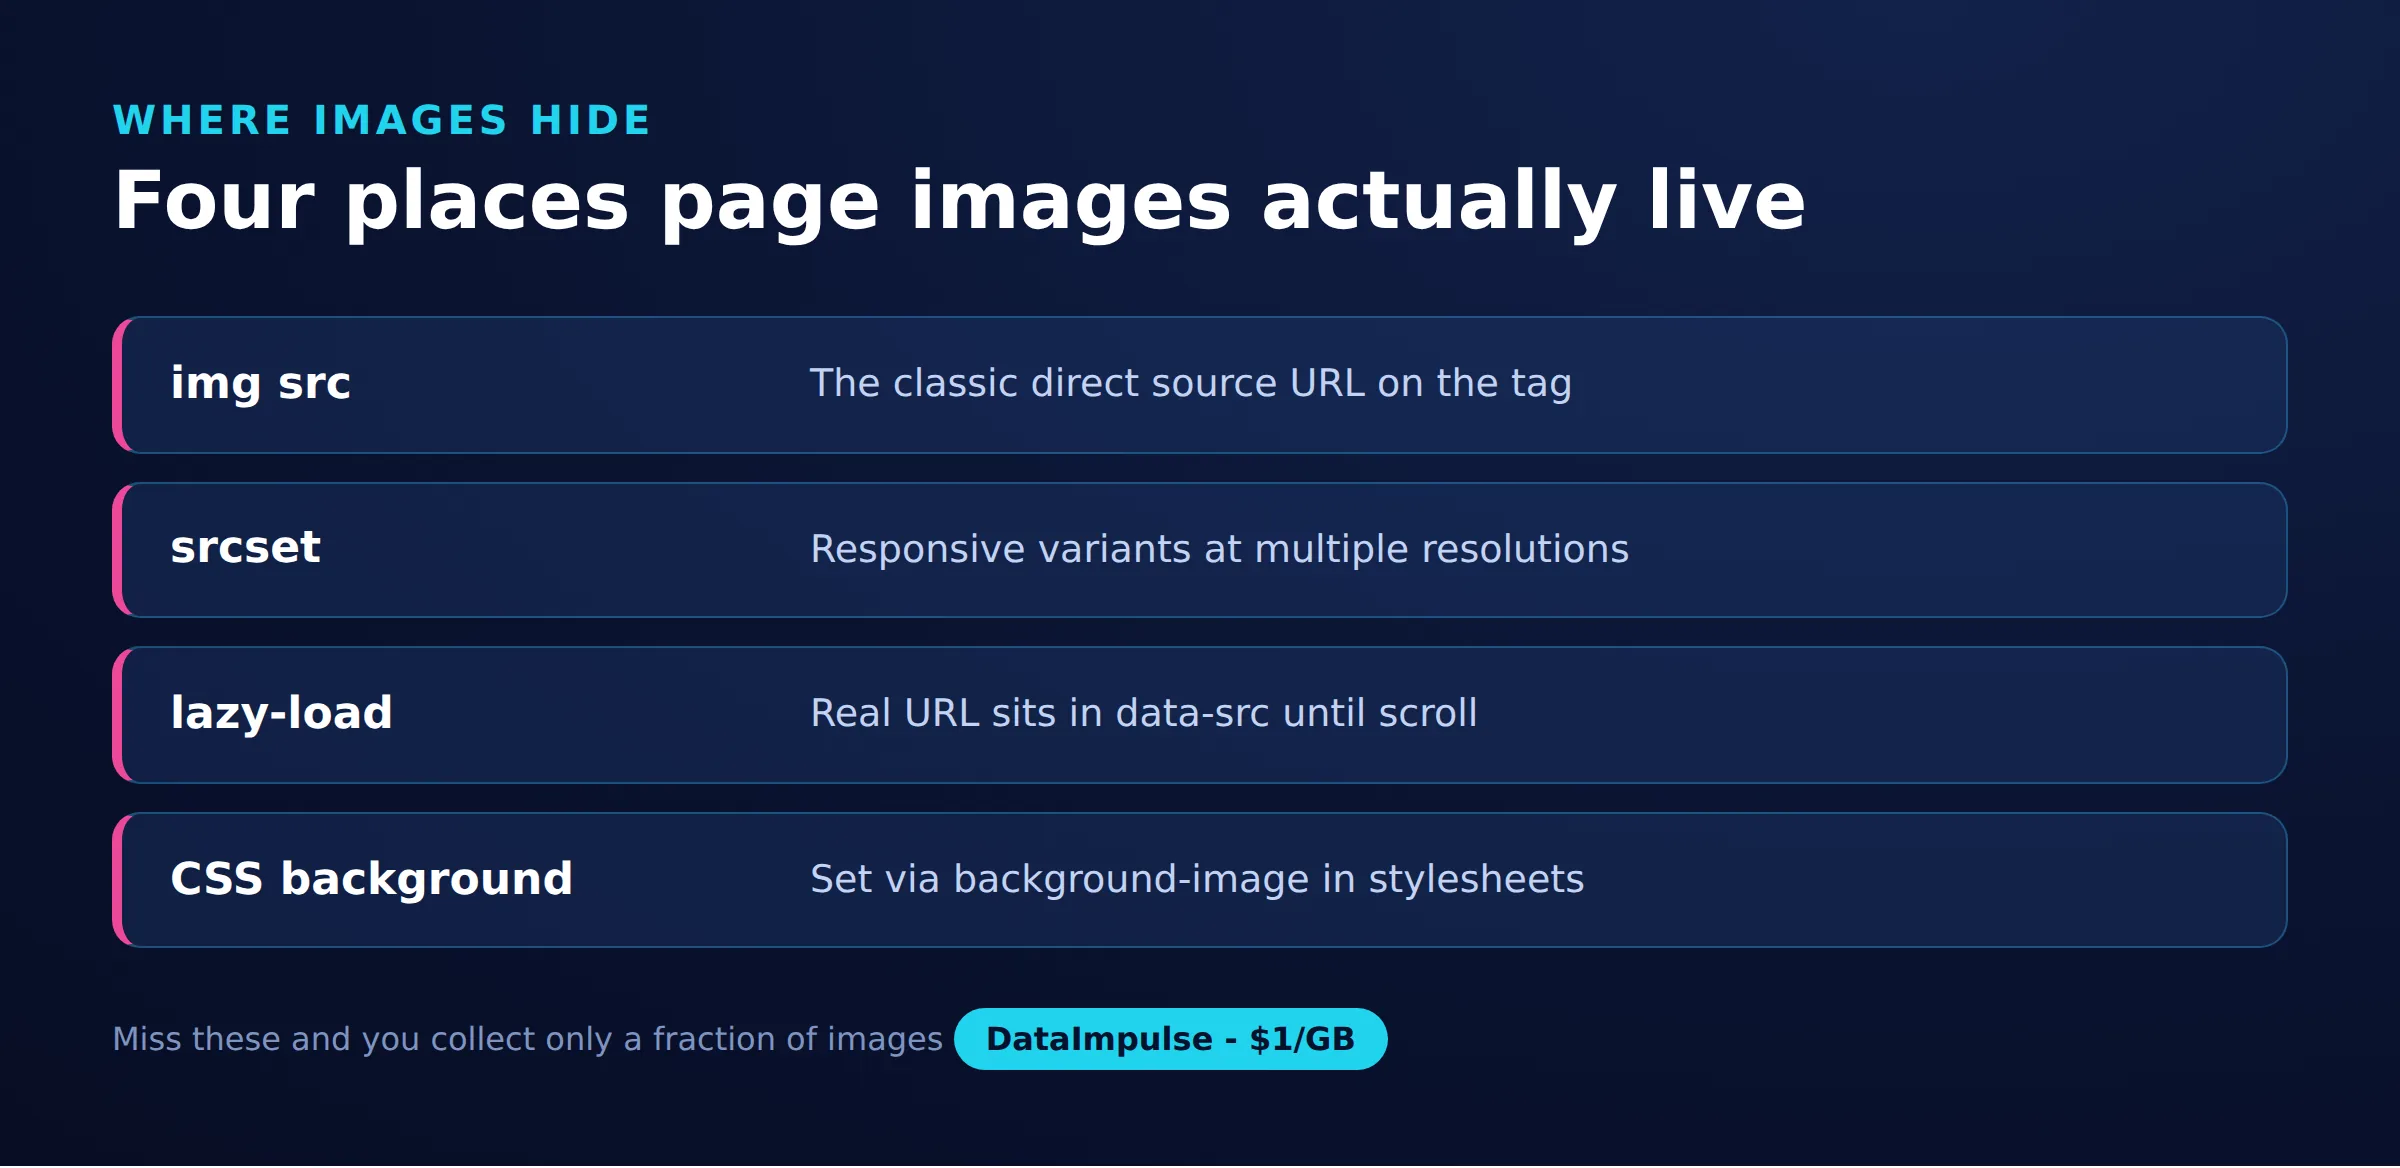
تصویر کے URLs کئی جگہوں پر محفوظ ہوتے ہیں، صرف src ایٹریبیوٹ میں نہیں، اس لیے ایک قابلِ اعتماد اسکریپر ہر ایک کو چیک کرتا ہے۔ ایک صفحہ معیاری ٹیگز، ریسپانسیو ایٹریبیوٹس، لیزی لوڈنگ پلیس ہولڈرز، اسٹائل شیٹس اور اسٹرکچرڈ ڈیٹا کے ذریعے ایک ہی تصویر کا حوالہ دے سکتا ہے۔
- معیاری تصاویر:
<img>ٹیگ کاsrcایٹریبیوٹ براہِ راست URL رکھتا ہے۔ - ریسپانسیو تصاویر:
<img>اور<source>پر موجودsrcsetایٹریبیوٹ چوڑائی یا کثافت کے ڈسکرپٹرز کے ساتھ متعدد URLs درج کرتا ہے، جن کی مدد سے براؤزر مناسب سائز منتخب کر لیتا ہے۔ - لیزی لوڈ تصاویر: نظر آنے والا
srcاکثر ایک چھوٹا سا پلیس ہولڈر ہوتا ہے، جبکہ اصل URLdata-src،data-original، یا اسی طرح کے کسٹم ایٹریبیوٹ میں ہوتا ہے جب تک صارف اسکرول نہ کرے۔ - CSS بیک گراؤنڈز: آرائشی تصاویر ان لائن اسٹائلز یا اسٹائل شیٹس میں
background-image: url(...)کے ذریعے سیٹ کی جاتی ہیں، اور کبھی بھی<img>ٹیگ میں ظاہر نہیں ہوتیں۔ - اسٹرکچرڈ ڈیٹا: پروڈکٹ اور آرٹیکل کے صفحات اکثر JSON-LD بلاک میں ایک کینونیکل ہائی ریزولوشن تصویر درج کرتے ہیں۔
چونکہ تصویر کے ماخذ بکھرے ہوئے ہو سکتے ہیں، اس لیے صفحے کو ممکنہ ماخذوں کے مجموعے کے طور پر دیکھیں اور ڈاؤن لوڈ سے پہلے انہیں ان تمام جگہوں سے جمع کریں۔ نیچے دی گئی ٹیبل بتاتی ہے کہ ہر ماخذ کہاں ملتا ہے اور عام طور پر کون سی چیز اسکریپرز کے لیے مسئلہ بنتی ہے۔
| نکالنے کے لیے ماخذ | اسے کہاں تلاش کریں | عام مسئلہ |
|---|---|---|
| img src | img ٹیگز کا src ایٹریبیوٹ | لیزی لوڈ صفحات پر اکثر ایک پلیس ہولڈر یا data: URI |
| srcset | img اور source ٹیگز پر srcset | چوڑائی کے ڈسکرپٹرز کے ساتھ کئی URLs رکھتا ہے؛ آپ کو اسے پارس کر کے ایک سائز منتخب کرنا ہوگا |
| لیزی ایٹریبیوٹس | data-src, data-original, data-lazy-src, data-srcset | ایٹریبیوٹ کے نام فریم ورک کے لحاظ سے مختلف ہوتے ہیں، اس لیے اصل مارک اپ چیک کریں |
| CSS بیک گراؤنڈ | ان لائن style اور style بلاکس، background-image: url() | img ٹیگ میں ظاہر نہیں ہوتا؛ CSS متن پر ریجیکس کی ضرورت پڑتی ہے |
| JSON-LD | type application/ld+json کے ساتھ script ٹیگ | image فیلڈ ایک اسٹرنگ، لسٹ، یا نیسٹڈ آبجیکٹ ہو سکتا ہے |
آپ Python تصویری اسکریپر کیسے سیٹ اپ کرتے ہیں؟
HTTP کے لیے requests، پارسنگ کے لیے BeautifulSoup، اور تیز پارسر بیک اینڈ کے طور پر lxml انسٹال کریں، پھر صفحہ حاصل کریں اور ہر تصویری ٹیگ کا src پڑھیں۔ یہ مختصر مثال آگے آنے والے ہر مرحلے کی بنیاد ہے۔
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
Session آبجیکٹ کنکشنز کو زندہ رکھتا ہے اور ہیڈرز دوبارہ استعمال کرتا ہے، جو ہر درخواست کے لیے نیا کنکشن کھولنے کے مقابلے میں تیز اور ٹارگٹ سرور پر کم بوجھ ڈالتا ہے۔ ہمیشہ urljoin کال کریں تاکہ /media/photo.jpg جیسے رشتہ دار راستے مطلق URLs میں تبدیل ہو جائیں جنہیں آپ بعد میں ڈاؤن لوڈ کر سکیں۔ اگر آپ وسیع ورک فلو میں نئے ہیں، تو ویب اسکریپنگ کے بہترین طریقوں کی گائیڈ ہیڈرز، ٹائم آؤٹس اور شائستہ درخواستوں کے اصول زیادہ تفصیل سے بیان کرتی ہے۔
آپ img src، srcset اور لیزی لوڈ ذرائع کیسے نکالتے ہیں؟
srcset کو کوما پر تقسیم کر کے اور چوڑائی کا ڈسکرپٹر پڑھ کر پارس کریں تاکہ آپ سب سے بڑا ورژن منتخب کر سکیں، اور لیزی لوڈ ذرائع کے لیے ہر ممکنہ data- ایٹریبیوٹ پڑھیں۔ صرف ایک ایٹریبیوٹ پڑھنے سے جدید صفحات کی بہت سی تصاویر رہ جاتی ہیں، اس لیے آپ کو ہر فارمیٹ کے لیے چھوٹے مددگار فنکشنز درکار ہوتے ہیں۔
srcset ویلیو میں کئی URLs 800w جیسے ڈسکرپٹرز کے ساتھ درج ہوتے ہیں۔ سب سے زیادہ ریزولوشن والی کاپی حاصل کرنے کے لیے، چوڑائی کے اعداد کا موازنہ کریں اور سب سے بڑا URL رکھیں۔
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
اب معیاری، ریسپانسیو اور لیزی لوڈ ذرائع کو ایک کلیکٹر میں یکجا کریں۔ مختلف فریم ورک مختلف ایٹریبیوٹ نام استعمال کرتے ہیں، اس لیے کئی کو چیک کریں۔ یہی فنکشن <picture> عناصر کے اندر موجود <source> ٹیگز بھی پڑھتا ہے، جن کا اپنا الگ srcset ہوتا ہے۔
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
کسی بھی ایسے src کو چھوڑ دینا جو data: سے شروع ہوتا ہے، ان لائن base64 پلیس ہولڈرز محفوظ کرنے سے بچاتا ہے، جو عام طور پر وہ کم معیار کے تھمب نیل ہوتے ہیں جو ایک لیزی لوڈر اصل تصویر آنے سے پہلے دکھاتا ہے۔
آپ CSS بیک گراؤنڈ اور JSON-LD تصاویر کیسے تلاش کرتے ہیں؟
background-image اعلانات سے URLs نکالنے کے لیے ریگولر ایکسپریشن استعمال کریں، اور ہر JSON-LD بلاک میں تلاش کر کے اس کا image فیلڈ پڑھیں۔ یہ دونوں ماخذ کبھی <img> ٹیگ میں ظاہر نہیں ہوتے، اس لیے صرف امیج ٹیگز پڑھنے والا اسکریپر انہیں مکمل طور پر چھوڑ دے گا۔
آرائشی اور ہیرو تصاویر عام طور پر CSS میں سیٹ کی جاتی ہیں۔ url(...) ویلیوز کے لیے ان لائن style ایٹریبیوٹس اور <style> بلاکس دونوں کو اسکین کریں۔
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
پروڈکٹ اور آرٹیکل کے صفحات پر ایک کینونیکل، فل ریزولوشن تصویر تلاش کرنے کے لیے اسٹرکچرڈ ڈیٹا سب سے قابلِ اعتماد جگہ ہے۔ image ویلیو ایک اسٹرنگ، لسٹ، یا نیسٹڈ آبجیکٹ ہو سکتی ہے، اس لیے پورے ٹری میں تلاش کریں۔
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
تینوں کلیکٹرز کو سیٹ یونین کے ذریعے جوڑ دیں، مثال کے طور پر collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base)، اور آپ کے پاس ڈاؤن لوڈ کے لیے تیار امیدوار URLs کا ایک ڈی ڈپلیکیٹڈ سیٹ مل جائے گا۔
آپ تصویری فائلیں محفوظ طریقے سے کیسے ڈاؤن لوڈ کرتے ہیں؟
ہر ریسپانس کو اسٹریم کریں، تصدیق کریں کہ Content-Type ہیڈر واقعی ایک تصویر ہے، اور سائز کی حد مقرر کریں تاکہ ایک واحد فائل میموری یا ڈسک بھر نہ دے۔ کسی URL کو آنکھ بند کر کے ڈاؤن لوڈ کرنے سے HTML ایرر پیجز، ری ڈائریکٹس، یا بہت بڑی فائلیں محفوظ ہونے کا خطرہ ہوتا ہے، اس لیے بائٹس محفوظ کرنے سے پہلے تصدیق کریں۔
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
stream=True اور iter_content کے ساتھ اسٹریمنگ کا مطلب ہے کہ ہیڈر چیک مکمل باڈی ڈاؤن لوڈ ہونے سے پہلے ہو جاتا ہے، اس لیے غلط لیبل والا لنک جلد مسترد ہو جاتا ہے۔ بتائی گئی قسم چیک کرنا اس عام صورت کو پکڑ لیتا ہے جہاں ایک ٹوٹا ہوا URL 200 اسٹیٹس کے ساتھ HTML 404 صفحہ واپس کرتا ہے۔ اضافی حفاظت کے لیے آپ پے لوڈ کے ابتدائی میجک بائٹس کی بھی تصدیق کر سکتے ہیں، لیکن ہیڈر چیک اور سائز کی حد زیادہ تر حقیقی دنیا کی اسکریپنگ کو سنبھال لیتی ہے۔
آپ ڈاؤن لوڈ کردہ تصاویر کو ڈی ڈپلیکیٹ اور نام کیسے دیتے ہیں؟
ڈاؤن لوڈ کی گئی بائٹس کو SHA-256 کے ساتھ ہیش کریں اور ہر ایسے ڈائجسٹ کو چھوڑ دیں جو آپ پہلے محفوظ کر چکے ہیں، پھر فائل کے نام کو صاف کریں اور فائلوں کو ہیش پریفکس کے ذریعے سب فولڈرز میں تقسیم کریں۔ ویب سائٹس اکثر ایک ہی تصویر کو متعدد راستوں، CDNs، یا سائز ورژنز سے فراہم کرتی ہیں، اس لیے مواد کا ہیش URLs کا موازنہ کرنے سے زیادہ قابلِ اعتماد ہے۔
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
بنیادی نام کو صاف کرنے سے پاتھ ٹراورسل حروف اور کوئری اسٹرنگ کا غیر ضروری حصہ ہٹ جاتا ہے تاکہ کوئی نقصان دہ یا بے ترتیب URL آپ کے ٹارگٹ فولڈر سے باہر نہ لکھ سکے۔ ہیش کے پہلے دو حروف کے ذریعے تقسیم کرنے سے ڈائریکٹریاں چھوٹی رہتی ہیں، جو اہم ہو جاتا ہے جب آپ دسیوں ہزار فائلیں جمع کر لیتے ہیں۔ قریب قریب ڈپلیکیٹ کی شناخت کے لیے، جیسے مختلف ریزولوشنز پر ایک ہی تصویر، imagehash جیسی پرسیپچوئل ہیش لائبریری بصری طور پر ملتی جلتی فائلوں کو گروپ کر دیتی ہے جنہیں بائٹ ہیش الگ الگ سمجھتے ہیں۔
آپ بہت سی تصاویر بیک وقت کیسے ڈاؤن لوڈ کرتے ہیں؟
ایک ساتھ کئی تصاویر ڈاؤن لوڈ کرنے کے لیے ThreadPoolExecutor استعمال کریں، اور ایک مشترکہ ریٹ لیمیٹر شامل کریں تاکہ تمام تھریڈز مل کر فی سیکنڈ درخواستوں کی حد سے نیچے رہیں۔ تصاویر ڈاؤن لوڈ کرنا I/O باؤنڈ کام ہے، اس لیے تھریڈز رفتار میں نمایاں اضافہ کرتے ہیں، لیکن بے حد کنکرنسی ٹارگٹ پر غیر ضروری دباؤ ڈالے گی اور آپ کی رسائی بلاک کروا سکتی ہے۔
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
seen کے گرد لاک ڈی ڈپلیکیشن کو تھریڈ سیف بناتا ہے، اور ہر جاب کو try بلاک میں رکھنے سے ایک خراب URL پورے رن کو نہیں روکتا۔ ریٹ کو معتدل رکھیں، فی سیکنڈ چند درخواستیں ایک مناسب ڈیفالٹ ہے، اور ویب سائٹ کا لحاظ رکھنے والی حدود منتخب کرنے کے لیے اخلاقی ویب اسکریپنگ کی گائیڈ پڑھیں۔
آپ پراکسیز کے ساتھ بڑے پیمانے پر تصاویر کیسے اسکریپ کرتے ہیں؟
جب کوئی ٹارگٹ آپ کے IP کو ریٹ لمٹ یا بلاک کرنا شروع کرے تو پراکسیز کی ضرورت پڑتی ہے، اور ایک ہی ایڈریس سے بہت سی تصاویر ڈاؤن لوڈ کرتے ہوئے ایسا جلد ہو سکتا ہے۔ ہر درخواست کو ایک proxies ڈکشنری پاس کریں تاکہ وہی ڈاؤن لوڈ لوپ روٹیٹنگ رہائشی IPs کے ذریعے چلے۔ ایک ہی IP سے تصویری درخواستوں کا مسلسل سلسلہ ایک واضح خودکار پیٹرن ہے، اور تصاویر بھاری ہوتی ہیں، اس لیے بینڈوڈتھ عام طور پر اصل حد بن جاتی ہے۔
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
روٹیٹنگ پراکسیز درخواستوں کو کئی IPs پر پھیلا دیتی ہیں تاکہ کوئی ایک ایڈریس توجہ نہ کھینچے، جبکہ اسٹکی سیشنز ایسی گیلری کے لیے ایک IP برقرار رکھتے ہیں جسے کوئی سائٹ کسی سیشن سے جوڑتی ہے۔ DataImpulse ان ٹارگٹس کے لیے رہائشی پراکسیز اور موبائل پراکسیز فراہم کرتا ہے جو ٹریفک کا باریک بینی سے جائزہ لیتے ہیں، اس کے علاوہ کم حساس ماخذوں سے زیادہ حجم کے ڈاؤن لوڈ کے لیے ڈیٹا سینٹر پراکسیز بھی۔ تمام IPs اخلاقی طور پر ان صارفین سے حاصل کیے جاتے ہیں جو رضامندی دیتے ہیں اور انہیں معاوضہ ملتا ہے۔ اگر آپ کی اسناد 407 کے ساتھ مسترد ہو جائیں، تو پراکسی توثیق کی گائیڈ لاگ ان کے درست فارمیٹ کو بیان کرتی ہے۔
چونکہ ہر ڈاؤن لوڈ شدہ بائٹ آپ کے ٹریفک بجٹ میں شمار ہوتا ہے، شروع کرنے سے پہلے سائز کا اندازہ لگا لیں: اگر آپ کو صرف مرکزی مواد چاہیے تو کسی حد سے نیچے کی تصاویر چھوڑ دیں، جب فل ریزولوشن کی ضرورت نہ ہو تو چھوٹا srcset ورژن مانگیں، اور جو کچھ پہلے سے موجود ہے اسے کیش کریں تاکہ دوبارہ چلانے پر سب کچھ دوبارہ حاصل نہ کیا جائے۔ DataImpulse 1 ڈالر فی GB سے پے ایز یو گو بلنگ استعمال کرتا ہے جس میں ٹریفک ختم نہیں ہوتی، اس لیے تصاویر کا بڑا مگر کبھی کبھار ہونے والا کام ماہانہ سبسکرپشن کا تقاضا نہیں کرتا، اور غیر استعمال شدہ ٹریفک آگے منتقل ہو جاتی ہے۔
آپ JavaScript سے رینڈر ہونے والی گیلریاں کیسے اسکریپ کرتے ہیں؟
اگر کوئی سائٹ اپنی گیلری مکمل طور پر JavaScript میں بناتی ہے، تو تصویر کے URLs خام HTML میں کبھی ظاہر نہیں ہوتے، اس لیے پہلے Playwright کے ساتھ صفحہ رینڈر کریں اور نتیجہ انہی کلیکٹرز کو دیں۔ صرف requests اسکرپٹس نہیں چلا سکتا، اس لیے انفینٹ اسکرول اور سنگل پیج گیلریوں کو لوڈنگ شروع کرانے کے لیے ایک حقیقی براؤزر کی ضرورت ہوتی ہے۔
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
لوپ میں اسکرول کرنے سے لیزی لوڈر مجبور ہوتا ہے کہ وہ اپنے data-src پلیس ہولڈرز کو اصل URLs سے بدل دے، جس کے بعد وہی پارسرز جو آپ پہلے لکھ چکے ہیں انہیں حاصل کر لیتے ہیں۔ ہیڈ لیس رینڈرنگ کی گہری وضاحت کے لیے، ڈائنامک ویب پیجز اسکریپ کرنا دیکھیں۔
آخر میں، ایک CSV مینی فیسٹ لکھیں تاکہ ہر ڈاؤن لوڈ شدہ فائل اپنے ماخذ URL، ہیش اور سائز تک قابلِ سراغ رہے۔ ایک مینی فیسٹ بے نام فائلوں کے فولڈر کو ایسے ڈیٹا سیٹ میں بدل دیتا ہے جس کا آپ آڈٹ کر سکتے ہیں، دوبارہ شروع کر سکتے ہیں، اور مختلف رنز میں ڈی ڈپلیکیٹ کر سکتے ہیں۔
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
مینی فیسٹ کے موجود ہونے سے آپ جاب کو دوبارہ چلا سکتے ہیں اور کسی بھی ریکارڈ شدہ URL کو چھوڑ سکتے ہیں، جو بینڈوڈتھ بچاتا ہے اور آپ کے ڈیٹا سیٹ کو وقت کے ساتھ یکساں رکھتا ہے۔
کیا ویب سائٹ سے تصاویر اسکریپ کرنا اور دوبارہ استعمال کرنا قانونی ہے؟
کسی تصویری فائل کو ڈاؤن لوڈ کرنا ایک تکنیکی عمل ہے؛ یہ آپ کو اس تصویر کو دوبارہ استعمال کرنے کا کوئی لائسنس نہیں دیتا۔ یہ تصویر اسکریپنگ کا سب سے زیادہ غلط سمجھا جانے والا پہلو ہے، اس لیے اسے احتیاط سے لیں۔ ویب پر تقریباً ہر تصویر، تصویری خاکہ، اور گرافک اپنی تخلیق کے لمحے سے کاپی رائٹ سے محفوظ ہوتی ہے، اور جس شخص نے اسے لیا یا بنایا وہ ان حقوق کا مالک ہوتا ہے جب تک کہ اس نے واضح طور پر انہیں نہ چھوڑ دیا ہو۔
کسی فائل کو حاصل کر سکنا آپ کے اسے دوبارہ شائع کرنے، بیچنے، اس پر ماڈل تربیت دینے، یا دوبارہ تقسیم کرنے کے حق کے بارے میں کچھ نہیں کہتا۔ اسکریپ شدہ تصاویر دوبارہ استعمال کرنے سے پہلے، ان کے ساتھ منسلک لائسنسنگ شرائط چیک کریں، Creative Commons یا پبلک ڈومین جیسے کسی واضح لائسنس کو تلاش کریں، اور جب استعمال تجارتی ہو تو تحریری اجازت حاصل کریں۔ نجی تجزیے، انڈیکسنگ، یا تحقیق کے لیے تصاویر جمع کرنا انہیں شائع کرنے سے ایک الگ سوال ہے، اور محفوظ طریقہ یہ ہے کہ یہ فرض کر لیا جائے کہ ایک تصویر محفوظ ہے جب تک کوئی لائسنس واضح طور پر اس کے برعکس نہ کہے۔
شروع کرنے سے پہلے ٹارگٹ سائٹ کی سروس کی شرائط اور robots.txt کا بھی جائزہ لیں۔ چیک کریں کہ آیا کوئی ویب سائٹ اسکریپنگ کی اجازت دیتی ہے کی گائیڈ دکھاتی ہے کہ ان اشاروں کو کیسے پڑھا جائے، اور بلاک ہوئے بغیر اسکریپنگ کی گائیڈ ذمہ دارانہ کرالنگ کے طریقوں کا احاطہ کرتی ہے۔ اس مضمون کی کوئی بھی تکنیک بنیادی اصول کو نہیں بدلتی: رسائی لائسنس نہیں ہے، اور درست مؤقف یہ ہے کہ ایک کام کرنے والا اسکریپر اور دوبارہ استعمال کا قانونی حق دو الگ چیزیں ہیں، اور دونوں کی شرائط الگ الگ پوری کرنی ہوتی ہیں۔
اکثر پوچھے جانے والے سوالات
کیا میں کسی بھی ویب سائٹ سے تصاویر اسکریپ کر سکتا ہوں؟
تکنیکی طور پر آپ زیادہ تر سائٹس سے فائلیں ڈاؤن لوڈ کر سکتے ہیں، مگر پہلے سائٹ کی سروس کی شرائط اور robots.txt چیک کریں، اور یاد رکھیں کہ ایک تصویر ڈاؤن لوڈ کرنا آپ کو اسے دوبارہ استعمال کرنے کا حق نہیں دیتا۔ رسائی لائسنس نہیں ہے۔
کچھ تصاویر اس HTML میں کیوں ظاہر نہیں ہوتیں جو میں ڈاؤن لوڈ کرتا ہوں؟
ایسی تصاویر عام طور پر JavaScript یا لیزی لوڈنگ کے ذریعے لوڈ ہوتی ہیں، اس لیے ان کے اصل URLs data ایٹریبیوٹس میں ہوتے ہیں یا صفحہ رینڈر ہونے کے بعد شامل ہوتے ہیں۔ Playwright جیسے ہیڈ لیس براؤزر کے ساتھ صفحہ رینڈر کریں اور لوڈنگ شروع کرانے کے لیے اسکرول کریں، پھر نتیجہ پارس کریں۔
میں کسی تصویر کا سب سے زیادہ ریزولوشن والا ورژن کیسے منتخب کروں؟
srcset ایٹریبیوٹ کو پارس کریں، ہر URL کے بعد چوڑائی کا ڈسکرپٹر پڑھیں، اور سب سے بڑی چوڑائی والا URL رکھیں۔ پروڈکٹ صفحات اکثر JSON-LD بلاک میں فل ریزولوشن تصویر بھی درج کرتے ہیں۔
میں ایک ہی تصویر کو دو بار ڈاؤن لوڈ کرنے سے کیسے بچوں؟
ہر ڈاؤن لوڈ شدہ فائل کا ایک SHA-256 ہیش نکالیں اور کسی بھی ایسے ہیش کو چھوڑ دیں جو آپ پہلے محفوظ کر چکے ہیں۔ مختلف سائز پر بصری طور پر ملتی جلتی کاپیوں کے لیے، اس کے بجائے imagehash جیسی پرسیپچوئل ہیش لائبریری استعمال کریں۔
کیا DataImpulse ایک منظم امیج اسکریپنگ API پیش کرتا ہے؟
نہیں۔ DataImpulse ایسی پراکسیز فراہم کرتا ہے جن کے ذریعے آپ اپنا اسکریپر چلاتے ہیں؛ یہ کوئی منظم اسکریپنگ API یا مفت ویب پراکسی سروس نہیں ہے۔ آپ ڈاؤن لوڈ کی منطق لکھتے ہیں اور رسائی اور روٹیشن کے لیے DataImpulse کے IPs استعمال کرتے ہیں۔
DataImpulse کب صحیح انتخاب نہیں ہوتا؟
اگر آپ کو اسٹیٹک ISP پراکسیز، مکمل طور پر منظم اسکریپنگ API، یا بینکنگ اور سرکاری سائٹس تک رسائی درکار ہے، تو DataImpulse صحیح ٹول نہیں ہے۔ یہ عوامی ڈیٹا جمع کرنے اور مواد تک رسائی کے لیے روٹیٹنگ رہائشی، موبائل اور ڈیٹا سینٹر پراکسیز پر توجہ مرکوز کرتا ہے۔
بڑے پیمانے پر تصاویر اسکریپ کرنا شروع کریں
جب آپ کے تصویری اسکریپر کو سبسکرپشن کے بغیر قابلِ اعتماد رسائی اور IP روٹیشن کی ضرورت ہو، تو DataImpulse اخلاقی طور پر حاصل کردہ رہائشی، موبائل اور ڈیٹا سینٹر پراکسیز پیش کرتا ہے، جہاں پے ایز یو گو ٹریفک 1 ڈالر فی GB سے شروع ہوتی ہے۔ ایک اکاؤنٹ بنائیں اور چند منٹوں میں اپنے ڈاؤن لوڈ لوپ کو ان کے ذریعے چلائیں۔