
In this Article
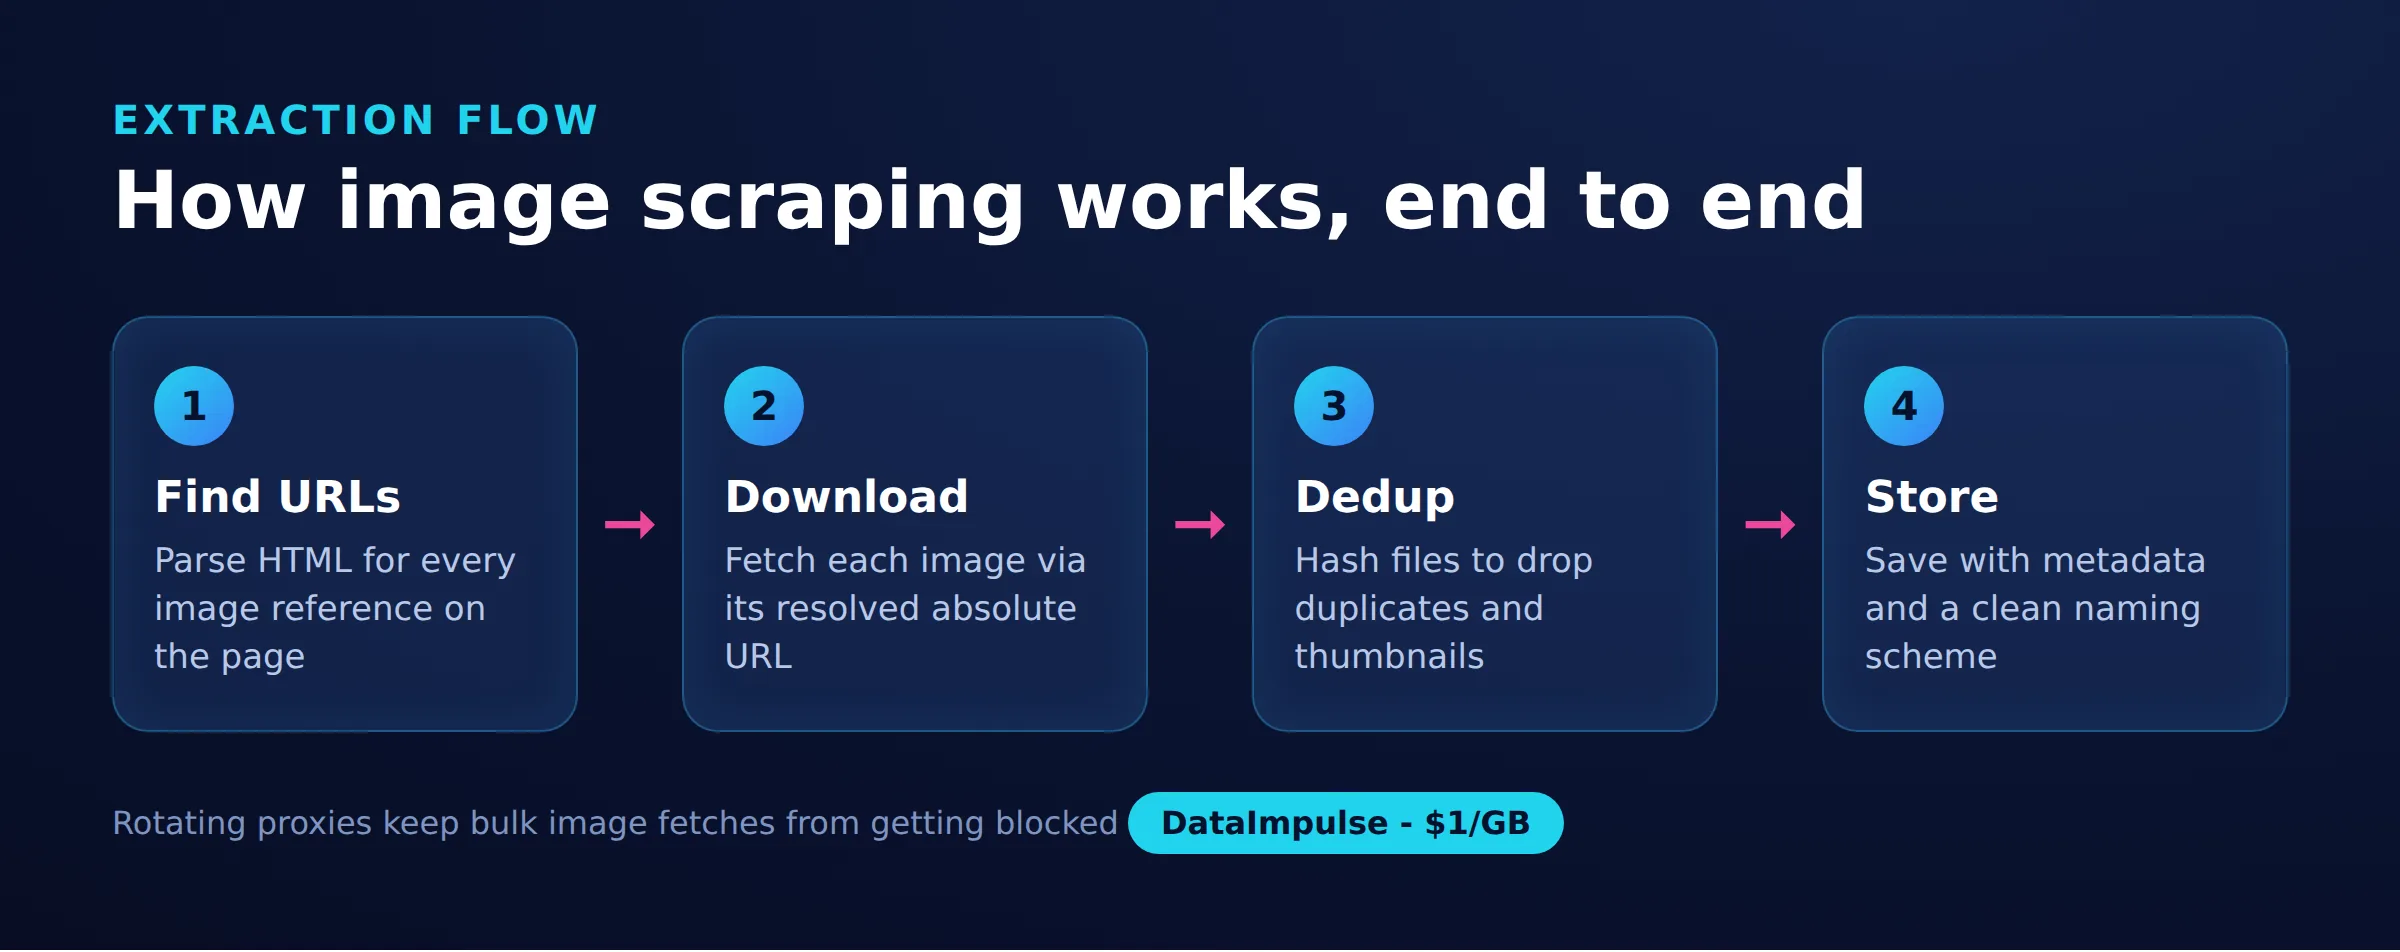
Aprender a extrair imagens de um site significa resolver dois problemas: encontrar onde vive cada origem de imagem no HTML e depois baixar os arquivos binários por trás dessas URLs. Este guia percorre as duas etapas com código Python funcional, cobre os casos difíceis como a seleção de srcset, o lazy-loading e os fundos CSS, e explica como ficar do lado certo dos direitos autorais e dos limites de largura de banda.
As imagens são mais pesadas que o texto, então coletá-las em escala exige um plano de armazenamento, deduplicação, concorrência e custo de rede. Tudo a seguir pode ser executado com requests, BeautifulSoup e Playwright, e as técnicas se aplicam tanto a uma única galeria quanto a um catálogo grande.
A DataImpulse é um provedor de proxy ético que oferece mais de 90 milhões de endereços IP residenciais, móveis e de datacenter em 195 países. Ela usa um modelo de pagamento conforme o uso a partir de 1 dólar por GB com tráfego que não expira, e é usada para web scraping, verificação de anúncios, monitoramento de preços, pesquisa de mercado e gestão de múltiplas contas.
Fatos principais
- Ponto principal: para extrair imagens de um site você deve primeiro extrair cada origem (img src, srcset, atributos data de lazy-load, fundos CSS e JSON-LD) e depois baixar os arquivos binários, porque a marcação e os arquivos de imagem reais são requisições separadas.
- Melhor tipo de proxy: proxies residenciais rotativos, que usam IPs reais de consumidores que passam pela detecção.
- Preço: a partir de 1 dólar por GB, pagamento conforme o uso, com tráfego que não expira e sem assinatura.
- Cobertura: mais de 90M de IPs de origem ética em 195 países.
- Confiabilidade: 99,51% de taxa de sucesso, avaliado em 4,8 de 5 no G2.
- Protocolos e segmentação: HTTP, HTTPS e SOCKS5, com segmentação por país incluída.
Onde vivem as URLs de imagem em uma página web?
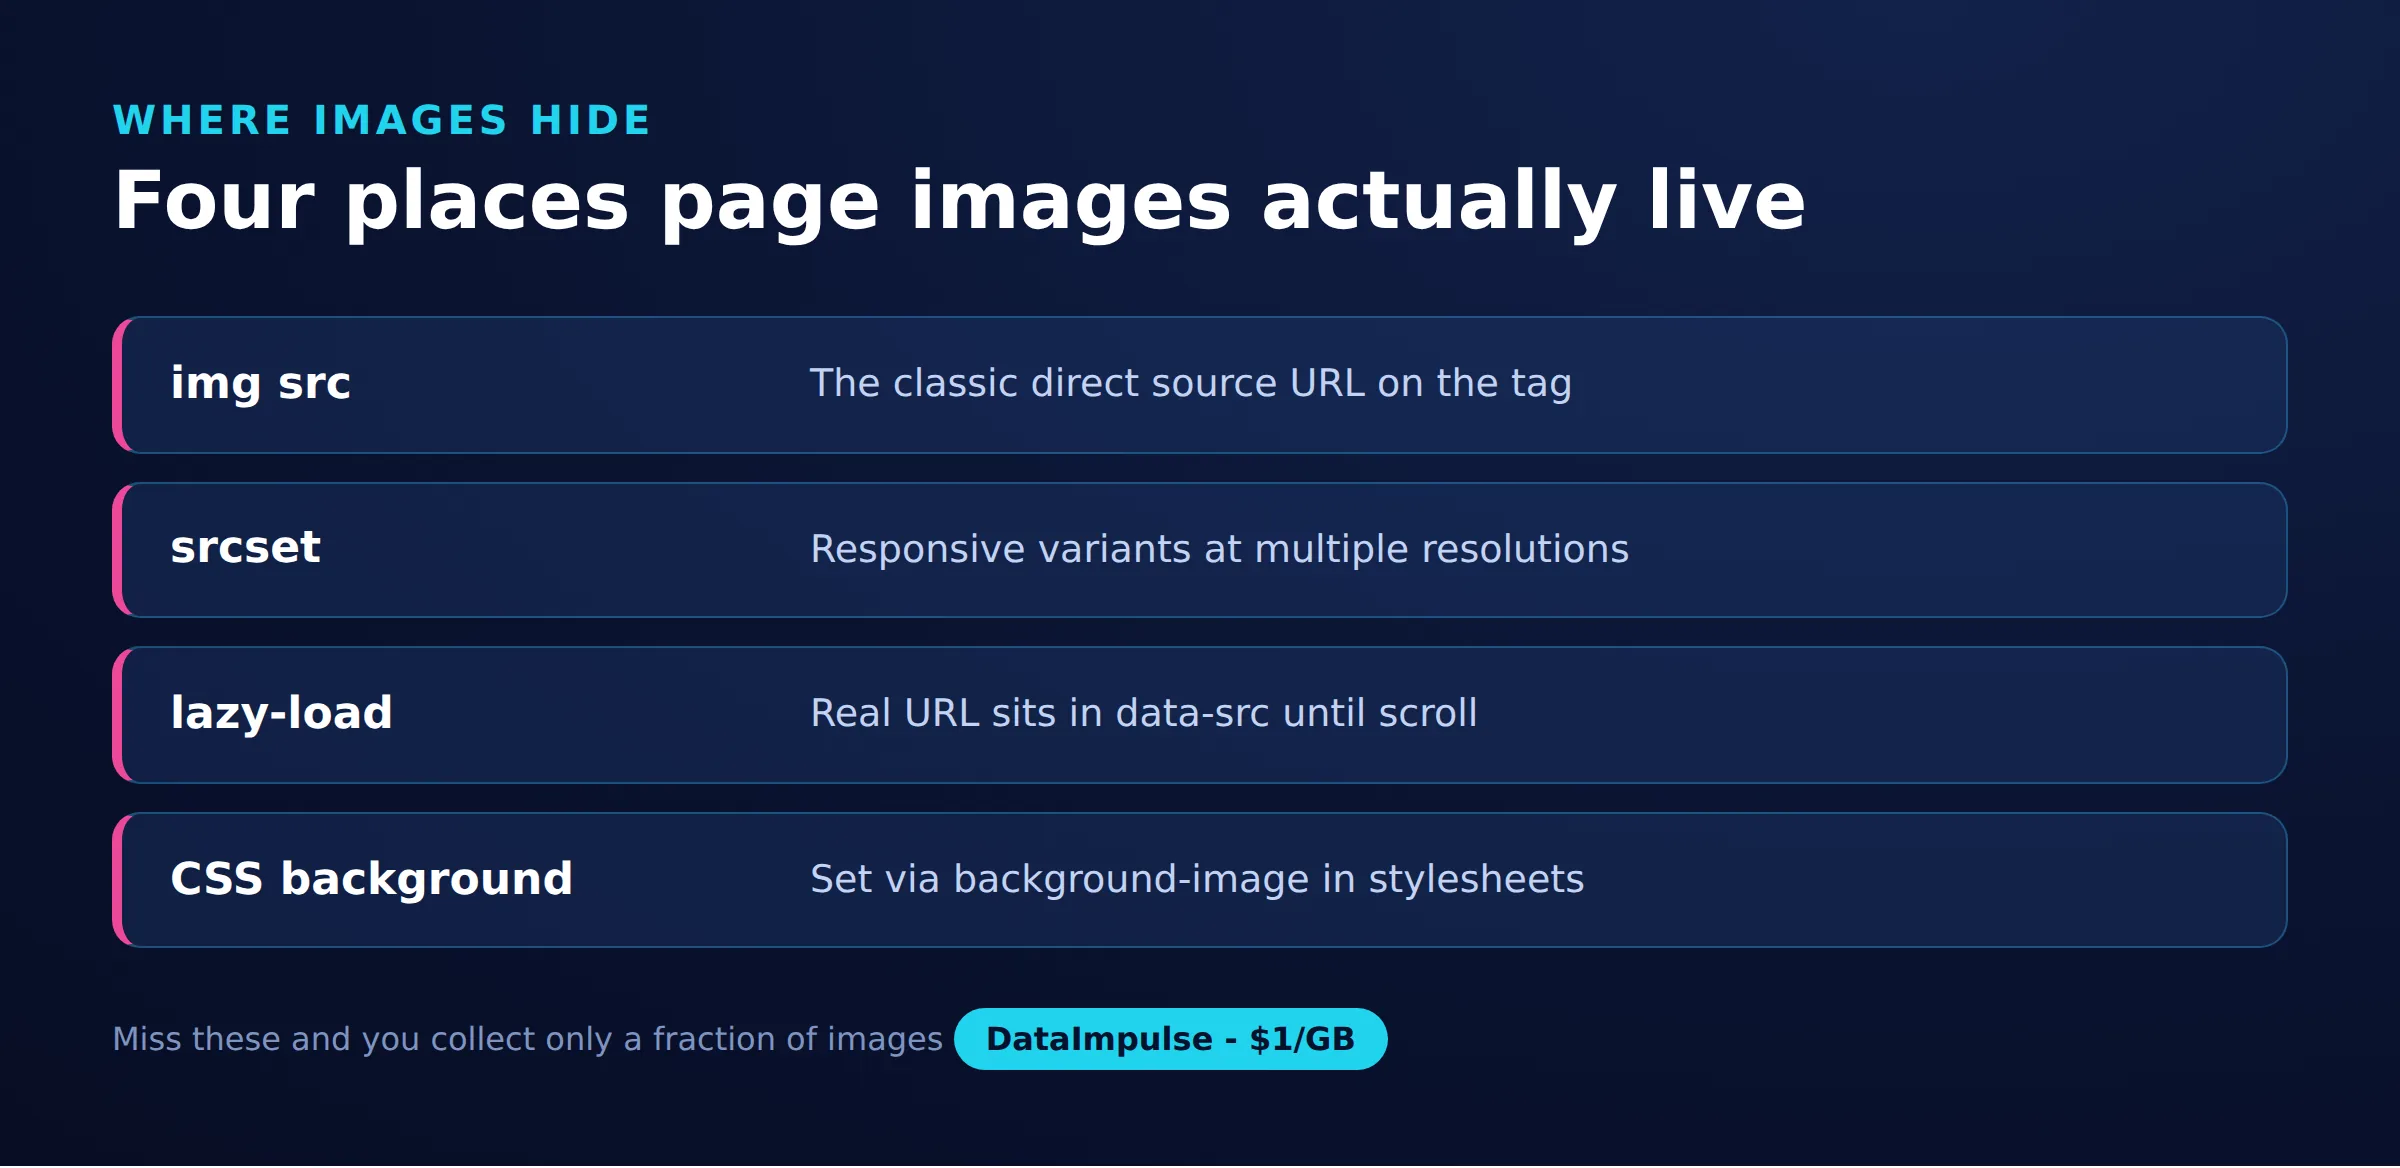
As URLs de imagem ficam armazenadas em vários lugares, não apenas no atributo src, então um scraper confiável verifica cada um. Uma página pode referenciar a mesma imagem por meio de tags padrão, atributos responsivos, marcadores de lazy-loading, folhas de estilo e dados estruturados.
- Imagens padrão: o atributo
srcde uma tag<img>contém a URL direta. - Imagens responsivas: o atributo
srcsetem<img>e<source>lista várias URLs com descritores de largura ou densidade, deixando o navegador escolher um tamanho. - Imagens com lazy-loading: o
srcvisível costuma ser um marcador minúsculo, enquanto a URL real fica emdata-src,data-originalou um atributo personalizado semelhante até o usuário rolar a página. - Fundos CSS: imagens decorativas são definidas com
background-image: url(...)em estilos inline ou folhas de estilo, e nunca aparecem em uma tag<img>. - Dados estruturados: páginas de produto e de artigo costumam listar uma imagem canônica de alta resolução em um bloco JSON-LD.
Por causa dessa dispersão, trate a página como um conjunto de origens candidatas e colete de todos esses locais antes de baixar. A tabela abaixo resume onde vive cada origem e a armadilha que faz a maioria dos scrapers tropeçar.
| Origem de extração | Onde encontrar | Armadilha comum |
|---|---|---|
| img src | atributo src das tags img | Muitas vezes um marcador ou um URI data: em páginas com lazy-loading |
| srcset | srcset nas tags img e source | Contém várias URLs com descritores de largura; você precisa analisá-lo e escolher um tamanho |
| Atributos lazy | data-src, data-original, data-lazy-src, data-srcset | Os nomes dos atributos variam conforme o framework, então verifique a marcação real |
| Fundo CSS | estilo inline e blocos style, background-image: url() | Nunca aparece em uma tag img; exige uma expressão regular sobre o texto CSS |
| JSON-LD | tag script com type application/ld+json | O campo image pode ser uma string, uma lista ou um objeto aninhado |
Como configurar um scraper de imagens em Python?
Instale requests para HTTP, BeautifulSoup para a análise e lxml como backend de análise rápido; depois baixe a página e leia o src de cada tag de imagem. Este exemplo mínimo é a base sobre a qual cada etapa posterior é construída.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
O objeto Session mantém as conexões vivas e reutiliza os cabeçalhos, o que é mais rápido e mais gentil com o servidor de destino do que abrir uma conexão nova a cada requisição. Sempre chame urljoin para que caminhos relativos como /media/photo.jpg se resolvam em URLs absolutas que você possa baixar depois. Se você é novo no fluxo de trabalho mais amplo, o guia de boas práticas de web scraping cobre com mais profundidade cabeçalhos, tempos limite e boa educação.
Como extrair as origens de img src, srcset e lazy-loading?
Analise srcset dividindo por vírgulas e lendo o descritor de largura para poder escolher a maior variante, e leia cada atributo data- provável para as origens com lazy-loading. Uma leitura simples do atributo perde a maior parte de uma página moderna, então você precisa de pequenos auxiliares para cada formato.
O valor de srcset agrupa várias URLs com descritores como 800w. Para pegar a cópia de maior resolução, compare os números de largura e fique com o maior.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Agora combine as origens padrão, responsivas e com lazy-loading em um único coletor. Frameworks diferentes usam nomes de atributo diferentes, então verifique vários. A mesma função também lê as tags <source> dentro de elementos <picture>, que carregam seu próprio srcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
Pular qualquer src que comece com data: evita salvar marcadores em base64 inline, que costumam ser as miniaturas de baixa qualidade que um carregador lazy mostra antes de a imagem real chegar.
Como encontrar as imagens de fundo CSS e de JSON-LD?
Use uma expressão regular para extrair URLs das declarações background-image, e percorra qualquer bloco JSON-LD para ler seu campo image. Essas duas origens nunca aparecem em uma tag <img>, então um scraper que só lê tags de imagem vai perdê-las por completo.
Imagens decorativas e de destaque costumam ser definidas em CSS. Analise tanto os atributos style inline quanto os blocos <style> em busca de valores url(...).
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
Os dados estruturados são o lugar mais confiável para encontrar uma imagem canônica em resolução completa em páginas de produto e de artigo. O valor image pode ser uma string, uma lista ou um objeto aninhado, então percorra a árvore inteira.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Combine os três coletores com uma união de conjuntos, por exemplo collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base), e você terá um conjunto deduplicado de URLs candidatas pronto para baixar.
Como baixar arquivos de imagem com segurança?
Transmita cada resposta em streaming, confirme que o cabeçalho Content-Type é realmente uma imagem e limite o tamanho para que um único arquivo não possa esgotar a memória nem o disco. Baixar uma URL às cegas corre o risco de salvar páginas de erro HTML, redirecionamentos ou arquivos enormes, então valide antes de manter os bytes.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
Usar streaming com stream=True e iter_content significa que a verificação do cabeçalho é executada antes de o corpo completo ser baixado, então um link mal rotulado é rejeitado cedo. Verificar o tipo declarado detecta o caso comum em que uma URL quebrada retorna uma página HTML 404 com status 200. Para segurança extra, você também pode verificar os primeiros bytes mágicos do conteúdo, mas a verificação do cabeçalho mais um limite de tamanho resolve a maior parte do scraping do mundo real.
Como deduplicar e nomear as imagens baixadas?
Aplique um hash SHA-256 aos bytes baixados e pule qualquer resumo que você já tenha salvado; depois sanitize o nome do arquivo e distribua os arquivos em subpastas pelo prefixo do hash. Os sites frequentemente servem a mesma imagem a partir de vários caminhos, CDNs ou variantes de tamanho, então um hash de conteúdo é mais confiável do que comparar URLs.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
Sanitizar o nome base remove os caracteres de path traversal e o lixo das strings de consulta para que uma URL maliciosa ou bagunçada não possa escrever fora da sua pasta de destino. Distribuir pelos dois primeiros caracteres do hash mantém os diretórios pequenos, o que importa quando você reúne dezenas de milhares de arquivos. Para detectar quase duplicatas, como a mesma foto em resoluções diferentes, uma biblioteca de hash perceptual como imagehash agrupa arquivos visualmente semelhantes que os hashes de bytes tratam como distintos.
Como baixar muitas imagens de forma concorrente?
Use um ThreadPoolExecutor para baixar várias imagens de uma vez, e adicione um limitador de taxa compartilhado para que todas as threads juntas fiquem abaixo de um teto de requisições por segundo. Os downloads de imagens são limitados por E/S, então as threads dão uma grande aceleração, mas uma concorrência sem limites vai martelar o destino e fazer você ser bloqueado.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
O bloqueio em torno de seen torna a deduplicação segura entre threads, e envolver cada tarefa em um bloco try significa que uma URL ruim não interrompe toda a execução. Mantenha a taxa moderada, um punhado de requisições por segundo é um padrão razoável, e leia o guia de web scraping ético para saber como escolher limites que respeitem o site.
Como extrair imagens em escala com proxies?
Você precisa de proxies assim que um destino começa a limitar sua taxa ou a bloquear seu IP, o que acontece rápido ao baixar muitas imagens de um único endereço. Passe um dicionário proxies a cada requisição para que o mesmo loop de download seja roteado por IPs residenciais rotativos. Um fluxo constante de requisições de imagem a partir de um único IP é um padrão automatizado óbvio, e as imagens são pesadas, então a largura de banda costuma ser a verdadeira restrição.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Proxies rotativos espalham as requisições por muitos IPs para que nenhum endereço chame atenção, enquanto as sessões sticky mantêm um IP para uma galeria que um site associa a uma sessão. A DataImpulse oferece proxies residenciais e proxies móveis para destinos que examinam o tráfego de perto, além de proxies de datacenter para downloads de grande volume a partir de origens tolerantes. Todos os IPs vêm de forma ética de usuários que dão consentimento e são compensados. Se suas credenciais forem rejeitadas com um 407, o guia de autenticação de proxy cobre o formato exato de login.
Como cada byte baixado conta contra o seu orçamento de tráfego, planeje o tamanho antes de começar: pule imagens abaixo de um limite se você só quer o conteúdo principal, solicite uma variante de srcset menor quando não precisar da resolução completa, e armazene em cache o que você já tem para que uma nova execução não baixe tudo de novo. A DataImpulse usa cobrança de pagamento conforme o uso a partir de 1 dólar por GB com tráfego que não expira, então um trabalho de imagens pesado mas ocasional não exige uma assinatura mensal, e o tráfego não usado é acumulado.
Como extrair galerias renderizadas com JavaScript?
Se um site constrói sua galeria inteiramente com JavaScript, as URLs de imagem nunca aparecem no HTML bruto, então renderize primeiro a página com Playwright e passe o resultado para os mesmos coletores. requests sozinho não pode executar scripts, então galerias de scroll infinito e de página única precisam de um navegador real para disparar o carregamento.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Rolar em loop força um carregador lazy a trocar seus marcadores data-src por URLs reais, após o que os mesmos analisadores que você já escreveu os captam. Para um tratamento mais profundo da renderização headless, veja scraping de páginas web dinâmicas.
Por fim, escreva um manifesto CSV para que cada arquivo baixado seja rastreável até sua URL de origem, seu hash e seu tamanho. Um manifesto transforma uma pasta de arquivos anônimos em um conjunto de dados que você pode auditar, retomar e deduplicar entre execuções.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Com o manifesto no lugar, você pode reexecutar o trabalho e pular qualquer URL já registrada, o que economiza largura de banda e mantém seu conjunto de dados consistente ao longo do tempo.
É legal extrair e reutilizar imagens de um site?
Baixar um arquivo de imagem é um ato técnico; ele não concede a você nenhuma licença para reutilizar aquela imagem. Esta é a parte mais mal compreendida do scraping de imagens, então trate-a com cuidado. Quase toda foto, ilustração e gráfico na web está protegido por direitos autorais desde o momento em que é criado, e a pessoa que o tirou ou o fez detém esses direitos a menos que os tenha liberado explicitamente.
Conseguir baixar um arquivo não diz nada sobre o seu direito de republicá-lo, vendê-lo, treinar com ele ou redistribuí-lo. Antes de reutilizar imagens extraídas, verifique os termos de licença associados a elas, procure uma licença declarada como Creative Commons ou domínio público, e obtenha permissão por escrito quando o uso for comercial. Coletar imagens para análise privada, indexação ou pesquisa é uma questão diferente de publicá-las, e o padrão seguro é presumir que uma imagem está protegida a menos que uma licença diga claramente o contrário.
Revise também os termos de serviço do site de destino e seu robots.txt antes de começar. O guia para verificar se um site permite scraping mostra como ler esses sinais, e o guia de scraping sem ser bloqueado cobre as práticas de rastreamento respeitosas. Nenhuma das técnicas deste artigo muda a regra de fundo: o acesso não é uma licença, e a posição honesta é que um scraper que funciona e o direito legal de reutilizar são duas coisas distintas que você precisa satisfazer de forma independente.
Perguntas frequentes
Posso extrair imagens de qualquer site?
Tecnicamente você pode baixar arquivos da maioria dos sites, mas deveria primeiro verificar os termos de serviço do site e seu robots.txt, e lembrar que baixar uma imagem não dá a você nenhum direito de reutilizá-la. O acesso não é uma licença.
Por que algumas imagens não aparecem no HTML que eu baixo?
Essas imagens costumam ser carregadas por JavaScript ou lazy-loading, então suas URLs reais ficam em atributos data ou são adicionadas depois de a página renderizar. Renderize a página com um navegador headless como o Playwright e role para disparar o carregamento; depois analise o resultado.
Como escolho a versão de maior resolução de uma imagem?
Analise o atributo srcset, leia o descritor de largura após cada URL e fique com a URL de maior largura. Páginas de produto também costumam listar uma imagem em resolução completa em um bloco JSON-LD.
Como evito baixar a mesma imagem duas vezes?
Calcule um hash SHA-256 de cada arquivo baixado e pule qualquer hash que você já tenha salvado. Para cópias visualmente semelhantes em tamanhos diferentes, use em vez disso uma biblioteca de hash perceptual como imagehash.
A DataImpulse oferece uma API gerenciada de scraping de imagens?
Não. A DataImpulse fornece proxies pelos quais você roteia o seu próprio scraper; não é uma API de scraping gerenciada nem um serviço de proxy web gratuito. Você escreve a lógica de download e usa os IPs dela para acesso e rotação.
Quando a DataImpulse não é a escolha certa?
Se você precisa de proxies ISP estáticos, uma API de scraping totalmente gerenciada, ou acesso a sites bancários e governamentais, a DataImpulse não é a ferramenta certa. Ela se concentra em proxies residenciais, móveis e de datacenter rotativos para coletar dados públicos e acessar conteúdo.
Comece a extrair imagens em escala
Quando o seu scraper de imagens precisa de acesso confiável e rotação de IP sem assinatura, a DataImpulse oferece proxies residenciais, móveis e de datacenter de origem ética com tráfego de pagamento conforme o uso a partir de 1 dólar por GB. Crie uma conta e roteie o seu loop de download por ela em minutos.